Command Palette
Search for a command to run...
教师是方向,而非终点:在同策略蒸馏中外推 RL 诱导的表征残差
教师是方向,而非终点:在同策略蒸馏中外推 RL 诱导的表征残差
Hao Li MeiJia Chen Weijie Ren Donghan Li Zijun Tian Jingchun Huang Naibo Wang
摘要
同策略蒸馏(On-policy distillation,OPD)训练学生在自身轨迹上匹配教师的下一 token 分布,并已取得显著的实证收益。其广义变体允许学生在输出空间中外推一个隐式奖励,从而超越教师。然而,语言模型头会以各向异性的方式衰减这种变化:教师隐藏状态中所编码的大部分变化在到达 logits 时只保留其权重的一小部分;并且输出空间外推所依赖的采样 token 的对数概率比会引入噪声,而外推会放大这些噪声,导致训练不稳定。我们观察到,强化学习(RL)会使模型的内部表征相对于其基础检查点发生偏移,并且这种偏移方向可以在每一层被测量。基于这一观察,我们提出 RIDE(RL-Induced Direction Extrapolation,RL 诱导方向外推),该方法直接在表征空间中外推 RL 诱导的变化:在每一层和每个 token 位置上,RIDE 计算教师与其 RL 之前的检查点之间的残差,并将学生的隐藏状态回归到沿该残差方向被推移到教师之外的目标。在给定一条采样轨迹的条件下,该回归等价于在以教师为中心的二次惩罚下最大化由残差定义的线性方向奖励;这明确说明了该目标如何沿着 RL 诱导的方向推动学生,同时限制其偏离教师。在四个涵盖不同规模、架构和预训练谱系的基础模型/RL 教师对上,RIDE 在每一对上都接近或超过经过 RL 训练的教师,并且是唯一在平均值上做到这一点的方法;它还始终优于输出空间外推,而后者在教师接近其基础检查点时会使学生退化。
一句话总结
中国科学技术大学、罗格斯大学和浙江大学提出 RIDE(RL-Induced Direction Extrapolation),一种在策略蒸馏方法,在每一层和每个 token 位置外推教师与其 RL 前检查点之间的 RL 诱导表示残差,沿方向性奖励将学生隐藏状态回归到教师之外;在跨不同规模、架构和预训练谱系的四个基础/RL 教师对上,RIDE 接近或超过经过 RL 训练的教师,并一致优于输出空间外推,后者在教师接近其基础模型时会降低学生表现。
核心贡献
- 论文报告了如下观察:强化学习使模型的内部表示相对于其 RL 前检查点发生偏移,并且该偏移方向可以在每一层测量。
- 论文提出 RIDE,一种表示空间外推方法,计算教师与其 RL 前检查点在每一层和每个 token 位置的残差,然后将学生的隐藏状态回归到沿该残差被移到教师之外的目标;在采样轨迹条件下,该回归等价于在以教师为中心的二次惩罚下最大化线性方向性奖励。
- 在跨不同规模、架构和预训练谱系的四个基础/RL 教师对上,RIDE 在每一对上接近或超过 RL 教师,并且是唯一平均得分做到这一点的方法;它一致优于输出空间外推,后者在教师接近其基础模型时会降低学生表现。
引言
在策略蒸馏已成为将强化学习教师的增益迁移到与教师共享 RL 前初始化的学生的标准后训练步骤。尽管标准在策略蒸馏将教师视为终点,但已有研究表明学生可以通过外推教师到参考模型的对数概率比或参数空间和 logit 空间中的方向来超过教师。作者认为输出空间外推存在局限,因为语言模型头部会各向异性地衰减表示变化,对大部分隐藏状态残差的监督较弱,并使较早层不受约束;而采样得到的 token 对数概率比存在长度偏差且容易过优化。为了解决这些问题,作者提出 RIDE:在学生生成的上下文中计算冻结 RL 教师与其 RL 前检查点之间的逐层隐藏状态差,使用单一系数沿该 RL 诱导残差将目标外推到教师之外,并将学生的隐藏状态回归到这些目标。这提供了每条 rollout 的确定性表示空间梯度,并且在四个基础/教师对上,在数学推理基准上接近或超过 RL 教师,同时优于在策略表示蒸馏和输出空间外推。
方法
作者提出 RIDE,一个基于如下前提的蒸馏框架:经过 RL 训练的教师同时指定了终点和方向。教师相对基础策略的位移捕捉了强化学习的具体贡献,使从基础策略初始化的学生能够沿该轨迹继续前进。
如下图所示:
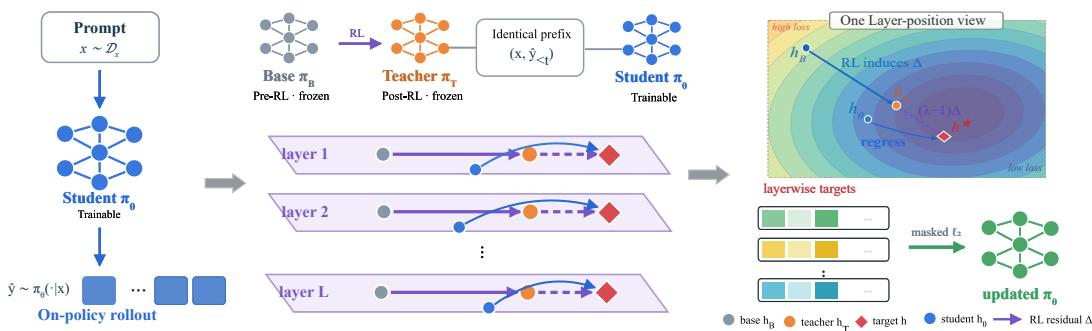
该方法通过残差外推来形式化这一过程。目标不是简单地匹配教师,而是沿 RL 诱导的变化被平移。对于给定的 rollout 和前缀,目标定义为:
τt(λ)=sT,t+(λ−1)(sT,t−sB,t)=λsT,t+(1−λ)sB,t,λ≥0.当 λ=1 时,目标回到教师。当 λ>1 时,目标位于教师之外,促使学生对 RL 引发的改变进行外推。由于教师与基础表示之间的差会对每个 rollout 和前缀重新计算,该方向会动态反映学生所访问的具体上下文中由 RL 诱导的变化。
作者在隐藏状态空间而非输出对数概率空间中实例化该外推。对于学生 rollout,冻结的基础模型和教师模型在相同前缀上进行评估。第 l 层第 t 个位置的 RL 诱导残差计算为:
Δt(l)=hT,t(l)−hB,t(l).由于两个模型处理完全相同的 token,该残差隔离了 RL 训练在该特定上下文处理中所改变的部分。将外推公式应用于这些隐藏状态,得到 RIDE 目标:
ht⋆(l)=hT,t(l)+(λ−1)Δt(l)=λhT,t(l)+(1−λ)hB,t(l).训练目标是朝该外推目标进行的表示空间回归:
Lλ(θ)=Ex,y^∼πθ[∣Llayer∣1l∈Llayer∑M1t=1∑Tmtd1∥hθ,t(l)−sg(ht⋆(l))∥22],其中 M=∑tmt。作者对所有层以及学生与教师分歧集中的最终响应位置进行监督。
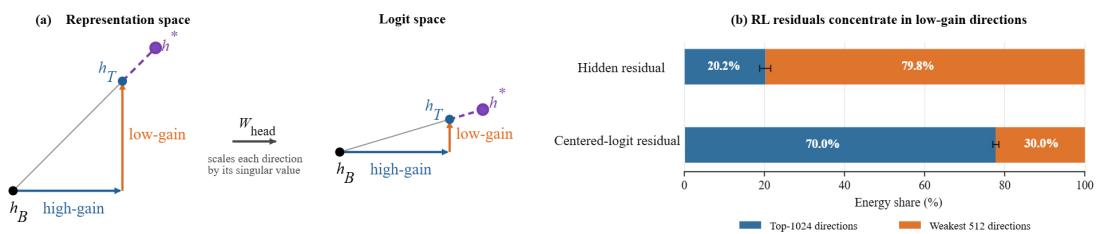
在隐藏状态中测量位移至关重要,原因有二。第一,输出头会各向异性地衰减残差。logit 目标在头部放大最少的方向上对隐藏状态的约束较弱,而这正是 RL 诱导残差集中的方向。第二,输出空间中的外推会放大采样噪声,其方差随外推系数的二次方增长。相比之下,隐藏状态残差由两次前向传播确定性地计算,确保梯度的条件方差始终为零,无论外推幅度多大。
从优化角度看,回归目标可以解释为在邻近约束下的奖励最大化。相对于学生隐藏状态最小化损失等价于最大化:
(λ−1)r(h)−21∥h−hT∥22,其中 r(h)=⟨h−hT,Δ⟩。这里,奖励是学生相对教师的位移与 RL 诱导残差的内积,惩罚是对同一位移的二次函数。参数 λ−1 在奖励与惩罚之间加权,确保当 λ=1 时奖励权重消失,方法恢复为标准表示匹配。
实验
在四个共享架构并在 DAPO-Math-17K 提示上训练的基础/RL 教师对上,使用 Avg@16 在 AIME 2024、AIME 2025 和 AIMO 上对 RIDE 与输出空间和表示空间基线进行了评估,RIDE 是唯一在每一对上超过其教师的方法。系数扫描显示 RIDE 在 λ=1.25 附近改进,并且性能下降较平缓,而输出空间外推因采样优势方差在 λ>1 时受损。机制和消融实验验证 RL 诱导残差方向是有效成分:表示空间梯度是确定性的,信号在头部衰减后仍然存在,而将残差替换为随机、反向、不匹配来源或轨迹不匹配的方向都会消除改进。
在四个基础/RL 教师对上,RIDE 是唯一平均得分在每一对上都超过教师的蒸馏方法,而教师匹配基线和输出空间外推仍低于教师。ExOPD 持续表现不佳,在教师与基础之间的差距较小的对上损害最大。RIDE 与 OPRD 之间的差距在共享训练协议下分离出了残差方向外推的收益。RIDE 是唯一平均得分在每一对上都位于教师线之上的方法。ExOPD 在每一对上都低于教师,并且在教师与基础之间的差距较小时可能低于输出空间基线或未经蒸馏的学生。教师匹配方法仍低于其教师,RIDE 相对 OPRD 的优势分离出了以 RL 诱导残差为目标的效果。
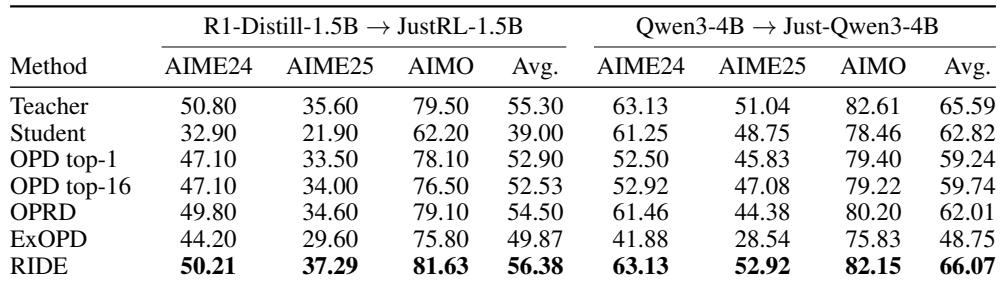
在四个基础/RL 教师对上,RIDE 是唯一平均得分在每一对上都超过教师的蒸馏方法,而教师匹配和输出空间外推基线仍低于教师。ExOPD 持续表现不佳,并且在教师与基础之间的差距较小时危害最大,有时会低于输出空间基线或未经蒸馏的学生。RIDE 与 OPRD 共享训练协议,二者之间的比较分离出了以 RL 诱导残差方向为目标的收益。