Command Palette
Search for a command to run...
我们距离移除视觉编码器还有多远?无编码器多模态预训练的规模法则
我们距离移除视觉编码器还有多远?无编码器多模态预训练的规模法则
Lin Chen Bolin Ni Qi Yang Lan Jiang Kun Ding Xiaoran Fan Hower Yang Ying Wang Shiming Xiang
摘要
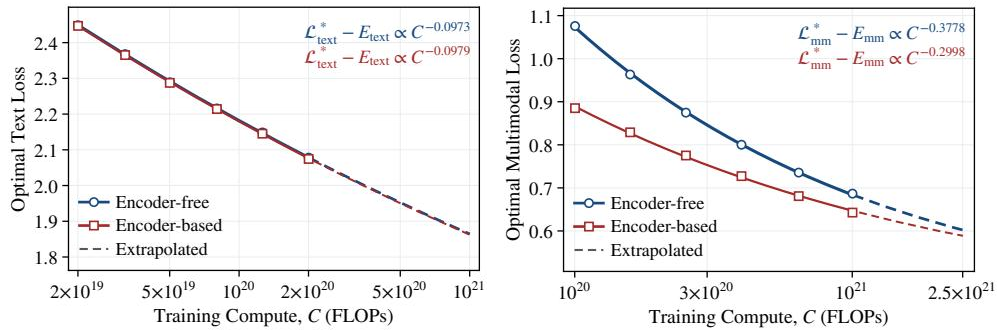
大多数现代多模态大语言模型(MLLM)都建立在预训练视觉编码器之上,从而获得强大的视觉先验。无编码器多模态大语言模型则直接从原始像素学习视觉表示,提供了一种简单且统一的架构,但其规模扩展行为尚未被系统刻画。为填补这一空白,我们比较了无编码器与基于编码器的多模态大语言模型的规模法则,并报告三项主要发现:(1)移除视觉编码器会使多模态目标的计算最优分配转向更大的模型,而文本目标的最优分配几乎保持不变。(2)两种架构在文本目标上表现出几乎重叠的损失—计算前沿,但在多模态目标上出现分化:无编码器模型在小规模下表现不佳,但预计将在约 10^22 FLOPs 时迎头赶上,这远在实际预训练预算范围之内。(3)在没有视觉编码器的情况下,语言模型通过视觉特异性适应来接管这一角色:随着训练计算量增长,视觉 token 之间的双向交互变得越来越有益,视觉处理转移到更早的层,并且视觉 token 的专家路由变得更加集中。总体而言,我们的结果表明,预训练编码器所提供的视觉先验优势随着规模增大而减弱,这使无编码器架构成为多模态预训练的一个有前景的方向。
一句话总结
来自 CASIA、UCAS 和腾讯的研究者比较了无编码器与基于编码器的多模态大语言模型的缩放定律,发现移除视觉编码器会使多模态目标的计算最优分配向更大模型偏移,并且无编码器模型通过视觉特定适应在大约 1022 FLOPs 处追平。
核心贡献
- 对无编码器与基于编码器的多模态 LLM 进行系统的缩放定律比较表明,移除视觉编码器会使多模态目标下的计算最优解码器分配向更大模型偏移,同时几乎不改变文本最优分配。
- 无编码器与基于编码器的架构在文本上的损失-计算前沿几乎重叠,但无编码器模型在小规模多模态目标上表现较差,并且预计在计算最优分配下于 10^22 FLOPs 附近追平。
- 随着训练计算增长,无编码器解码器接管视觉编码,增强视觉 token 之间的双向交互,将视觉处理转移到更早的层,并使视觉 tokens 的专家路由更加集中。
引言
大多数现代多模态大语言模型依赖预训练视觉编码器为语言模型提供丰富的视觉表示。无编码器 MLLM 移除了该编码器,直接将图像块输入解码器,这简化了架构,但迫使解码器从原始像素学习视觉表示。先前的无编码器研究已经证明了可行性,但其缩放行为尚未被系统刻画。作者通过一项受控缩放研究弥补这一空白,该研究比较了共享相同稀疏解码器阶梯、数据混合、优化设置和视觉 token 粒度的无编码器模型与基于编码器的模型。作者为文本目标和多模态目标分别拟合缩放定律,并探测解码器内部机制,结果表明计算最优的无编码器训练倾向于更大的模型,预测多模态效率交叉出现在 10^22 FLOPs 附近,并揭示解码器形成了视觉特定适应,例如视觉 tokens 之间更强的双向注意力和更集中的专家路由。
方法
作者建立了一个用于估计缩放定律的框架,以确定大语言模型的计算最优分配。令 M 表示每个 token 的 FLOPs,D 表示目标 tokens 的数量,训练预算为 C=MD。在目标预算 C 下,计算最优分配在约束 MD=C 下最小化损失 L(M,D):
Mopt(C),Dopt(C)=M,DargminL(M,D)s.t.MD=C.在不同预算下,这些最优点遵循计算最优分配定律:
Mopt(C)∝Ca,Dopt(C)∝Cb,a+b=1.相应的计算最优前沿定义为:
L∗(C)=E+KC−γ,其中 γ>0 是损失-计算指数,K>0 是拟合的前置因子,E 表示数据分布引起的熵下界。为了估计这些参数,作者使用 IsoFLOP 曲线。对于给定预算 C,作者改变 M 并设 D=C/M,将验证损失拟合为 logM 的二次函数。拟合的最小值确定 Mopt(C),由此直接推导出 Dopt(C) 和 L∗(C)。
同时,作者设计了一个匹配的模型阶梯,以比较多模态大语言模型中的架构范式。该阶梯包含 11 个稀疏混合专家语言模型,总参数从 1.1B 到 44B,活跃非嵌入参数从 71M 到 2.4B,所有模型共享相同的数据混合、优化设置和视觉 token 粒度。基于编码器与无编码器方法的架构对比如下所示。
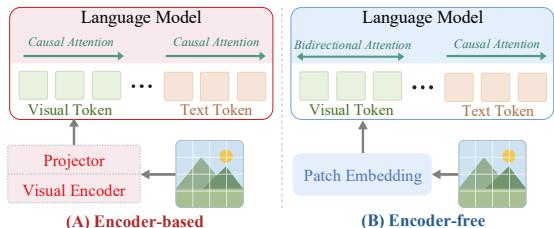
在基于编码器的配置中,图像使用预训练的 SigLIP 2 Vision Transformer 处理,随后通过 ConvPool 适配器和投影器。该架构对所有 tokens 统一应用因果注意力。Vision Transformer 在不同解码器规模下保持相同大小,并与解码器联合训练。相反,无编码器模型绕过了专用视觉编码器,通过图像块投影将原始图像块直接映射到解码器中。在这种设置下,视觉 tokens 在每个图像内部进行双向注意力,而所有其他注意力机制保持严格因果。作者还研究了这种无编码器设计的完全因果变体,以进一步分离双向视觉注意力的影响。
实验
这组实验使用 IsoFLOP 曲线以及计算最优加过度训练的缩放分析,比较无编码器与基于编码器的多模态模型。移除预训练视觉编码器几乎不改变文本目标分配和损失行为,但会使多模态训练转向更大的解码器,并产生初始多模态效率差距;该差距预计在可实际使用的计算预算内缩小,在 STEM 等语言密集型主题上更早追平,在图像描述等感知密集型主题上较晚追平。解码器似乎通过形成类似编码器的视觉处理来补偿:视觉 tokens 获得更强的双向注意力,在较浅层中更早被转换,并由更集中的专家路由处理。
无编码器模型在多模态目标上比在文本目标上更积极地将计算分配给模型规模。在视觉 tokens 上使用因果注意力时,多模态分配指数仍然较高,这表明向更大模型的偏移并非双向视觉注意力所特有。在两种注意力设置下,无编码器文本分配指数都接近基于编码器的文本行为。多模态分配指数相对于文本大幅上升,表明计算最优偏好更大的模型。视觉 tokens 上的因果注意力产生与双向设置接近的多模态分配指数,因此更大模型偏移在不同视觉注意力掩码下持续存在。
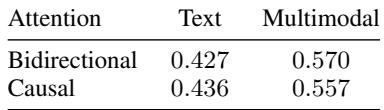
实验评估了无编码器模型在文本和多模态目标下,在双向和因果视觉注意力下如何将计算分配给模型规模。多模态目标一致地偏好比文本目标大得多的模型,而在两种注意力设置下,无编码器文本分配仍然接近基于编码器的文本行为。更大模型偏移在因果视觉注意力下持续存在,表明这种偏好并非双向视觉注意力所特有。