Command Palette
Search for a command to run...
超越教师分配:领域归一化多教师同策略蒸馏
超越教师分配:领域归一化多教师同策略蒸馏
Xin Li Hao Jiang Xin Gao Annan Wang Yuchen Xie Jinghao Guo Xingwei Qu Yichi Zhang Chau Yuen
摘要
强化学习可以把一个语言模型变成多个专家模型,每个专家精通数学、编程或指令遵循等单一技能,但用户需要的是具备所有这些技能的一个模型。多教师同策略蒸馏(MOPD)通过让专家模型共同训练一个学生模型来合并它们:学生模型回答每个提示,该提示所属领域的专家模型对每个 token 给出反馈。这种路由决定了由哪个专家来教,但并未决定其反馈以多大强度影响共享学生模型。在三种规模的 Qwen3.5 模型上,我们发现 MOPD 的学生模型并未超过由最佳单一专家训练的学生模型,并且几乎没有获得数学专家模型的优势。反馈存在不平衡:指令遵循反馈的离散程度比数学反馈高数倍,并主导了学生模型的更新。我们提出领域归一化 MOPD(DN-MOPD),它在保留路由的同时,按各领域反馈的实测离散程度重新缩放反馈。在六个公开基准上,DN-MOPD 在每种规模、三个随机种子以及两种答案长度限制下均提高了相对 MOPD 的平均得分,并恢复了大部分损失的数学增益。使用固定领域权重的对照实验表明,增益主要来自调低指令遵循反馈,而非仅调高数学反馈;并且接近 DN-MOPD 实测权重的固定权重也能达到相近性能。因此,合并专家模型不仅需要决定由哪个专家来教,还需要决定其反馈以多大强度计入。
一句话总结
来自南洋理工大学、耶鲁大学和曼彻斯特大学的研究人员提出了 Domain-Normalized Multi-Teacher On-Policy Distillation(DN-MOPD),该方法保留专家路由,但根据每个领域反馈的实测离散度对其重新缩放,以纠正不平衡反馈;在六个公开基准上,DN-MOPD 在多种模型规模、随机种子和回答长度限制下均优于 MOPD,并恢复了大部分此前损失的数学增益。
核心贡献
- 在三种规模的 Qwen3.5 模型中,多教师 on-policy 蒸馏(MOPD)表现出不平衡反馈:指令遵循反馈的离散度是数学反馈的数倍,因此学生从数学专家处获益很少,并且未能超过最强的单教师基线。
- Domain-Normalized MOPD(DN-MOPD)保留 MOPD 的教师路由,并根据其教师-学生 log 比值的实测离散度对每个领域的反馈进行重新缩放。
- 在六个公开基准上,DN-MOPD 在所有规模、三个随机种子和两种回答长度限制下均比 MOPD 提高平均得分,并恢复了大部分丢失的数学增益;固定权重对照显示,增益主要来自调低指令遵循反馈,而不是仅调高数学反馈。
引言
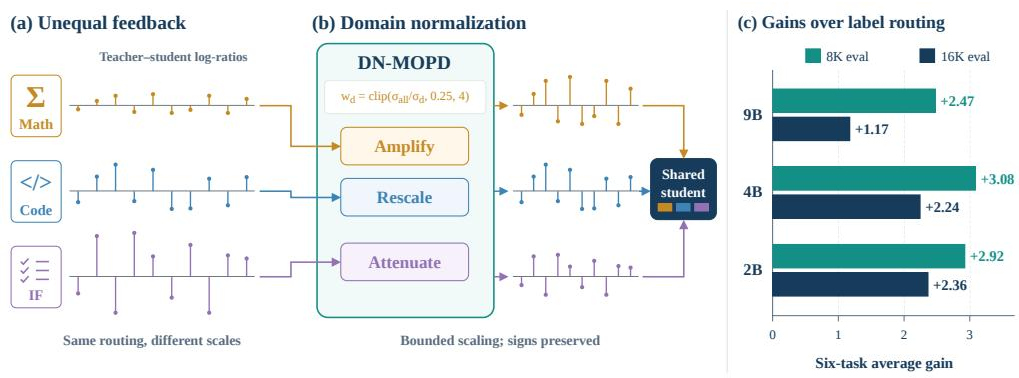
大型语言模型的后训练越来越依赖领域特定的强化学习,产生数学、代码和指令遵循的独立专家,这些专家必须被整合到一个可部署模型中。多教师 on-policy 蒸馏(MOPD)通过将每个提示路由到其领域专家,并使用该专家对学生自身回答的 token 级 log 概率来整合这些专家,但仅靠路由无法控制每个专家反馈的权重。固定权重或基于差距的领域权重忽略反馈离散度的差异,因此分散的指令遵循反馈可能主导共享梯度,而数学迁移仍然较弱。作者提出了 Domain-Normalized Multi-Teacher On-Policy Distillation(DN-MOPD),该方法在每个 batch 上估计每个领域内教师-学生 log 比值的离散度,并应用有界乘数,使每个领域的蒸馏优势接近汇总后的尺度。在 9B、4B 和 2B 的 Qwen3.5 专家池上,DN-MOPD 在六任务平均得分上优于 MOPD,并恢复了 MOPD 丢失的大部分数学增益,同时没有增加额外的教师模型、教师调用或学习路由器。
方法
作者提出了 DN-MOPD,该方法保留多教师 Online Policy Distillation(OPD)的领域标签分配,同时引入领域归一化步骤。在更新共享学生模型之前,根据当前 batch 的相对反馈离散度对每个领域的蒸馏优势进行重新缩放。
训练设置从一个初始模型开始。三个副本分别通过强化学习独立训练,成为数学、代码和指令遵循(IF)的专家。第四个副本作为学生 πu,训练目标是获得全部三种技能。每个训练提示带有领域标签 d∈{math, code, IF},Td 表示对应的领域专家。
为了生成反馈,学生首先生成对提示的回答 y=(y1,…,yn)。匹配的领域教师随后评估该回答,通过比较教师的 token 概率与学生的 token 概率来计算 token 级蒸馏优势:
At=logpTd(yt∣ht)−logπu(yt∣ht)其中 ht=(x,y<t)。正 At 鼓励采样到的 token,负值则抑制该 token,其幅度对策略梯度贡献进行加权。
然而,独立训练的专家会产生不同尺度的优势。例如,IF log 比率可能显著比数学 log 比率更分散。为解决这一问题,DN-MOPD 使用每个领域内反馈的标准差进行领域归一化。对于回答 i,log 比率定义为 ri,t=ℓi,tT−ℓi,troll,其中 ℓT 是教师的 token log 概率,ℓroll 是学生缓存的 rollout log 概率。在每个 batch 中,σd 表示领域 d 的有效 token 上 ri,t 的总体标准差,σall 是在所有领域汇总的全部有效 token 上计算的标准差。每个领域被赋予一个乘数:
wd=clip(σdσall,0.25,4),At=wdAt该规则放大离散度较小的反馈,并衰减离散度较大的反馈,目标是离散度本身,而不是将该统计量视为教师质量的估计。通过乘以正因子而不减去领域均值,该方法保留了每个优势的符号。边界 [0.25,4] 在尺度比率极端时限制调整幅度。
完整的训练迭代如下所示。
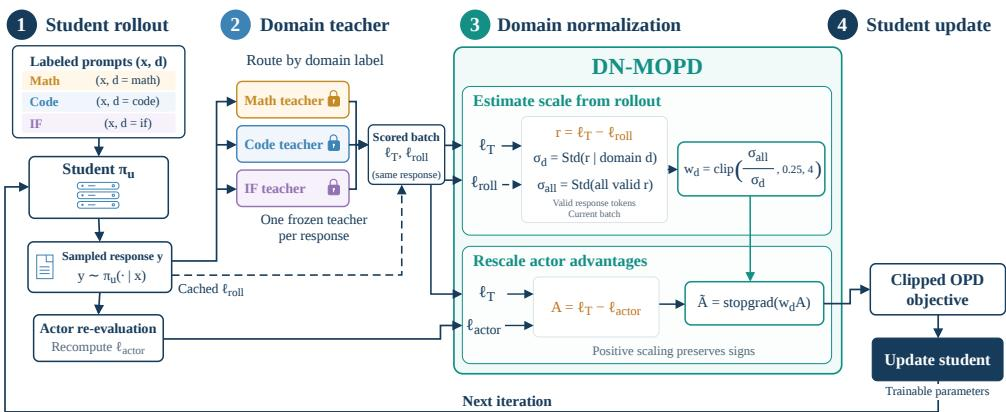
对于学生更新,actor 在采样的回答上重新计算更新前的学生 log 概率 ℓactor,以形成 Ai,t=ℓi,tT−ℓi,tactor。缩放后的优势被停止梯度,Ai,t=stopgrad(wdiAi,t),并用于基线 clipped OPD loss。将策略比率定义为 ρi,t(θ)=πθ(yi,t∣hi,t)/exp(ℓi,tactor) 后,token loss 计算如下:
Li,t(θ)=−min{ρi,t(θ)Ai,t,clip(ρi,t(θ),1−η−,1+η+)Ai,t}其中 η− 和 η+ 是策略比率裁剪边界。损失归约先对每个回答内的有效 token 损失求平均,再对回答之间求平均。将所有 wd 设为 1 会恢复标准的按标签路由 OPD 基线。
实验
实验在 9B、4B 和 2B 的 Qwen3.5 模型上,在数学、代码生成和指令遵循任务中评估 DN-MOPD 与按标签路由 OPD 及多个基线,并对评估长度和训练时长进行敏感性检查。DN-MOPD 在不同模型规模和评估预算下均一致优于按标签路由 OPD,增益集中在数学上,并源于重新校准各领域反馈权重,而不是改变教师分配或使用更长回答。消融实验表明,改进主要来自放大数学反馈并下调指令遵循反馈权重,后者尽管贡献的 token 很少,但否则会主导共享更新。该优势还体现在超过最强单教师学生,并在更长训练和评估预算下持续存在,尽管最终收敛时的排序仍未确定。
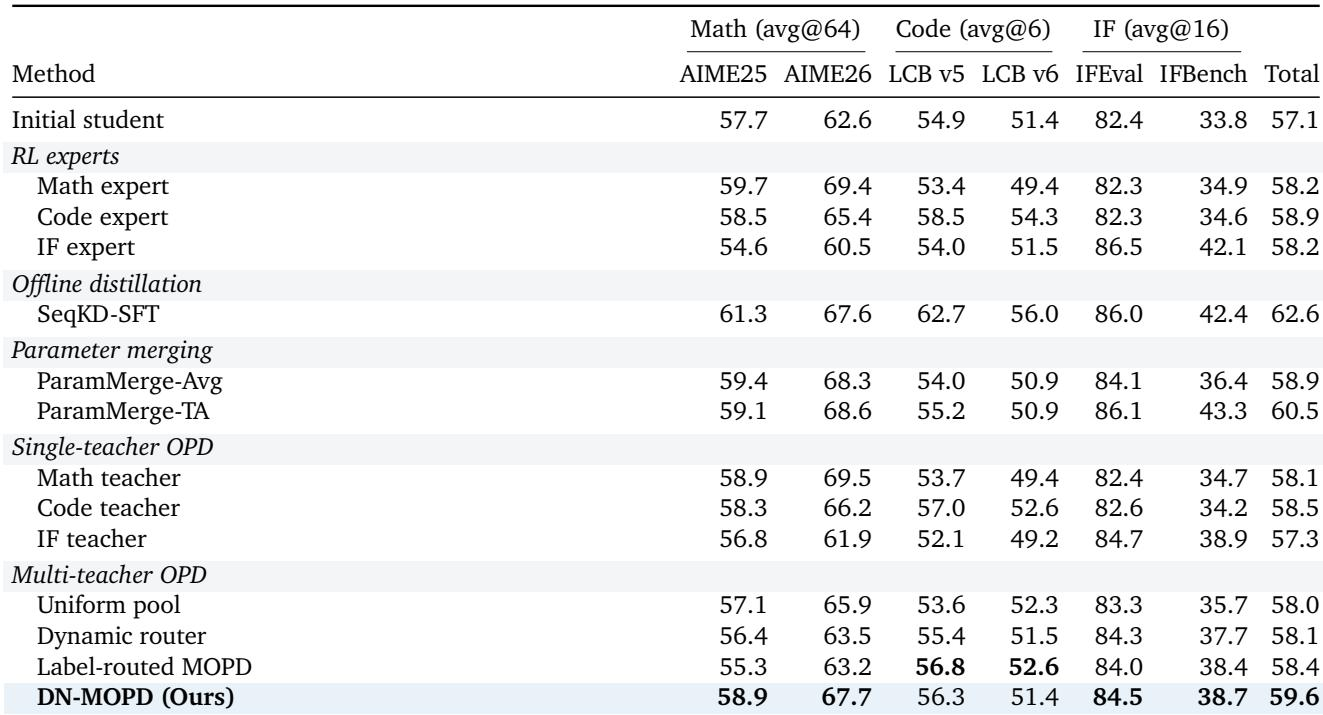
在 9B 规模下,多教师整合显示 DN-MOPD 主要通过更强的数学迁移优于按标签路由基线。最强单教师学生仍然是有竞争力的参考,按标签路由基线未能超过它,而 DN-MOPD 做到了。代码和指令遵循的增益较小且不太一致,表明最明显的好处来自改进按标签路由反馈的使用方式。DN-MOPD 在 9B 下优于最强单教师学生,并且其优势随着训练延长而扩大。数学贡献了大部分改进,而代码和指令遵循增益仍然较小且不太一致。按标签路由基线从未超过最强单教师学生,而 DN-MOPD 做到了。
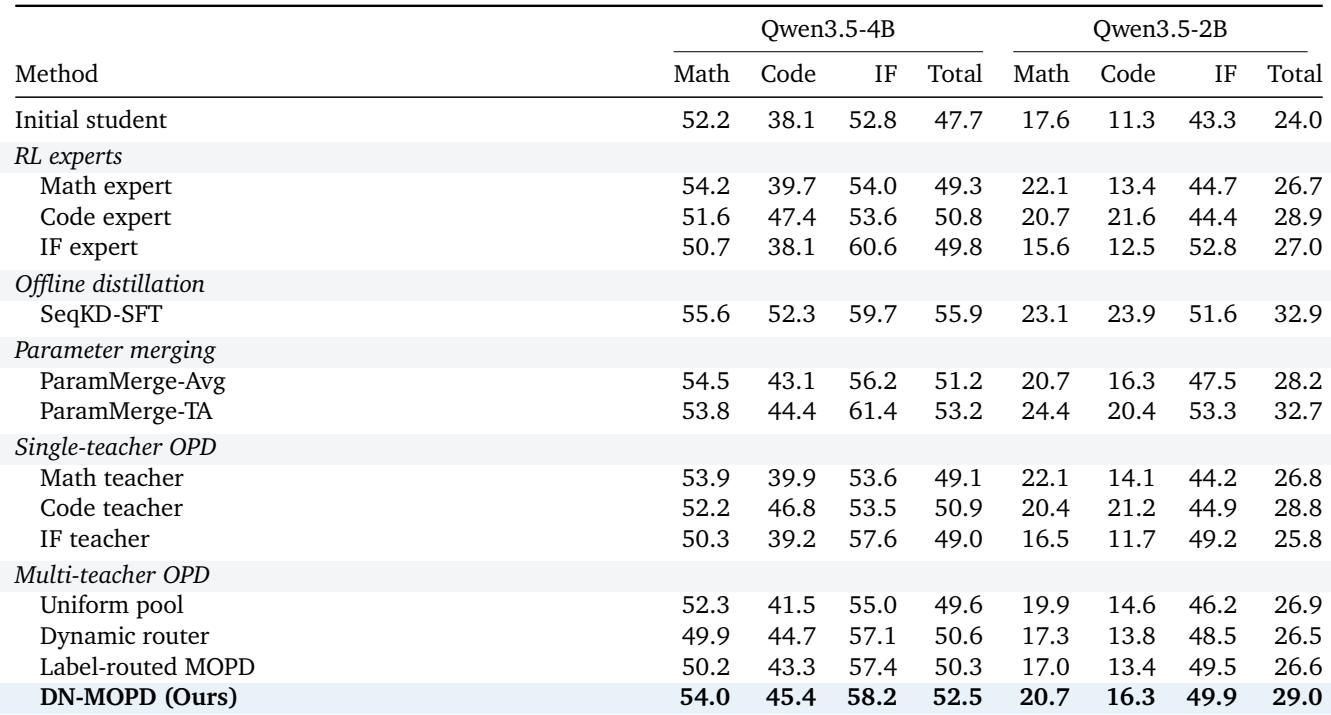
在较小规模下,单个专家在其自身领域上比初始学生有所提升,但多教师整合的增益并不均衡。DN-MOPD 在所有模型规模下均优于按标签路由基线,数学是主要增益来源,而代码和指令遵循的增益较小或不太一致。该收益主要归因于校准反馈尺度,尤其是降低指令遵循的影响,而不是改变教师选择或使用更长生成。在两个较小规模下,单个专家在其专业领域均有所提升,而它们对其他领域的影响各不相同。DN-MOPD 在所有规模下均超过按标签路由基线,数学带来最明显的增益,指令遵循权重的下调贡献了大部分改进。
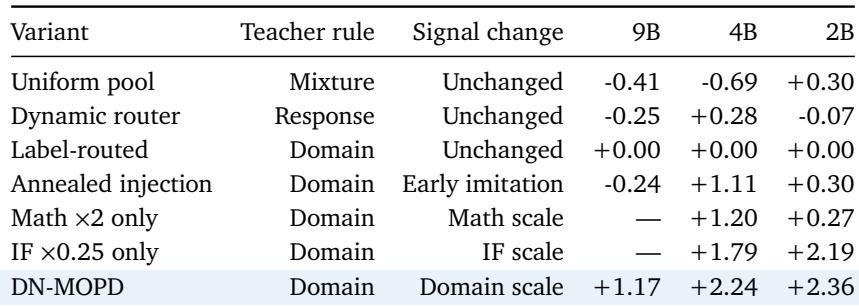
相对于按标签路由 OPD,DN-MOPD 在所有测试模型规模上提高了总分,而通过均匀池化或动态路由改变教师分配则产生不一致且有时为负的变化。将 IF 权重固定降为 0.25 能在 4B 和 2B 上恢复大部分 DN-MOPD 增益,而将数学权重加倍只能带来部分或很少的好处。这支持将增益主要归因于反馈尺度校准,尤其是限制 IF 影响,而不是教师选择变化。DN-MOPD 是唯一在所有测试模型规模上都优于 Label 的变体,在 4B 和 2B 上的增益大于 9B。均匀池化和动态路由在不同规模上带来好坏参半或负面的变化,与 DN-MOPD 的一致改进不同。仅将 IF 权重下调至 0.25 在 4B 和 2B 上几乎与 DN-MOPD 相当,而将数学权重加倍在 4B 上只能恢复部分增益,在 2B 上收效甚微。
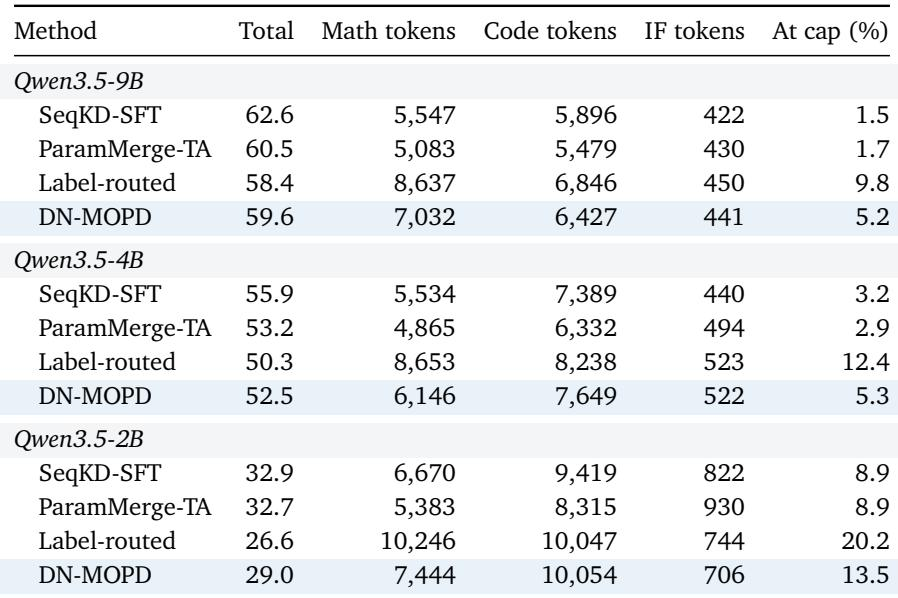
数据报告了按领域划分的平均回答 token 数,以及若干 9B 方法和一个 4B 基线中达到 16K 生成上限的输出占比。在 9B 方法中,Label-routed 的数学回答最长且命中上限的比例最高,而 DN-MOPD 降低了两者,这与其数学增益来自更好的反馈校准而非更长生成一致。指令遵循 token 在所有方法中仍只占回答量的一小部分,尽管随附分析描述其训练信号具有不成比例的影响。在所列 9B 方法中,Label-routed 生成的数学回答最长,达到 16K 上限的输出占比最大,而 DN-MOPD 降低了两项指标。SeqKD-SFT 和 ParamMerge-TA 在 9B 方法中命中上限率最低,表明其输出更不容易达到生成长度限制。指令遵循回答在每种所列方法中仅占领域 token 的一小部分,这与观察到的情况一致:指令遵循提供约 1% 的回答 token,但可能主导梯度方差。4B SeqKD-SFT 基线的代码回答比数学回答更长,而 9B SeqKD-SFT 模型的数学和代码长度更接近。
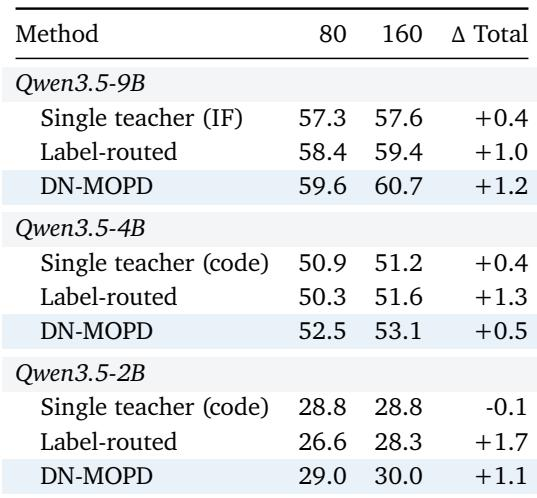
将训练从 80 次更新延长到 160 次,在 16K 评估设置下六任务总分有适度提升。DN-MOPD 在所有模型规模和两个训练端点上都保持领先于 Label-routed 和单教师基线,尽管更长训练缩小了较小规模上的差距。更长训练提升了所报告的方法,单教师模型的增益小于 Label-routed 和 DN-MOPD。DN-MOPD 在 80 和 160 次更新以及所有模型规模上均保持六任务最高总分。该优势在主要训练端点之后仍然存在,尽管更长运行在较小规模上缩小了差距。
实验在 9B、4B 和 2B 模型上,在涵盖数学、代码和指令遵循的六项任务中,将 DN-MOPD 与按标签路由 OPD 和单教师基线进行比较。DN-MOPD 在每个规模上均一致优于按标签路由基线,在 9B 上超过最强单教师模型,并在数学上表现出最明显的增益,而代码和指令遵循的改进较小或不一致。消融将增益主要归因于反馈尺度校准,尤其是下调指令遵循影响,而不是教师选择或更长生成;回答长度结果通过显示数学回答长度和上限率下降佐证了这一点。延长训练使 DN-MOPD 在所有测试规模上保持领先于基线,尽管更长运行在较小规模上缩小了差距。