Command Palette
Search for a command to run...
是什么让世界动作模型能够泛化?一项关于测试时未来建模的实证研究
是什么让世界动作模型能够泛化?一项关于测试时未来建模的实证研究
摘要
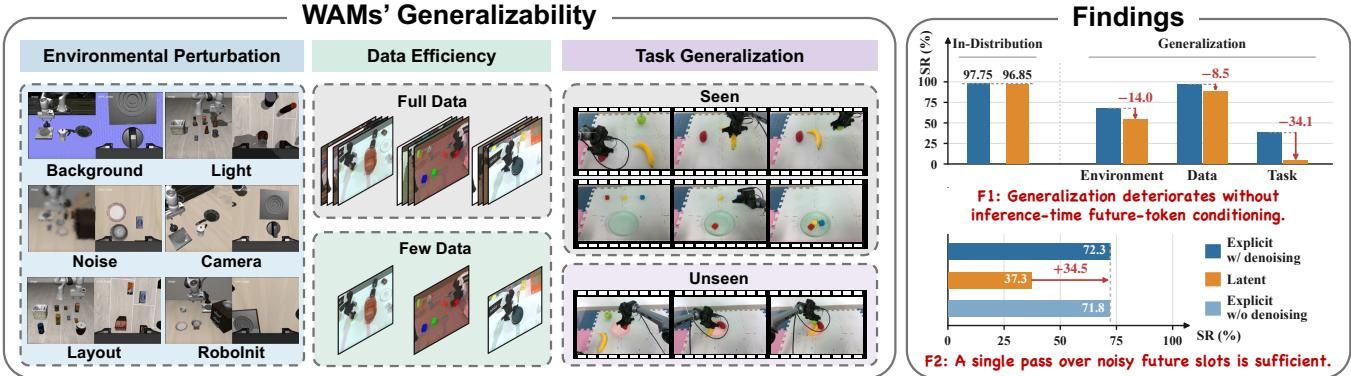
世界动作模型(WAM)在训练过程中同时预测未来与动作。由于视频去噪的计算开销较高,推理时是否仍必须生成未来存在争议:显式 WAM 会随每个动作块将未来去噪为干净帧,而隐式 WAM 则完全丢弃未来以加速。我们发现,尽管隐式 WAM 在分布内任务上与显式 WAM 表现相当,却无法保留最初推动 WAM 发展的泛化收益。为证明这一点,我们从环境扰动、数据效率和任务泛化三个维度评估泛化能力。在主干网络、训练数据和计算预算均匹配的受控对比中,当动作专家模块不再以未来表示为条件时,三个维度均出现一致的性能下降。进一步分析表明,该差距几乎完全源于第一个去噪步骤:收益来自对未来的准备,而非生成未来。因此,我们提出 Simple-WAM,将未来建模简化为对完全加噪的视频 token 的单次前向传播,并使训练时的噪声调度适配这一推理行为。在仿真和现实世界任务中,Simple-WAM 兼得两者之长,在泛化性能上领先显式 WAM,同时效率与隐式 WAM 相当。
一句话总结
Leap Lab(清华大学)等提出 Simple-WAM,它把未来建模简化为对完全加噪视频 tokens 的单次前向传播,并使训练时的噪声调度适应这种推理行为;此前研究表明,隐式 WAM 会失去显式 WAM 的泛化收益,因为动作专家不再以未来表征为条件。Simple-WAM 达到隐式 WAM 的效率,并在仿真和真实世界任务上优于显式 WAM。
核心贡献
- 一个覆盖环境扰动、数据效率和任务泛化的匹配评估框架表明,当去除推理时的未来条件化后,隐式世界动作模型会持续丧失泛化能力。
- 在匹配的骨干网络、训练数据和预算下进行的对照比较,将泛化差距几乎完全追溯到第一个去噪步骤,说明准备未来视频 tokens 比生成干净的未来帧更重要。
- Simple-WAM 使用完全加噪视频 tokens 的单次前向传播,并使训练时的噪声调度适应这种推理行为,在泛化性能上领先显式世界动作模型,效率与隐式模型相当。
引言
世界动作模型(WAM)旨在通过联合预测未来视频帧和动作来构建可泛化的机器人策略,利用网络规模的视频预训练提供丰富的时空先验,以及超越稀疏动作标签的观测空间监督。这种未来建模能力被视为相比视觉-语言-动作模型的关键优势,因为后者的静态图像-文本预训练几乎不提供时序理解。一个核心的开放问题是,推理时是否也必须生成未来视频。显式 WAM 在动作旁边去噪未来帧,这支持泛化,但由于视频 tokens 数量远超动作 tokens,会使高频闭环控制成本很高。隐式 WAM 跳过测试时视频生成,并在分布内任务上与显式 WAM 表现相当,同时成本低得多;但此前的比较没有隔离推理时未来建模如何影响最初催生 WAM 的更广泛泛化能力。作者引入了一个覆盖环境鲁棒性、数据效率和任务泛化的受控评估,发现隐式 WAM 在这三个轴向上均落后,并提出 Simple-WAM:它在单次前向传播中以完全加噪的未来 tokens 为条件,以接近隐式推理的成本恢复大部分泛化收益。
方法
作者采用了一个语言条件的视觉运动控制框架,该框架将视频专家与动作专家耦合。在每个控制步骤 t,策略接收图像观测 ot、语言指令 ℓ 和本体感觉状态 st,预测动作块 At=at:t+H−1。视频专家处理跨越当前帧和未来帧的潜变量序列,而动作专家在独立的 flow time 上回归速度场。
为了理解所提出方法的设计,有必要考虑两种现有的条件化范式。显式世界动作模型在整个调度过程中迭代地去噪未来视频 tokens,提供丰富的未来上下文,但推理成本较高。相反,隐式世界动作模型在推理时完全丢弃未来视频 tokens,仅依赖当前帧来实现高效率,但牺牲了泛化能力。
有关这些条件化方案的直观比较,请参见框架图。
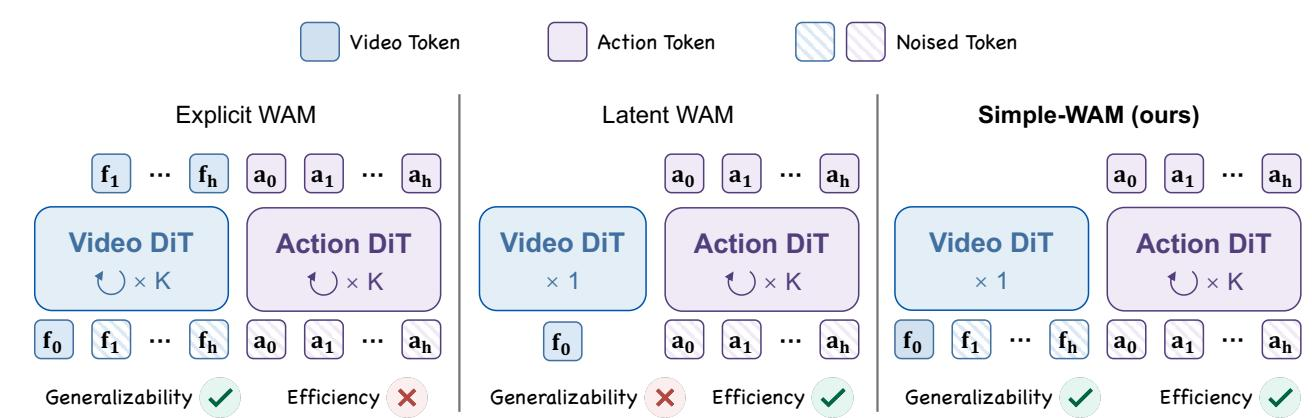
所提出的 Simple-WAM 弥合了这一差距:保留显式范式的未来视频 tokens,同时采用隐式范式的单次前向传播效率。推理时,模型放弃对未来视频 tokens 的迭代去噪。相反,视频专家在序列上执行单次前向传播,未来视频 tokens 在 flow time τ=1 处保持为纯高斯噪声。所得特征为所有 K 个动作步骤提供条件,从而有效平衡显式方法的泛化能力与隐式方法的计算效率。
为了支持这种推理策略,作者引入了一种混合训练调度。由于推理完全依赖在 τ=1 处提取的特征,训练过程必须增强从纯噪声中读取特征的能力。未来视频 tokens 的 flow time 采样方式为:以概率 p 取 τ=1,否则从标准 flow-time 调度中采样。这种混合确保视频专家针对推理时遇到的噪声水平得到专门优化,同时剩余训练预算继续在调度其余部分提供监督。两个专家联合训练,最小化动作速度场和视频速度场的组合损失。
实验
本文沿环境扰动、数据效率和任务泛化三个方向评估世界动作模型泛化,使用受控的显式和隐式推理时未来条件化范式。结果发现,分布内表现相当掩盖了巨大差距:在推理时去除未来建模会损害泛化,而以完全加噪的未来为条件已经能提供大部分收益。Simple-WAM 在此基础上使用噪声级别的未来条件化,在仿真和真实世界基准上达到或超过显式未来建模,且推理成本显著更低。消融实验表明,混合调度具有鲁棒性,加噪视频 tokens 优于可学习查询或零向量,因为它们与视频预训练保持一致。
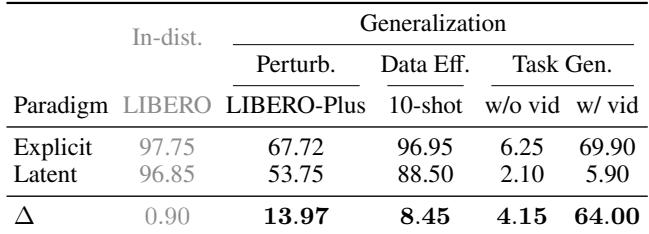
在匹配的分布内设置下,显式和隐式未来条件化表现相当。在环境扰动、数据效率和任务泛化方面,显式范式持续领先,当留出任务有无动作视频可用时差距最大。这表明未来建模在推理时是必需的,而不仅仅是训练目标。显式和隐式范式的分布内成功率几乎相同。在环境扰动和减少演示数据的设置下,显式未来建模保持明显优势。无动作视频为显式范式在留出任务上带来很大收益,而隐式范式仍接近其无视频水平。即使分布内表现看起来相当,在推理时去除未来建模也会降低泛化能力。
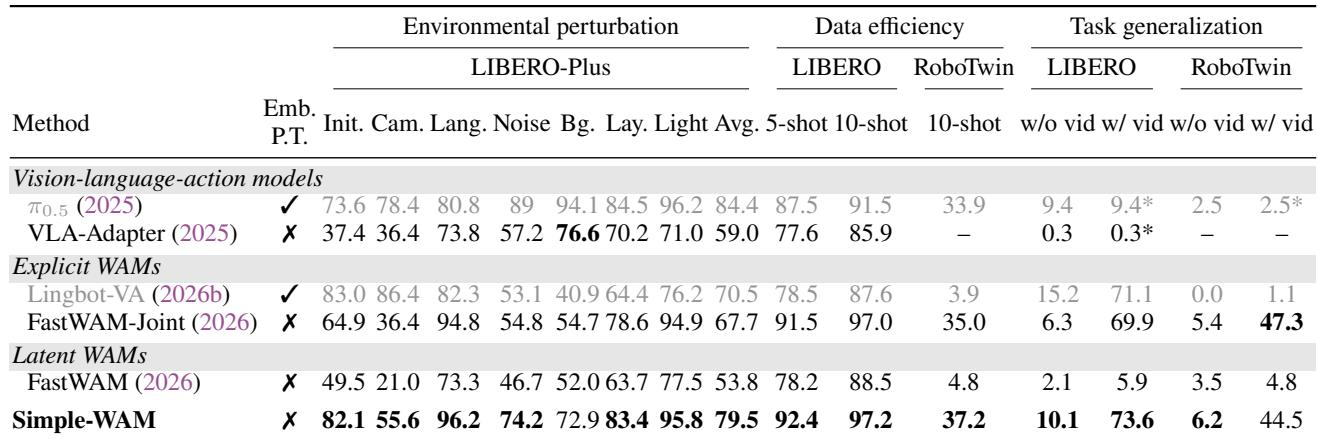
Simple-WAM 保留了显式未来建模的大部分泛化收益,同时推理成本更接近隐式模型。在环境扰动、数据效率和留出任务泛化方面,隐式未来建模落后,而加噪未来条件化无需迭代去噪即可恢复性能。这支持未来建模是测试阶段鲁棒性和泛化的必要条件。Simple-WAM 在环境扰动上领先没有具身预训练的方法,并缩小了与大规模具身预训练基线的差距。与显式未来建模相比,Simple-WAM 每个动作块的推理速度显著更快,同时在低数据和留出任务泛化上保持竞争力。
在 LIBERO-Spatial 上的消融表明,混合调度取中间概率时具有鲁棒性,并优于两个极端,其中数据效率在不同设置下仍是最稳定的维度。两个端点在环境扰动和任务泛化上损失最大。用可学习查询或零向量替换加噪未来视频 tokens 会导致所有维度急剧下降,尤其是任务泛化,这凸显了与预训练对齐的加噪视频条件化的重要性。中间混合概率优于两个极端,平均性能在中间范围内保持稳定。用可学习查询或零向量替换未来视频 tokens 会降低所有维度,其中任务泛化损失最大。
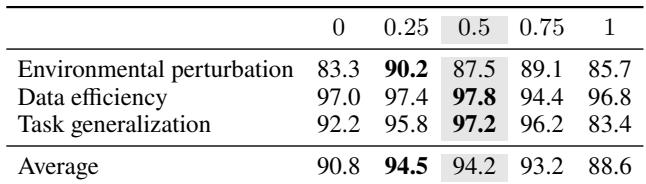
实验在分布内、环境扰动、数据效率和留出任务泛化设置下比较了显式和隐式未来条件化,并在 LIBERO-Spatial 上进行了消融。显式未来建模在分布内表现相当,但在分布偏移和低数据场景下持续领先,尤其是当无动作视频可用时;而通过 Simple-WAM 进行的加噪未来条件化以更低推理成本保留了这些收益。消融实验表明,混合调度的中间概率具有鲁棒性,用可学习查询或零向量替换加噪未来视频 tokens 会显著降低所有维度,尤其是任务泛化。总体而言,未来建模在推理时是必需的,而不仅仅是训练目标。