Command Palette
Search for a command to run...
PanoVLN:迈向有效的全景视觉-语言导航
PanoVLN:迈向有效的全景视觉-语言导航
Zhen Wang Changpeng Wang Zhe Liu Zhangyang Qi Yuxiang Lu Zimo Zeng Donglian Qi Xi Chen
摘要
近年来,视觉-语言模型(VLM)推动了视觉-语言导航(VLN)的发展,使模型能够根据视觉观测和语言指令预测导航动作。本文探索基于全景观测的 VLN,并提出 PanoVLN。其动机很直接:更完整的视觉上下文应能支持更明智的导航决策。例如,全景图像可以揭示透视相机视野之外的通道,使模型无需额外探索即可识别预期路线。然而,我们发现仅将透视图像替换为全景图像带来的提升有限。我们的诊断结果表明,要充分利用更广的视野,需要修改动作预测、训练监督和视觉表示。第一,更广的视野支持更长时域的动作规划。我们让模型预测更长的动作序列,从而能够从单张全景图像出发执行更大角度的转向和后续移动。具体而言,我们提出了一种置信度引导执行(CGE)策略,动态决定在重新规划前执行多少个预测动作。第二,更广的视野也带来了更复杂的路线选择。因此,我们构建了具有频繁分支点和清晰指令的训练路线,为路线选择提供针对性监督。第三,全景导航需要理解不同观察方向之间的空间关系,而不仅仅是识别单个地标。我们融合来自 RGB 全景图像的语义特征和几何特征,以同时捕获场景内容和空间布局,而无需增加视觉 token。在使用 4B 骨干网络且仅以 RGB 为输入的条件下,PanoVLN 在 R2R-CE 和 RxR-CE 的 Val-Unseen 上成功率分别比先前 SOTA 提高 11.9% 和 8.7%。在四足机器人上的真实实验进一步表明,与先前 VLN 方法相比,PanoVLN 导航更快、停顿更少。我们的项目主页见 https://wangzhen-w.github.io/PanoVLN/。
一句话总结
浙江大学和香港大学的研究者提出 PanoVLN,一种全景视觉语言导航模型,该模型使用置信度引导执行来实现更长视界的动作、分支点训练监督以及语义与几何结合的 RGB 全景特征,在 R2R-CE 和 RxR-CE Val-Unseen 上的成功率比之前最先进方法分别高出 11.9% 和 8.7%,并能以更少停顿实现更快的真实四足机器人导航。
核心贡献
- PanoVLN 是一种全景视觉语言导航方法,它从单张全景图预测更长动作序列,并使用置信度引导执行来确定在重新规划前要执行多少预测动作。
- 一个包含 800 个 HM3D 场景、98K 条轨迹的决策中心训练数据集提供频繁的分支点和具有视觉依据的指令,并在转弯和停止点附近进行更密集采样,用于路线选择和完成监督。
- 该方法将同一 RGB 全景图中的语义 VLM 特征与几何 PanoVGGT 特征结合;使用 4B 纯 RGB 主干网络时,在 R2R-CE Val-Unseen 上达到 77.3% 成功率,在 RxR-CE Val-Unseen 上达到 78.0%,比之前最先进方法分别提升 11.9% 和 8.7%,并能以更少停顿实现更快的真实四足机器人导航。
引言
视觉语言导航 (VLN) 要求 agent 在环境中遵循自然语言指令,近年来视觉语言模型通过从视觉观测预测导航动作改进了该任务。大多数先前工作使用透视图像,这限制了每个决策点可用的视觉上下文。作者研究等距柱状全景图,其提供 360 度视图,能够显示通道、地标和备选路线。他们发现,在相同设置下仅将透视图像替换为全景图并不能提升性能,因此提出 PanoVLN,该方法通过更长视界的动作预测和置信度引导执行进行适配,构建了 98K 条轨迹的决策中心训练数据集,并将语义 VLM 特征与全景几何特征融合。该方法在 R2R-CE 和 RxR-CE 上取得了最先进的成功率,并能以更少停顿实现更快的真实机器人导航。
数据集
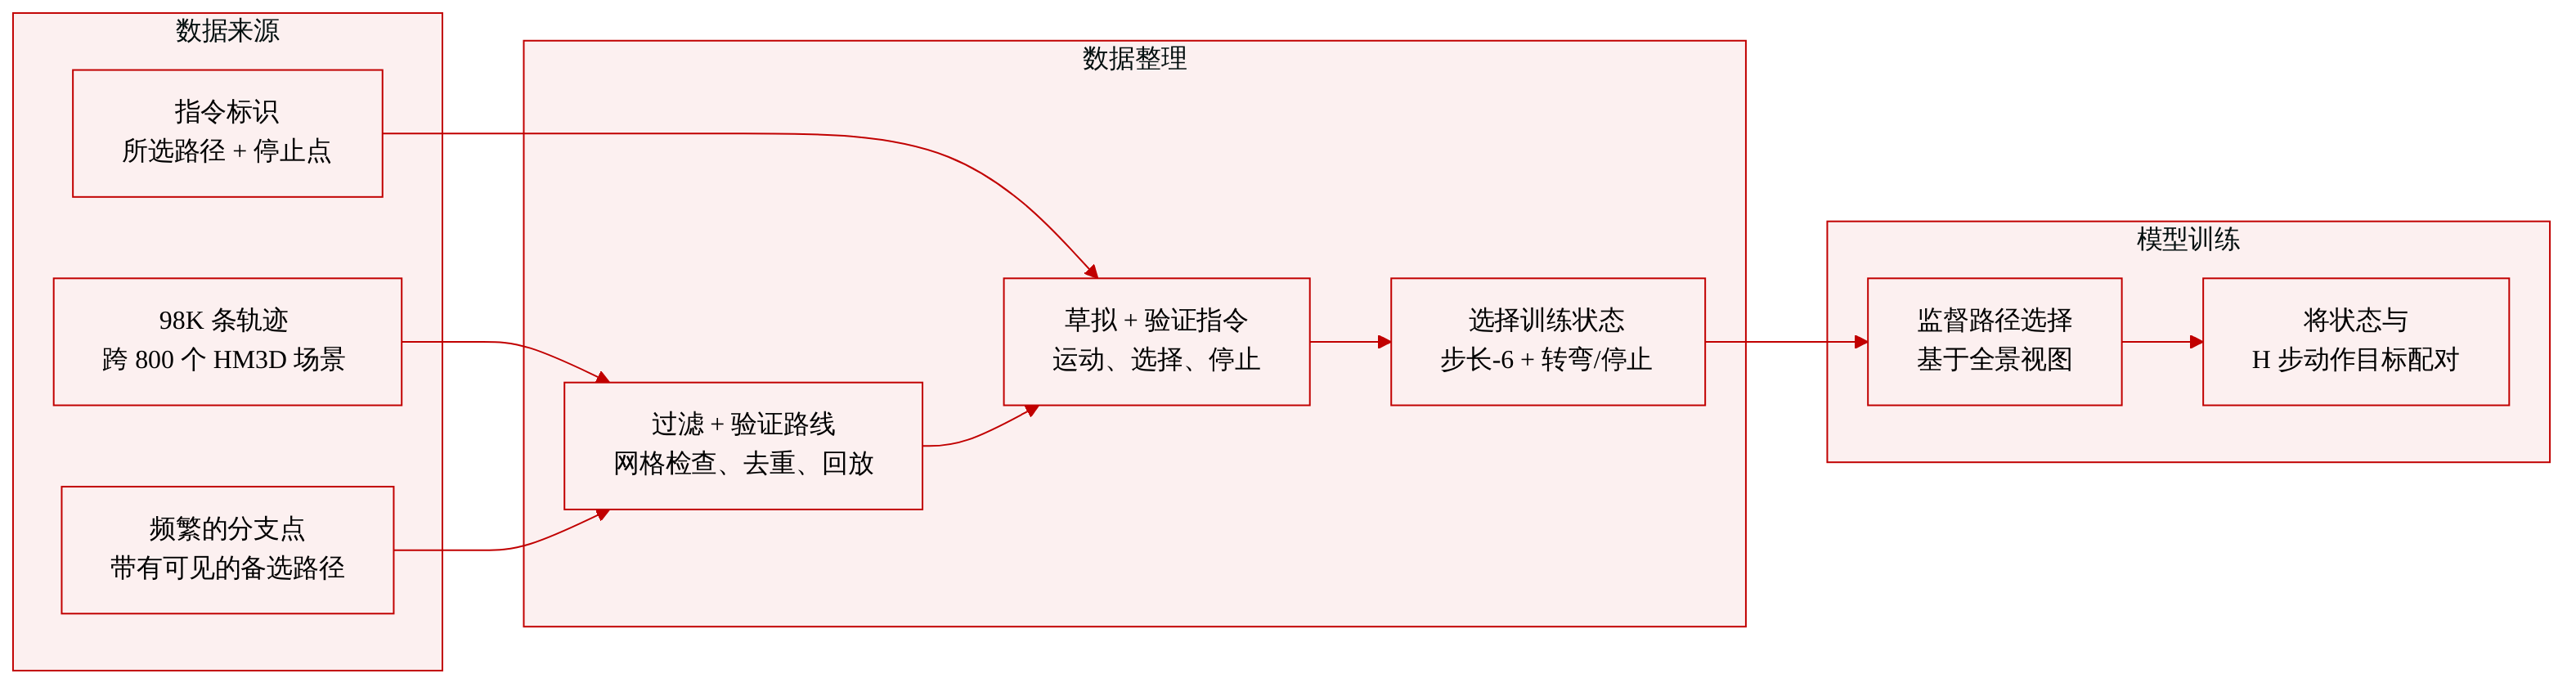
数据集组成与来源
- 作者在 800 个 HM3D 场景中构建了 98K 条导航轨迹。
- 轨迹被设计为包含频繁的分支点,agent 需要在这些点从多条可见可通行路径中做出选择。
- 每条轨迹配有一条指令,用于指明所选路径和停止位置。
路线构建与过滤
- 使用导航网格将可行走空间划分为连通区域。
- 分支点被定义为至少存在两条通往不同区域的可见可通行路径,且不包括来路。
- 在不同区域采样端点,并保留经过分支点的路线。
- 渲染质量检查会移除存在网格空洞或几何不完整的候选,之后进行近似重复去除。
- 专家将剩余路线转换为原子动作序列。
- 回放会验证目标可达性,并确认所选路径及其备选路径在每个分支点均可见。
指令构建与验证
- 轨迹被划分为行进段、分支段和到达段。
- 行进段使用第一视角视频,并在地面上标记专家路径。
- 分支段和到达段额外使用八视角罗盘图。
- Qwen3.8-27B 描述移动过程,从可见线索中识别所选路径,并指定停止位置。
- 描述按路线顺序组合,去除重复并精炼措辞。
- 验证使用不带指令或路线叠加的干净视频和罗盘图。
- 应用三项检查:运动一致性、选择依据和停止依据。
- 不匹配的段落在局部修订并重新验证;只有通过全部三项检查的样本才会被保留。
训练样本构建与使用
- 这些数据用于为从全景观测中学习路径选择提供监督。
- 对于 H = 18,作者使用步长为 6 的网格,将相邻网格目标之间的重叠从 17 个动作减少到 12 个动作。
- 在持续转弯起始处和接近终止处增加额外状态,以监督转弯和停止。
- 每个状态与其 H 步专家动作序列配对。
- 网格保持路线覆盖,新增状态则强调动作转换。
- 所给章节未指定训练/评估划分或混合比例。
方法
作者提出一种方法,以在视觉语言导航任务中充分利用全景图提供的完整视觉上下文。从以全景图为输入的基线模型出发,他们引入三项关键改进:更长动作序列监督与执行、决策中心数据构建和几何感知视觉表示。
为了利用全景观测更宽的可见范围,作者扩展了动作预测视界。策略不再预测单步动作,而是被训练为预测接下来 H 个专家动作的序列。训练目标使用教师强制最小化专家动作序列的负对数似然:
Lact=−H1i=1∑Hlogpθ(at,i∗∣Ot,At,<i∗)其中 At,<i∗ 包含前面的专家动作,pθ 是 VLM 的下一个 token 分布。
在推理期间,通过一种称为置信度引导执行的机制,根据预测不确定性调整执行长度。生成动作的不确定性定义为预测动作的负对数概率。如下图所示:
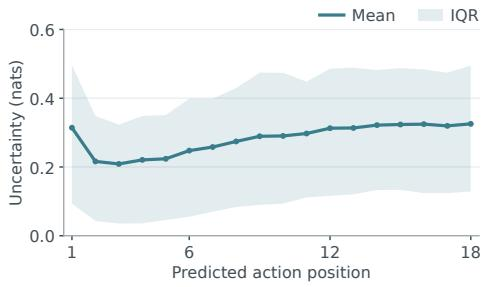
平均不确定性在初始下降后上升,并且在不同策略调用之间表现出显著变化。为应对这一点,执行机制在累积不确定性 Ut(k) 仍处于预定义预算 B 内时扩展已执行前缀,同时确保至少执行 Emin 个动作:
Et=max{k∈{1,…,H}:k≤Emin or Ut(k)≤B}agent 执行该前缀,然后重新观测环境,除非预测到停止动作。
为了更有效地监督从多个可见选项中选择正确路径,作者构建了决策中心训练数据集。他们在多个场景中生成导航轨迹,特别针对至少存在两条可见可通行路径的分支点。过滤掉存在渲染问题或近似重复的路线后,专家将有效路线转换为原子动作序列。指令通过将轨迹划分为行进段、分支段和到达段来构建。大语言模型使用第一视角视频和罗盘图描述移动过程并识别所选路径。作者严格验证运动一致性和选择依据,对未通过检查的段落进行修订,并仅保留通过所有检查的段落。为减少相邻训练状态之间的重叠,他们采用步长为 6 的网格进行采样,并在持续转弯起始处和接近终止处增加特定状态,以强调动作转换。
最后,作者开发了一种几何感知视觉表示,以更好地理解全景观测中的空间关系。他们为当前等距柱状全景图分配更多 token,而为每个历史帧分配较少的 token。为在不增加额外视觉 token 的情况下融合几何信息,预训练的 PanoVGGT 编码器从当前 RGB 全景图中提取几何特征。这些特征在 ERP 坐标中重采样并分组,以与 VLM 合并后的当前 token 对齐。可训练的 MLP 将对齐后的几何组投影到视觉 token 嵌入空间,用于残差融合:
Vˉt=Vt+αfψ(Gt)其中 α 是固定的残差尺度。该融合结合了对应 ERP 区域的语义和几何信息,同时保持 token 数量和顺序不变,最终与指令和历史 token 一起为动作预测提供条件。VLM 和投影层联合训练,而几何编码器保持冻结。
实验
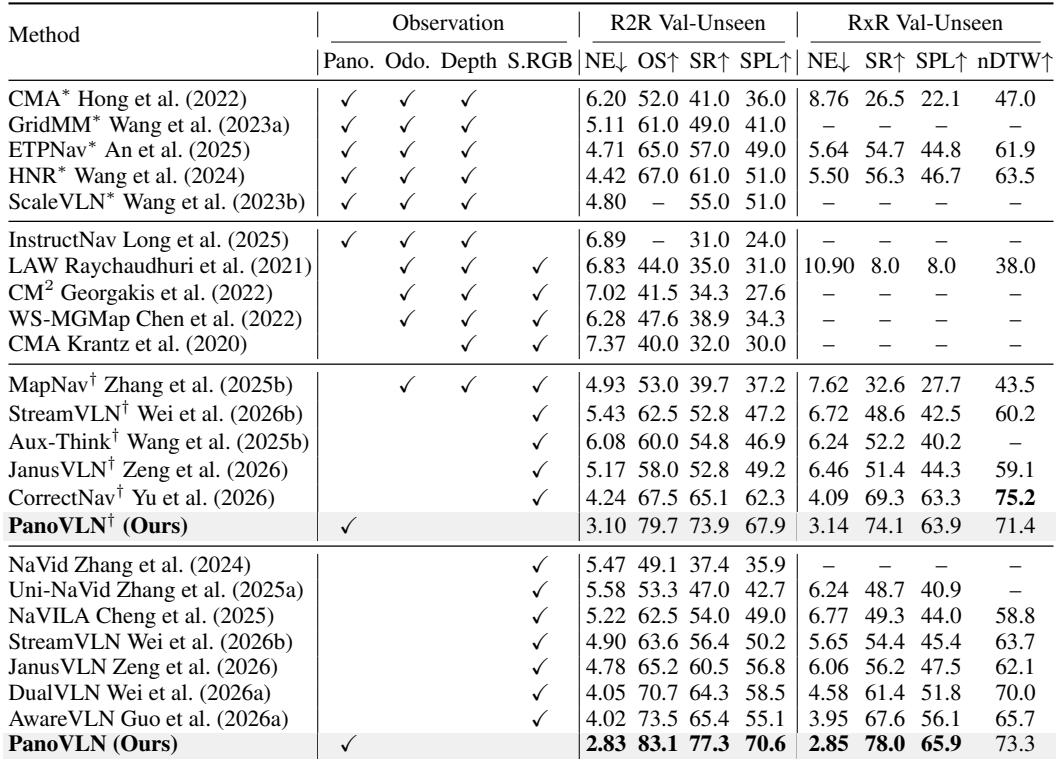
实验在 Matterport3D 中使用 Habitat 评估纯 RGB 的 PanoVLN 在 R2R-CE 和 RxR-CE Val-Unseen 划分上的表现,指标包括导航误差、成功率、SPL 和 nDTW。仿真结果表明,PanoVLN 在两个基准上均取得最先进的成功率,并受益于全景上下文;在 Unitree Go2 上跨走廊、办公室和校园场景的真实测试表明,该方法能够可靠完成室内路线跟随和室外迁移,并通过更长预测段落与置信度引导执行实现高效运行。消融实验确认,更长的 ERP 预测视界、转弯和终止感知采样、置信度引导执行、PanoVGGT 全景特征以及决策中心训练轨迹均能改善导航和停止行为。
PanoVLN 在 R2R-CE 和 RxR-CE 上均取得最高的成功率和 SPL,以大幅领先之前全景导航方法,建立新的最先进水平。受限数据版本的 PanoVLN 在其训练数据组中也在成功率和 SPL 上领先。这些结果将全景上下文和决策中心轨迹与未见场景中更好的泛化联系起来。PanoVLN 在 R2R-CE 上比之前最佳成功率高 11.9 个百分点,在 RxR-CE 上高 8.7 个百分点。在仅使用 R2R-CE 和 RxR-CE 导航数据训练的情况下,PanoVLN 在两个基准的受限数据组中仍然在 SR 和 SPL 上领先。添加决策中心轨迹进一步改善未见场景中的表现。
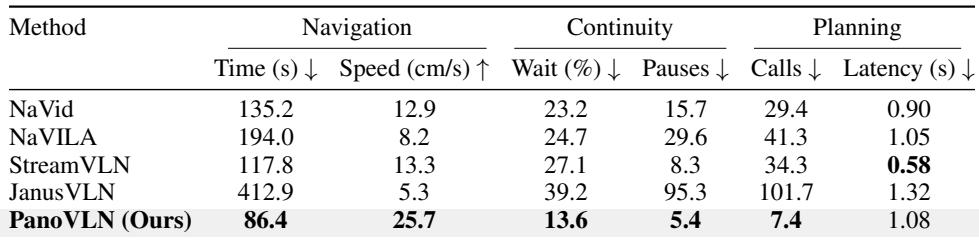
在所有真实世界路线中,PanoVLN 在所有比较方法中实现了最短导航时长和最高行进速度。它在等待策略响应上花费的时间也最少,并且停顿次数和策略调用次数远更少。尽管其单次请求推理延迟并非最低,但整体执行流程最高效。PanoVLN 同时具备最短导航时长和最高行进速度,而 JanusVLN 明显最慢。PanoVLN 的等待占比最低、停顿最少、策略调用最少,尽管其单次请求延迟并非最低。
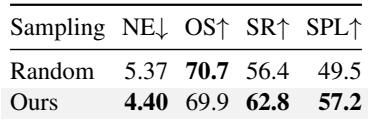
与随机起点采样相比,所提出的转弯和终止感知采样降低了导航误差,同时使 oracle 成功率几乎保持不变。它也使成功率和 SPL 明显提高,表明当转弯和停止状态获得更强监督时,终止和路线完成更可靠。所提出的采样相对于随机起点采样降低了导航误差,同时保持相近的 oracle 成功率。它提高了成功率和 SPL,表明目标区域的终止更可靠,转弯和停止状态得到更好监督。
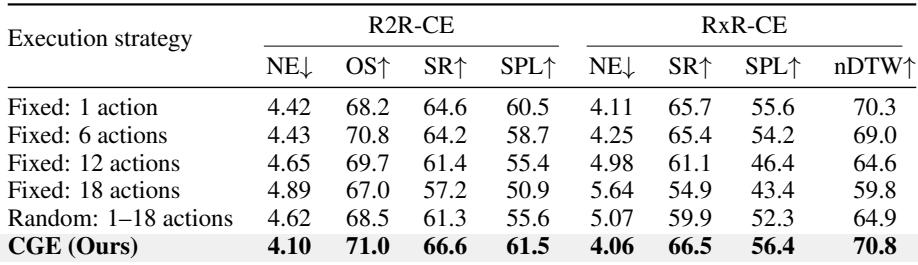
置信度引导执行在两个基准上均取得最佳导航性能,优于固定执行长度和随机执行。固定执行长度为一个动作是最强的固定设置,而更长的固定视界通常会降低成功率和路径质量。结果表明,根据模型置信度调整执行比固定为预设或随机动作数更可靠。置信度引导执行在两个基准上记录了最低导航误差以及最高的成功率和路径质量指标。在固定策略中,单动作执行最强,而更长的固定视界会降低成功率和 SPL,尤其在 RxR-CE 上。在 1 到 18 个动作上的随机执行不如置信度引导执行,且在 RxR-CE 上落后于单动作固定策略。
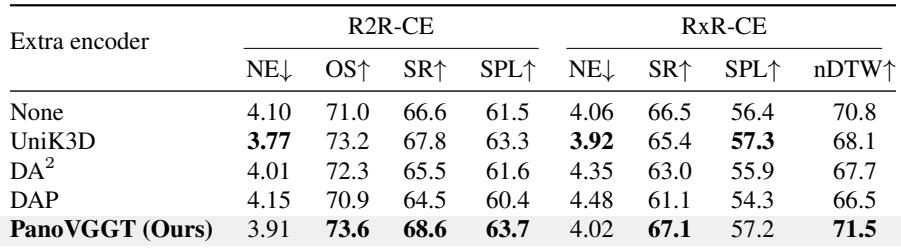
在相同融合和执行设置下,几何编码器比较显示现有编码器的效果好坏参半。PanoVGGT 在 R2R-CE 和 RxR-CE 上均达到最高成功率,并在 R2R-CE 的 oracle 成功率和 SPL 以及 RxR-CE 的 nDTW 上领先。结果表明其全景几何特征增加了支持路线选择的空间线索。PanoVGGT 在两个基准上的成功率均领先于所有比较编码器,并具有最佳的 R2R-CE oracle 成功率和 SPL 以及最佳的 RxR-CE nDTW。其他编码器效果不一:UniK3D 降低了 R2R-CE 导航误差并提高了 SPL,但未改善 RxR-CE 成功率,而 DA^2 和 DAP 倾向在两个基准上降低成功率。
实验在 R2R-CE 和 RxR-CE、真实世界导航路线以及采样、执行和几何编码器的消融上对 PanoVLN 进行基准测试。PanoVLN 在两个基准上以大幅优势刷新最先进的成功率和 SPL;其在真实世界运行中实现最短时长和最高速度,停顿和策略调用更少,尽管单次请求延迟并非最低。转弯和终止感知采样与置信度引导执行相比随机或固定基线改善了成功率和路径质量;在几何编码器中,PanoVGGT 给出最强整体结果,其他编码器效果不一。