Command Palette
Search for a command to run...
MaLiang-Harness:一条通往图像与视频生成的可编程路径
MaLiang-Harness:一条通往图像与视频生成的可编程路径
Haoyu Zhao Zihao Zhang Xudong Wang Jiaxi Gu Zuxuan Wu Yu-Gang Jiang Shuicheng Yan
摘要
可执行程序对图像和视频的构建方式提供了显式控制,但生成可运行代码只是视觉创作的起点。一个程序可能正确执行,却违背了所要求的构图、外观或运动。我们将这种差异定义为程序到视觉(P2V)差距,并引入 MALIANG-HARNESS——一个统一框架,用于将 MLLM 驱动的视觉生成组织为构建、检查与修订的持续过程。其核心设计是使不断演化的视觉程序、其构建历史及其验证共享一个共同的修订参照。我们将持久可执行生成(PEG)状态定义为保存程序与任务上下文;可追溯生成过程(TGP)将编辑与渲染证据关联起来;修订感知的编辑与验证(REV)支持恢复,并在完成前检查当前修订。这些机制共同协调跨渲染后端的规划、执行与视觉反馈。我们在 MaLiang-IBench 上评估了 11 个强大的闭源 MLLM,并在 MaLiang-VBench 上评估了四个,衡量生成成功率、视觉质量和计算成本。GPT-6-Astra 在两个基准上均实现了 100% 的生成成功率,其中 96.0% 的图像任务和 76.9% 的视频任务满足所有质量阈值。比较结果还揭示出通用能力得分与视觉生成性能之间的错位:得分相近的模型在满足视觉要求的能力上差异显著。MaLiang-Harness 为研究 MLLM 如何将可执行代码转化为视觉结果提供了系统性基础,同时揭示了可编程生成的潜力以及通用基准在预测该能力方面的局限性。项目地址为 https://github.com/gulucaptain/MaLiang-Harness。
一句话总结
来自新加坡国立大学、复旦大学和腾讯的研究人员提出了 MaLiang-Harness,这是一个统一框架,通过持久可执行生成、可追溯生成过程以及修订感知的编辑与验证,来解决 MLLM 驱动的图像和视频生成中的程序到视觉差距,并在 MaLiang-IBench 和 MaLiang-VBench 上对其进行了评估,其中 GPT-6-Astra 实现了 100% 的生成成功率。
核心贡献
- 提出并定义了程序到视觉(P2V)差距,即程序级正确性与视觉需求满足之间的差异,将视觉程序生成构建为构造、检查和修订的有状态过程。
- 提出了 MaLiang-Harness,一个用于可编程图像和视频生成的统一框架,其持久可执行生成状态、可追溯生成过程和修订感知的编辑与验证,支持跨渲染后端的持续细化、构造历史检查以及当前输出的验证。
- 在 MaLiang-IBench 上评估了 11 个 MLLM,在 MaLiang-VBench 上评估了 4 个 MLLM,覆盖生成成功率、视觉质量和计算成本。GPT-6-Astra 在两个基准上均实现了 100% 的生成成功率,而通用能力得分相近的模型在视觉生成结果上表现出显著差异。
引言
近期高质量的图像和视频生成主要遵循直接视觉合成,即模型学习视觉数据分布并生成像素或潜在表示,但这一过程仍然隐式。与此同时,多模态大语言模型使可编程生成更加实用,通过将创作意图表示为可执行视觉程序,由渲染器转换为输出。一个关键挑战是程序到视觉(P2V)差距:程序可以正确运行,却仍可能生成不符合用户视觉需求的图像或视频,而以往工作缺乏跨图像和视频后端的统一有状态检查和修订机制。作者引入了 MaLiang-Harness,该框架维护持久可执行状态,记录可追溯的生成过程,并将修订感知的验证与每次更新关联,使模型能够通过渲染反馈来细化视觉程序。在 MaLiang-IBench 和 MaLiang-VBench 上的评估表明,不同 MLLM 的生成成功率和视觉质量可能差异很大,即使在通用能力得分相近的模型之间也是如此。
方法
作者利用 MaLiang-Harness 探索图像和视频生成的另一条路径。该框架不依赖扩散或流匹配过程,而是使用多模态大语言模型(MLLM)通过统一的生成接口将提示转换为可执行视觉程序。
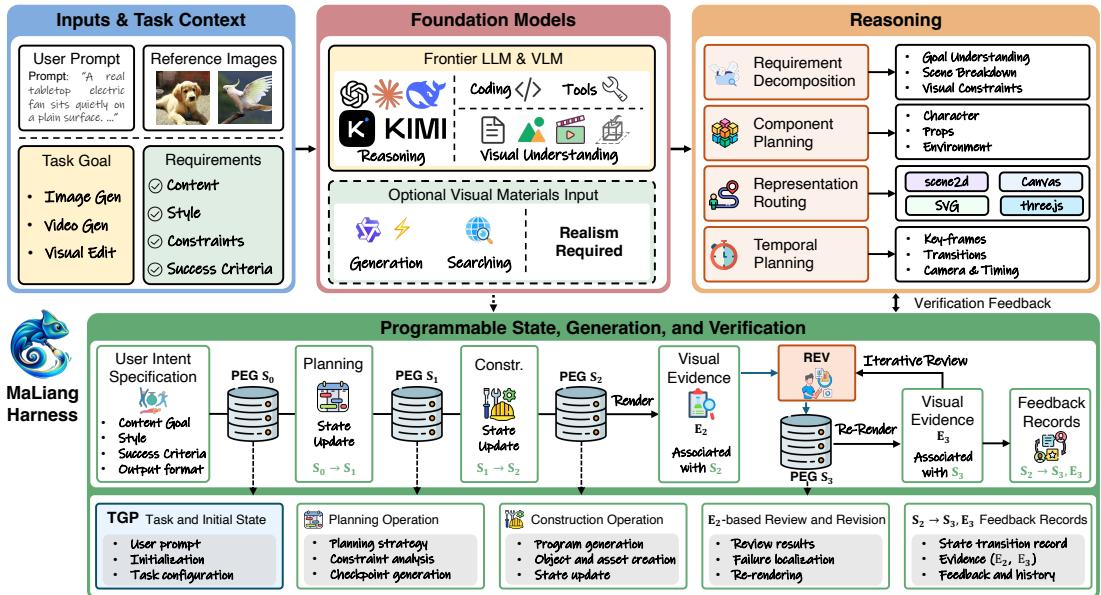
该框架采用 MLLM 规划和代码生成来构建具有表现力的视觉构图,然后由渲染器将其转换为图像和视频。视觉反馈在明确的空间和时间控制下指导生成的迭代细化。该系统建立在三个核心组件之上:持久可执行生成状态、可追溯生成过程以及修订感知的编辑与验证。
MaLiang-Harness 提供跨各种渲染后端的共享交互协议,例如 Canvas、SVG、Scene2d 或 Three.js。给定提示 p 和输出规范 ω,系统会规划外观、空间构图和时间动态,选择可执行表示和兼容后端 b,并生成绘制和动画代码。后端将生成的表示渲染为图像或视频,由 MLLM 根据任务要求进行评估。
为了管理这一过程,该框架维护持久可执行生成(PEG)状态。在第 k 次修订时,状态定义为 Sk=(Pk,Ak,Zk,Ck,k),其中 Pk 表示带有后端标识符的视觉程序,Ak 包含相关资产,Zk 描述空间构图和时间动态,Ck 保留包括提示和需求在内的生成上下文。状态更新与视觉渲染是分开的。编辑操作 ak 提交新状态 Sk+1=E(Sk,ak),而渲染器在内容时间 t 评估视觉程序,生成 Ik(t)=Rb(Sk,t;ω)。
在 PEG 状态保留可执行视觉表示的同时,可追溯生成过程(TGP)记录了这一表示的构建方式。对于第 j 个记录的操作,框架维护 τj=(oj,xj,yj,kj−,kj+),其中 oj 是已执行的操作,xj 和 yj 是其输入参数和执行结果,kj− 和 kj+ 标识来源修订和产生的 PEG 修订。这种可追溯性将记录的程序更改与修订特定的视觉证据联系起来,使系统能够诊断预期视觉结果与执行代码之间的差异。
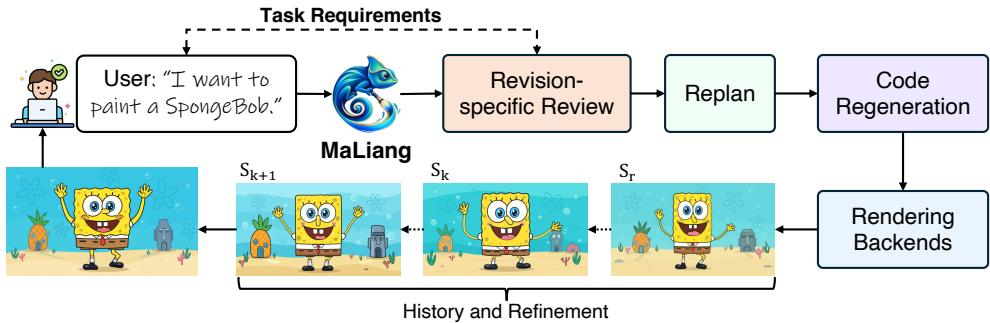
最后,修订感知的编辑与验证(REV)闭合了生成循环。对于 Ck 中的每个视觉需求 hi,REV 维护审查项 qi=(ki,Ei,vi),其中 Ei 包含来自修订 ki 的针对该需求的视觉证据,vi 表示验证状态。只有当 ki=k 时,审查项才适用于当前状态。当前修订只有在满足 Ready(Sk)=ExportOK(Sk)∧CheckpointOK(k)∧⋀hi∈Hk[ki=k∧Ei=∅∧vi=pass] 时才可交付。这一标准确保视觉验证严格与交付的修订绑定,使后续代码修订建立在观察到的视觉差异之上,而不是仅仅建立在执行成功之上。
实验
实验在 MaLiang-IBench 和 MaLiang-VBench 上评估 MaLiang-Harness,使用多个 DeepSeek、Kimi 和 GPT 模型的文本到图像和文本到视频提示,同时测量计算成本和生成质量。比较显示,成功生成与满足所有视觉质量标准之间存在明显差距,GPT-6 模型整体更强,运动连贯性是视频输出的主要限制因素。定性和讨论结果进一步表明,更丰富的渲染后端可以提高真实感,通用基准得分只能部分预测视觉程序生成性能,该框架支持检查构造和修订过程,但仍面临细化停滞和 token 限制失败。
现有的图像和视频生成模型覆盖了广泛的创意风格,并提供可控性和可编辑性,但其过程可追溯性尚未建立。MaLiang-Harness 除了对真实感仅部分支持外,支持同样的风格覆盖,同时增加了可检查的创建过程。这与其使用可执行视觉程序进行显式控制、定向编辑和可追溯构造相一致。现有的 T2I 和 T2V 模型支持所有列出的创意风格,而 MaLiang-Harness 对真实感仅部分支持。MaLiang-Harness 在可控性和可编辑性上与现有模型相当,并增加了过程可追溯性。其可执行视觉程序方法提供了显式控制、定向编辑和可检查的创建过程。
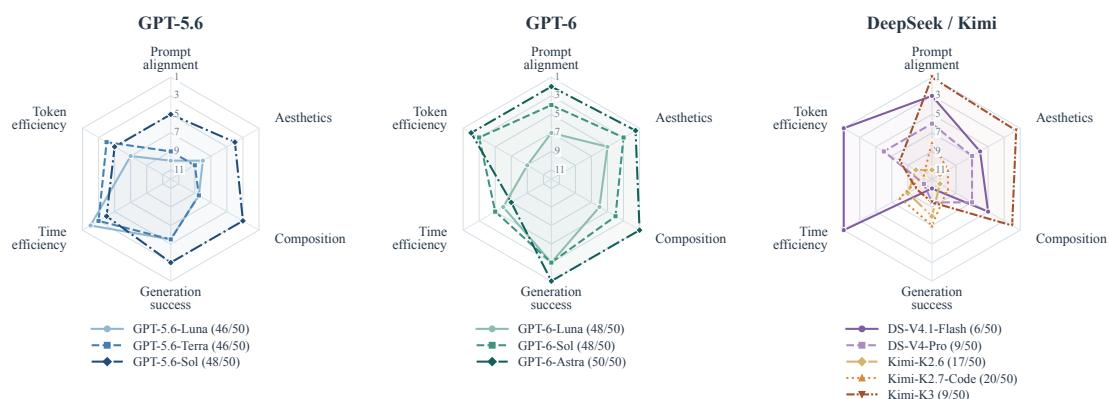
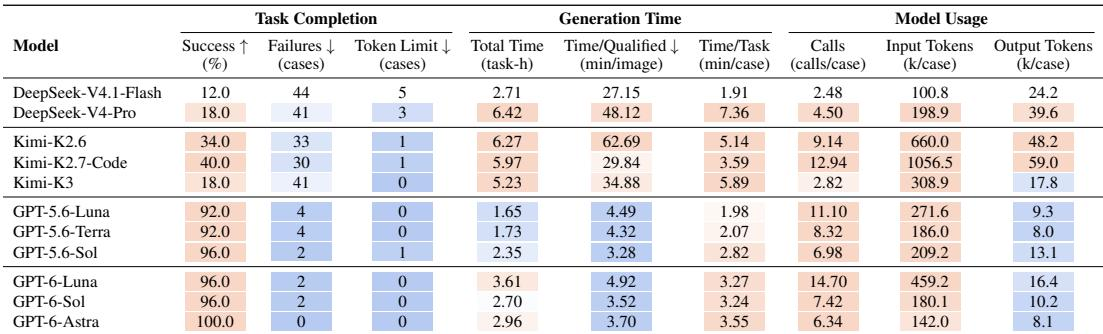
各评估模型的生成成功率和计算成本差异很大:GPT-5.6-Luna 的成功率远高于所示 DeepSeek 和 Kimi 模型,token 限制失败也更少,同时总时间和每张合格图像所需时间更少。仅凭成功生成并不能保证视觉质量,因为许多 GPT-5.6 生成任务可以完成,但只有大约一半满足全部三项质量标准,而 GPT-6-Astra 则将近乎完美的生成成功率与较高的质量通过率结合起来。成功率较低的模型往往在每张可用图像上花费更多时间,因此在解释其质量得分时,必须考虑其成功输出数量较少。GPT-5.6-Luna 的生成成功率显著更高,且没有 token 限制失败,其总时间和每张合格图像所需时间低于所示 DeepSeek 和 Kimi 模型。较高的完成率并不总是意味着较高的视觉质量:GPT-5.6-Luna 和 Terra 生成了大多数图像,但只有大约一半达到全部三项质量阈值,而 GPT-6-Astra 在几乎所有任务上都达到了这些阈值。
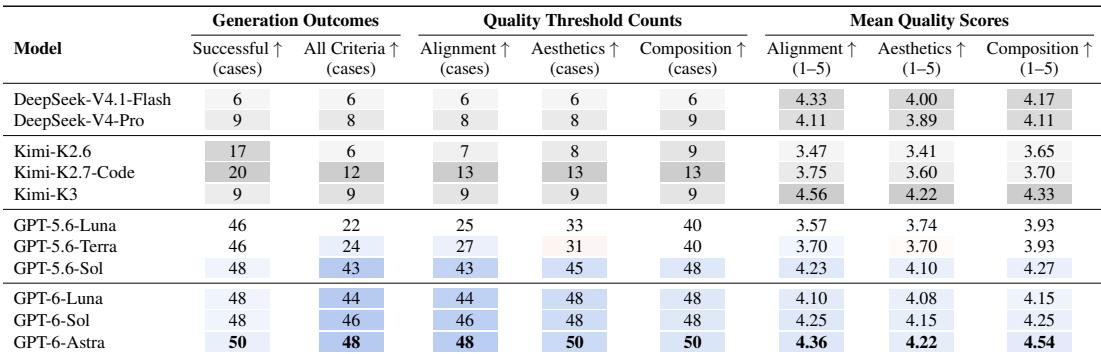
在 MaLiang-IBench 上,生成成功并不等同于达到所有视觉质量阈值。GPT-6 模型,尤其是 GPT-6-Astra,实现了广泛的生成成功和更强的质量结果,美学和构图基本得到满足,提示符合度是剩余失败的主要原因。DeepSeek 和 Kimi 模型成功生成的图像少得多,因此它们的平均质量得分仅反映有限子集,可比性较低。生成成功率始终高于达到全部三项质量阈值的输出比例。GPT-6-Astra 在 GPT 模型中实现了最高的生成成功率和最高的平均质量得分,所有成功图像都达到了美学和构图阈值。对于 GPT-6 模型,剩余的质量失败集中在提示符合度上,而不是美学或构图上。DeepSeek 和 Kimi 模型的生成成功率较低,因此它们的平均质量得分只描述了一小部分任务,应谨慎解释。一些 DeepSeek 和 Kimi 模型在有限成功样本上获得了较高的平均得分,但这并不能证明其在完整基准上的表现更优。
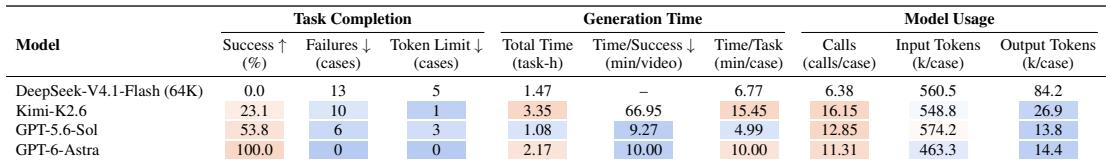
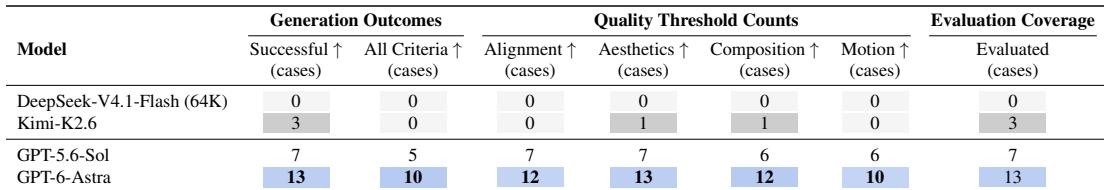
MaLiang-VBench 揭示了生成视频与达到所有质量阈值之间的明显差距。GPT-6-Astra 实现了完整的生成成功,没有失败或 token 限制案例,而 GPT-5.6-Sol 在每个成功视频和每个案例上的速度更快,但完成任务更少,完全合格的输出也更少。Kimi-K2.6 完成了一些任务,但没有一个达到全部标准,其每次成功生成的时间在所列模型中是最高的。GPT-6-Astra 是所列模型中唯一一个任务完全成功且失败或 token 限制案例为零的模型,并且它生成了最多的满足所有质量阈值的输出。GPT-5.6-Sol 在每个成功视频和每个案例上的时间低于 GPT-6-Astra,但其完成率和完全合格输出数量较低,显示出速度与质量的权衡。Kimi-K2.6 没有完全合格的视频,并且其每次成功生成的时间在有成功生成的模型中是最高的。
在 MaLiang-VBench 上,GPT-6-Astra 在所列模型中实现了最强的视觉质量结果,拥有最多的成功生成和最多满足所有质量阈值的案例。GPT-5.6-Sol 的质量较低但依然可观,其大多数成功生成达到了所有标准。Kimi-K2.6 完成了少量任务,但没有一个达到全部标准的案例,而 DeepSeek-V4.1-Flash 没有产生可评估或质量通过的案例。GPT-6-Astra 在成功生成数量、全标准案例以及对齐度、美学、构图和运动计数方面均领先所列模型。GPT-5.6-Sol 在大多数成功生成中达到全部质量阈值,而 Kimi-K2.6 只完成了少量任务且没有全标准案例,DeepSeek-V4.1-Flash 没有产生可评估案例。
这些实验在风格覆盖、可控性、可编辑性、过程可追溯性、生成成功率、视觉质量和计算成本方面,将 MaLiang-Harness 与现有文本到图像和文本到视频模型进行了评估。MaLiang-Harness 在控制和编辑方面与现有模型相当,同时增加了可检查的可执行视觉程序过程,仅在真实感方面部分支持。在 MaLiang-IBench 和 MaLiang-VBench 上,完成生成与满足所有质量阈值始终是不同的,GPT-6-Astra 通过将高完成率与几乎普遍的质量相结合,表现出最强的整体结果,而其剩余的图像失败主要集中在提示符合度上。成功率较低的模型,如 DeepSeek、Kimi 和某些 GPT-5.6 变体,要么产生的可用输出太少,无法获得可比的质量得分,要么为了速度而牺牲了完全合格视频的数量。