Command Palette
Search for a command to run...
YUE2:以前沿质量统一符号音乐生成与音频音乐生成
YUE2:以前沿质量统一符号音乐生成与音频音乐生成
摘要
符号模型显式地给出旋律、和声、节奏与曲式,但通常止步于完整录音之前;音频模型能生成完整歌曲,却将作曲过程隐式化。我们提出 YuE2,通过符号化规划在前沿质量上统一符号音乐生成与音频音乐生成。单一 AR–NAR Mixture-of-Transformers(MoT)[14] 先生成可读乐谱以指定旋律与和声,再将其扩展为语义音乐 token,并最终实现为整首歌曲音频。在使用同一检查点的对比中,专家在整体质量与音乐性上更偏好符号化规划,整体偏好率为 49.3%,而无规划为 34.6%。专家还认为该统一模型优于独立的语言模型与扩散 Transformer [81]。在 WildSongBench 上,YuE2 在 SongBench [77] Global Avg 上得分为 6.73,超过所有已评估的公开基线。从八个候选中选择(best-of-8)时,YuE2 达到 6.96,是所有被评估系统中观测到的最高平均分。专家聆听进一步确立其与商业歌曲生成器的竞争力:相比 Suno v4.5 [68] 更偏好 best-of-8,并且与 Suno v5 [65] 的偏好几乎持平。为了在无对齐乐谱的情况下从录音中学习这一生成过程,我们引入 MERT2 和 SheetSage2,以提供语义监督与符号监督。MERT2 在音乐表示学习上达到新的最优水平,在 15 项 MARBLE [87] 指标中有 14 项超过此前最佳结果;SheetSage2 在 lead-sheet 转录对比中,在 15 对基准–指标组合中有 12 对领先。同一检查点能够遵循乐谱编辑,同时基本保留未编辑的音乐内容,并在无需翻唱专项训练的情况下生成 zero-shot 翻唱。其可读乐谱还支持智能体式音乐编辑,由外部语言模型将用户反馈转化为对乐曲的修改。
一句话总结
来自香港科技大学、HKGAI 的研究人员与合作者推出了 YuE2,一个单一的 AR-NAR Mixture-of-Transformers,将符号化音乐生成与音频音乐生成统一到前沿水平,方法是先规划可读乐谱,再实现完整歌曲音频,由 MERT2 和 SheetSage2 提供语义与符号监督,使 YuE2 在 SongBench Global Avg 上获得 6.73 分,超过所有已评估的公开基线模型,通过 best-of-8 达到 6.96 分,并支持可编辑的零样本歌曲生成。
核心贡献
- YuE2 通过生成可读乐谱来指定旋律与和声,将其展开为语义音乐 token,并使用单一 AR-NAR Mixture-of-Transformers 渲染完整歌曲音频,从而将符号化音乐生成与音频音乐生成统一到前沿水平。
- MERT2 和 SheetSage2 为从录音中学习这种从作曲到音频的层级结构提供语义与符号监督,且无需预先存在的对齐乐谱;MERT2 在 15 项 MARBLE 指标中有 14 项创下新的最优水平,SheetSage2 在完整歌曲转录的 15 对基准指标中领先 12 对。
- 同一检查点支持乐谱编辑、零样本翻唱生成和 agentic 音乐编辑;专家在整体上以 49.3% 对 34.6% 的比例偏好符号化规划而非无规划,对 best-of-8 的偏好超过 Suno v4.5,YuE2 在 SongBench Global Avg 上达到 6.73,best-of-8 达到 6.96,超过所有已评估的公开基线模型。
引言
作者关注符号化音乐生成与音频音乐生成之间的差距:符号化模型暴露可编辑乐谱,但不生成成品录音;音频模型生成录音,却将作曲内容隐式化。这限制了完整歌曲生成中对旋律、和声与曲式的控制。作者推出 YuE2,一个统一模型,它首先通过符号化作曲规划写出一段包含旋律、和弦、调性、拍号、速度和曲式的符号化作曲,然后使用语义音乐 token 和连续声学潜变量将其渲染为立体声音频。由于普通音频语料缺乏对齐的音符、和弦、节拍和段落信息,作者还推出 MERT2 和 SheetSage2,从录音中获取语义与符号监督。该方法改善了感知歌曲质量,并支持基于乐谱的编辑、零样本翻唱生成以及使用同一检查点的 agentic 音乐编辑。
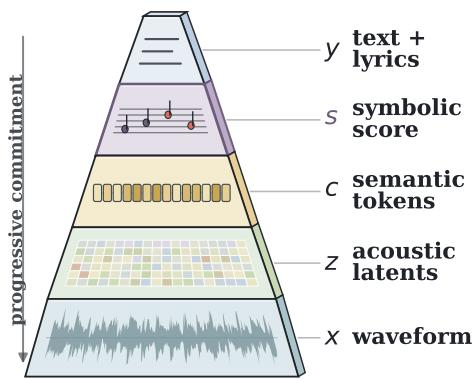
数据集
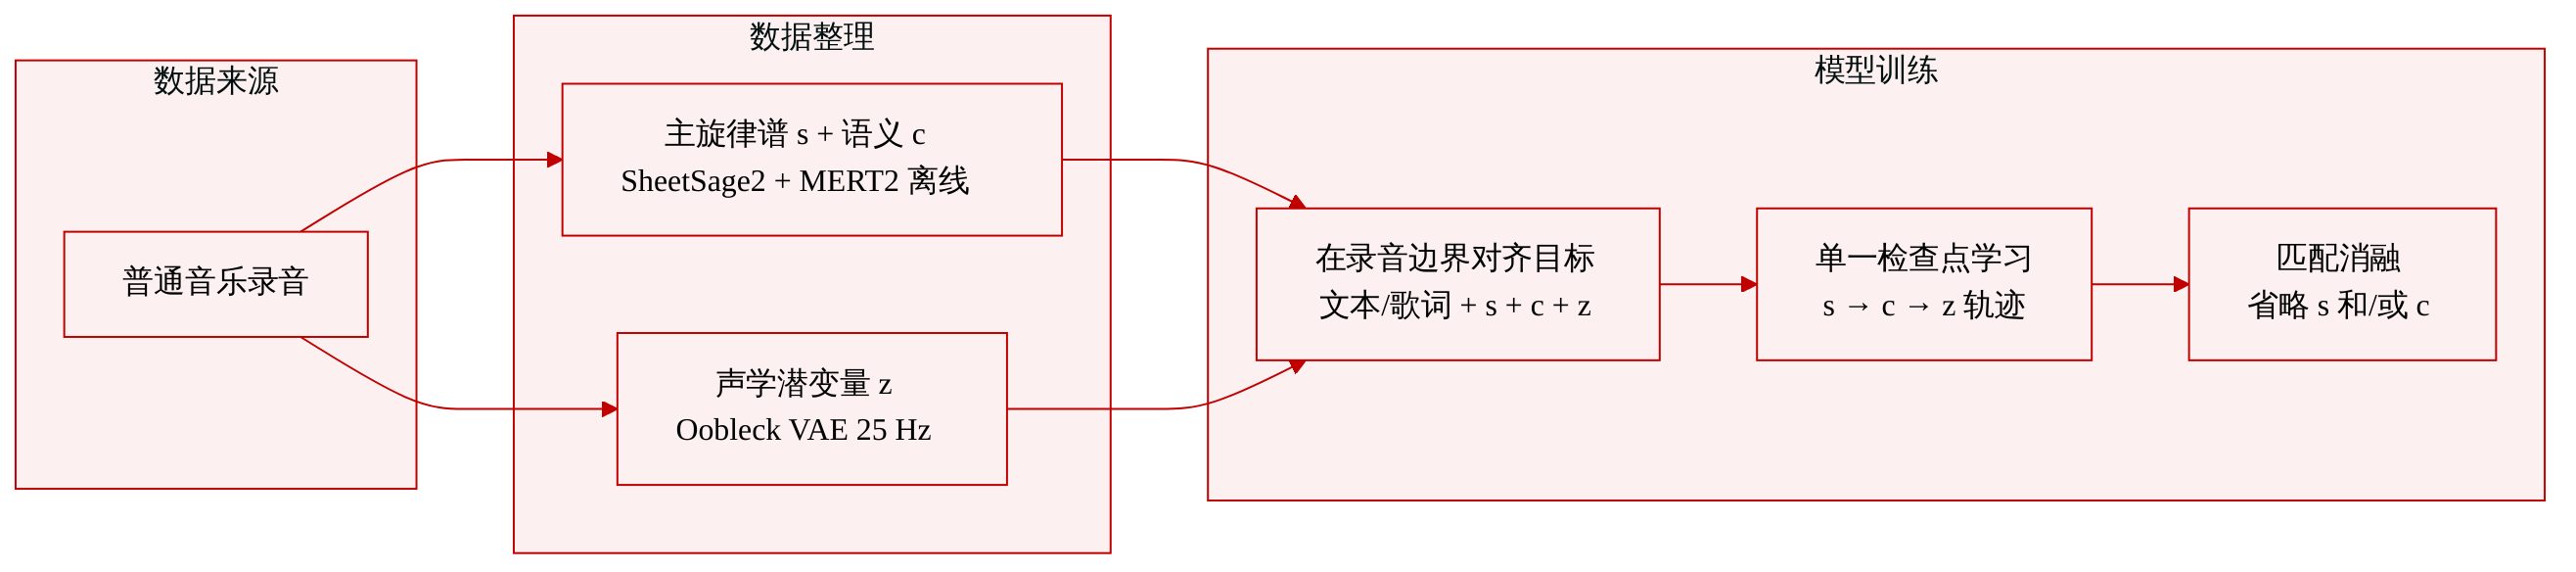
作者从普通音乐录音中构建监督信号。对于每个训练录音 x,三个冻结的目标构造器生成对齐的视图:符号化主旋律谱 s、紧凑语义 token c 和连续声学潜变量 z。
-
作曲与来源:该节描述了从训练录音中获得的监督信号,但未指明底层语料、数据集规模或过滤规则。重点在于每个录音如何被转换为对齐的符号化、语义和声学目标。
-
目标细节:
- s:来自 SheetSage2 的主旋律谱转录,使用双向完整歌曲上下文。
- c:来自单独 MERT2 tokenizer 分支的紧凑语义 token,采用因果自注意力,遵循 Qwen-Music 的设计,用于自回归预测。
- z:来自 Oobleck 变分自编码器的连续声学潜变量,该自编码器在 Stable Audio Open 之后单独训练。其卷积编码器将 48-kHz 立体声音频压缩 1,920 倍,得到 25 Hz 的 64 维瓶颈表示。
-
数据使用方式:每个训练样本将文本与歌词条件与可用的符号化和语义目标拼接,然后在录音边界对齐声学潜变量序列。符号化 token 共享文本词表,语义 ID 占据不相交的范围,声学潜变量保持连续。这种序列格式使单一检查点能够学习完整的 s→c→z 轨迹。匹配的消融实验可以省略 s、c 或两者。
-
处理细节:目标构造器离线运行并保持冻结。所提供的材料未指定裁剪策略、元数据构造、训练划分或混合比例,仅说明了对齐序列布局。
方法
YuE2 显式表示音乐作曲,并通过三种表示逐步实现它:符号化作曲 s、语义 token c 和连续声学潜变量 z。模型将生成分解为 pθ(s,c,z∣y)=pθ,AR(s,c∣y)pθ,NAR(z∣y,s,c),其中 y 表示文本和歌词。稀疏符号序列 s 承载人类可读的决策,25-Hz 语义序列 c 提供稠密的音乐轨迹,25-Hz 潜变量序列 z 保留声学细节以供 48-kHz 立体声解码器使用。
为了从录音构建对齐的训练目标,作者利用冻结的分析路径。对于符号化目标,使用 SheetSage2,一个自回归转录器,可恢复可编辑的主旋律谱。如下图所示:
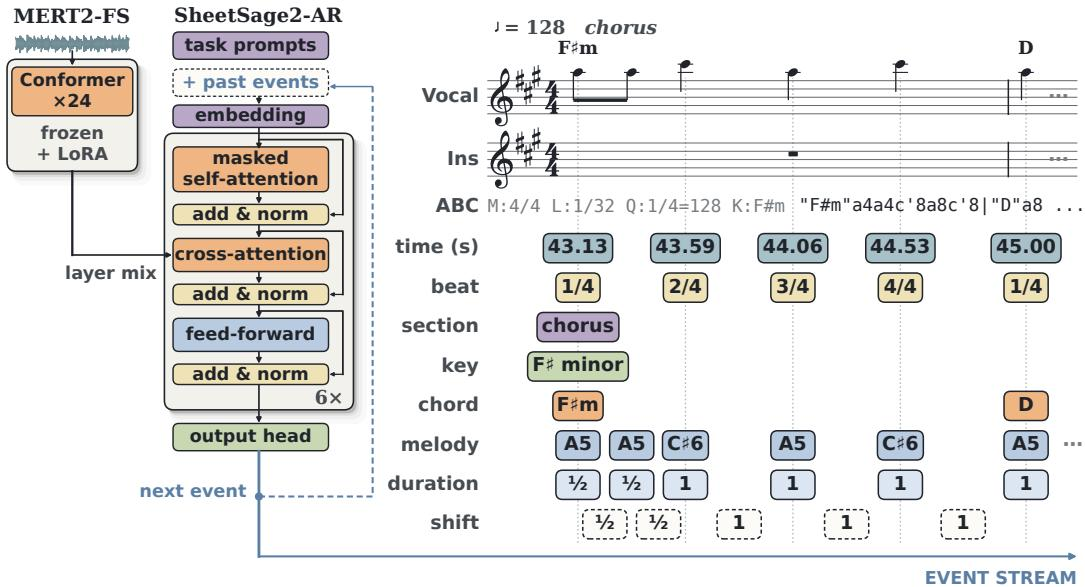
SheetSage2-AR 使用具有冻结主干和可训练低秩适配器的全上下文 MERT2-FS 编码器,输入到六层自回归 RoFormer 解码器,生成按时间顺序排列的事件序列,该序列被转换为 ABC 记谱。
对于语义目标,作者开发了 MERT2。该过程从多视图目标合成开始,其中冻结的 MuQ 和 Qwen2-Audio-Instruct 编码器将音频映射到时间对齐的特征,通过共享瓶颈组合,并由四级残差向量量化器离散化。如下图所示:
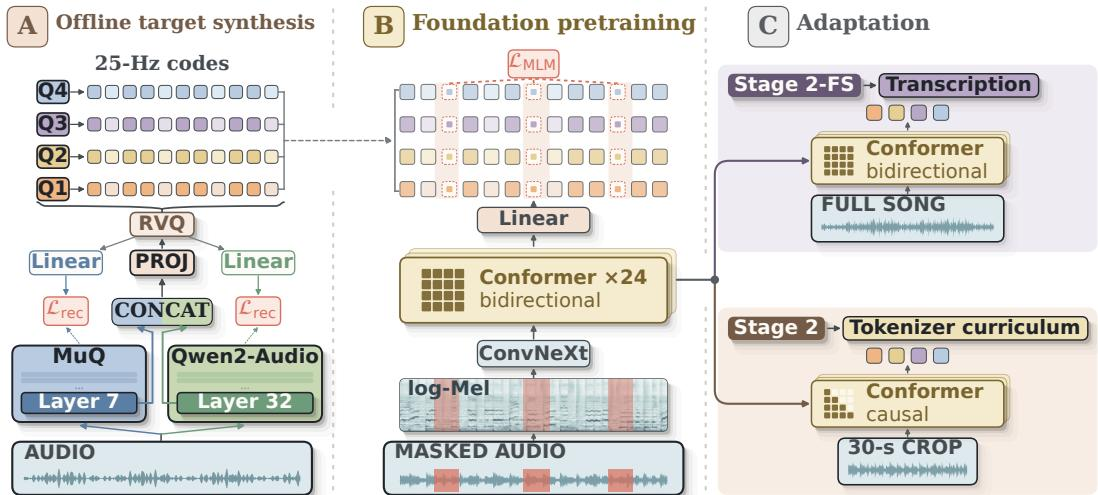
随后在第 1 阶段(基础预训练)训练一个新的音频编码器,使用 ConvNeXt 前端和 24 层双向 Conformer 从掩码音频中预测这些编码。后续的适配分支分为完整歌曲转录和语义 tokenization。tokenizer 分支经历因果适配、监督微调和语义量化。如下图所示:
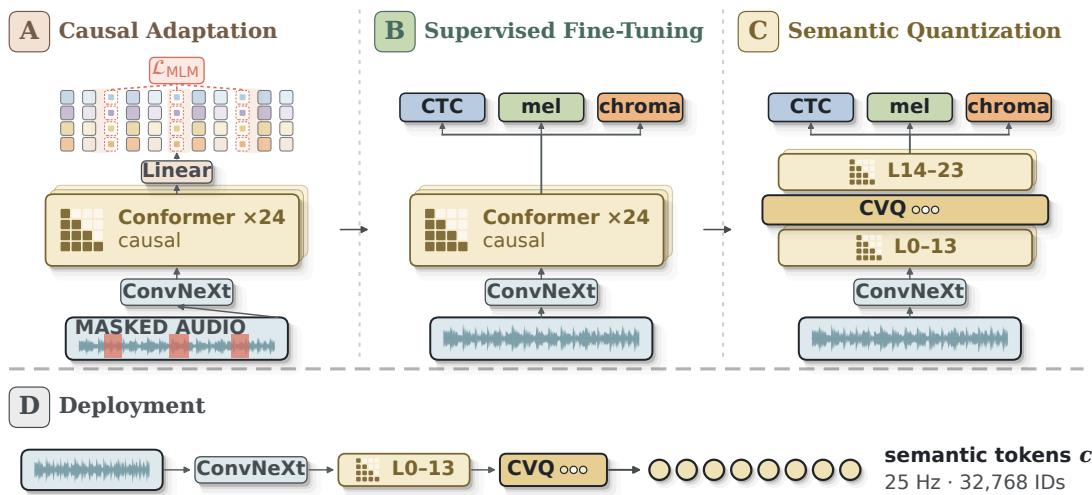
因果适配将 Conformer 切换为因果注意力。监督微调添加歌词连接主义时间分类以及梅尔频谱和 chroma 重建。语义量化在第 13 层和第 14 层之间插入一个包含 32,768 个条目的聚类向量量化器。部署时保留前端、因果 Conformer 的第 0 至 13 层以及量化器,以 25 Hz 输出语义 ID。
主 YuE2 模型在受 Mixture-of-Transformers 启发的单一 28 层主干中同时实现自回归和非自回归计算。每层具有独立的 AR 和 NAR 归一化、查询、键、值和输出投影以及多层感知机专家,同时共享位置方案并参与一次注意力计算。混合掩码确保离散预测无法读取声学目标,而声学状态可双向关注所有文本、乐谱和语义 token。在声学位置,噪声潜变量的投影替换 token 嵌入,线性头预测流动速度。
AR 流在符号化和语义区间上使用下一个 token 交叉熵进行训练:
LAR=−∣A∣1i∈A∑logpθ(wi∣w<i)对于声学学习,条件流匹配最小化:
LFM=64∣Z∣1i∈Z∑∥vθ(zt,t,y,s,c)i−(ϵi−z0,i)∥22其中 zt=(1−t)z0+tϵ。联合目标为 L=0.25LAR+LFM。作者在约 346,000 小时音乐上进行训练,将完整歌曲打包到 24,576 位置的上下文中。训练期间从四种任务中采样,包括省略乐谱、语义 token 或两者的设置,使模型能够在不同可用输入下生成,并支持分类器无关引导。
实验
实验在 WildSongBench 上使用自动指标和专家试听评估 YuE2 的完整歌曲生成能力,与公开和专有系统对比,并分离符号化规划与统一生成的贡献。他们发现 YuE2 达到了前沿竞争力的歌曲质量,显式旋律与和声规划改善了感知整体质量与音乐性,统一的 Mixture-of-Transformers 优于分离的语言模型加扩散设计,乐谱在音频中得以实现并支持受控的局部与全局编辑,同时保留未编辑内容。进一步研究表明,零样本翻唱生成在基于完整乐谱的条件下保留作品身份,agentic 编辑支持迭代式音乐修改,底层的 MERT2 和 SheetSage2 模型在音乐理解与完整歌曲转录基准上领先。
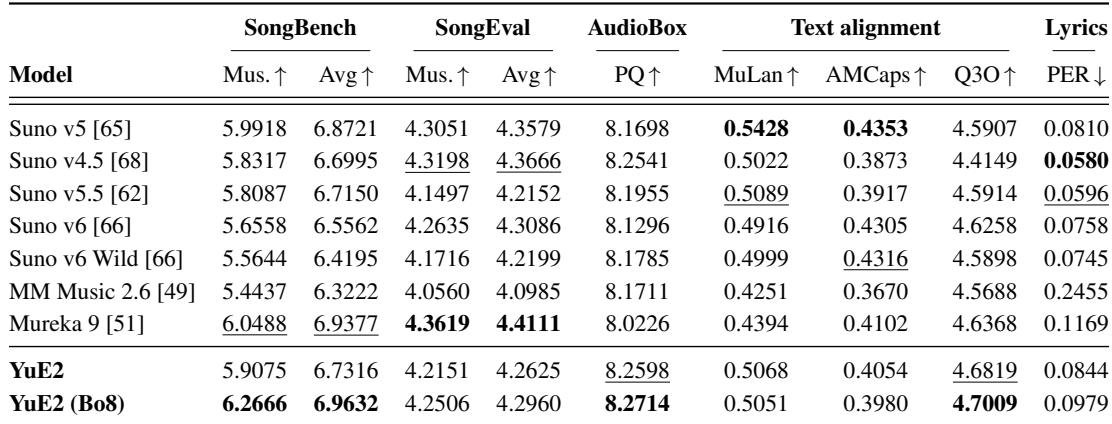
在 192 个 WildSongBench 提示中,Suno 各版本在专有系统对比中在多数音乐质量、制作质量、文本对齐和歌词准确率指标上领先。Suno v5 在 SongBench 音乐性和平均值以及两项文本对齐指标上领先,而 Suno v4.5 在 SongEval、制作质量和歌词准确率上领先。MiniMax Music 2.6 在多数指标上落后于 Suno 系统,歌词清晰度明显更弱。Suno v5 在对比系统中录得最高的 SongBench 音乐性和平均值,并在 MuLan 和 AllMusicCaps 文本对齐上领先。Suno v4.5 取得最佳 SongEval 音乐性和平均值、最高的 AudioBox 制作质量以及最低的音素错误率。Suno v5.5 在 SongBench 平均值、AudioBox 制作质量、MuLan 对齐、Q3O 提示遵循度上位居第二,并具有第二低的音素错误率。Suno v6 尽管 SongBench 音乐性低于其他几个 Suno 版本,但具有最高的 Q3O 提示遵循度。MiniMax Music 2.6 录得最弱的 SongBench、SongEval、MuLan 和 AllMusicCaps 分数,且音素错误率显著更高。
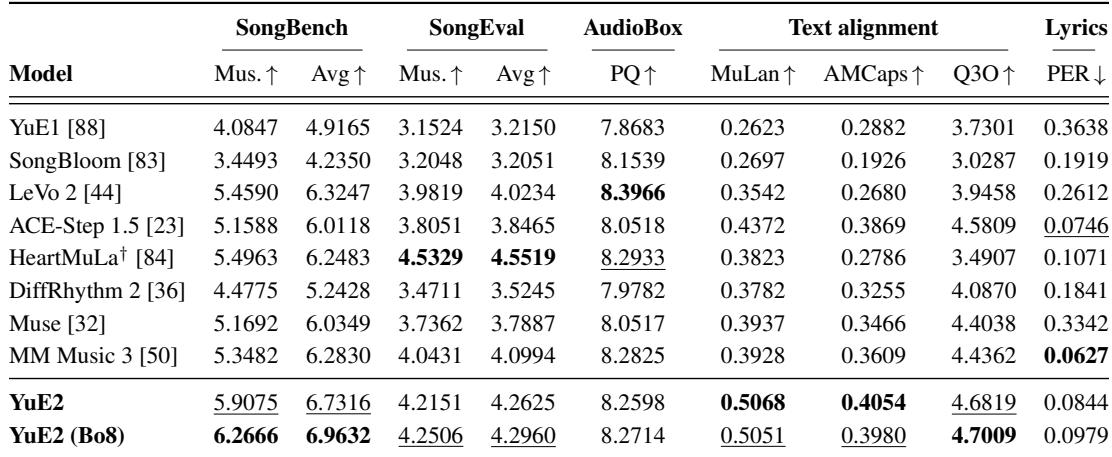
在 WildSongBench 上对比的公开系统中,ACE-Step 1.5 展现最强的文本对齐和歌词准确率,具有最高的 Q3O、MuLan 和 AMCaps 分数以及最低的音素错误率。HeartMuLa 在音乐性上领先,取得最佳的 SongBench 音乐性、SongEval 音乐性和平均值,而 LeVo 2 在 SongBench 平均值和 AudioBox 制作质量上排名最佳。YuE1 和 SongBloom 在音乐和文本对齐指标上普遍落后,不过 SongBloom 保持相对较强的制作质量。ACE-Step 1.5 在对比的公开系统中领先提示遵循度和歌词准确率,具有最佳的 Q3O、MuLan、AMCaps 和 PER 结果。HeartMuLa 取得最高的 SongBench 音乐性、SongEval 音乐性和平均值,同时其音素错误率第二低。LeVo 2 录得最强的 SongBench 平均值和 AudioBox 制作质量,但其文本对齐和歌词准确率指标弱于 ACE-Step 1.5。YuE1 和 SongBloom 通常在音乐和文本对齐指标上得分较低,不过 SongBloom 展现出相对较高的制作质量。
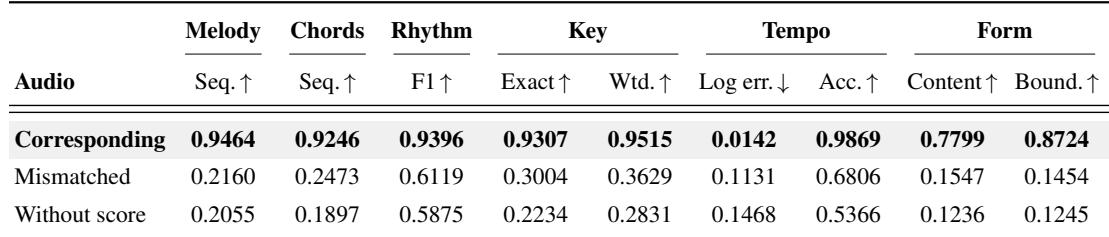
从对应乐谱生成的音频在旋律、和弦、节奏、调性、速度和曲式方面与所记谱的作曲表现出高度一致。相比之下,从不匹配乐谱生成的音频或没有乐谱的音频在相同提示和歌词上显示出一致性大幅降低。这一差距表明观察到的一致性特定于正在实现的具体乐谱。对应乐谱音频在旋律、和弦、节奏、调性、速度和段落边界度量上取得高一致性。不匹配乐谱音频和没有乐谱的音频远低于对应音频,尤其是在旋律、和声和曲式相似性方面。对应音频的速度误差最低,速度准确率显著高于两个对照组。当音频不遵循其自身生成的乐谱时,调性和节奏一致性也急剧下降。
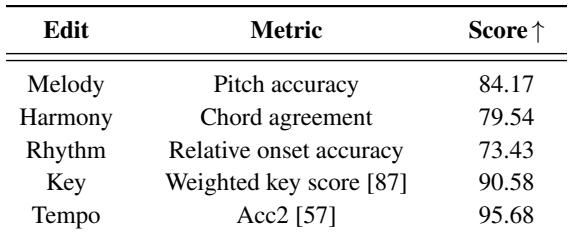
在五种乐谱编辑类型中,调性和速度编辑的遵循度最强,而节奏编辑的遵循准确率最低。旋律与和声遵循度介于两者之间,其中旋律音高准确率高于和声和弦一致性。该基准将这些遵循度分数与内容保留分开报告,此处关注编辑后的音乐属性被精确实现的程度。速度编辑在评估的编辑类型中取得最高的遵循度分数,其次是调性编辑。节奏编辑显示最低的遵循度,表明相对起始时间是局部变更中最难遵循的。旋律音高准确率高于和声和弦一致性,但两者都低于调性和速度遵循度。
在零样本 SHS100K 评估中,具有完整乐谱的 YuE2 在全部八项检索指标上均优于两个被评估的翻唱生成基线,尽管没有翻唱特定训练。乐谱条件是保留作品身份的关键,因为移除和弦会降低检索性能,完全移除乐谱会导致检索性能降至接近零。完整乐谱 YuE2 配置在没有翻唱特定训练的情况下在每个检索指标上领先 SongEcho 和 ACE-Step 1.5。从乐谱中移除和弦信息仍保持对两个翻唱基线的明显检索优势。没有任何乐谱时,检索性能崩溃至接近零,表明乐谱条件对于保留作品身份至关重要。
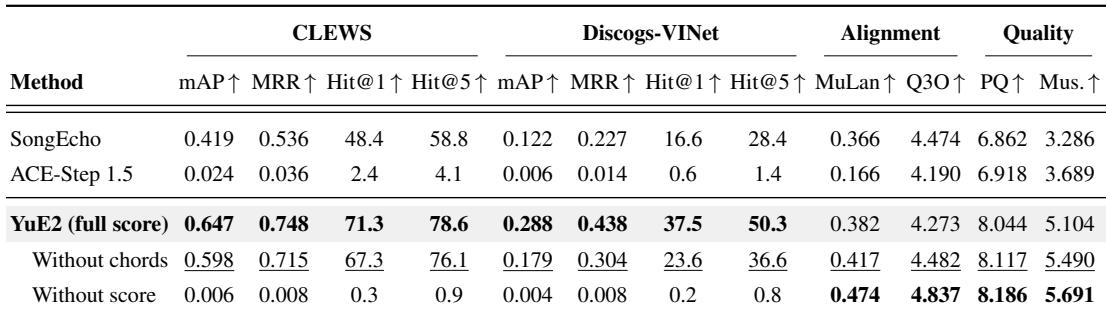
论文在 WildSongBench 上评估音乐生成系统,对比专有 Suno 各版本和公开模型。在专有系统对比中,Suno 系统在音乐质量、制作质量、文本对齐和歌词准确率上普遍领先;在公开模型中,ACE-Step 1.5 在文本对齐和歌词准确率上表现突出,HeartMuLa 或 LeVo 2 在音乐性和制作质量上领先。受控实验确认基于乐谱的生成能强有力地保留音乐属性和作品身份,完整乐谱 YuE2 优于翻唱基线,乐谱编辑在调性和速度上比节奏更可靠地被遵循。总体而言,乐谱条件被证明对于精确的乐谱对齐和作品身份检索至关重要。