Command Palette
Search for a command to run...
VoxMem:大型音频语言模型中的多模态记忆基准测试
VoxMem:大型音频语言模型中的多模态记忆基准测试
Yang Xiao Vidhyasaharan Sethu Eun-Jung Holden Ting Dang
摘要
口语对话系统必须从先前的交互中恢复信息(即记忆),但语音中的相关信息不仅限于“说了什么”,还包括“谁说的”“如何说的”以及“能听到什么”;这些信息仅存在于音频信号中,无法从转写文本中恢复。除了“记住什么”之外,记忆还要求多种操作:检索单个事实、跨轮次整合证据、跟踪不断变化的状态。真实交互还会跨会话展开,意味着信息在不同片段中累积,而不是在单一连续录音中累积。现有基准在这三个方面均存在不足:主要关注词汇内容,采用有限且临时的记忆操作,并将记忆视为单会话问题。我们认为,原则性的记忆评估需要同时刻画需要保留的声学证据以及施加于其上的操作,并沿这两个维度提出一种分类体系。基于该分类体系,我们提出了 VoxMem:它包含 3,196 个评估实例,覆盖 34,743 个口语会话(177小时),横跨四种声学证据类型(语音语义、说话人身份、副语言线索、环境声音)和四种记忆操作(信息抽取、多会话推理、时序跟踪和拒绝回答),并以多会话历史为基础,在 8K 到 64K token 的上下文预算范围内进行分层。在评估 15 个 LALM 后,没有一个模型在 32K 上下文长度下超过 40%。模型对“说了什么”的记忆远好于对“谁说的”“如何说的”或“能听到什么”的记忆;这一差距在复杂操作下进一步扩大,随着历史长度增加而加剧,并在不同证据类型上表现为性质不同的失败模式。VoxMem 旨在为全面衡量和推动口语对话记忆的进展提供基础。
一句话总结
来自墨尔本大学和新南威尔士大学的研究者提出了 VoxMem,一个包含 3,196 个评估实例、覆盖 34,743 个语音会话的基准,采用声学证据与记忆操作联合分类法,在 8K 到 64K token 上下文中评估 15 个大型音频语言模型,发现在 32K 时没有任何模型超过 40%,且模型对词汇内容的保留远好于对说话人身份、副语言线索和环境声音的保留,暴露出词汇记忆之外的差距。
核心贡献
- 提出了一种面向语音对话记忆的二维分类法,将需要保留的声学证据(包括语音语义、说话人身份、副语言线索和环境声音)与记忆操作(如信息抽取、多会话推理、时间演变追踪和拒绝作答)联合刻画。
- 提出 VoxMem,一个包含 3,196 个经过质量控制的实例、34,743 个语音会话、总计 177 小时的多会话基准,按 8K 到 64K token 的上下文预算分层,并由来自 20 个话题族的证据会话、竞争会话和不相关会话构建。
- 报告了对 15 个 LALM 的系统评估,显示在 32K 上下文时没有任何模型超过 40%,词汇内容保留远好于说话人身份、副语言线索或环境声音,且失败模式因证据类型而异,如说话人身份的错误归因和副语言信息的声学线索丢失。
引言
大型音频语言模型(LALM)正在支持跨多个独立会话的更长时间语音交互,使得长期记忆成为关键需求。然而,现有语音记忆基准缺乏对哪些声学证据必须被保留以及需要哪些记忆操作的原则性分类法,并且大多评估孤立录音或连续对话,而非多会话历史。它们也倾向于将历史长度与问题难度和证据类型混淆。作者提出了 VoxMem,一个沿两个轴组织的多会话基准:声学证据,包括语音语义、说话人身份、副语言线索和环境声音;记忆操作,包括信息抽取、多会话推理、时间演变追踪和拒绝作答。VoxMem 包含 3,196 个经质量控制的实例,覆盖 34,743 个语音会话,横跨 8K 到 64K token 的四种上下文预算,并支持对语音记忆随上下文长度扩展而退化的受控评估。
数据集
VoxMem 基准数据集
-
范围与分类法。 VoxMem 是一个围绕两个维度组织的语音对话记忆基准:声学证据和记忆操作。声学证据覆盖语音语义、说话人身份、副语言线索和环境声音。记忆操作覆盖信息抽取、多会话推理、时间演变追踪和拒绝作答。基准包含 15 个评估场景,排除了针对语音语义的信息抽取。
-
数据组成。 每个多会话历史包含三种会话类型。证据会话保存回答问题所需的信息。干草堆会话添加同一话题上看似合理但具有误导性的内容,防止模型仅靠话题匹配作答。填充会话包含不相关对话,用于将历史扩展到目标长度。每个条目都从结构化计划开始,在编写对话或音频之前指定问题、标准答案和所需证据。
-
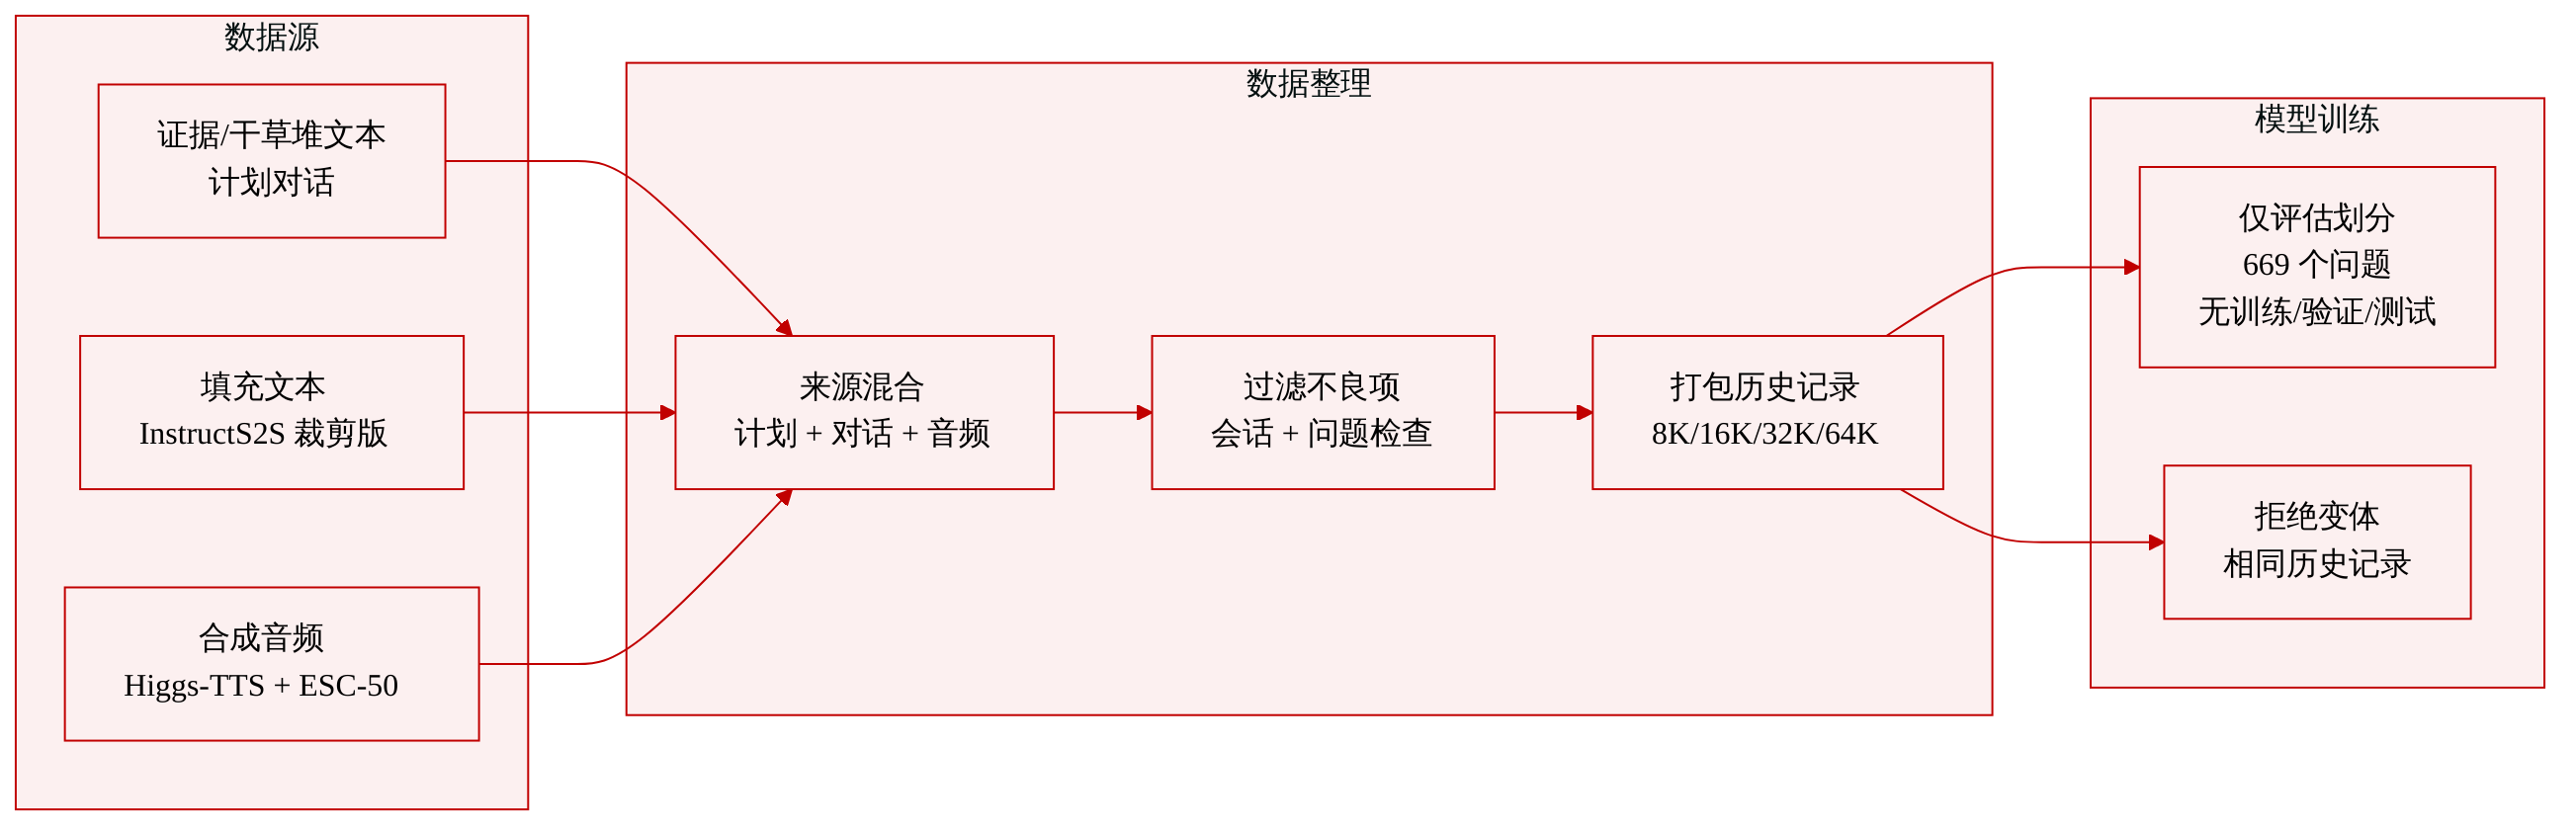
文本与音频来源。 证据和干草堆对话首先以文本形式编写。填充文本取自 InstructS2S,并裁剪以匹配 VoxMem 会话长度。用户轮次使用 Higgs-TTS-3 合成,每个用户使用固定的 VCTK 声音。副语言线索通过风格控制引入,来自 ESC-50 的环境声音以 10dB SNR 混合。问题使用 Gemini-3.7-Flash 和 GPT-5.6-Luna 渲染为自然语言。在最终输入中,用户轮次为音频,助手轮次为文本,并包含会话边界和时间戳。
-
规模。 构建流程生成超过 30,000 个计划。最终可作答集合包含 669 个问题,拒绝作答变体由现有可作答题派生。每个可作答问题被嵌入四种长度的历史中:8K、16K、32K 和 64K token,使用 Whisper 编码器测量,约为 2.5 到 20 分钟音频。较长的历史严格扩展较短历史,并且除时间演变追踪中时间顺序重要的情况外,证据和干草堆会话均匀分布。
-
过滤与质量控制。 会话级检查验证转录保真度、说话人一致性、目标线索可感知性以及成对副语言和环境呈现的确定性一致性。问题族检查验证证据唯一确定答案、问题需要预期操作、音频原生问题无法仅从转录回答,以及完整历史中不存在泄露或替代答案。未通过检查的条目会被修改并重新检查或丢弃。仅文本分类器也无法可靠区分证据会话和干草堆会话,确认表面模式不会透露答案。
-
用途。 VoxMem 是一个仅用于评估的基准,不是训练集。它旨在评估接受音频输入但不生成语音的 LALM。每个模型接收相同的具有音频用户轮次和文本助手轮次的历史,并在四种上下文长度上比较性能,以便将变化归因于上下文增长而非证据变化。
方法
作者按照二维分类法构建 VoxMem 基准,利用由三种不同会话类型组成的多会话对话结构,以确保自然性和受控评估场景。证据会话包含回答查询所需的特定信息。干草堆会话引入同一话题上看似合理但具有误导性的内容,迫使模型在完整声学和语义上下文中推理,而不是依赖话题匹配。填充会话由与问题无关的普通对话组成,用于将历史扩展到目标上下文长度。
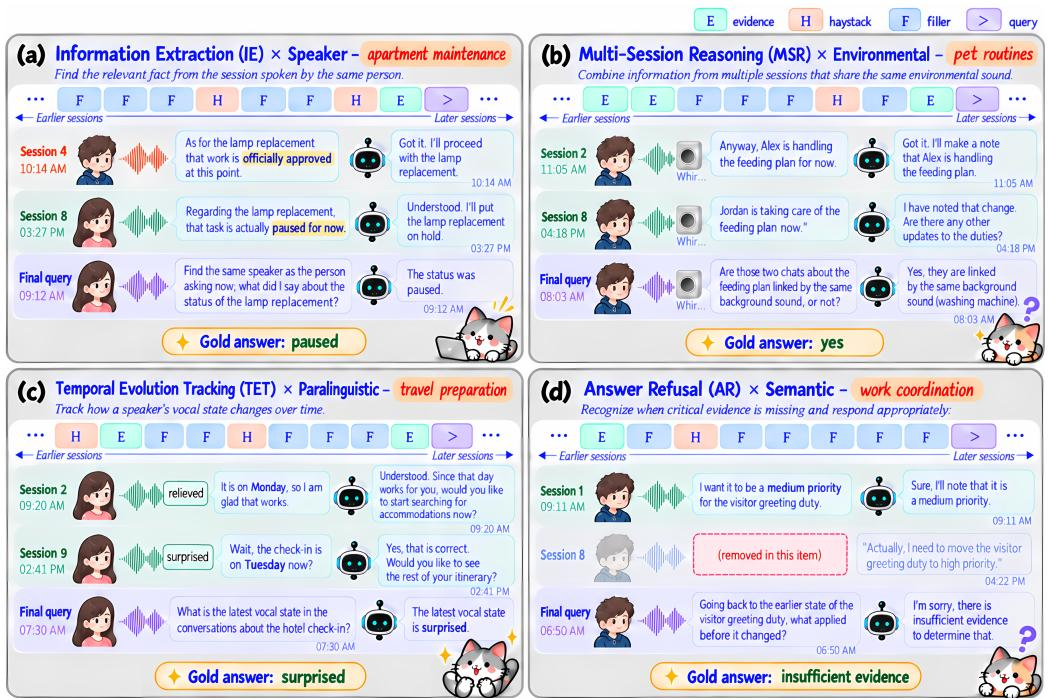
如下图所示,该结构应用于不同的记忆类型。例如,在涉及说话人身份的信息抽取场景中,证据会话包含提问用户说出的答案,而干草堆会话中另一位用户以不同内容讨论同一话题。
每个条目的构建遵循严格的流程,如框架图所示。
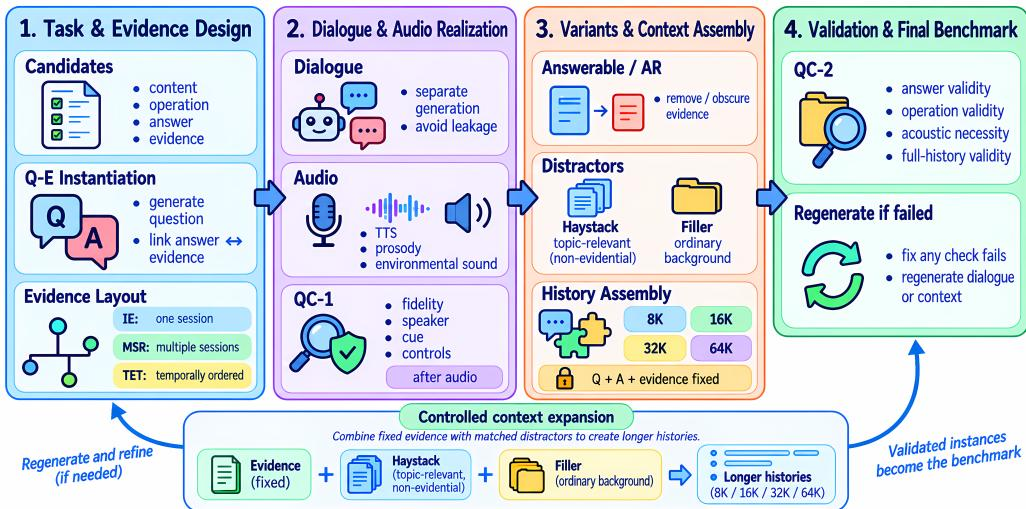
该过程从任务与证据设计开始,在此阶段结构化计划指定问题、标准答案和所需证据。证据根据操作类型分布在会话中:信息抽取使用单个会话,多会话推理使用多个会话,时间演变追踪使用有序序列。在对话与音频实现阶段,证据会话被编写为用户-助手对话。为防止答案泄露,两侧独立编写。用户轮次使用具有固定声音的 TTS 系统合成,并引入副语言线索或环境声音。
在变体与上下文组装阶段,作者创建可作答和拒绝作答变体。干草堆会话和填充会话作为干扰项添加。历史按四种长度(8K、16K、32K 和 64K token)组装,通过用更多干扰项严格扩展较短历史,确保问题和证据保持一致。最后,验证与最终基准阶段涉及多阶段质量控制。
作者实现了两级质量控制过程。会话级验证针对单个会话内的失败,验证转录保真度、说话人一致性和声学线索的可感知性。问题族验证针对完整历史中出现的失败。这包括检查答案和操作有效性,通过拒绝仅从文本即可回答的问题来确保声学必要性,并验证完整历史有效性以确保不存在泄露或替代答案。未通过检查的条目会被修改并重新检查。
实验
VoxMem 基准在声学证据和记忆操作的二维分类法中评估语音对话记忆,使用 LLM 评判的简短答案在 8K 到 64K token 的历史上测试 15 个大型音频语言模型。实验表明,当前模型仍然不可靠,在 32K 时没有任何模型总体准确率超过 40%,并且非词汇声学信息(如说话人身份、副语言线索和环境声音)比语音语义更难保留。记忆操作难度取决于证据类型,而拒绝模式表明模型常常因为声学处理薄弱而放弃作答,而不是真正意识到证据缺失。更长的历史降低了对相同证据的访问,说话人和环境记忆退化最快,错误画像在不同证据类型和操作之间存在差异。
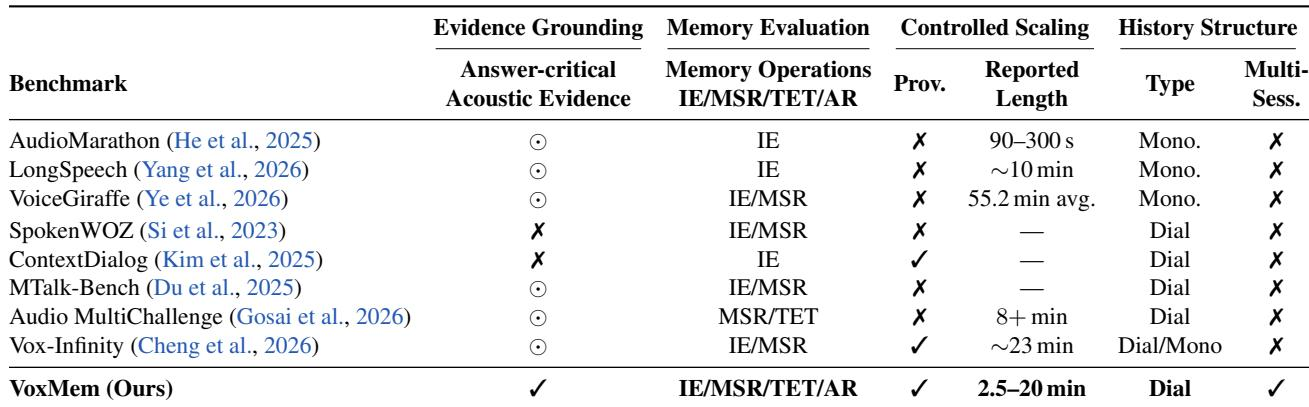
比较显示,现有语音记忆基准仅部分覆盖声学证据和记忆操作。大多数强调语言内容或选定的声学线索,并且只评估检索或整合,而时间演变追踪和拒绝作答缺失。这些基准还依赖单会话独白或对话,受控扩展和证据来源很少被报告。先前基准很少测试说话人身份、副语言线索或环境声音;一些只关注词汇内容。记忆操作覆盖范围狭窄:所有列出的基准都包含信息抽取,少数添加多会话推理,没有包含时间演变追踪或拒绝作答。所有列出的基准都使用单会话历史,没有多会话评估。大多数列出的基准缺少证据来源,只有一个对话基准提供。
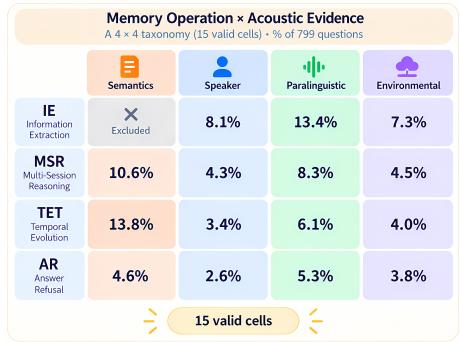
评估分类法不均衡,副语言和语义问题占主导,拒绝作答较少见。实验结果表明,更长的历史降低了对先前可用证据的访问,尤其是在说话人和环境声音记忆方面,而副语言理解在所有上下文长度下都保持较低。错误归因还揭示了不同操作和证据类型之间的明显失败模式,例如说话人信息的绑定错误和时间演变的定位错误。分类法分布不均:副语言和语义问题是最常见的证据类别,拒绝作答在所有操作中出现频率较低。随着历史增长,模型对证据的访问减少,说话人身份和环境记忆退化最快;副语言线索在每个上下文长度下都仍然困难。
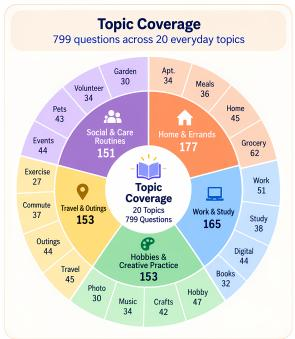
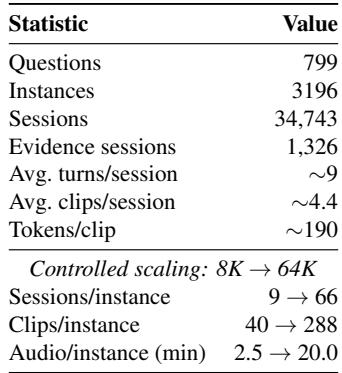
该基准包含数百个问题和数千个实例,取自数万个会话,其中证据会话是较小的子集。会话相对紧凑,平均每次会话约九轮和几个片段。从 8K 到 64K 的受控上下文扩展显示,随着历史增长准确率下降,说话人身份和环境声音的相对下降最陡。数据集包含 799 个问题和 3,196 个实例,但只有一小部分会话充当证据会话。更长的上下文窗口降低了所有证据类型的准确率,说话人和环境记忆比语音语义和副语言线索退化更快。
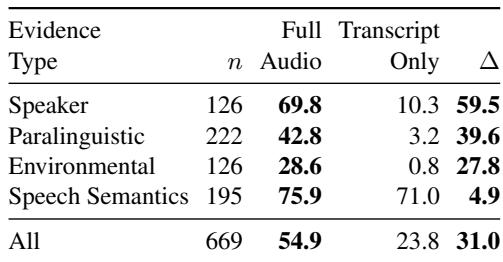
对于 Gemini-3.7-Flash 在可作答声学记忆问题上的表现,将完整音频替换为仅转录轮次会导致总体准确率大幅下降,这证实了对非文本声学线索的依赖。影响高度不均:语音语义相对稳定,而说话人身份、副语言线索和环境声音失去了大部分准确率。完整音频的总体准确率从约 55% 下降到仅转录输入时的不到四分之一。语音语义受影响最小,说话人身份下降约 60 个百分点,降至略高于 10%,而副语言和环境得分降至接近零。
语音记忆准确率随着参考历史增长而下降,专有模型和开放权重模型在 8K 到 32K 之间都失去准确率。说话人身份和环境声音的下降比语音语义和副语言线索更陡。副语言线索的绝对准确率最低,但下降速率与语音语义相似,表明基线难度和历史敏感性是不同的失败模式。在 64K 时,语音语义和副语言线索保留了其 8K 准确率的大约 70%,而说话人身份和环境声音保留约 63% 到 67%。专有模型在 8K 和 32K 时得分高于开放权重模型,但两组都随着历史增长而失去准确率。说话人错误最常是绑定失败,而副语言错误以定位失败为主,环境错误在定位失败和无依据答案之间分布。
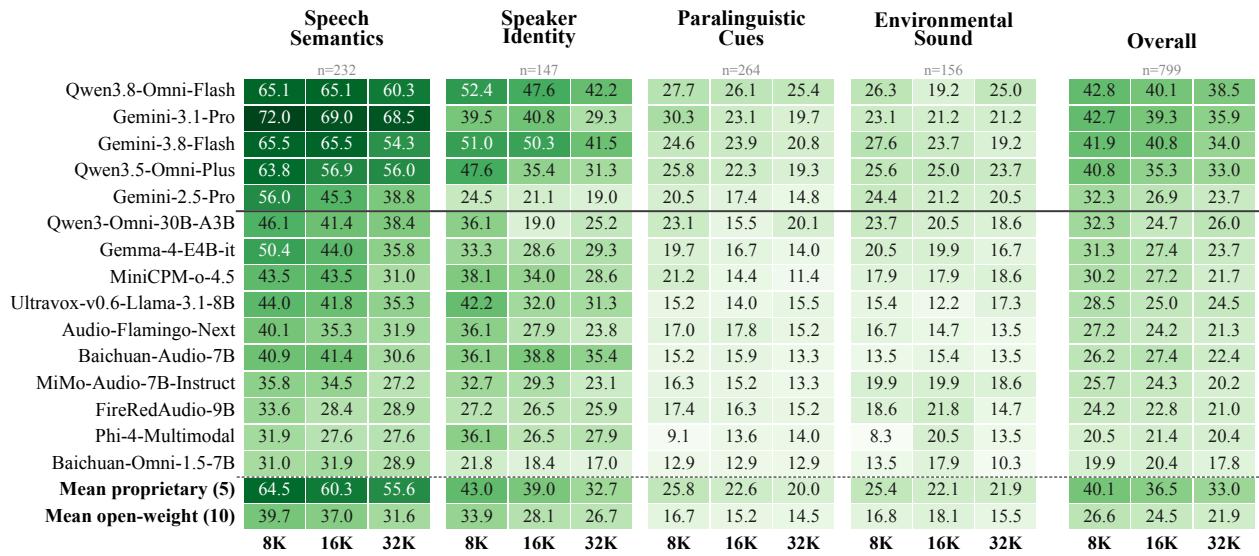
现有语音记忆基准仅部分覆盖声学证据和记忆操作,常常缺少说话人身份、副语言和环境线索、时间演变追踪、拒绝作答、多会话历史和证据来源。该基准的受控上下文扩展显示,专有模型和开放权重模型都随着历史增长而失去对早期证据的访问,说话人身份和环境声音比语音语义退化更陡,而副语言线索在所有上下文长度下都仍然困难。将音频替换为转录会导致总体大幅下降,并使说话人、副语言和环境表现接近零,确认模型依赖文本之外的声学线索。错误归因揭示了不同的失败模式,包括说话人信息的绑定错误以及副语言和时间演变问题的定位错误。