Command Palette
Search for a command to run...
面向代码智能体 RL 的分组式智能体评分与优势再分配
面向代码智能体 RL 的分组式智能体评分与优势再分配
Jinhao Dong Liang Zhao Zihao Yue Wenhan Ma Linghao Zhang Lei Li Shicheng Li Yifan Song Bowen Ye Fuli Luo
摘要
针对代码智能体的强化学习(RL)通常使用可执行测试来给出二元奖励。在这些奖励下,分组相对策略优化(GRPO)会为每个 rollout 组内通过测试的轨迹分配相同的优势,忽视了实现质量以及对任务要求的遵守程度上的差异。这使得策略缺少一种学习信号,无法偏向简洁、有针对性的实现,而不是包含不必要或超出范围修改的实现。我们提出了 Gagar,一个用于代码智能体 RL 的质量感知信用再分配框架。Gagar 基于动态采样,保留同时包含通过和失败轨迹的组,并将每个组中的所有轨迹放入一个共享工作空间;在那里,一个经过 SFT 训练的智能体评分器会联合检查这些轨迹,并对通过测试的候选轨迹进行排序。基于该排序,我们降低排名较低轨迹的权重,并按比例重新缩放所有通过测试轨迹的优势,以恢复它们原有的总和。这种保持总和不变的再分配在将信用向更高质量实现转移的同时,保留了基于质量降权所建立的相对权重。我们使用 MiMo-V2.6-Flash(总参数 310B)和 MiMo-V2.6-Pro(总参数 1.02T)的 RL 前 SFT 检查点,在工业规模上评估 Gagar。受控的纯代码 Flash 实验表明,代码智能体性能提升、轨迹长度增长降低,训练更加稳定。我们进一步在 Flash 和 Pro 的大规模混合任务 RL 中应用 Gagar。我们的结果支持将基于测试的验证与分组式智能体评分相结合,以提升代码智能体 RL 的质量和稳定性。
一句话总结
来自小米、中国人民大学、北京大学及其他机构的研究者提出 Gagar,这是一个面向 code agent RL 的质量感知信用重分配框架;该框架使用动态采样和经 SFT 训练的 agentic grader 对通过测试的轨迹进行排序,对排名较低的轨迹降权,并应用保和优势缩放;在 MiMo-V2.6-Flash(总参数量 310B)和 MiMo-V2.6-Pro(总参数量 1.02T)上进行的工业规模实验显示 code agent 性能提升、轨迹长度增长降低、训练更稳定。
核心贡献
- Gagar 是一个面向 code agent RL 的质量感知信用重分配框架,它使用动态采样保留同时包含通过和失败轨迹的组,然后使用经 SFT 训练的 agentic grader 在共享工作区中检查并对通过测试的轨迹进行排序。
- Gagar 对排名较低的通过轨迹降权,并按比例重新缩放所有通过轨迹的优势,在将信用向更高质量实现转移的同时保留原始总正优势。
- 在 MiMo-V2.6-Flash 上进行的受控纯代码实验显示 code agent 性能提升、轨迹长度增长降低、训练更稳定;使用 MiMo-V2.6-Flash 和 MiMo-V2.6-Pro 的混合任务 RL 在 DeepSWE v1.1 上达到 avg@3 分数 67.9 和 71.9。
引言
通过可执行反馈进行强化学习,是训练 code agent 的一种可扩展方式,此类 agent 会检查仓库、修改代码,并在长时间交互中验证更改。在 GRPO 等常见的组相对设置中,所有通过测试的轨迹都获得相同的正结果优势,因此训练信号无法区分更干净、更聚焦的补丁与过于复杂或高风险的实现。基于静态文本的评估也往往会忽略仓库上下文和执行证据。作者提出 Gagar,一个质量感知框架,该框架使用 agentic grader 检查代码、运行针对性检查,并在每个 rollout 组中对通过测试的候选轨迹进行排序,然后在成功轨迹之间重分配信用,同时保持这些轨迹的总正优势不变。该方法旨在强化精确、最小侵入、可直接合并的解决方案,并已在 MiMo 模型上以工业规模得到验证。
方法
作者利用逐组质量监督来增强 code agent 的强化学习,从而超越二元的任务结果。如下图所示,该框架将逐组 agentic grading 集成到 RL 训练循环中,以评估和排序有效的通过实现。
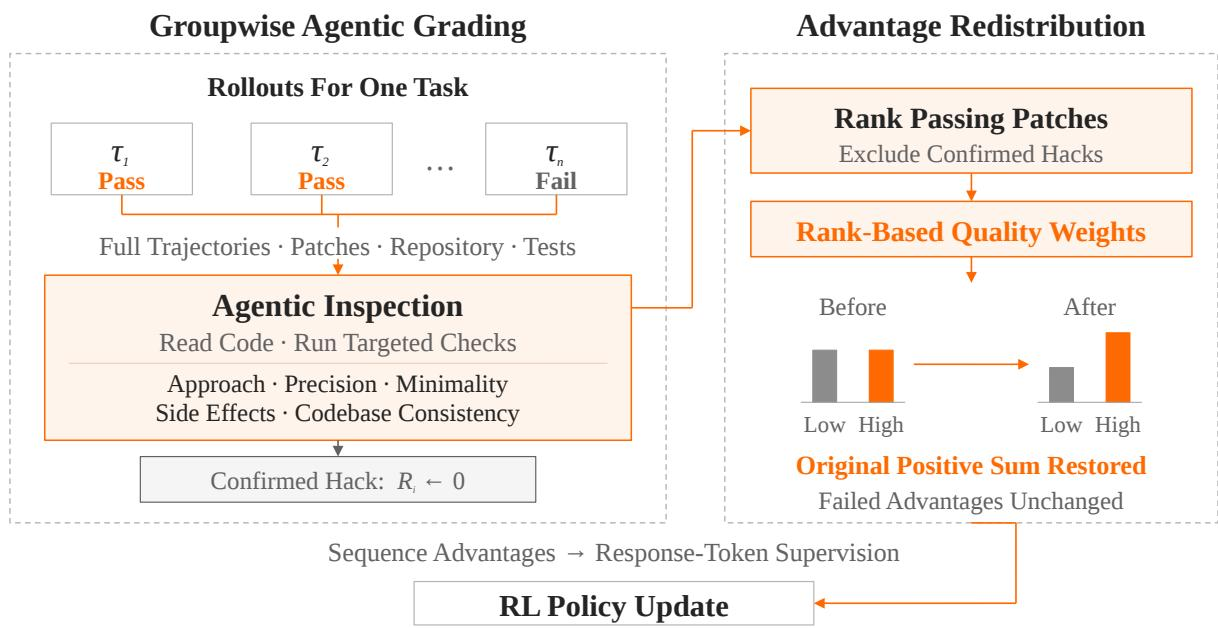
在训练设置中,对于每个编码任务,rollout 策略会生成多条轨迹。每条轨迹的最终补丁使用可执行测试进行评估,得到二元结果奖励。令 Gx={τi}i=1n 表示有效轨迹组。作者使用按均值中心化的结果优势 Ai=Ri−Rˉ,其中 Rˉ=n−1∑j=1nRj。为确保成功和失败的轨迹同时存在,采用动态采样,使得 0<Rˉ<1。所有通过轨迹最初获得相同的正优势 1−Rˉ,这无法区分实现质量。
为此,作者引入逐组 agentic grading。该 grader 在共享工作区中联合检查所有 rollout,工作区包含任务规范、仓库、完整轨迹、提交的补丁和测试输出。这种比较有助于识别最强解决方案,并暴露无效策略。agentic grader 以迭代方式收集证据,审查逐轮摘要,阅读相关轨迹部分,并将补丁与仓库代码和测试日志进行交叉核对。它还可以运行针对性检查。质量评估涵盖五个标准:方案适配性、精确性、最小改动性、副作用和代码库一致性。对通过的解决方案会检查是否存在泄露或外部答案,确认的作弊行为会得到零奖励。其余候选方案被评分并映射到三个质量等级,这些等级决定对其正优势的折扣因子 fi∈(0,1]。
在 grading 之后,应用保和优势重分配。简单应用折扣因子会使通过轨迹得到 A~i=fiAi,在负侧没有相应变化的情况下移除正信用。这种缺口削弱了对成功轨迹的强化。为了保持分配给通过轨迹的总正优势 S+=∑i∈PAi,作者应用一个公共重缩放因子:
λ=∑j∈PfjAjS+重分配后的优势为:
Ai⋆={λfiAi,Ai,i∈P,i∈F.这确保总正优势得到恢复,并且该变化在通过子集上是零和的,同时保持质量偏好的排序和相对强度。
在在线训练集成过程中,grading 与 rollout 收集异步运行。系统检查 grading 结果的有效性,必要时回退到原始结果优势。对于确认依赖外部解决方案的情况,系统会在重新计算组统计量之前将受影响奖励重置为零。所得的序列级优势被广播到模型生成的响应 tokens,以监督 RL 策略更新。
实验
这些实验使用 DeepSWE v1.1 和 SWE-bench Pro 作为基准,在 MiMo-V2.6-Flash 上的纯代码强化学习以及 Flash 和 Pro 上的工业规模混合任务 RL 中评估 Gagar。主要对比显示,Gagar 提升了长时程 code agent 性能,使轨迹更短且更高效,并在外部模型审查中取得更高实现质量。消融实验证实,保和重分配对训练稳定性很重要,因为降权通过轨迹而不恢复信用会导致动态不稳定和下游行为退化。工业规模运行进一步表明,与更大的前沿模型相比,code agent 性能具有竞争力。
使用 Gagar 进行工业规模混合任务 RL 后,MiMo-V2.6-Flash 和 MiMo-V2.6-Pro 在编码基准上取得与强大外部基线具有竞争力的结果。MiMo-V2.6-Pro 在 DeepSWE 上优于 Kimi K3,尽管其总参数量少得多,并在 SWE-bench Pro 上超过 GPT-5.6 Sol。其 DeepSWE 分数接近 GPT-5.6 Sol 和 Claude Opus 5,但在 SWE-bench Pro 上落后于 Claude Opus 5。MiMo-V2.6-Pro 在 DeepSWE 上优于 Kimi K3,尽管其总参数量少得多。MiMo-V2.6-Pro 在 SWE-bench Pro 上超过 GPT-5.6 Sol。MiMo-V2.6-Pro 在 DeepSWE 上接近 GPT-5.6 Sol 和 Claude Opus 5,但在 SWE-bench Pro 上仍低于 Claude Opus 5。MiMo-V2.6-Flash 在 DeepSWE 和 SWE-bench Pro 上的分数接近更大的外部模型。
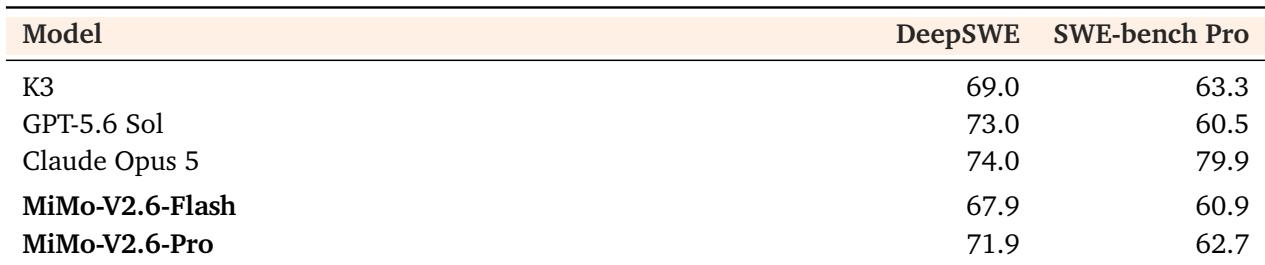
本实验评估经过使用 Gagar 的工业规模混合任务 RL 训练后的 MiMo-V2.6-Flash 和 MiMo-V2.6-Pro 在编码基准上的表现。结果表明,MiMo-V2.6-Pro 与强大的外部模型相比具有竞争力,在 DeepSWE 上优于 Kimi K3,尽管参数量少得多,并在 SWE-bench Pro 上超过 GPT-5.6 Sol,同时在 DeepSWE 上接近 GPT-5.6 Sol 和 Claude Opus 5,但在 SWE-bench Pro 上仍低于 Claude Opus 5。MiMo-V2.6-Flash 也在 DeepSWE 和 SWE-bench Pro 上取得接近更大外部模型的分数。