Command Palette
Search for a command to run...
Duplex-MPE:面向全双工对话中多方交互的基准评测
Duplex-MPE:面向全双工对话中多方交互的基准评测
Chengqian Ma Wenhao Feng Weixuan Jin Gaole Dai Tianyu Xie Yuexiao Ma Zhaolu Kang Xiangyu Zhao Xiawu Zheng Fei Chao
摘要
实时全双工语音模型能够在说话的同时倾听,从而支持无需严格话轮边界的自然交互。现有基准测试评估了话轮转换、打断处理和多轮对话,但大多以一名指定用户为中心,而非关注在多人共享对话中参与的助手。我们提出 Duplex-MPE,用于评估此类助手应在何时回答、保持沉默或停止说话。该基准包含 2,000 个场景,每个场景有三到四名人类说话者和一名助手,并针对同一请求的显式与隐式称呼进行成对设置。模型接收连续的对话音频,不提供转写文本或给定的话轮边界。四项评分指标分别衡量新响应发起、回答准确性、保持沉默以及在人类解决请求时停止说话。我们评估了五个开放权重语音系统:MiniCPM-o 4.5、Moshi、FLM-Audio、Voila 和 Freeze-Omni。MiniCPM-o 4.5 在三项评分能力上领先,而其他系统的频繁发言可能与不准确的回答或未能保持沉默同时出现。基于转写文本的 Gemini 3.1 Pro 参考系统对显式请求的响应频率比隐式请求高出 64.3 个百分点;配对检验未检测到语音系统在响应率上的显著差异。
一句话总结
北京大学、中国人民大学的研究人员及合作者提出 Duplex-MPE,这是一个包含 2,000 个场景的基准,用于评估全双工语音助手在三到四名人类说话者的对话中应当何时回答、保持沉默或停止说话。他们发现,MiniCPM-o 4.5 在五个被评估的开放权重语音系统中,在三项评分能力上处于领先地位,而语音模型在显式与隐式请求的响应率上没有显著差异。
核心贡献
- Duplex-MPE 是一个全双工多方基准,包含 2,000 个场景,每个场景有三到四名人类说话者和一名助手;每个场景都针对同一请求的显式与隐式称呼进行配对,并分别评分新响应启动、答案准确性、保持沉默,以及在人类解决请求时停止说话。
- 该基准将受话人识别视为对连续对话音频的潜在语音控制决策,要求模型在没有转录文本或给定轮次边界的情况下跟踪所有参与者,并决定何时开始说话、回答、保持沉默或让出发言权。
- 对五个开放权重语音系统的评估显示,MiniCPM-o 4.5 在三项评分能力上处于领先,而其他系统的频繁说话可能与不准确答案或未能保持沉默同时出现。基于转录的 Gemini 3.1 Pro 参考系统对显式请求的响应频率比隐式请求高 64.3 个百分点,而配对测试未检测到这些语音系统在显式与隐式请求之间的响应率存在显著差异。
引言
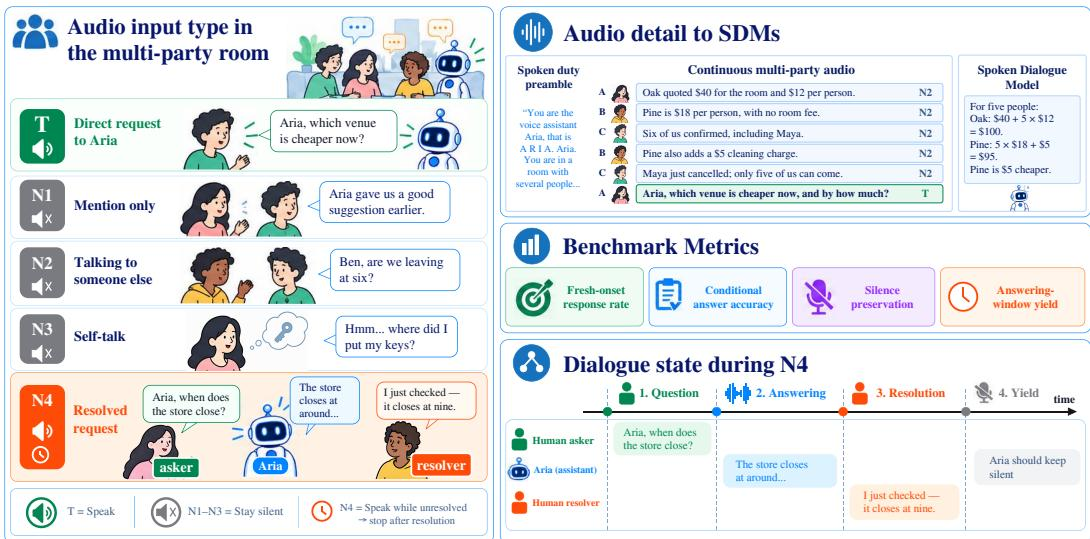
语音助手越来越依赖能够在说话时同时倾听的全双工语音模型,但它们的价值取决于选择性参与:在会议或车内等共享多方环境中决定何时说话、保持沉默或停止。先前的口语和全双工基准主要评估孤立请求或用户与助手的对话,并注入打断和背景语音,且没有测试助手是否能够跟随多方对话、推断谁在被称呼,并在其他参与者解决请求时克制不说话。作者提出 Duplex-MPE,这是一个包含 2,000 个连续多方语音场景的基准,并配有配对的显式和隐式请求,分别衡量响应启动、答案正确性、保持沉默,以及在人类解决请求后停止。
数据集
Duplex-MPE 基准是一个用于接收连续多方音频的语音助手的评估数据集。它为每个轮次分配一个预期动作,将每个场景按显式和隐式称呼形式配对,以无辅助信息的方式流式输入音频,并在各自独立的分母上对四项能力进行评分。评估单元是一个场景在一种称呼条件下的表现,因此从 2,000 个场景对中得到 4,000 段被评估对话。
来源与构建
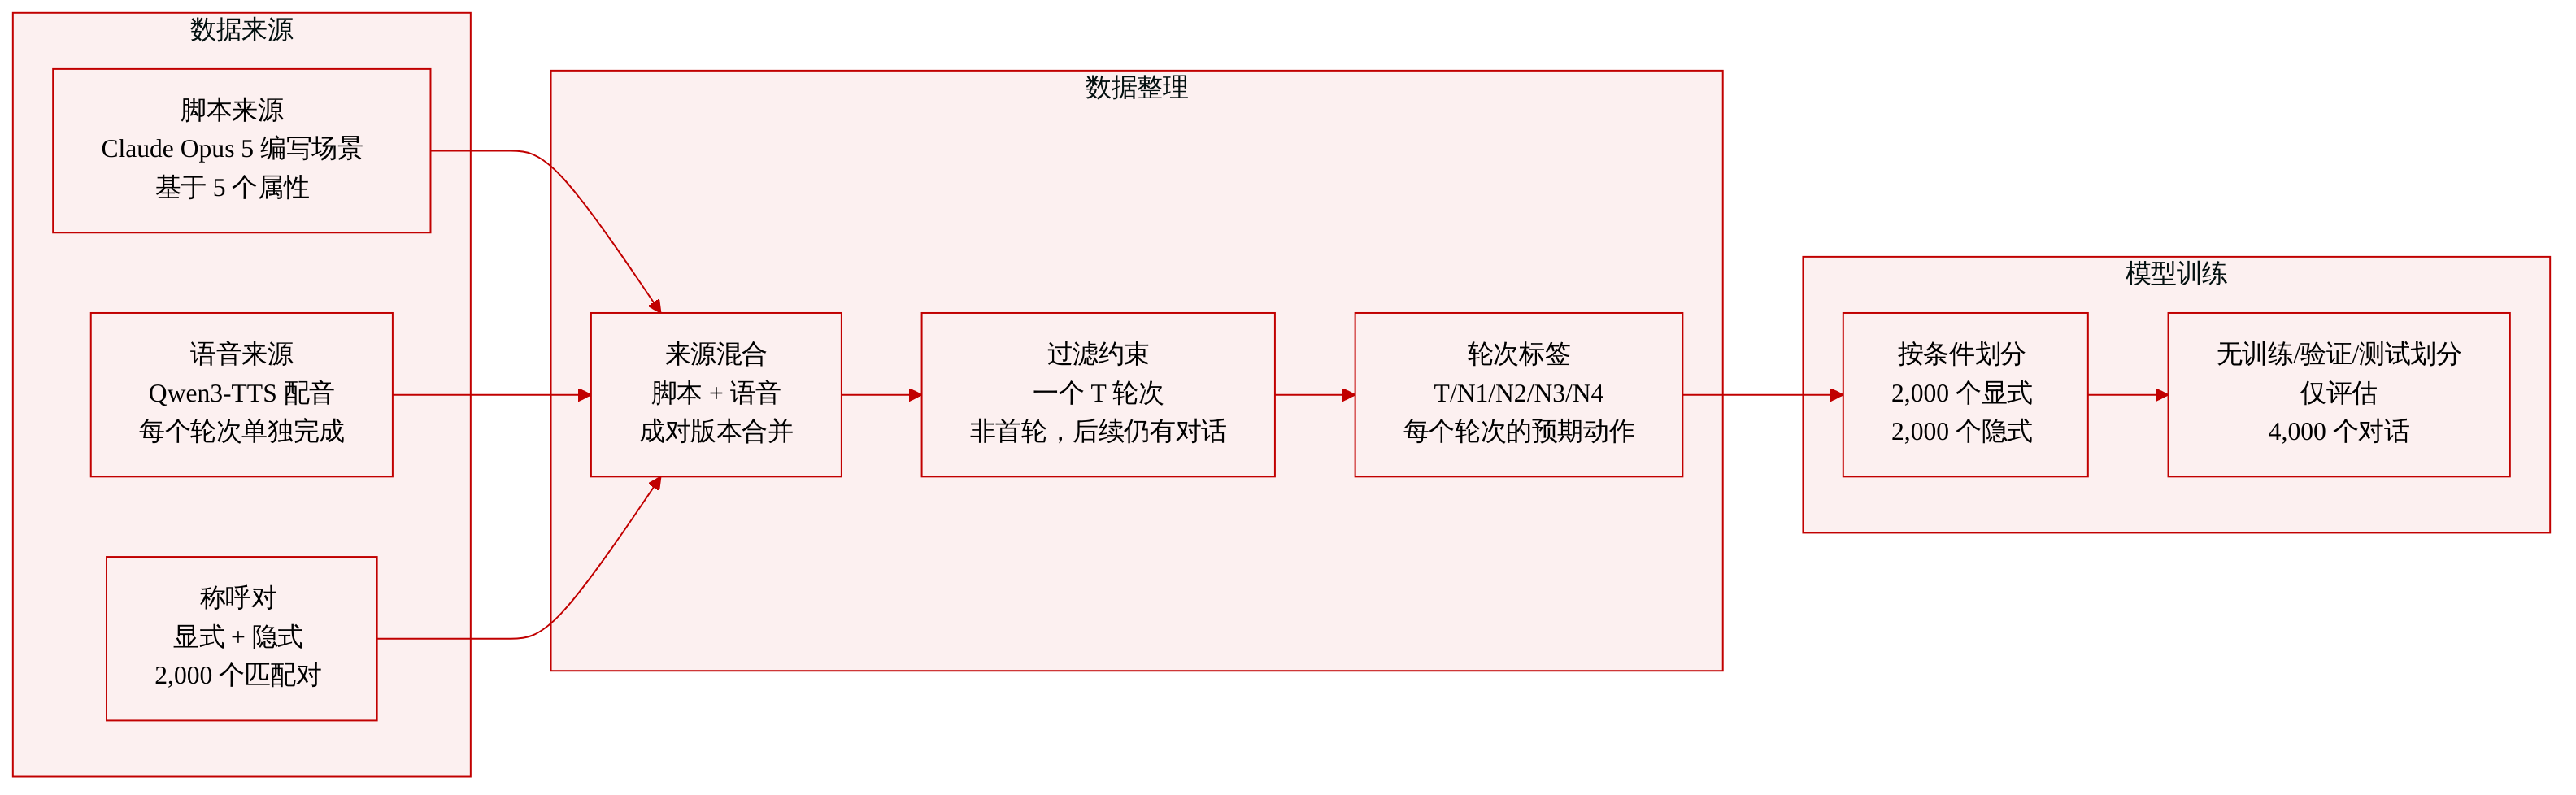
- 脚本来源:作者使用 Claude Opus 5,根据五个属性的组合生成多方对话脚本:场景、活动、关系、设备语境和语域。
- 脚本内容:每个脚本指定人类说话者、他们的语句和轮次标签,以及直接请求轮次的金标准答案。
- 语音来源:Qwen3-TTS 在确定的说话者到声音映射下分别合成每个人类轮次。
- 金标准边界:逐轮合成提供构造层面的金标准轮次边界。
- 过滤约束:每个场景在指定的位置桶中恰好包含一个直接请求轮次。该轮次从不是第一个,并且总是后接更多对话。如果存在 N4 问题,则按设计向 Aria 提出,但被作为单独的时序事件处理,其请求稍后得到解决。
轮次标签模式
- T:向 Aria 提出的、仍未解决的直接请求;这是唯一要求响应的普通轮次,每个场景恰好包含一个。
- N1:提到 Aria 但没有要求其做任何事;要求保持沉默。
- N2:该轮次面向 Aria 之外的某人或某物,包括其他人类或助手;要求保持沉默。
- N3:没有指定受话人的语音,包括自言自语和出声思考;要求保持沉默。
- N4:测试当 Aria 的回答不再需要时,它是否会停止。它包含向 Aria 提出的问题 N4_Q,以及稍后的解决事件 N4_R。模型在 N4_Q 结束到 N4_R 开始之间有 3 秒的响应时间窗口,并且在听到 N4_R 时应停止或保持沉默。
配对的显式与隐式条件
- 对于每个生成的场景,作者通过反转 T 轮次是否明确称呼 Aria 来构造对应场景。
- 这产生了 2,000 个配对场景和 4,000 条音频流。
- 每对包含一个显式条件和一个隐式条件:在显式条件中 T 轮次称呼 Aria,在隐式条件中必须从对话上下文中推断预期受话人。
- 场景级任务保持固定,每对中的金标准答案完全相同。
- 重写以 T 轮次为目标:显式称呼时加入名字,隐式称呼时用上下文线索替换。
- 如果 T 轮次无法自然携带标识助手的线索,则同时修改紧接其前的轮次。
- 重写最初保留轮次数量和事件标签序列,但后续的 N4 编辑和分别合成可能会在最终配对版本之间引入措辞、事件数量和音频差异。
规模与统计
- 按条件划分的数据集:2,000 个显式版本和 2,000 个隐式版本,每个场景对各一个。
- 去重后的人类语音片段:61.10 小时。
- 构建的总音频:4,000 段对话共 110.93 小时,包括重复使用的片段和轮次间停顿。
- 额外音频:口头任务前导语和依模型而定的等待时间另计。
- 平均评估对话长度:99.8 秒。
论文如何使用这些数据
- 在所描述的材料中,该基准用于评估,而非作为训练集。
- 本文没有在本节中指定训练划分或混合比例。
- 主要用途是评估选择性语音响应行为:Aria 是否在需要时回答、对 N1、N2 和 N3 轮次保持沉默,并在 N4 解决后停止。
- 响应存在性在完整的显式与隐式配对场景之间进行比较,而不将差异仅归因于助手名字的出现。
方法
作者设计了一套系统化流程来构建 Duplex-MPE 基准,该基准评估语音模型在连续多方音频中的选择性响应能力。构建过程从场景属性流向配对音频流,如框架图所示。
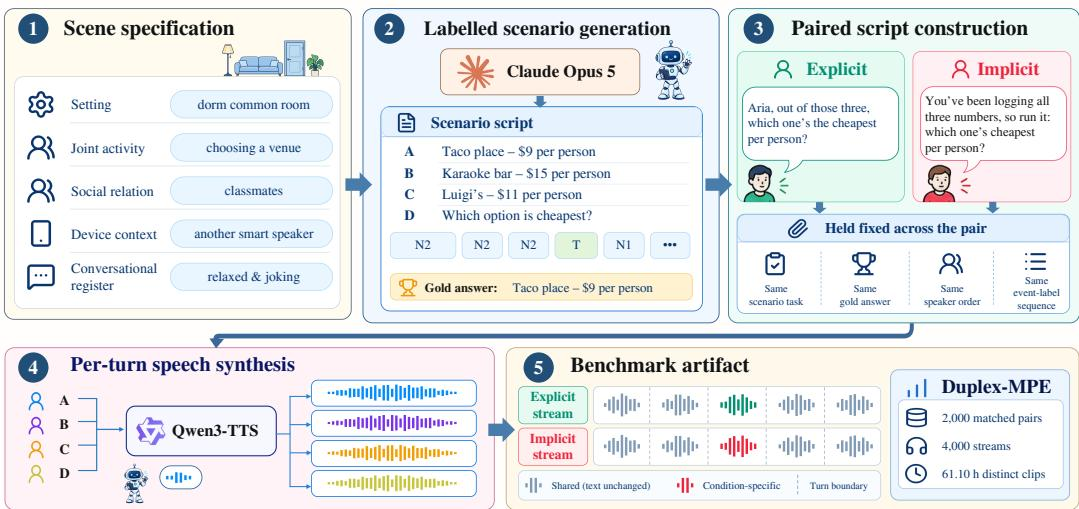
流程从场景规范开始,其中五个核心属性定义了上下文:场景、共同活动、社会关系、设备语境和对话语域。这些属性指导带标签的场景生成阶段。作者利用 Claude Opus 5,根据这些属性组合生成多方对话脚本。每个脚本详细给出人类说话者、他们的语句、轮次标签以及目标任务的金标准答案。脚本被严格约束为在指定位置桶中恰好包含一个目标轮次,确保该轮次从不是第一个,并且总是后接更多对话,以避免时间线索。
接下来,流程进入配对脚本构建。对于每个生成的场景,作者通过反转目标轮次是否明确称呼助手来构造对应场景。这产生了由显式条件和隐式条件组成的匹配对,其中隐式条件下的预期受话人必须从上下文推断。重写过程保留轮次数量和事件标签序列,使场景任务、金标准答案和说话者顺序在配对中保持固定。
脚本生成之后,作者使用 Qwen3-TTS 进行逐轮语音合成。每个人类轮次在确定的说话者到声音映射下分别合成,这提供了构造层面的金标准边界。最后,通过将完成场景分组为显式和隐式版本,组装成基准制品。由此得到包含匹配对和去重音频流的数据集,并带有共享文本、条件特定的音频差异和精确轮次边界。
实验
Duplex-MPE 基准使用配对的显式和隐式称呼形式,在连续多方音频上评估全双工语音助手,并分别评分新响应启动、答案准确性、保持沉默和发言权释放。结果表明,较高的响应存在性可能掩盖较弱的新启动、较差的答案正确性或不分情况的说话,而显式称呼对以转录为条件的参考系统影响很大,但对所测试的语音系统几乎没有系统性差异。发言权释放仅对真正进入回答窗口的系统才有意义,并且对某些模型来说,较晚出现的请求往往会降低响应或准确率。敏感性检查确认,保持沉默的排名稳定,而选择新响应启动率而非响应存在性会改变模型排名。
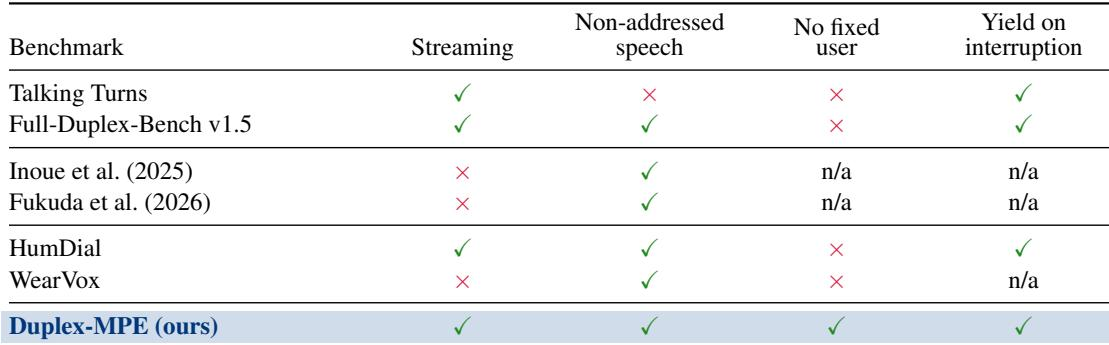
比较表明,Duplex-MPE 是唯一同时包含流式交互、无明确受话人语音、无固定用户设置和被打断时让出的协议。现有基准只覆盖部分组合:一些流式基准省略了无明确受话人语音,而聚焦受话人的基准通常是非流式的。全双工基准支持流式且包含无明确受话人语音,但仍假设存在固定用户。Duplex-MPE 是唯一同时结合流式、无明确受话人语音、无固定用户和被打断时让出的被评估协议。Full-Duplex-Bench v1.5 和 HumDial 同时包含流式和无明确受话人语音,但不支持无固定用户设置。以 Inoue 等人和 Fukuda 等人为代表的聚焦受话人基准包含无明确受话人语音,但不是流式的。Talking Turns 支持流式和被打断时让出,但省略了无明确受话人语音。
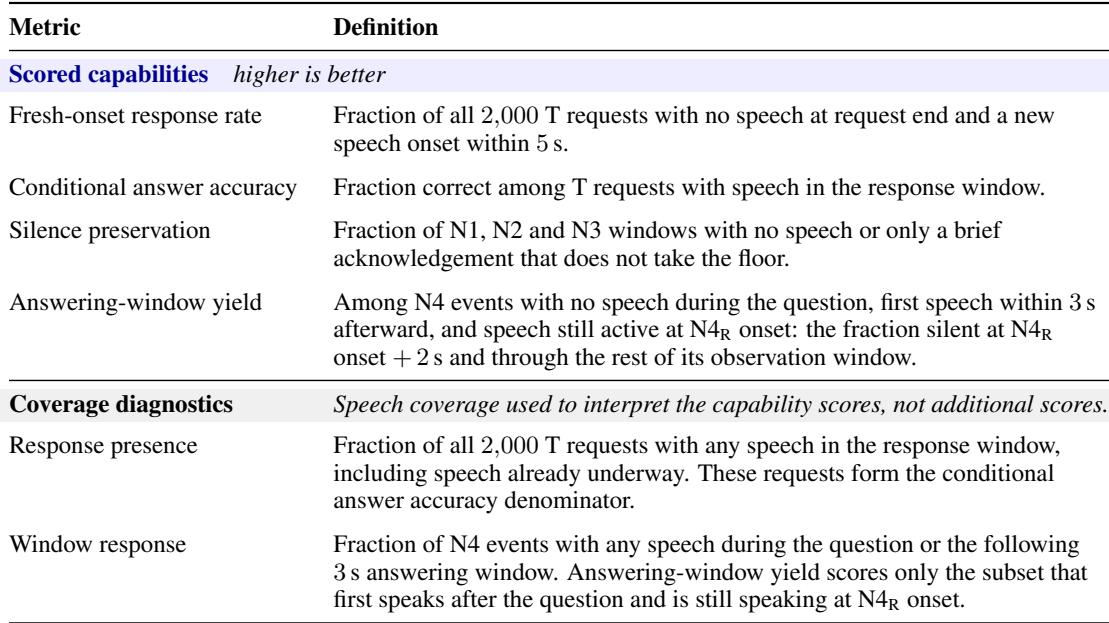
Duplex-MPE 定义了四项评分能力,用于评估连续多方对话中的选择性参与:新响应启动率、条件答案准确性、保持沉默和回答窗口让出。另外两项覆盖率诊断指标,即响应存在性和窗口响应,在不计分的情况下揭示分母覆盖率和时序构成。这些指标定义区分了新的说话决策与宽松的语音覆盖,并要求保持沉默的窗口内要么没有助手语音,要么只有不占取发言权的简短确认。新响应启动率只在请求后不久开始出现新的助手语音起始,并且在该边界处没有助手语音已经活跃时,才将该请求计入。响应存在性统计响应窗口内的任何语音,包括已经在进行的语音,并作为条件答案准确性的分母。保持沉默在 N1、N2 和 N3 窗口上评估,只有在没有助手语音或仅出现不占取发言权的简短确认时才算通过。条件答案准确性只在有语音可用的地方评估,因此沉默轮次不提供可判断的答案内容。敏感性分析显示,排名可能在新响应启动率和响应存在性之间变化,其中某个模型因频繁的延续性说话,从响应存在性下的第一名变为新响应启动率下的最后一名。
MiniCPM-o 在显式和隐式称呼两种条件下,在所有评分能力上都领先于所列模型,其中在条件答案准确性和保持沉默方面的优势尤其明显。显式与隐式称呼在大多数指标上只带来适度差异。保持沉默的排序在不同语音时长阈值下保持稳定,并得到基于重采样的置信区间支持。MiniCPM-o 在显式和隐式称呼两种条件下均取得最高的新响应启动率、条件答案准确性、保持沉默和回答窗口让出。Moshi 和 FLM-Audio 的条件答案准确性远低于 MiniCPM-o,其中 FLM-Audio 接近零,尽管响应存在性和窗口响应较高。所报告的保持沉默排序在不同简短语音检测阈值下保持不变,并得到重采样置信区间的支持。
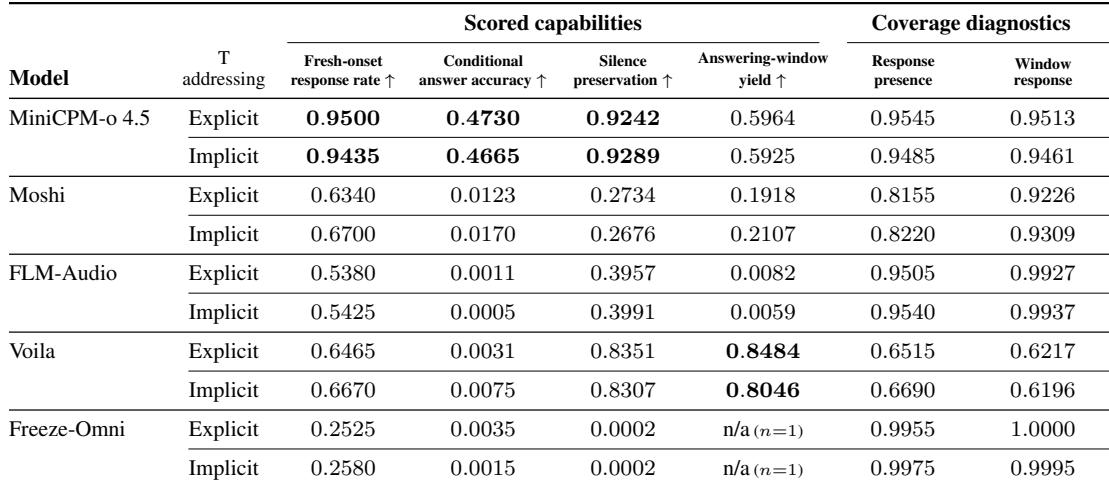
这些实验确立 Duplex-MPE 是唯一同时支持流式交互、无明确受话人语音、无固定用户设置和被打断时让出的被评估基准,而现有基准只覆盖部分组合。指标设计实验表明,将新响应启动与宽松语音覆盖区分开是必要的,因为频繁延续性说话的模型在基于存在性的指标下可能看起来很强,但在新响应启动评分下排名更差。在显式和隐式称呼下的模型评估发现,MiniCPM-o 在所有评分能力上处于领先,而 Moshi 和 FLM-Audio 尽管语音存在性较高,答案准确性却低得多,且称呼模式对大多数结果只有适度影响。