Command Palette
Search for a command to run...
InternW0-∆:基于 20K+ 小时开放数据、桥接预测动力学与动作的世界动作模型
InternW0-∆:基于 20K+ 小时开放数据、桥接预测动力学与动作的世界动作模型
摘要
世界动作模型(WAMs)通过联合建模视觉动力学与动作生成,已成为通用机器人操作的一种有前景的范式。其核心挑战在于,如何将来自大规模预训练模型的互补先验——包括视觉动力学、场景语义以及几何与运动理解——有效整合到一个统一的机器人动作生成框架中。我们提出了 InternW0-∆,这是一个统一的世界动作模型,能够应对上述挑战:它在大规模异构语料上进行预训练,在多种仿真基准和真实机器人平台上的表现均优于先前方法。InternW0-∆ 在 Mixture-of-Transformers(MoT)框架中融合了预训练视觉动力学、场景级语义理解、4D 几何与运动先验以及动作生成。在 World–Action MoT 中,预训练视频专家与动作专家在冻结 VLM 提供的场景锚定语义引导下交互,而预训练 4D 基础模型则通过仅在训练时进行的蒸馏注入几何与运动先验。为了将预测性视觉动力学转化为对动作预测有用的表征,我们提出了 Causal Imprint,它通过仅在训练时提供的未来监督来学习与未来相关的场景变化,并使这些预测性表征能够直接供动作专家使用,而无需在推理时进行未来视频推演。为支持大规模联合训练,我们构建了一个异构语料库,涵盖机器人演示、UMI 数据、第一人称视角人类演示和 Ego2Robot 数据;这些数据经过精心整理与过滤,统一到一种公共的 state-action 表征下,并完成时间对齐,最终得到超过 20K 小时的已处理训练数据,据我们所知是同类中最大的开源语料库。我们在该异构语料库上对 InternW0-∆ 进行预训练,并在多种仿真基准和真实机器人平台上展现出强大的性能。我们将开源训练代码、模型权重、基础设施和数据处理流程,并在许可证允许的情况下提供处理后的数据,以加速具身智能和物理人工智能的发展。
一句话总结
上海人工智能实验室 Physical Intelligence Team 的研究人员介绍了 InternW0-∆,一个统一的世界动作模型,它结合了 Mixture-of-Transformers 框架和 Causal Imprint,以整合预训练视频、动作、语义和 4D 几何先验,并在超过 20K 小时的异构开放语料上训练,在仿真和真实机器人基准上优于先前方法。
核心贡献
- 本文提出了 InternW0-∆,一个统一的世界动作模型,在 Mixture-of-Transformers 框架内结合预训练视觉动力学、场景级语义理解、4D 几何与运动先验以及动作生成,在多个仿真基准和真实机器人平台上优于先前方法。
- Causal Imprint 从仅训练阶段的未来监督中学习与未来相关的场景变化,并将这些预测性表示暴露给动作专家,从而在推理时无需未来视频 rollout 即可获得预测性视觉动力学的好处。
- 该工作构建了一个经过筛选、过滤和时间对齐的超过 20,000 小时的预训练语料,涵盖机器人演示、UMI 数据、第一视角人类演示和 Ego2Robot 数据,并在统一的状态-动作表示下进行整合,将所得模型迁移到仿真基准、真实机器人平台、夹爪操作和灵巧手设置中。
引言
世界动作模型是通用机器人操作的一个有前景方向,因为它们联合建模视觉动力学和机器人动作,且大规模视频预训练可以提供有用的视觉和时间先验。然而,预测未来观测的能力并不直接转化为有效控制:动作生成还需要识别与任务相关的变化、推理物体的几何与运动,并将这些线索与当前指令和场景建立关联。此前 WAM 通常依赖推理时的未来视频生成,或者没有让动作路径直接访问预测性表示。为了解决这一问题,作者提出了 InternW0-∆,一种有向世界-动作架构,它将预训练视频专家与动作专家耦合,利用 Causal Imprint 和仅训练阶段的 4D 感知蒸馏注入与动作相关的未来、几何和运动信息,而无需在推理时采样未来视频。
数据集
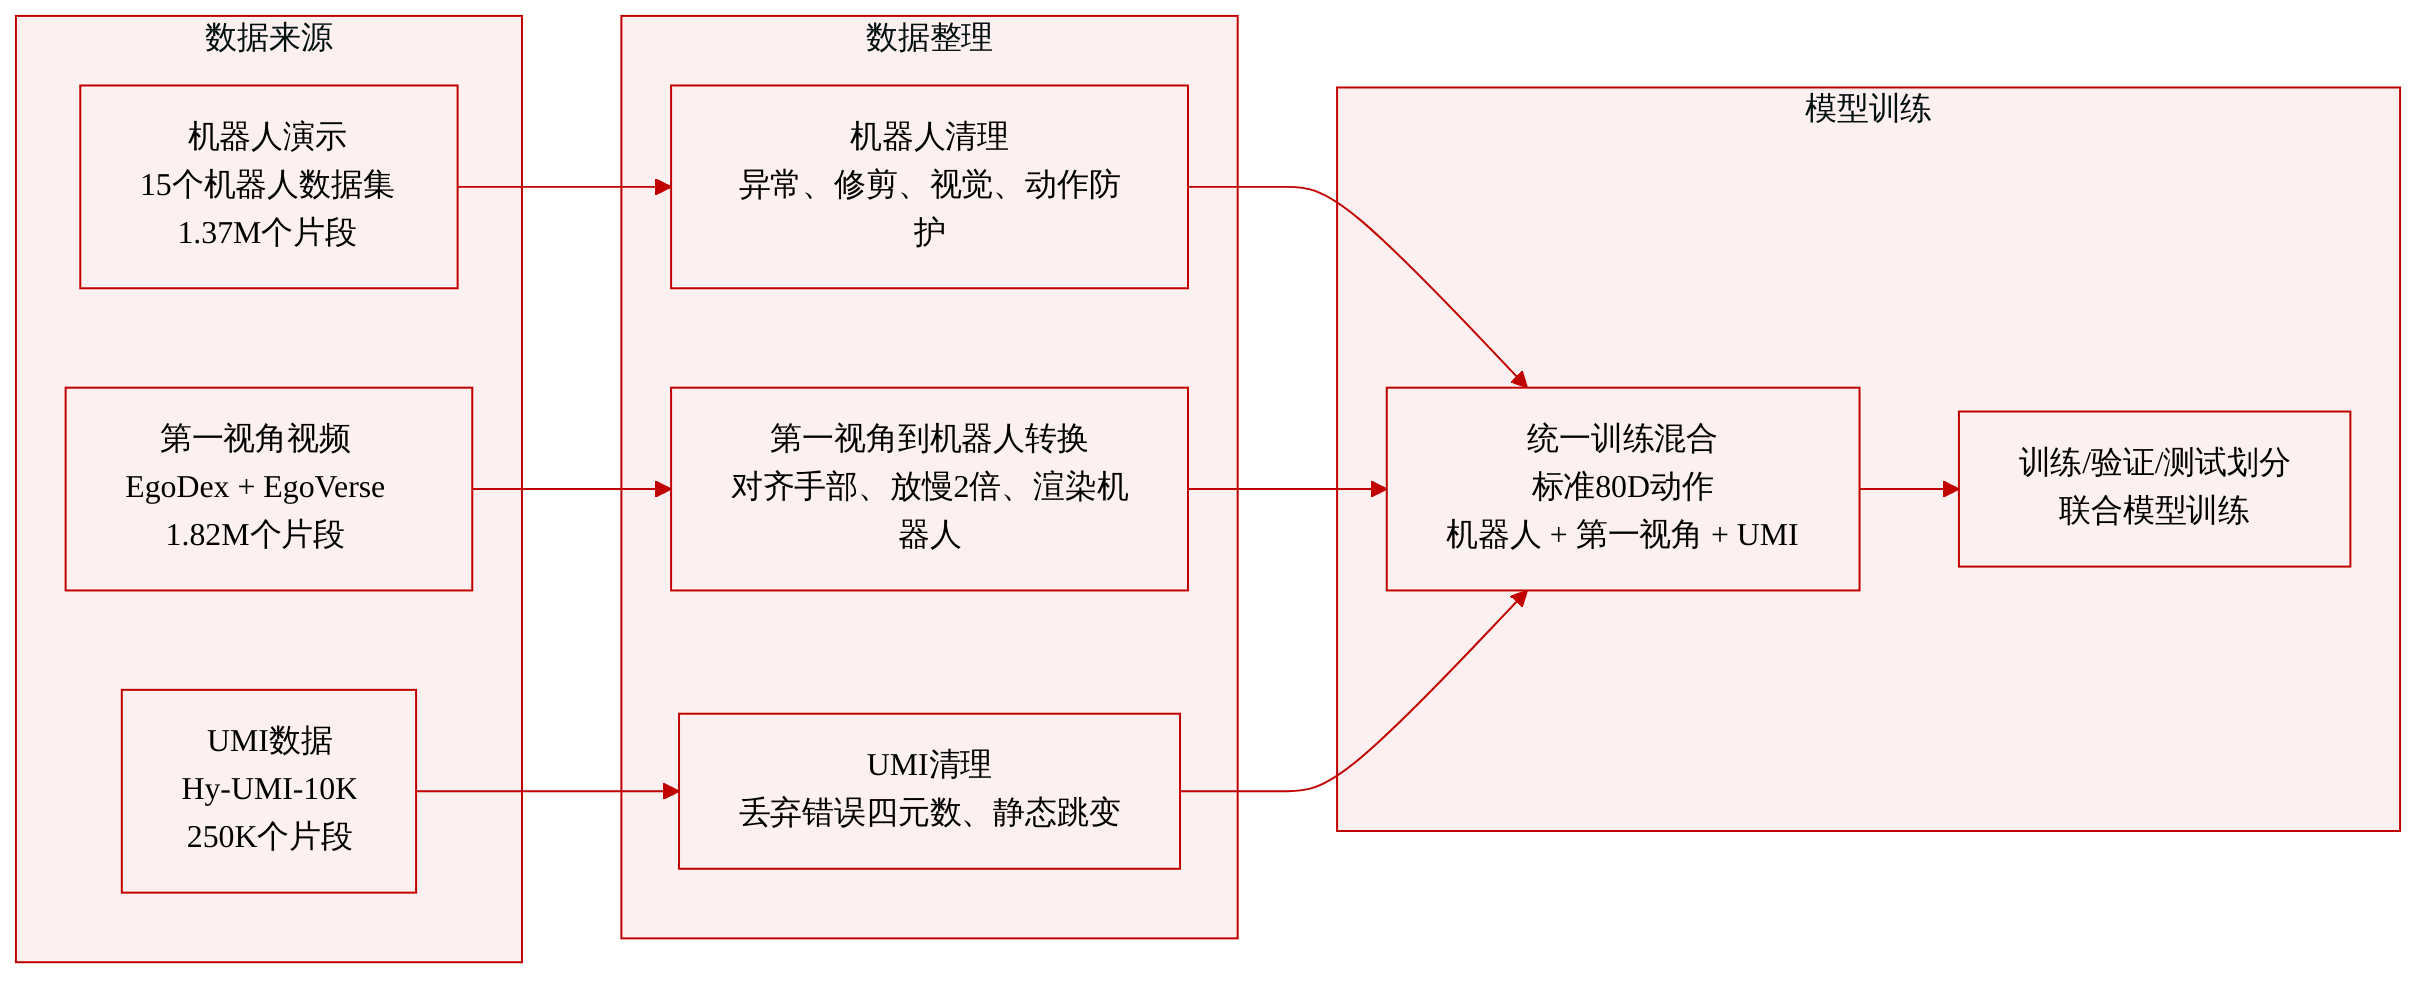
数据集概览
作者使用多源具身数据集进行联合训练。它结合了机器人操作演示、第一视角人类视频、ego-to-robot 转换数据和 UMI 数据。所有轨迹都统一在一种规范的状态-动作表示下。
统一表示
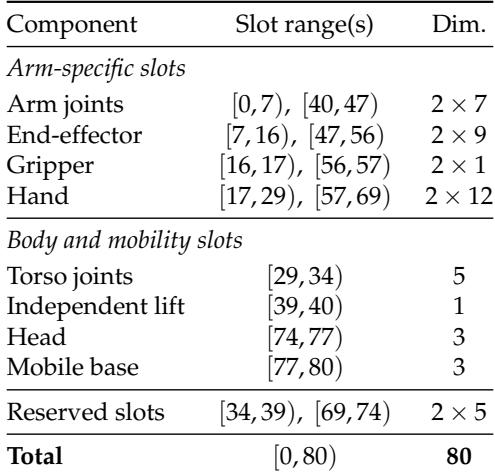
- 所有机器人动作被映射到一个共享的 80 维动作空间,并具有固定语义槽位。
- 机器人状态保留绝对量:当前关节位置、绝对末端执行器位姿以及当前夹爪或手部配置。
- 末端执行器位姿表示为 3D 位置加上连续 6D 旋转。
- 对于平行夹爪,手部状态使用夹爪开度;对于灵巧手,则使用手部关节配置。
- 动作区分关节空间中的绝对目标关节位置与任务空间中的相对末端执行器运动。
- 任务空间末端执行器动作在当前末端执行器局部坐标系中使用 3D 平移增量和 3D 旋转向量。
- 一个动作片段包含 Ha 个连续规范动作向量。
机器人操作数据
作者整合了来自仿真和真实环境的 15 个机器人数据集。报告的来源细节包括:
- AgiBotWorld:超过 100 万条轨迹,约 3,000 小时,双臂人形数据,217 个任务,多模态相机和触觉传感器。
- InternData-A1:超过 63 万条轨迹,7,400 小时,四种具身形态,70 个任务,227 个场景,仿真和真实。
- RoboMIND / RoboMIND 2.0:107K 条轨迹,涉及 479 个任务;2.0 版扩展到超过 310K 条双臂轨迹、六种具身形态、739 个任务。
- RW-RL Dataset:超过 1,000 小时的真实交互,结合了遥操作演示、自主 rollout、干预、奖励和终止标签。
- Dexora:100K 条仿真加 10K 条真实双臂灵巧操作轨迹。
- ABC-130K:超过 130K 个真实双臂回合,超过 3,500 小时,195 个任务。
- Galaxea Open-World Dataset:超过 500 小时的真实移动操作,带子任务级语言标注。
- RoboCOIN:超过 180K 条演示,覆盖 15 个机器人平台、421 个任务、16 个场景。
- RH20T:超过 110K 条接触丰富序列,147 个任务,包含力、音频、深度和部分触觉数据。
- RDT-1B:将 46 个数据集聚合为超过 100 万个回合,另有超过 6K 条 ALOHA 演示。
- RoboSet:约 31K 条真实厨房轨迹,涵盖 40 个任务,另有仿真轨迹。
- RealSource-World:超过 1,400 万帧,超过 11K 个双臂回合,35 个任务,带有原子技能分割和质量标注。
- MolmoAct2-BimanualYAM:超过 720 小时的真实双臂操作,带多视角观测和语言标注。
- HABIT:超过 10K 个回合,160 小时,60 个涉及有人在场操作的任务。
- ActionNet:超过 30K 条遥操作轨迹,约 140 小时,灵巧双臂人形操作。
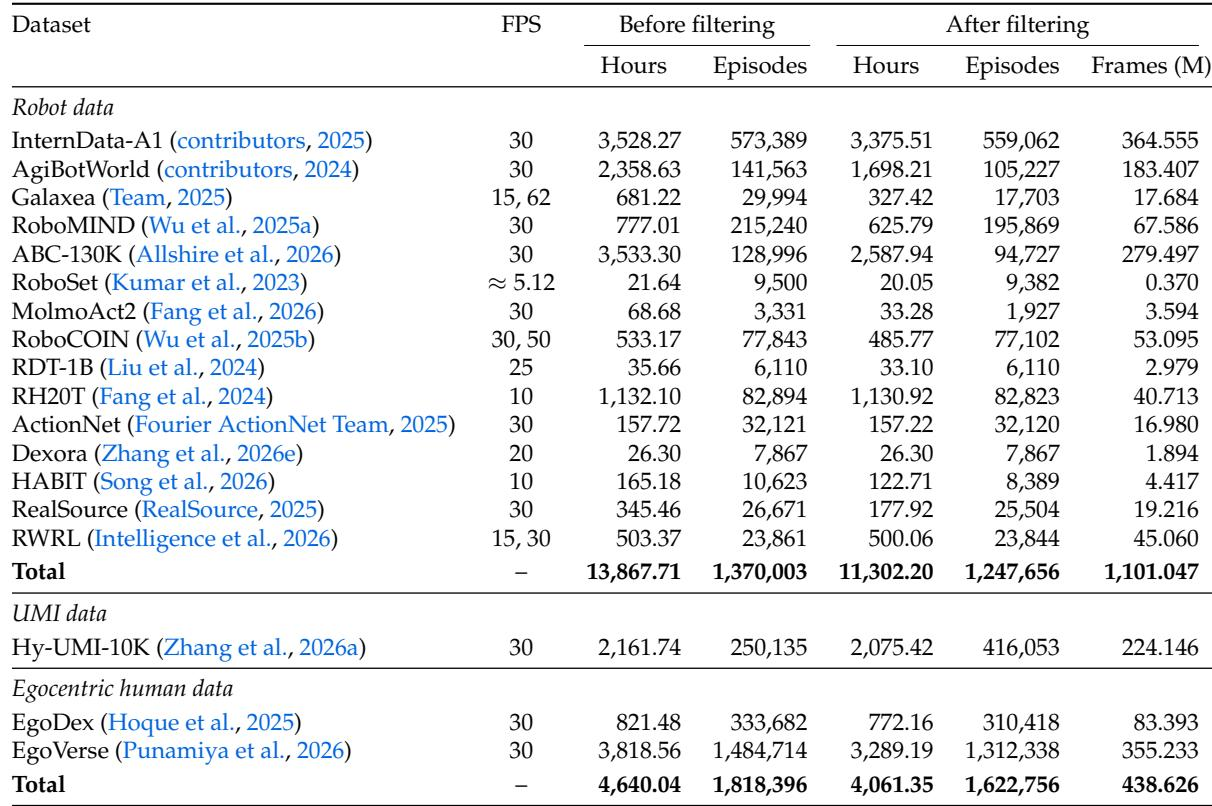
过滤前,机器人数据总计 13,867.71 小时,涉及 1,370,003 个回合。过滤后,作者保留 11,302.20 小时,涉及 1,247,656 个回合,对应 1,101.047 百万帧。
机器人数据处理规则
机器人处理流水线按顺序应用以下阶段:
- 信号异常与一致性过滤:移除非有限值、突变异常值以及状态-动作不一致;使用局部互相关对齐,默认一致性阈值为 0.65。
- 静态边界裁剪:自适应移除回合边界处的长时间静止,同时保留中间停顿。
- 视觉质量过滤:检测黑帧、模糊、压缩伪影、极端时间变化、块效应和饱和度异常。
- 动作幅度保护:拒绝单步平移超过 0.2 m 或旋转超过 0.5 rad 的末端执行器动作。
- 指令正确性过滤:使用 LLM 移除空、格式错误、不完整或不清晰的指令。
- 视频-指令一致性过滤:使用视觉-语言模型将夹爪事件片段和全局帧与指令进行比较。
- 人工语义验证:在解码关节轨迹并将末端执行器位姿与录制视频进行可视化对比后,对采样回合进行检查。
第一视角与 ego-to-robot 数据
作者使用:
- EgoDex:829 小时第一视角人类演示,涵盖 194 个桌面任务,使用 Apple Vision Pro 采集。它提供 30 Hz RGB 视频、3D 头部/上半身/手部位姿、相机内参、相机位姿和语言描述。
- EgoVerse:约 473K 条记录的快照扩展,产生 148 万个分割后的回合和 3,819 小时。它包含第一视角视频、3D 手部关键点、6-DoF 头部姿态和任务描述,并为行业贡献数据提供子任务级语言标注。
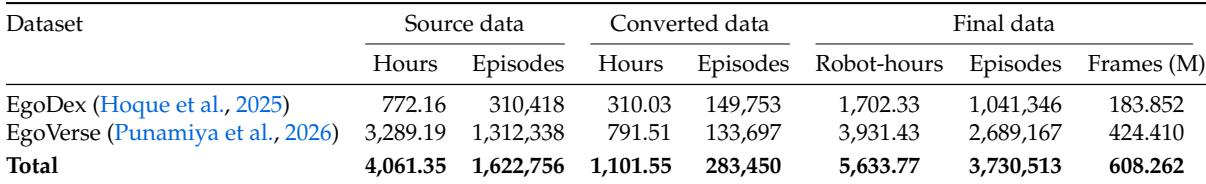
过滤后,EgoDex 和 EgoVerse 合计从 4,640.04 小时中保留 4,061.35 小时,从 1,818,396 个回合中保留 1,622,756 个回合。保留时长分别为 EgoDex 772.16 小时和 EgoVerse 3,289.19 小时,合计 438.626 百万帧。
第一视角数据处理包括:
- 动作对齐:将人类手腕位姿转换为相机相对末端执行器状态。夹爪开度通过指尖几何估计,5 cm 映射为完全闭合,7 cm 映射为完全打开。
- 动作速度对齐:EgoDex 和 EgoVerse 轨迹被放慢至原来的二分之一。
- 第一视角数据仅进行动作对齐和动作速度对齐。
Ego2Robot 转换增加:
- 运动学对齐:基座选择与逆运动学耦合,使用由粗到细的轨迹验证来检测跟踪失败和不连续的 IK 分支。
- 视觉对齐:SAM3 分割人体区域,ProPainter 将其移除,并将渲染的机器人合成到修复后的场景中。
- 深度感知合成使用度量手部关键点和物体掩码,并保留下游训练所需的有效性掩码。
经过滤的 EgoDex 和 EgoVerse 视频中,流水线覆盖 1,101.55 小时,来自 283,450 个唯一来源回合。它产生 5,633.77 个机器人小时,涉及 3,730,513 个训练回合,合计 608.262 百万帧。机器人小时是在动作速度放慢至原来的二分之一之前报告的。
UMI 数据
作者使用公开的 Hy-UMI-10K 版本:
- 约 250K 个回合,共 2,162 小时。
- 头部相机和腕部相机 RGB 视频,配合 6-DoF 夹爪位姿、夹爪开度和任务描述。
UMI 过滤包括:
- 移除四元数范数满足 ∣∣q∣∣2≤10−8 的片段。
- 移除双手静止的片段:位置方差低于 5×10⁻⁴ m2,旋转方差低于 0.1 rad2。
- 应用轨迹异常过滤,并拒绝速度过快或位置/姿态突变。
过滤后,Hy-UMI-10K 从 2,161.74 小时、250,135 个回合减少到 2,075.42 小时、224.146 百万帧。由于保留的 UMI 轨迹被分割为多个训练回合,回合数增加到 416,053。
模型中的使用
本文在共享规范表示下使用过滤和转换后的数据进行联合训练。机器人数据、ego 数据、ego-to-robot 转换后的机器人数据以及 UMI 数据都提供对齐的状态和动作监督。导出的 ego-to-robot 训练片段必须包含至少 32 个动作步。数据集部分报告了过滤和转换量,但没有指定最终训练混合比例。
方法
作者提出了 InternW0-∆,一种有向世界-动作架构,整合了预训练视觉动力学、任务条件下的场景语义和动作生成。如下图所示,该框架通过一个有向 Mixture-of-Transformers(MoT)将预训练视频专家与动作专家耦合。冻结的视觉-语言模型向动作专家提供场景锚定的任务语义,而视频专家处理由 anchor、recent 和 current 观测组成的轻量稀疏记忆。本体感觉状态分别独立地作为两个专家的条件。
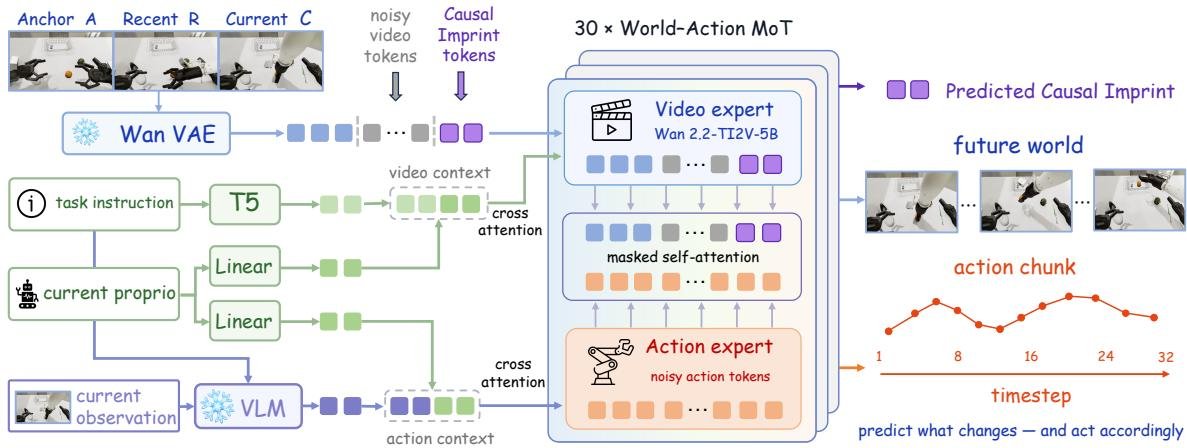
为了处理异构相机配置,多视角观测被调整尺寸并排列到统一视觉画布中,然后由预训练视频 VAE 编码以产生视觉 latent。模型维护一个稀疏视觉记忆,包括回合级全局记忆(anchor)、来自上一动作 chunk 的短期记忆(recent)以及当前观测。这种设计保留长期任务上下文和短期运动连续性,同时避免稠密历史带来的计算开销。本体感觉状态通过线性层分别投影到视频专家和动作专家的嵌入空间。对于任务条件,视频专家使用语言指令的 T5 嵌入来保留预训练语言先验。为了补充场景级理解,冻结的 VLM 联合处理有效当前视图和指令,为动作专家提供关于当前环境和任务的丰富多模态 token。
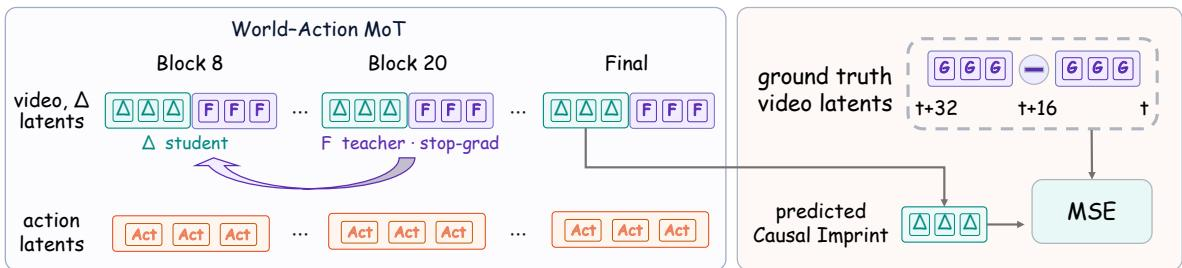
为了在不将已实现的未来观测暴露给动作预测路径的情况下学习与动作相关的动态表示,作者在视频专家的自注意力层中引入 Causal Imprint token。这些 token 聚合 recent 和 current 视觉特征,以捕获运动和状态转移。训练时,它们由干净真实视频 latent 之间的相邻差分监督,并与视频专家的中间特征对齐。如下图所示,Causal Imprint 的双重监督机制结合了对 latent 差分的直接回归与来自未来切片的特征对齐。
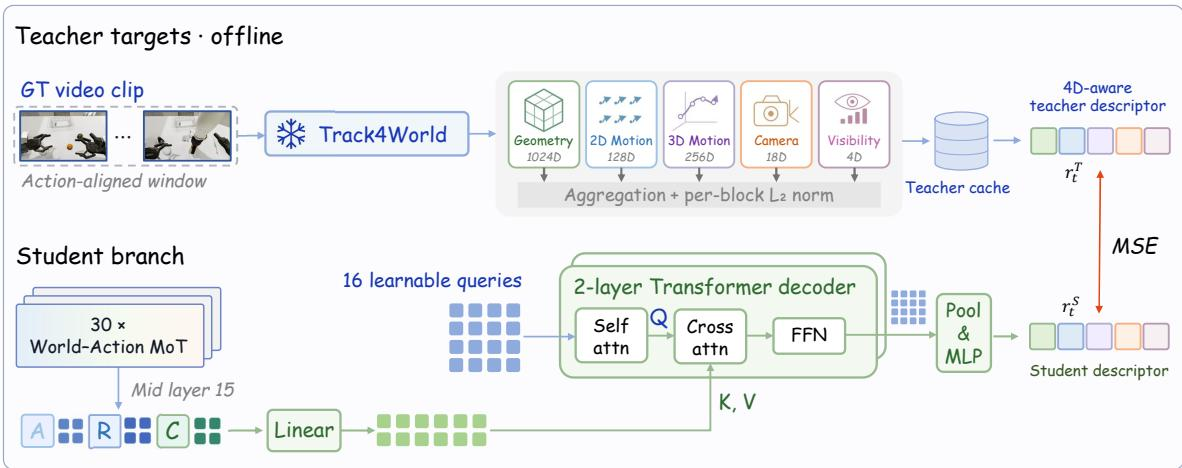
此外,为了用几何和运动感知表示增强视频专家,采用了一个仅训练阶段的蒸馏目标,使用冻结的 Track4World teacher。如下图所示,teacher 处理真实视频窗口,生成包含几何、2D/3D 运动和相机统计信息的 4D 感知描述符。一个 student 分支从视频专家中提取干净条件下的隐藏 token,通过 Transformer decoder 聚合它们,并使用辅助 MSE 损失将所得描述符与缓存的 teacher 描述符对齐。该蒸馏在不增加推理成本的情况下传递几何先验。
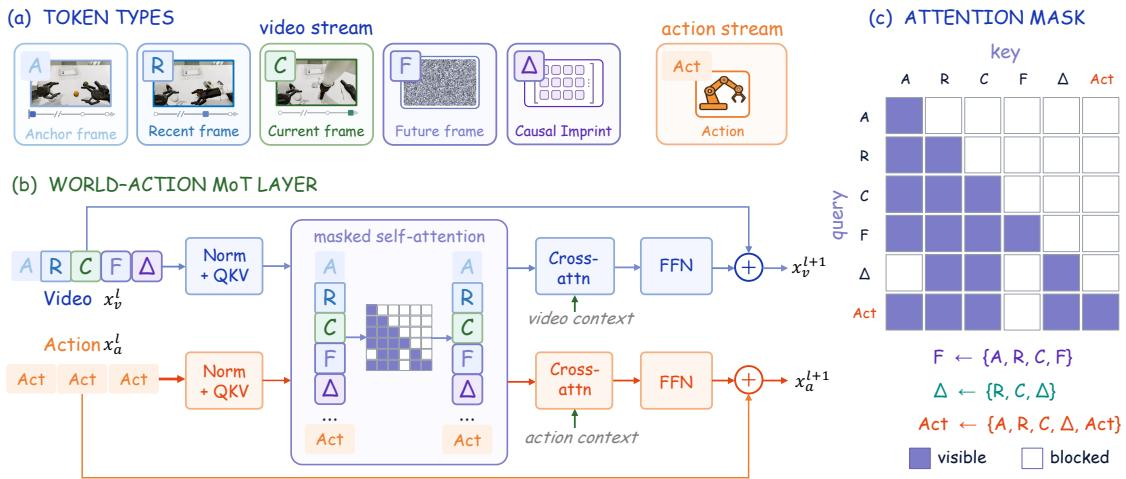
视频专家和动作专家保留各自模态特定的参数,但通过 MoT 块中的掩码联合注意力交换信息。在每个耦合 transformer 块中,两个专家独立计算 query、key 和 value 投影,将其拼接后执行单次注意力操作,然后再路由回各自的分支。如下图所示,详细给出了 token 类型、MoT 层结构和注意力掩码。该掩码严格控制信息流:未来帧 token 可以关注已观测上下文以进行未来预测,但 Causal Imprint 和动作 token 被禁止直接访问已实现的未来帧。这种有向流确保动作专家仅以已观测上下文和学习到的预测性表示为条件。
模型使用 flow matching 目标联合优化未来视频生成和动作预测。Causal Imprint token 通过针对相邻 latent 差分的平方误差损失,以及针对 detach 的未来视频特征的余弦对齐损失进行训练。4D 感知蒸馏使用辅助 MSE 损失将 student 描述符与缓存的 teacher 描述符对齐。总体目标以加权系数组合这些损失。
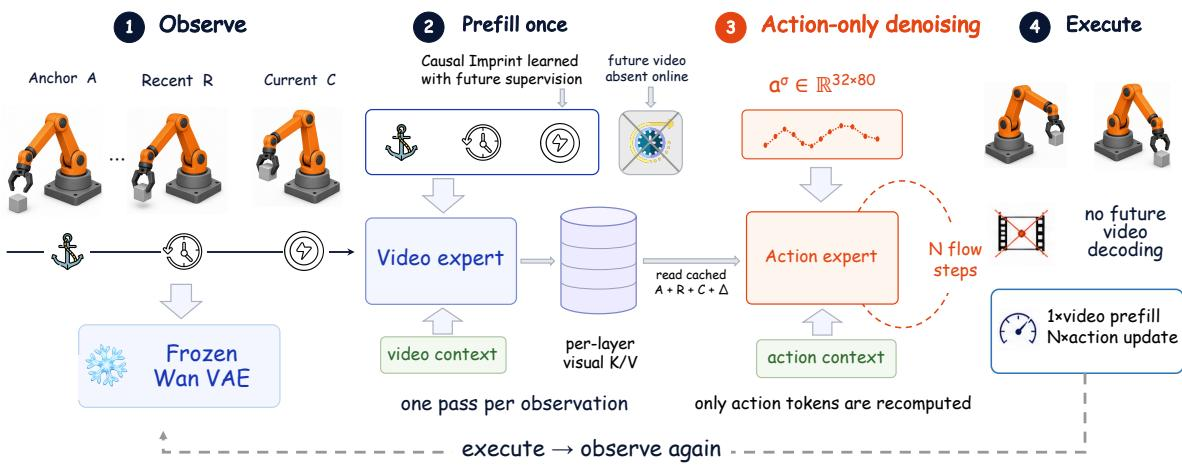
推理时,InternW0- 在不采样或解码未来视频的情况下生成动作 chunk。如下图所示,该过程从一次视频专家 prefill 开始,其中 anchor、recent 和 current 观测与 Causal Imprint token 一起被编码和处理。这些视觉 token 的自注意力 key/value 投影在每个 MoT 层被缓存。随后,动作专家在 N 个 flow 步骤上执行迭代的仅动作去噪,复用缓存的视觉特征并且只关注动作流。这种设计消除了未来视频 rollout 的需求,每个观测周期只需要一次视频专家 prefill 和 N 次动作专家更新。
实验
InternW0-∆ 在四个仿真基准(LIBERO-Plus、RoboTwin 2.0、EBench 和 RoboDojo)以及四个平台上的十一个真实机器人任务上进行了评估,另有关于训练效率、模型组件、数据源和 GPT 引导纠正的实验。训练优化带来端到端吞吐量 2.11 倍到 3.02 倍的加速,同时模型在 LIBERO-Plus 和 RoboTwin 2.0 上取得最佳总体结果,在长时程和扰动下表现强劲,并且预训练后真实机器人成功率从 20% 和 0% 提高到 95%,包括泛化到未见水位和跨具身部署。消融实验将改进归因于稀疏记忆上下文、VLM 表示、带表示对齐的 Causal Imprint、4D 感知蒸馏、机器人对齐的人类数据以及基于 GPT 的执行纠正,后者显著改善了困难的 RoboDojo 任务。
规范动作布局在 80 维向量中为机器人动作分配固定语义槽位,覆盖双臂操作和身体移动。成对的左臂和右臂组件分别获得关节、末端执行器、夹爪和手部的独立索引范围,而躯干关节占据专用块。这种格式标准化了异构动作维度,以支持跨具身学习。双臂槽位按侧分离,每一侧共享相同的臂关节、末端执行器、夹爪和手部组件结构。躯干关节被分配在臂特定槽位之外的专用身体移动范围内。
过滤使机器人集合减少了约 18% 的小时数和 9% 的回合数,同时保留约 11.0 亿帧。第一视角人类数据保留约 88% 的小时数和 89% 的回合数,UMI 数据在过滤后几乎保留了全部时长。机器人数据在过滤期间的小时数绝对减少量最大,损失约 2,566 小时和约 122,000 个回合。UMI 过滤仅移除少量时长,轨迹分割将回合数从约 250,000 增加到超过 416,000。
Ego2Robot 流水线将过滤后的 EgoDex 和 EgoVerse 第一视角视频转换为机器人训练数据。总体上,约四分之一的源视频小时数和不到五分之一的源回合成功完成合成。导出的数据集包含的机器人小时数和回合数远多于已转换的源覆盖率,其中 EgoVerse 贡献了最终训练量的大部分。EgoVerse 提供了大部分源小时数、转换小时数、最终机器人小时数和帧数,而 EgoDex 在其输入小时数和回合数中的转换比例更高。成功转换覆盖约四分之一的源视频小时数和不到五分之一的源回合,但最终导出的机器人回合数远多于已覆盖的源回合数。最终机器人数据集扩展到数百万个回合和数亿帧,每成功转换一个源小时产生超过五个机器人小时。
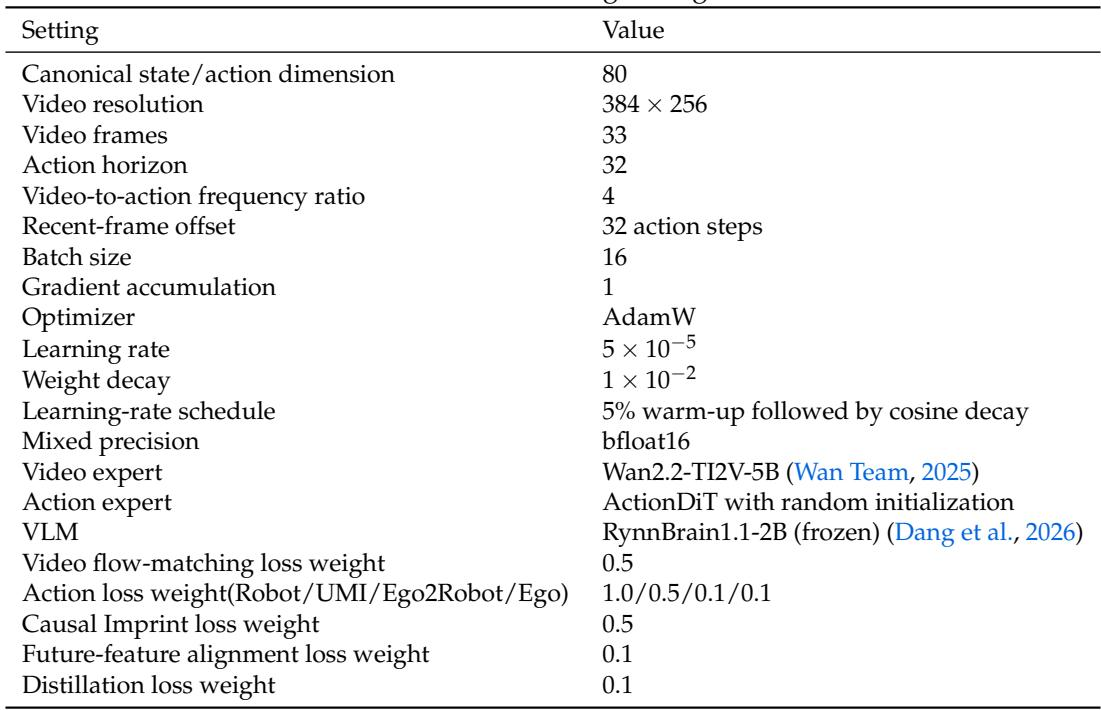
预训练使用以真实机器人演示为主的异构混合数据集,其中 ego-to-robot、UMI 采集和第一视角演示占比较小。所有来源都被标准化到规范的 80 维状态和动作空间,训练样本将 33 帧视频与 32 个动作步配对,视频与动作频率比为 4。在此配置下,原始第一视角视频带来的下游成功率提升有限,尽管这可能不反映表示质量或更大规模的收益。混合预训练数据以真实机器人演示为主,ego-to-robot、UMI 和第一视角来源的贡献较小。动作损失权重对机器人演示最高,对 UMI 数据较低,对 ego-to-robot 和第一视角演示更低。
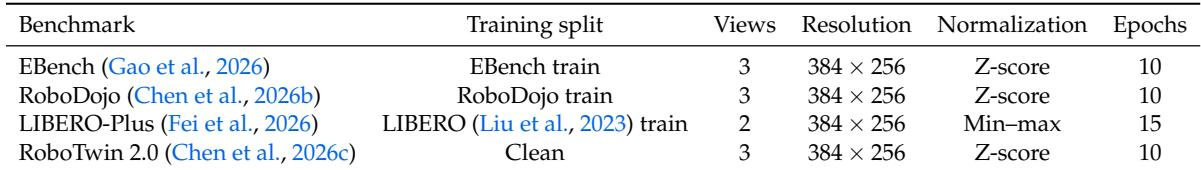
四个仿真后训练配置共享 384x256 打包多视角画布,以及一致的轨迹窗口和动作分块设置。大多数基准使用三个视图、z-score 归一化和 10 个 epoch。LIBERO-Plus 是例外,使用两个视图、min-max 归一化和 15 个 epoch,而 RoboTwin 2.0 在干净数据上训练,并在随机化数据上评估。所有四个基准共享 384x256 打包多视角分辨率。EBench、RoboDojo 和 RoboTwin 2.0 在三个视图、z-score 归一化和 10 个 epoch 上保持一致。LIBERO-Plus 的不同之处在于使用两个视图、min-max 归一化和 15 个 epoch,而 RoboTwin 2.0 在干净划分上训练并在随机化划分上评估。
评估协议将异构的机器人、第一视角和 UMI 数据标准化到规范的 80 维动作空间,对数据集合进行过滤,并通过 Ego2Robot 流水线将第一视角视频转换为机器人训练轨迹。过滤保留了大部分第一视角和 UMI 数据,同时移除了相当一部分机器人小时数,转换过程表明,只成功覆盖少数源第一视角视频仍能产生大型最终机器人数据集。预训练使用以真实机器人演示为主的混合数据,UMI 和 ego-to-robot 数据的动作损失权重较低,原始第一视角视频带来的下游成功率提升有限。仿真后训练基准共享打包多视角输入和动作分块设置,LIBERO-Plus 和 RoboTwin 2.0 的主要差异在于视图数量、归一化、epoch 以及从干净划分到随机化划分的评估协议。