Command Palette
Search for a command to run...
具有对数线性复杂度的块稀疏注意力
具有对数线性复杂度的块稀疏注意力
Bohao Tang Zhen Qin Yuqi Pan Zheng Li Pengfei Liu
摘要
将语言模型扩展到长上下文受限于自注意力的二次方计算代价。块稀疏注意力提供了一种高效的替代方案,但选择被保留的块仍然是一个瓶颈。传统的块选择方法需要对所有查询-块对进行打分,因此在序列长度上仍然是二次方的。为了解决这一问题,我们提出了 PISA,一种采用金字塔式 Top-K 选择策略的块稀疏注意力机制。其主要思想是逐步缩小不同层级上的候选范围,从而更高效地找到最相关的键。具体来说,我们构建了一个由粗到细的键层级结构,并从最粗层级开始进行选择。在每一层级,我们对一个有界的候选集合应用 LogSumExp 打分,为下一更细层级选择候选,直到到达最细层级。通过池化,我们构建了 O(log N) 个键层级,从而获得 O(N log N) 的总体复杂度,其中 N 表示序列长度。我们为训练和推理开发了硬件感知的 Triton 内核,将层级路由与 LogSumExp 打分融合,且无需显式构造查询-键打分矩阵。我们进一步在语言建模任务上评估了该方法。与基线相比,我们的方法在常识推理等基准上取得了相当的性能,同时在检索任务上表现更好。
一句话总结
上海交通大学、上海创新研究院和字节跳动 Seed 的研究者提出 PISA,一种块稀疏注意力机制,它在由粗到细的键层级上使用金字塔式 Top-K 选择,并采用有界的 LogSumExp 评分,以实现 O(N log N) 复杂度;同时开发了面向训练和推理的硬件感知 Triton 内核,在语言建模基准上取得与基线相当的性能,并在检索任务上获得更好的结果。
核心贡献
- 本文提出 PISA,一种块稀疏注意力机制,它在由粗到细的键层级上使用金字塔式 Top-K 选择,并在每个层级上使用 LogSumExp 评分,将块选择复杂度降低到 O(N log N)。
- 面向训练和推理的硬件感知 Triton 内核融合了层级路由和 LogSumExp 评分,保持有界候选集,并避免物化稠密的查询-键评分矩阵。
- 语言建模实验表明,PISA 在常识推理上达到与传统块稀疏注意力基线相当的性能,在检索任务上取得更好的结果,并且在最长 256K tokens 的序列上实现了比单层块选择更低的选择延迟。
引言
将语言模型扩展到更长的上下文十分重要,但全自注意力会随序列长度呈二次增长。块稀疏注意力通过将每个查询限制到选定的键块来降低成本;然而,传统 Top-K 块选择仍会扫描每个候选键块,这在长序列上造成 O(N2/C) 的选择瓶颈。为了解决该问题,作者提出 PISA,一种金字塔稀疏注意力方法,它构建多级池化键层级,并使用 LogSumExp 评分进行由粗到细的 Top-K 选择。这将块选择复杂度降低到 O(NlogN),并使用硬件感知 Triton 内核,在融合层级路由的同时避免稠密的查询-键评分矩阵。
方法
作者提出了 PISA,一种金字塔块稀疏注意力机制。它结合了三个主要组件:块稀疏注意力骨干、建立在由粗到细键金字塔上的分层 top-K 块选择器,以及专门的训练、预填充和解码内核。
块稀疏注意力
键和值被划分为连续块。对于查询 qt,块选择器只保留键块的一个子集,并在对应的原始键和值上计算注意力:
ot=∑j∈Ttexp(qt⊤kj/d)∑j∈Ttexp(qt⊤kj/d)vj.一个扁平块稀疏注意力方法对每个查询的 M=⌈N/C⌉ 个块摘要进行评分,这仍然在全序列评分上花费 O(N2d/C)。PISA 则将块选择组织为分层搜索。
金字塔键块层级
键层级由细到粗构建。第 0 级包含作为单元素块的原始键:
M0=N,Ki(0)=[ki].第一个合并步骤使用 g0=C 并产生叶子块。对所有更高层级,合并因子为 gℓ=g=2:
Mℓ+1=⌈gℓMℓ⌉, Ki(ℓ+1)=Concatr∈Chℓ(i)Kr(ℓ).每个块 Ki(ℓ) 都有一个摘要向量 kˉi(ℓ)。从 kˉi(0)=ki 开始,摘要通过均值池化递归计算:
kˉi(ℓ+1)=∣Chℓ(i)∣1r∈Chℓ(i)∑kˉr(ℓ).由于该层级在叶子层之后使用固定合并因子 g=2,它包含 L=O(logN) 层。查询在整个选择过程中保持逐 token 处理。
由粗到细的 Top-K 选择
选择从最粗层级 L 向下进行到叶子层级 1。对于每个查询,最粗层级的候选集初始化为:
At(L)={1}.在层级 ℓ,PISA 只对 At(ℓ) 中的候选块进行评分,选择 top K 块,并将保留的块扩展为其子块:
At(ℓ−1)=i∈It(ℓ)⋃Chℓ−1(i).由于对于 ℓ>1,每个保留块最多有 g 个子块,因此下一级候选集大小以 gK 为界。如果某一层最多包含 K 个有效候选,则所有候选无需评分即被保留。最终的叶子层选择集 Tt=Tt(1) 决定稀疏注意力层使用的原始键和值块。
在评分方面,PISA 使用 LogSumExp 块评分。候选块 Ki(ℓ) 对查询 qt 的评分为:
st,i(ℓ)=logr∈Chℓ−1(i)∑exp(dqt⊤kˉr(ℓ−1)),ℓ≥1.在叶子层,子项是原始键,因此叶子评分就是该块的精确原始键 LogSumExp 评分。在中间层,每个候选由其子摘要评分,每个评分最多归约 g 个 logits。这使得评分成本保持较低,同时使叶子层选择与注意力的 log-sum-exp 计算一致。
内核实现
对于训练和预填充,PISA 使用两阶段内核设计。
在第一阶段,内核处理从 L 到 2 的中间层级。它在查询位置和键/值头上并行化。同一 GQA 组内的查询头共享相同的选定键块。对于键/值头 h,内核为 H(h) 中的所有查询头计算 LSE 评分并求和:
uh,t,i(ℓ)=h′∈H(h)∑sh′,t,i(ℓ).然后它对求和后的评分应用 top-K 选择,并将保留的块扩展为其子块,以形成下一候选集。候选索引在整个循环中保持程序局部性。
第一阶段之后,每个查询最多有 gK 个候选叶子块。第二阶段将需要评分相同候选键块的查询分组为簇。每个簇被划分为最多 Qtile 个查询的瓦片,实现中 Qtile=4。每个内核程序一次加载形状为 d×C 的键瓦片,并在形状为 (QtileGQ)×d 的查询瓦片中复用,其中 GQ=∣H(h)∣。它计算
(QtileGQ)×d×d×C⟶(QtileGQ)×C,对每个查询头在键上应用 LSE,然后对 GQ 个查询头求和。最后一个内核为每个查询和键/值头独立应用 top-K 选择。
在解码期间,PISA 缓存均值金字塔,并只针对每个新 token 更新当前叶子均值以及受影响的祖先路径。块选择使用单个融合内核,从最粗层级向下运行到 ℓ=1,直接对原始键块进行评分。这避免了每个解码步骤启动多个内核的开销。
复杂度
由于金字塔层级有 O(logN) 层,且每个查询在每层最多评分 gK 个候选块,因此每个查询的选择成本为 O(logN)。因此,全序列训练或预填充成本为 O(NlogN),而解码平均每步成本为 O(logN)。
选择两阶段训练/预填充内核主要是为了输入/输出效率。通过将共享同一候选键块的查询分组,第二阶段在多个查询间复用每个已加载的键块。对于实现设置 GQ=16、Qtile=4 和 C=64,
GQ+QtileC=32<64=C,因此,与单阶段设计相比,两阶段设计减少了叶子层查询/键 IO。在解码期间,簇只包含一个查询,因此没有跨查询键复用。融合的单阶段内核复用中间选择期间已加载的查询向量,并避免单独的分组和最终选择启动。
实验
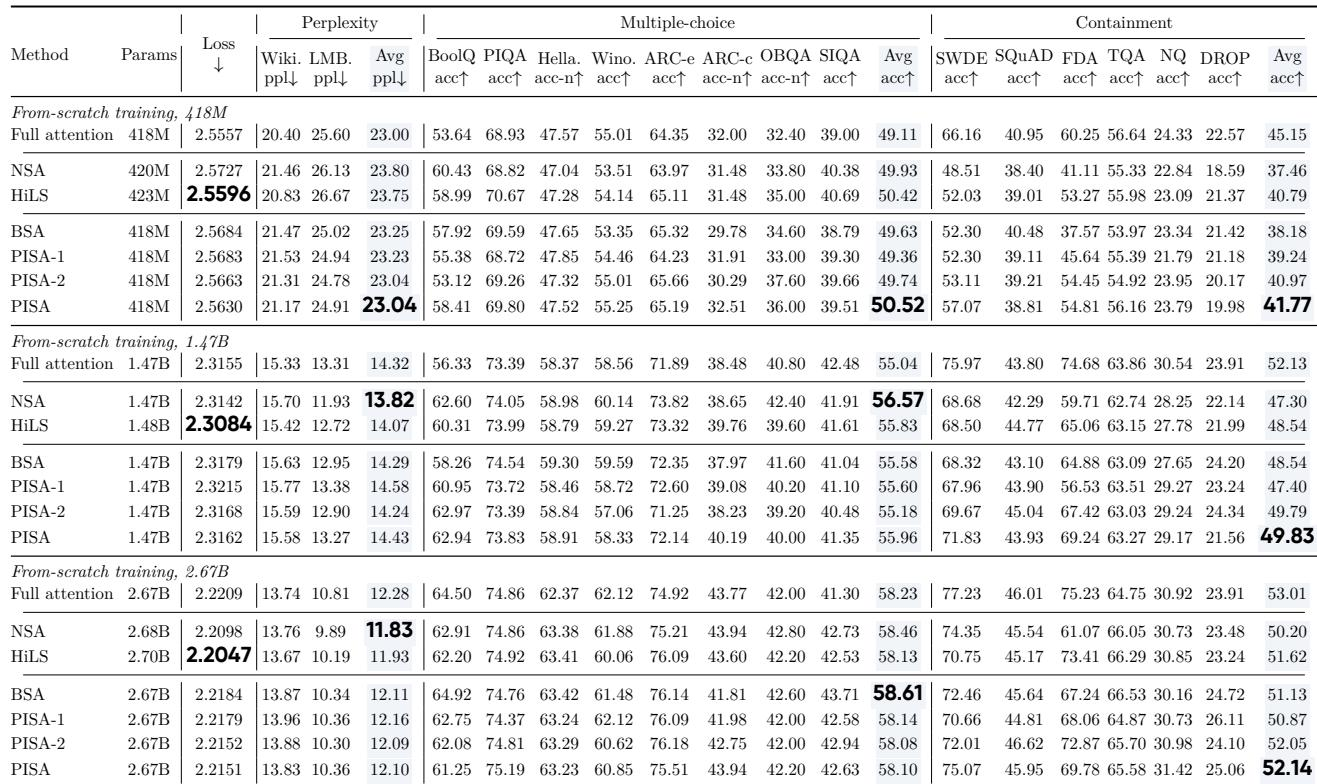
实验在匹配训练条件下比较了 PISA 与 Full Attention、BSA、NSA 和 HiLS,规模为 418M、1.47B 和 2.67B,先在 4K 序列长度上使用 100B tokens 训练,再在 16K 上使用 10B tokens 进行持续预训练。PISA 在语言建模和常识推理上与稀疏基线表现相当,在所有规模上的平均包含准确率在稀疏方法中最高,尽管 Full Attention 仍然更高,并在 RULER 上表现出较强的长上下文检索能力。消融实验表明,相对于 PISA-1、PISA-2 和 BSA,基于 LSE 的评分改善了 Top-K 块选择质量和下游性能,而块选择效率在非常长的上下文下相对 BSA 更具优势。
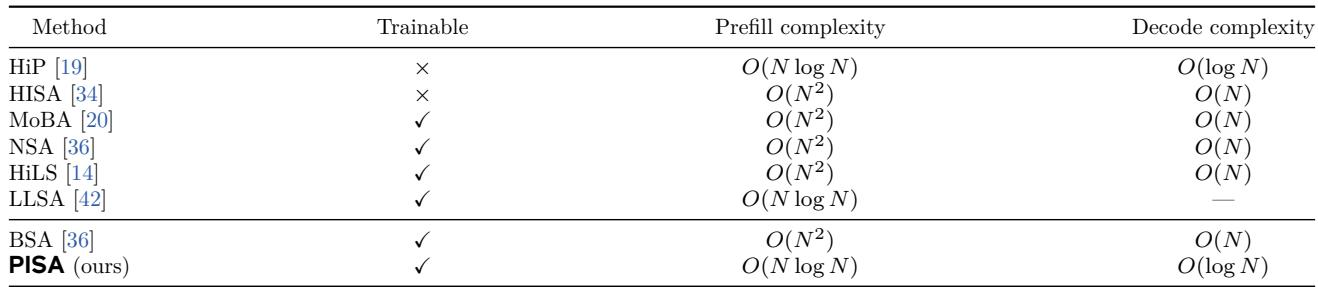
该表比较了稀疏注意力方法的训练设置和计算复杂度。HiP 作为一种免训练方法尤为突出,具有次二次预填充和对数级解码复杂度,而 HISA 和大多数可训练方法使用二次预填充和线性解码复杂度。LLSA 是可训练方法中的例外,具有次二次预填充,但其成本按每次扩散注意力传递报告,而不是按自回归预填充报告。在列出的免训练方法中,HiP 实现了比 HISA 更低的预填充和解码复杂度,具有次二次预填充和对数级解码。大多数可训练方法具有二次预填充和线性解码复杂度;LLSA 具有次二次预填充,但按扩散注意力传递报告,而不是按自回归预填充报告。
在 100B tokens 预训练后,PISA 在语言建模和常识推理上与 BSA、NSA 和 HiLS 表现相当。在稀疏方法中,PISA 在所有评估规模上的包含任务平均准确率最高,而全注意力保持更高的包含平均值。PISA 还表现出比 PISA-1、PISA-2 和 BSA 更低的训练损失和更高的平均包含准确率。PISA 在比较的稀疏方法中跨模型规模达到最佳包含平均值。全注意力在包含准确率上仍然领先,而 PISA 在语言建模和常识推理上与稀疏基线相当。PISA 在训练损失和平均包含准确率上优于 PISA-1、PISA-2 和 BSA。
在 16K 继续预训练后,全注意力在 2.67B 模型上具有最高的平均 RULER 大海捞针准确率。在稀疏方法中,PISA 和 PISA-2 整体领先且几乎持平,PISA-2 平均略领先,二者均高于 NSA 和 BSA。各方法的准确率随着上下文长度下降,尤其是在多键、多查询和多值任务上。全注意力取得了最高的平均准确率,而 PISA-2 和 PISA 是最强的稀疏方法且几乎持平。PISA 变体在若干短上下文多键和多查询设置上优于全注意力,但所有稀疏方法在 16K 时下降更剧烈,尤其是在多键和多值任务上。
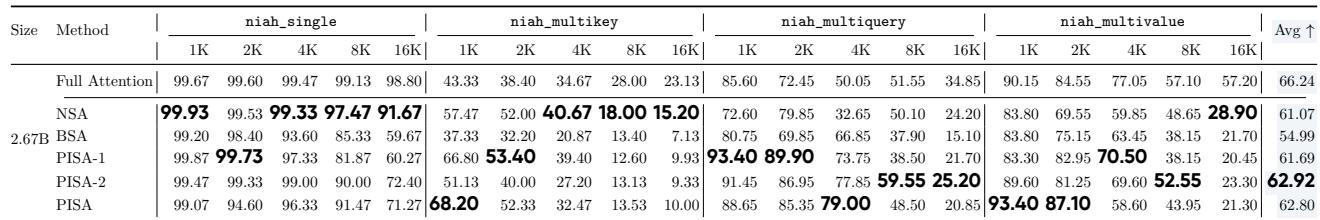
实验从效率、100B-token 预训练后的语言建模和常识推理,以及 16K 继续预训练后的长上下文检索方面比较了稀疏注意力方法。PISA 在语言建模和常识推理上与 BSA、NSA 和 HiLS 表现相当,并在稀疏方法中实现了最高的平均包含准确率,尽管全注意力整体上仍然更强。在长上下文 RULER 评估中,PISA 和 PISA-2 是最强的稀疏方法且几乎持平,并在一些短上下文场景中优于全注意力,但所有稀疏方法到 16K 时退化更严重。复杂度结果还表明,免训练的 HiP 具有次二次预填充和对数级解码,而大多数可训练方法使用二次预填充和线性解码。