Command Palette
Search for a command to run...
WanPE:面向现代文本到视频生成的电影级提示增强
WanPE:面向现代文本到视频生成的电影级提示增强
摘要
视频生成始于文本空间:先撰写电影化分镜脚本,再将其物化为像素。随着当代视频生成器扩展至 30 秒并忠实地遵循复杂条件,文本提示在很大程度上主导着制作过程,规划动作、相机轨迹、光照和声音如何在多镜头序列中展开。本文提出了 WanPE,一个在 1.05M 真实世界视频上训练、拥有 397B 参数的提示增强模型,旨在掌握导演级电影化规划能力。WanPE 通过基于视频的逆向构造生成镜头级电影化规划,并采用语义一致性 GRPO(SC-GRPO)在不同镜头之间以及时间维度上忠实保留用户需求。为评测这一能力,我们构建了 WanPEval,一个经人工标注的评测基准,覆盖 5 到 30 秒的时长与不同意图粒度,并提供约 11K 项盲评成对比较。在驱动 Wan3.0 的视频生成器时,WanPE-397B 在 5-15 秒场景中使人类偏好较原始用户提示提升 10.66-18.84 分,并在 30 秒场景中大幅提升 50.86 分。消融研究表明,逆向构造相比正向改写具有明显优势,而 SC-GRPO 能在不同模型规模下稳健地保持语义保真度。最终,WanPE 在 5-15 秒场景中领先所有被评估的商业方案,并在 30 秒场景中与 Seedance 2.5 保持竞争力。
一句话总结
来自南京大学、Wan 团队、阿里巴巴集团等机构的研究人员提出 WanPE,这是一个 397B 参数的提示词增强模型,在 105 万个真实世界视频上训练,通过基于视频的反向构建和语义一致性 GRPO 生成镜头级电影化规划。在 WanPEval 基准上,WanPE 相比原始提示词使 Wan3.0 偏好得分在 5 至 15 秒提升 10.66 至 18.84 分,在 30 秒提升 50.86 分。
核心贡献
- 论文提出 WanPE,一个 397B 参数的提示词增强模型,在 105 万个真实世界视频上训练,将提示词增强重新定义为可扩展的电影化规划,在像素渲染之前跨镜头和时间编排动作、摄影机调度、音频与叙事。
- 该方法通过基于视频的反向构建学习已实现的电影化结构,并应用语义一致性 GRPO 在镜头间保持用户需求;消融实验显示,反向构建优于前向改写,SC-GRPO 在不同模型规模上将语义一致性提升 18.6 至 23.3 分。
- 论文引入 WanPEval,一个人工标注基准,覆盖 5 至 30 秒生成,约含 1.1 万次盲式成对评估。在驱动 Wan3.0 视频生成器时,WanPE-397B 相比原始用户提示词在 5 至 15 秒将人类偏好提升 10.66 至 18.84 分,在 30 秒提升 50.86 分,并可迁移到下游视频生成器,在 5 至 15 秒领先所有已评估的商业系统,在 30 秒与 Seedance 2.5 保持竞争力。
引言
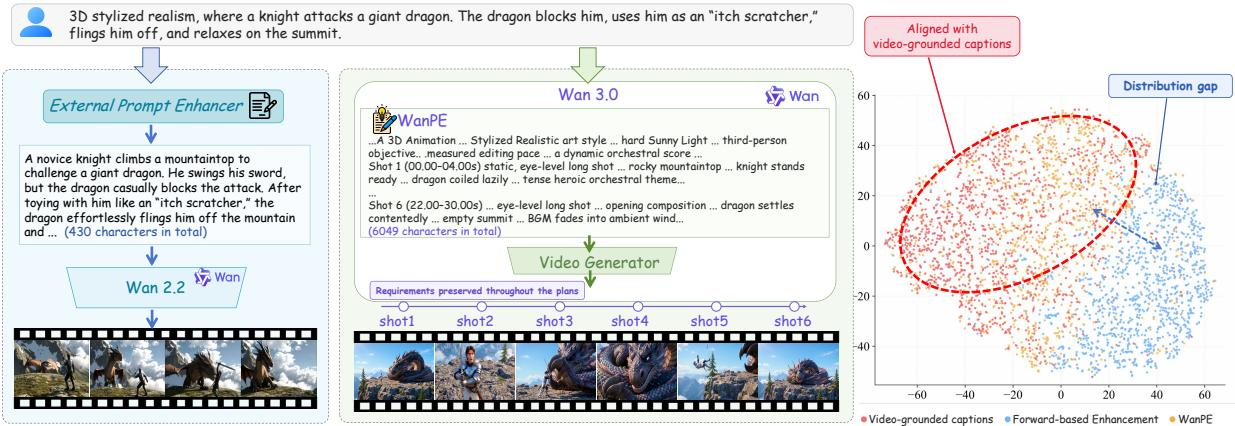
当前的文本到视频系统,如 Wan3.0 和 Seedance 2.5,已经能够生成最长达 30 秒的电影级视频,这使提示词增强从表面细节丰富转向覆盖动作、摄影机、灯光、对话、声音和镜头切换的完整制作规划。现有增强器大多依赖前向改写,将简短用户请求扩写成更丰富的描述,但这会造成训练与推理之间的不一致,并且常常无法在多镜头规划中一致地保留用户需求。作者提出 WanPE,一个电影化规划提示词增强器,在 105 万个真实世界视频上训练。WanPE 不使用前向改写,而是采用反向监督:从视频推导分层电影化条件并重建兼容的用户请求,然后应用 SC-GRPO,以九维奖励减少遗漏、改动、绑定错误和时间不一致。该方法在 WanPEval 上以 4B 到 397B 模型变体进行评估,WanPEval 是一个覆盖 5 到 30 秒生成任务的人工标注基准。
数据集
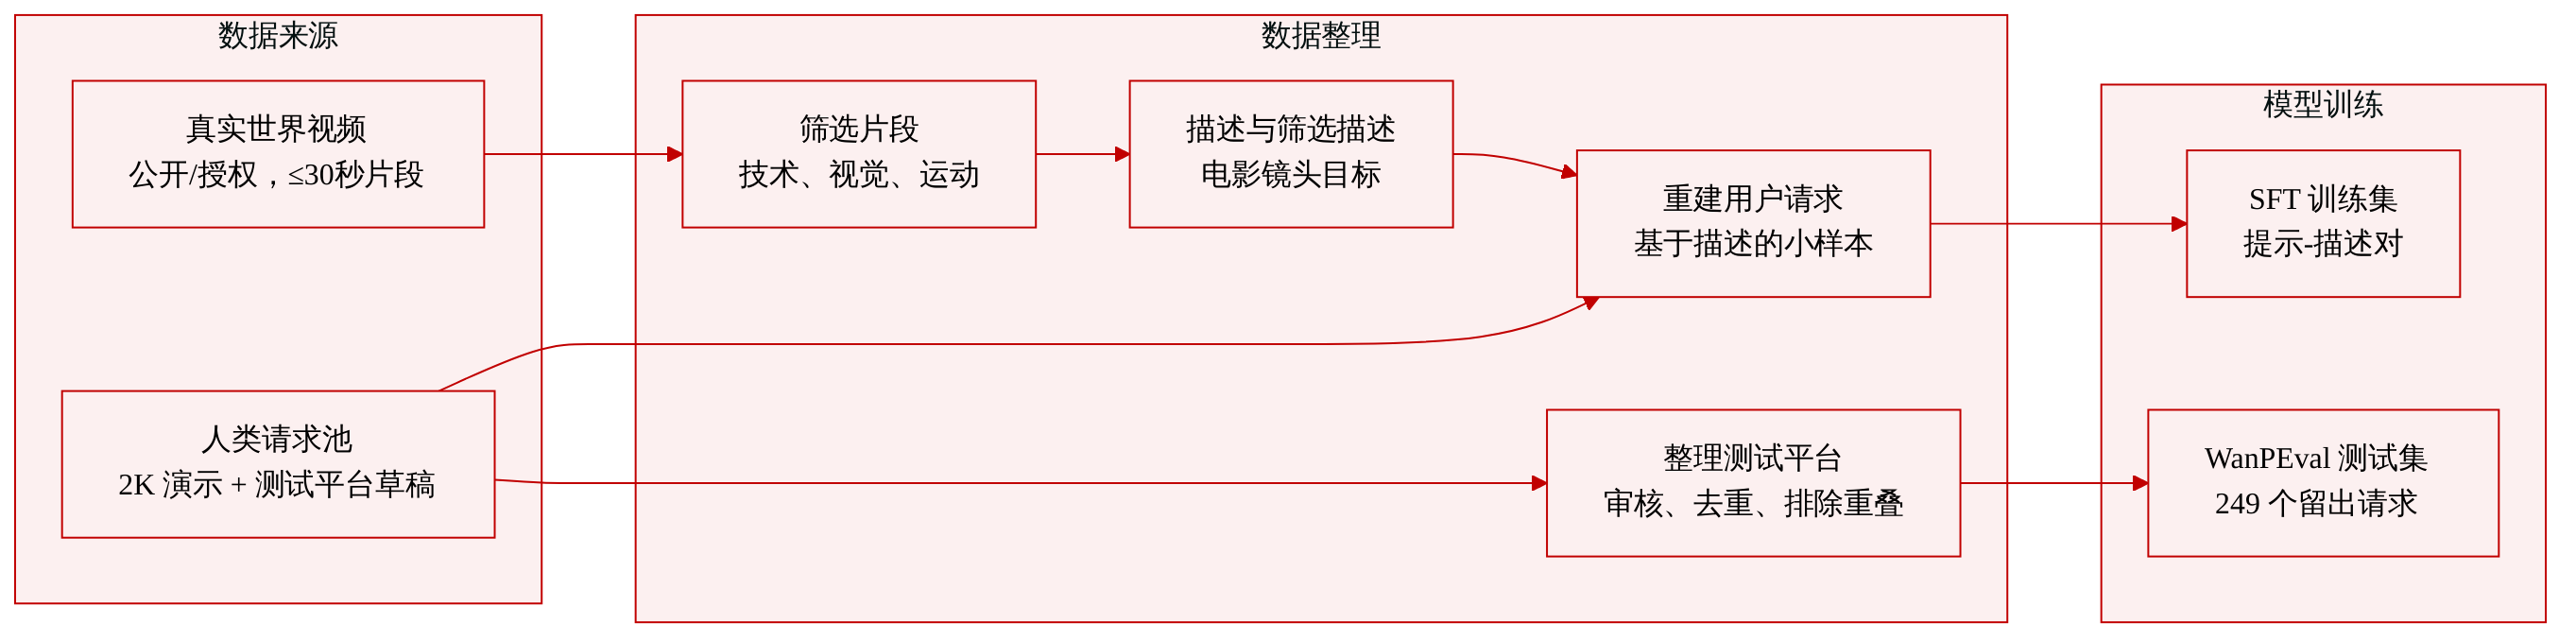
作者使用两个数据集组成部分:一个基于视频的有监督微调集,以及一个人工标注评估测试集。
基于视频的 SFT 数据集
- 来源与规模: 作者收集公开可用或获得许可的真实世界视频。长视频被切分为最长 30 秒的片段,并经过多个阶段的技术有效性、视觉质量和运动质量过滤。过滤后数据集包含约 105 万个片段,覆盖十个内容维度。
- 字幕与元数据构建: 一个多模态视频字幕模型按类别特定指令处理每个筛选后的片段。它生成一个电影化目标,包含视频级摘要和带时间戳的按时间排序的镜头级描述。镜头描述可包括构图、主体、动作、灯光、摄影机运动、转场、对话、音乐和音效。
- 字幕过滤: 字幕仅在通过结构完整性、时间戳有效性以及与源视频一致性检查后保留。
- 用户请求重建: 对每个基于视频的字幕目标,作者通过 GPT-5.4 的少样本提示重建自然用户请求。示例从覆盖十个内容类别的 2K 条人工编写请求池中抽样,每个样本使用五个示例。重建请求被约束为仅包含字幕支持的需求,保持语义兼容性。
- 用途: 得到的提示词-字幕对构成 SFT 数据集。提示词增强器在给定重建用户请求的条件下微调,以最大化每个电影化目标的似然。摘录未报告该 SFT 阶段的训练/开发/测试划分或混合比例。
WanPEval 测试集
- 来源与规模: 人工标注者撰写跨多种主题的实用文本到视频请求,按 5 至 30 秒时长以及从高层意图到详细镜头级指令的粒度分层。筛选后的测试集包含 249 个请求。
- 筛选规则: 请求经评审,检查语义清晰度、内部一致性和时间可行性。删除重复请求,排除与 SFT 或 SC-GRPO 训练数据重叠的请求。
- 用途: WanPEval 是用于文本级语义评估和专家视频评估的留存测试集。每个方法为每个请求生成一个视频,作者应用语义一致性奖励以及匿名成对人类偏好评估。
方法
WanPE 是提示词增强策略 πθ,置于文本到视频生成器 Gϕ 之前。作者将 WanPE 的作用形式化如下。给定自然语言用户请求 x∼pu,增强器生成文本电影化条件
y∼πθ(⋅∣x),视频生成器使用 y 合成视频
v^∼Gϕ(⋅∣y).有效条件 y 必须保持 x 中的所有语义和指令约束。有效条件集合定义为
Ysem(x)={y∣c(y)=1, ∀c∈C(x)},其中 C(x) 是用户指定约束集合,c(y)=1 表示 y 在不遗漏、不改变、不矛盾的情况下满足约束 c。
作者进一步要求增强器输出与视频生成器的条件分布对齐。由于 Gϕ 是在真实世界视频及其基于视频的字幕配对数据上训练的,目标分布是受限于语义有效条件的基于视频的字幕分布 pvg:
p∗(y∣x)=Z(x)pvg(y)I[y∈Ysem(x)].训练目标是在用户提示词上最小化与该目标分布的 KL 散度:
θ∗=argθminEx∼pu[DKL(p∗(⋅∣x)∥πθ(⋅∣x))].该形式化抓住了 WanPE 方法的两个核心要求:用户需求的语义保持,以及与基于视频的字幕的分布对齐。为利用现代视频生成器更长的条件容量,WanPE 将文本条件组织为分层电影化规划,包含视频级摘要和按时间排序的镜头描述。
基于视频的有监督微调
第一阶段是在以相反顺序构造的提示词-条件对上做有监督微调。传统做法会从用户请求 x 出发,将其丰富为电影化描述 y。但作者认为,这会使目标分布遵循改写过程,而不是基于视频的字幕分布 pvg。
因此,WanPE 颠倒了对构造过程:先通过为真实世界视频生成字幕获得 y,再从 y 推导兼容的用户请求 x。
在真实世界视频收集方面,长视频被切分为最长 30 秒的片段,并按技术有效性、视觉质量和运动质量过滤。对每个筛选后的视频片段 vi,多模态视频字幕模型 fcap 生成电影化目标
yi=fcap(vi;si),其中 si 是类别特定字幕指令。生成的目标 yi 分层描述视频,包含视频级摘要和按时间排序的带时间戳镜头描述。每个镜头指定构图、主体、动作、灯光、摄影机运动、转场、对话、音乐、音效及其随时间的变化。字幕仅在通过结构完整性、时间戳有效性和源视频一致性检查后保留。
为了从基于视频的目标 yi 重建自然用户请求 xi,WanPE 使用带少样本提示的 LLM。示例从跨内容类别的人工编写请求池中抽样。形式化为
xi=fLM(yi;Ei),其中 Ei 包含抽样示例。重建提示要求 xi 仅包含 yi 支持的需求,确保 yi∈Ysem(xi),同时示例引导语言风格和具体程度趋向自然用户请求。
得到的 SFT 数据集由配对 {(xi,yi)}i=1N 组成。WanPE 通过最小化每个基于视频的电影化条件在给定其重建用户请求下的负对数似然来微调提示词增强器:
LSFT(θ)=−N1i=1∑Nlogπθ(yi∣xi).该阶段教会增强器将自然用户请求转换为基于视频的电影化规划,捕捉各元素跨镜头和时间的联合组织。
语义一致性 GRPO
第二阶段通过语义一致性 GRPO,即 SC-GRPO,增强长程语义保真度。该阶段应用组相对策略优化,并使用语义一致性奖励,惩罚跨镜头的遗漏、改动、错误的主体-动作-对话绑定以及时间不一致。
在训练数据构造方面,人工标注者为最长 30 秒的视频撰写文本到视频提示词。视频使用以 SFT 增强器输出为条件的 Wan3.0 生成器生成。标注者识别生成视频未能充分实现所请求内容的提示词。这些困难案例与多样化的人工编写提示词合并,构成 SC-GRPO 训练集。
语义奖励使用 Qwen3.7-Max 作为纯文本评估器。给定用户请求 x 和生成条件 y,它评估 y 是否在九个维度上保持 C(x) 中的约束:风格、主体、动作、对话、声音、摄影机、灯光、空间关系和场景。评估器惩罚遗漏、弱化、改变或矛盾的需求,错误的主体-属性和说话人-对话绑定,动作和镜头顺序错误,以及跨镜头冲突。语义等价的改写和兼容的细化可接受。
在策略优化方面,WanPE 对每个提示词从当前策略采样 G 个条件,并将其奖励标准化为组相对优势 A^g。优化目标为
JSC−GRPO(θ)=EG1g=1∑GTg1t=1∑Tg(min{ρg,tA^g,clip(ρg,t,1−ϵ,1+ϵ)A^g}−βKg,t),其中 Tg 是输出长度,ρg,t 是当前策略与旧策略之间的概率比,Kg,t 是相对 SFT 参考的 KL 惩罚。该目标鼓励增强器生成语义一致性更高的条件,同时保持在 SFT 中学到的参考分布附近。
实验
评估使用 WanPEval,这是一个人工标注基准,覆盖不同时长和请求粒度,并采用专家成对视频偏好判断和 Bradley-Terry 评分。总体比较显示,相比无提示词增强和领先系统,WanPE 改善了下游视频质量,并且随着生成长度增加收益更大。消融实验表明,反向构建的基于视频的监督优于前向改写和前向目标 SFT,并且 WanPE 的电影化规划在格式适配后可迁移到其他生成器。SC-GRPO 进一步提升了各模型规模下的语义一致性和下游偏好。
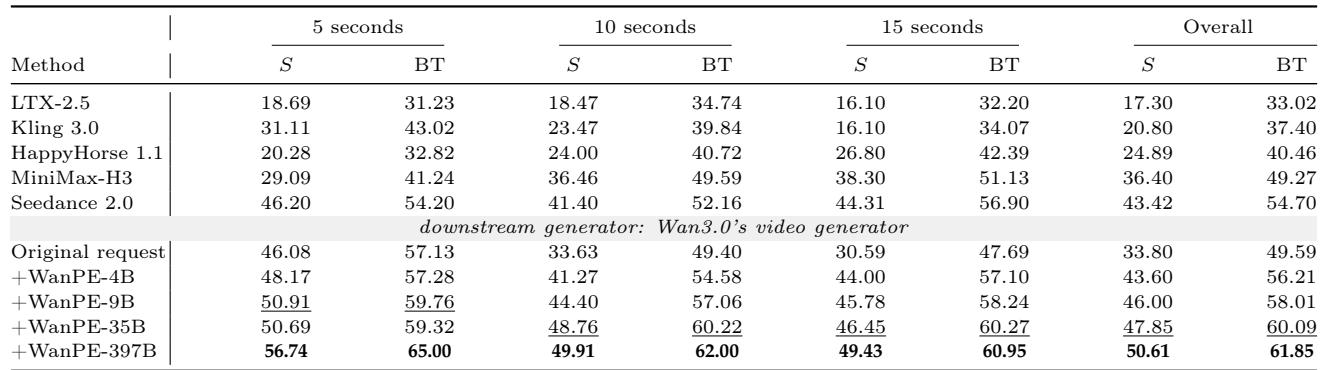
WanPE-397B 在 5、10 和 15 秒时长上,在专家偏好和 Bradley-Terry 分数上都排名第一。Seedance 2.0 是对比中最强的非 WanPE 系统,而 LTX-2.5 和 Kling 3.0 总体得分明显较低。WanPE-397B 在 5 至 15 秒子集的每个时长上,在两个指标上都领先所有报告的系统。Seedance 2.0 是所列基线中最强竞争者,总体上明显领先 MiniMax-H3。在对比系统中,LTX-2.5 的总体专家偏好和 Bradley-Terry 分数最低。
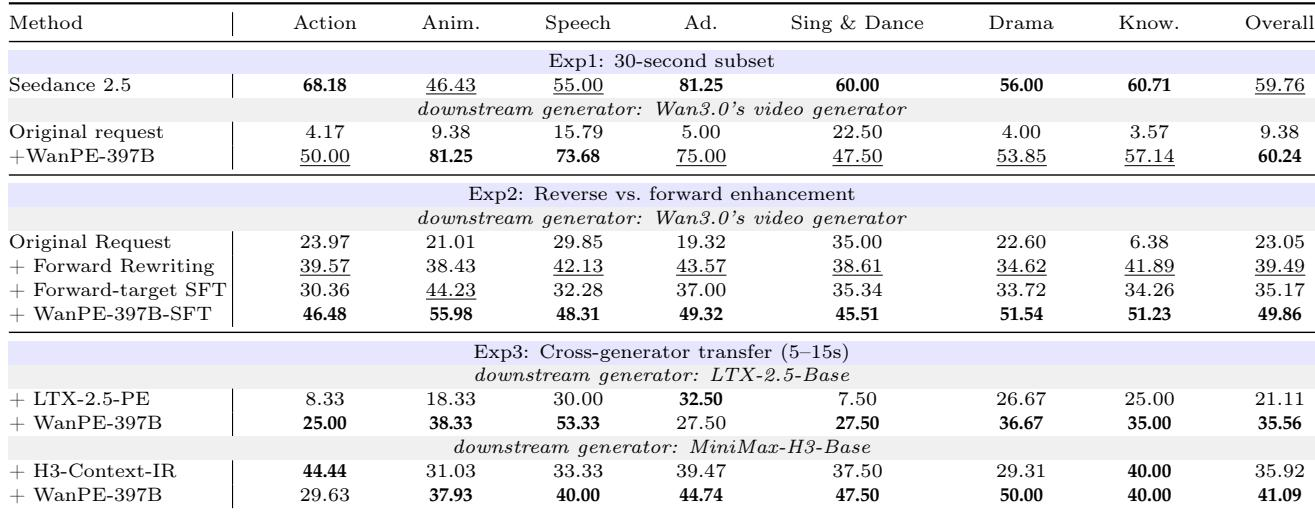
在 30 秒子集上,WanPE-397B 与 Seedance 2.5 具有竞争力,相比未增强请求有大幅优势,动画和语音得分尤其强。反向构建的基于视频的监督明显优于前向改写和前向目标 SFT,在所有内容类别中领先。格式适配后的 WanPE-397B 在迁移到 LTX-2.5 和 MiniMax-H3 时也超过原生增强器。在 30 秒子集上,WanPE-397B 总体上略胜 Seedance 2.5,并相对原始请求基线有显著提升。WanPE-397B 在动画和语音上领先 Seedance 2.5,而 Seedance 2.5 在动作和歌舞上仍然更强。基于视频的反向构建监督大幅优于前向改写,并在全部七个内容类别中排名第一。格式适配后的 WanPE-397B 在 LTX-2.5 和 MiniMax-H3 上均超过原生提示词增强器,且在 LTX-2.5 上提升更大。
SC-GRPO 在每个评估时长上均比 SFT 基线提升语义一致性,其中 5 秒提升最大,并显著提高完美输出率,同时降低失败率。这些提升迁移到下游视频生成,专家偏好从 42.70 提升到 49.69,且全部七个内容类别均有提升。最强的下游收益出现在知识、歌舞和语音。SC-GRPO 在评估时长上比 SFT 基线增加约 15 至 25 分语义一致性,其中 5 秒增益最大。相对 SFT 基线,SC-GRPO 将完美输出提高约 32 分,将失败降低约 29 分。SC-GRPO 在所有内容类别上改善下游专家偏好,知识、歌舞和语音的提升更大。
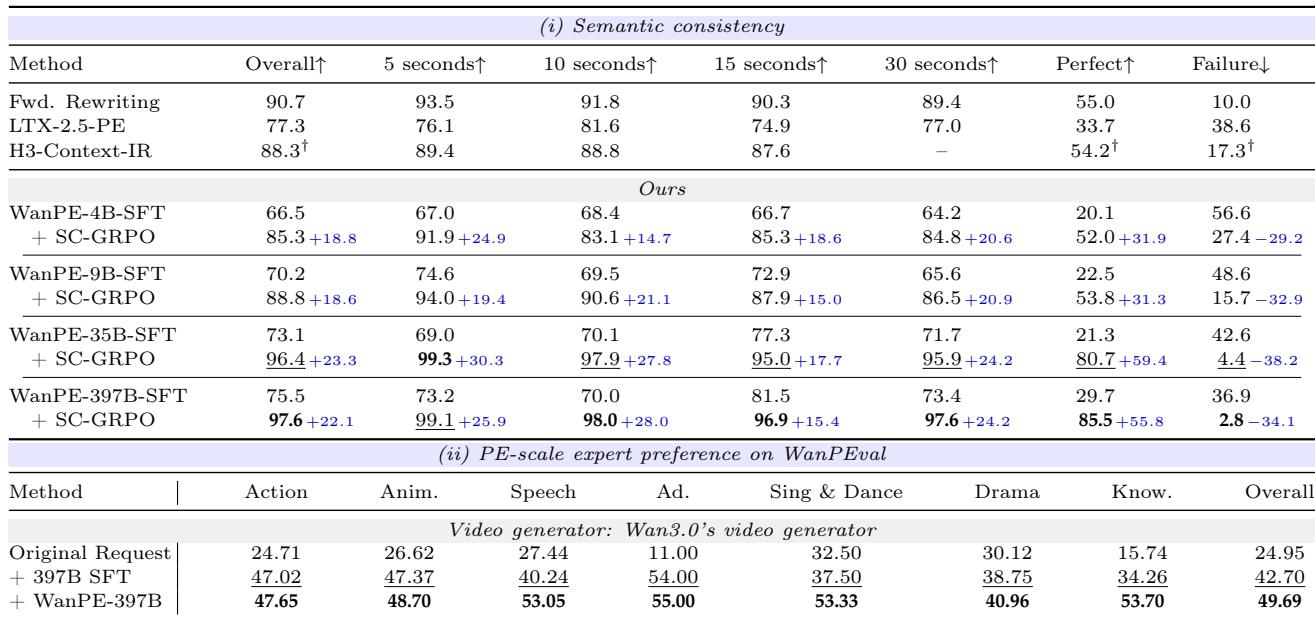
实验将 WanPE-397B 与基线提示词增强器和视频生成系统在 5、10、15 和 30 秒时长上进行比较,并将 SC-GRPO 与 SFT 基线评估。WanPE-397B 在 5 至 15 秒输出上领先所有对比系统,在 30 秒输出上与 Seedance 2.5 具有竞争力,基于视频的反向构建监督优于前向改写,并能很好地迁移到 LTX-2.5 和 MiniMax-H3。SC-GRPO 在所有时长上相比 SFT 提升了语义一致性和下游视频生成质量,知识、歌舞和语音的提升最大。