Command Palette
Search for a command to run...
你的 Transformer 能同时持有两种想法:大语言模型中线性叠加的证据
你的 Transformer 能同时持有两种想法:大语言模型中线性叠加的证据
Pavel Tikhonov Anton Korznikov Matvey Mikhalchuk Nikita Dragunov Temurbek Rahmatullaev Polina Druzhinina Anton Razzhigaev Ivan Oseledets Elena Tutubalina
摘要
尽管大语言模型(LLM)依赖高度非线性的组件,本文证明它们表现出基本的线性性质:当来自不同文本流的输入被线性组合时,模型输出的是各个下一 token 分布的叠加。我们将此称为叠加线性假设。我们提供证据表明,叠加是 Transformer 架构的内在属性,而非训练产生的涌现结果;事实上,我们观察到,随着预训练的进行,这种叠加往往会减弱。然而,我们证明,通过轻量级微调,线性性质可以在很大程度上得到恢复,从而显著减小预测的下一 token 分布与各个独立下一 token 分布平均值之间的差异。最后,我们引入一种引导式解码过程,将叠加输出解耦,从而能够在单次前向传播中同时生成两条连贯的续写。
一句话总结
作者提供证据表明 LLM 表现出叠加线性假设(Superposition Linearity Hypothesis),即线性组合输入会产生叠加的 next-token 分布;同时表明这种线性是 Transformer 架构的内在属性,但会随预训练而减弱,并且可以通过轻量微调得到大幅恢复;此外引入了一种引导式解码流程,可以从单次前向传播中解耦叠加输出,从而生成两个连贯续写。
核心贡献
- 论文证明仅解码器 Transformer 表现出叠加线性:将两个文本流的嵌入平均后,得到的 next-token 分布接近各独立 next-token 分布的平均值,并且在每个独立流所偏好的 token 上保留了较高的概率质量。
- 这项工作表明,叠加线性是一种内在架构属性,在预训练期间会退化;使用不到原始预训练数据 0.025% 的数据进行轻量微调可以大幅恢复该属性,从而降低混合 next-token 分布与平均 next-token 分布之间的差异。
- 引入了一种引导式解码流程来解耦叠加输出,能够从单次前向传播中恢复两个连贯续写,理论上可将推理吞吐量提高 2 倍,并将每个活动流的 KV-cache 占用减半。
引言
作者研究了仅解码器 Transformer 语言模型,这些模型由高度非线性的注意力和 MLP 组件构成,通常被视为单一连贯语义流。因此,处理多个独立输入需要分别进行前向传播、串行处理或进行架构修改,以避免破坏性干扰。尽管近期工作表明残差流中相邻层之间存在近似仿射结构,但这种线性是否延伸到端到端的输入输出行为仍不清楚。作者形式化了叠加线性假设,并表明当来自两个文档的 token 嵌入被平均并输入预训练 LLM 时,模型会为两个流保留大量概率质量,两个真实下一个 token 经常出现在 top 10 中。他们发现该行为在初始化时最强,并随着预训练而减弱,这表明它是一种架构属性而非学习到的能力;他们还表明,使用不到原始预训练数据 0.025% 的数据进行轻量微调可以大幅恢复该能力。其主要贡献包括一种解码流程,该流程可以解耦混合隐藏状态,从而从单次前向传播中恢复两个不同的续写。
方法
作者利用有针对性的优化策略来增强预训练 Transformer 模型的内在线性叠加能力。虽然标准预训练不会明确激励这种行为,但引入轻量微调阶段来调整模型权重,以明确支持叠加输入的并行处理。
为了实现这一目标,作者采用了一种自蒸馏框架,旨在最小化模型在混合输入上的输出与其独立输出混合之间的差异。该框架使用预训练权重初始化学生模型,并利用同一架构的冻结副本作为教师模型。对于给定的一对不同文本序列,目标概率分布定义为教师模型独立预测的算术平均:
Ptarget=21(Mteacher(x(A))+Mteacher(x(B)))学生模型处理来自两个序列的输入嵌入的逐元素平均值,公式为 z=21(E(x(A))+E(x(B)))。优化目标是最小化学生输出与目标混合之间的 Kullback-Leibler 散度:
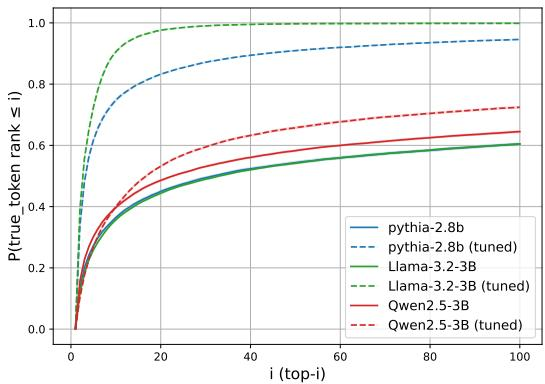
L=DKL(Ptarget∥Mstudent(z))该微调流程大幅降低了预测分布与目标分布之间的差异。这种干预成功逆转了基础模型中观察到的干扰,在输出层高保真地保留了两个真实流。值得注意的是,优化后真实下一个 token 出现在 top ranks 中的概率显著上升。
如下图所示,经过轻量微调阶段后,不同模型架构的累积排名分布表现出显著改善。
该图说明,单流预测 token 保留在混合分布 top ranks 中的概率显著增加。此外,优化有效恢复了对复杂语义内容的并行处理,在基础模型之前失效的困难内容 token 上重新获得了信号。
除了拟合混合分布之外,作者还解决了从单次混合前向传播中分别解码两个流的挑战。从混合分布直接采样受到几何平均效应的阻碍,即最终概率与独立分布的几何平均成比例:
Ptarget′(t)∝PA(t)PB(t)这带来了一种内在解码挑战,因为任何在一个流中概率很高但在另一个流中概率很低的 token 都会受到严重惩罚。为了将混合隐藏状态解耦回其组成流,作者提出了一种 Joint Contrastive Decoding 机制。该方法利用一个小型辅助模型在过程中提供逐流引导。解耦后的 logits 通过使用辅助模型的独立预测调整大模型的混合 logits 来计算:
ℓ~(A)=ℓlarge(z)+αℓsmall(A)−βℓsmall(B)对第二个流应用对称形式。标量系数初始化为 1,并与主干网络在对称的逐流交叉熵损失上联合训练,从而有效缓解几何平均阻碍,实现实用的并行推理。
实验
实验评估了标准 Transformer 是否能在不做架构修改的情况下,通过平均两个流的嵌入来处理叠加输入。排名和分布分析表明,预训练模型保留 token 级和分布信号的水平远高于随机水平,这种线性在训练早期最强,且深层仍接近线性。注意力修补表明,结构性注意力形状和频率先验有助于可预测位置,但在困难位置上 embedding mixing 保留了更多语义内容;自蒸馏微调进一步恢复了这种并行处理,但以牺牲一定单流质量为代价。最后,从混合前向传播中解码两个流受到几何平均干扰效应的限制,但 Joint Contrastive Decoding 提供了概念验证性的恢复。
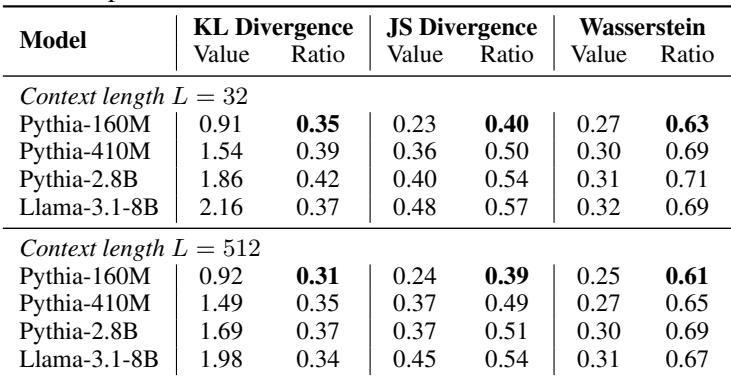
在上下文长度为 32 时,所有评估模型对目标算术平均混合的近似都优于随机基线,KL、JS 和 Wasserstein 指标的归一化散度比均低于 1。最小模型在所有指标上表现出最强的相对近似,而最大模型具有最高的绝对散度。KL 比始终最低,Wasserstein 比始终最接近 1。最小的 Pythia 模型取得了最佳的 KL、JS 和 Wasserstein 比,表明其与目标混合的相对匹配最接近。各模型的 Wasserstein 比高于 KL 和 JS 比,说明在嵌入感知指标上相对于随机基线的改进较弱。
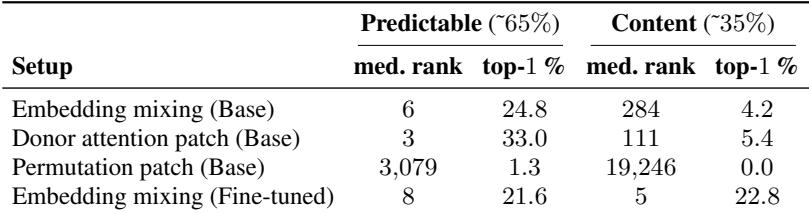
可预测位置约占 token 的三分之二,当 embedding mixing 或 donor patching 下保持注意力形状时,原始 top-1 token 仍保持在接近顶部的位置。内容位置则脆弱得多,在那些基础模型扰动下排名大幅上升;permutation patching 会破坏注意力结构,使两类 token 的 top-1 恢复都崩溃。微调在困难内容位置上恢复出了强得多的精确一致性和低中位排名。在基础 embedding mixing 和 donor patching 下,可预测位置保持较低中位排名和中等精确一致性,而内容位置显著退化。permutation patching 使可预测位置和内容位置的 top-1 恢复都崩溃,说明保持注意力形状至关重要。微调大幅改善内容位置恢复,将中位排名从数百降至个位数,并将精确一致性从个位数提高到五分之一以上。
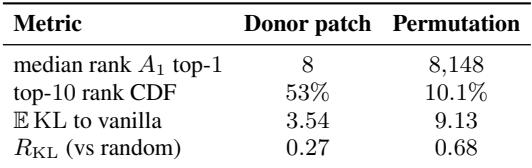
在单流扰动实验中,donor patch 保持 top-rank 目标位置的频率远高于置换注意力,top-10 召回率从多数降至约十分之一,top-1 中位排名从个位数恶化到数千。置换还会增加与原始输出之间的基于 KL 的散度,说明注意力结构的重要性超出了单纯的频率先验。置换注意力使 top-10 目标召回率下降到约十分之一,并将 top-1 中位排名从个位数推到数千。置换条件下的基于 KL 的散度大于 donor patch 条件,表明与原始行为的偏离更大。
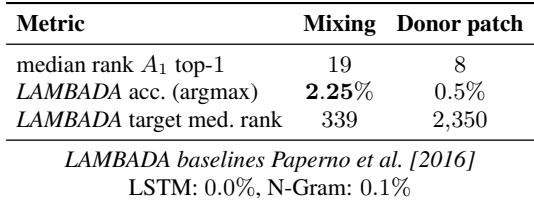
embedding mixing 在困难内容预测上比 donor patching 保留了更多信号,具有更高的 LAMBADA 准确率和更低得多的 LAMBADA 目标中位排名。donor patching 取得了更好的 A1 top-1 中位排名,但目标 token 恢复弱得多。先前的 LSTM 和 N-gram 基线接近零,使两种方法都处于困难低准确率区间。embedding mixing 实现了远高于 donor patching 的 LAMBADA 准确率。embedding mixing 取得了好得多的 LAMBADA 目标中位排名,表明对困难目标内容的恢复更强。donor patching 的 A1 top-1 中位排名优于 embedding mixing。LSTM 和 N-gram 基线接近零,因此即使使用 embedding mixing,任务仍然困难。
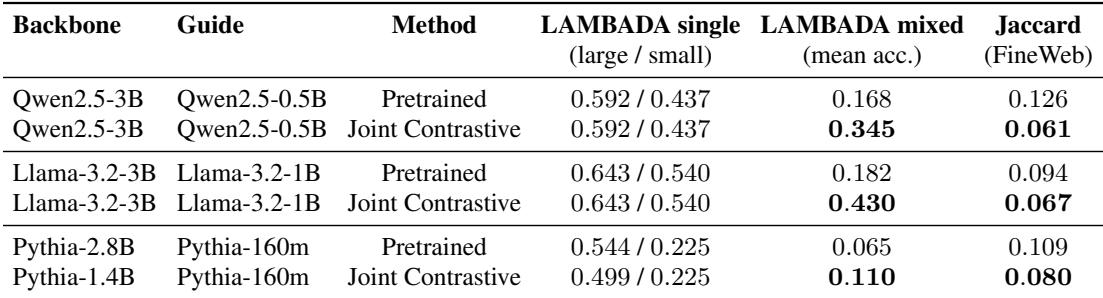
与原始预训练混合相比,Joint Contrastive Decoding 在所示 Qwen、Llama 和 Pythia 条目上提高了叠加前向传播的平均 LAMBADA 准确率,同时降低了 FineWeb 生成上的 Jaccard token 重叠,表明流分离更好。混合流准确率在每个报告配置中仍低于小模型的单流基线。这些结果支持该方法作为概念验证:叠加信号可利用但尚未被完全解码。Joint Contrastive Decoding 在报告模型配对上将 LAMBADA 混合平均准确率提高到高于预训练混合,其中 Llama-3.2-3B 在 Llama-3.2-1B 引导下增益最大。在所示配置下,FineWeb 生成上的 Jaccard token 重叠在 Joint Contrastive Decoding 下降低,表明两个流的分离更清晰。即使使用 Joint Contrastive Decoding,混合流准确率仍落后于小模型的单流基线,留下与几何平均阻碍一致的残差差距。
实验评估了模型对目标算术平均混合的近似程度,发现所有评估模型都优于随机基线,且较小模型表现出最强的相对拟合。注意力扰动分析表明,保持注意力形状至关重要:可预测位置在 embedding mixing 或 donor patching 下相对稳定,而内容位置急剧退化,permutation patching 会使恢复崩溃;不过微调大幅恢复了内容位置表现。embedding mixing 在困难内容预测上比 donor patching 保留了更多信号,Joint Contrastive Decoding 相比原始预训练混合提高了混合流准确率和流分离度,但仍低于单流性能并存在差距。