Command Palette
Search for a command to run...
Rufus-Air:一种开放的 LLM 后训练配方
Rufus-Air:一种开放的 LLM 后训练配方
摘要
Rufus-Air 是一个基于 GLM-4.5-Air-Base(106B-A12B)的开放且可复现的后训练配方,以串行流水线方式组织:SFT → 推理 RL → 编码 RL → 指令跟随 RL → 通用智能体 → 编码智能体 → 搜索智能体 → RLHF。我们记录了复现该配方所需的数据、奖励设计、基础设施、阶段顺序和分阶段结果。各阶段从基础能力向高级能力推进,并从硬性、可验证的奖励逐步过渡到更依赖评判器的软性信号。训练基于开源组件和公开数据构建,其中大部分数据按发布原样使用,没有新的人工标注,也没有内部蒸馏教师模型。我们的主要发现如下:(i) 多样且高质量的 SFT 建立了较强的能力下限;(ii) 难度过滤使 RL 提示保持在富有成效的学习区间内;(iii) 奖励可靠性为阶段排序提供了一个实用原则;(iv) 基础设施和工程选择属于该配方的一部分,而不仅仅是实现细节。Rufus-Air 优于官方 GLM-4.5-Air 后训练版本,并与同等规模的开源模型具有竞争力。
一句话总结
亚马逊研究人员推出了 Rufus-Air,一种面向 GLM-4.5-Air-Base 的开放且可复现的后训练方案,该方案按照 SFT、推理 RL、编码 RL、指令遵循 RL、通用 Agent、编码 Agent、搜索 Agent 和 RLHF 的顺序串联各阶段,使用公开数据且不新增标注;它在超越官方 GLM-4.5-Air 发布版本的同时,与同规模开放模型保持竞争力。
核心贡献
- Rufus-Air 是在 GLM-4.5-Air-Base(106B-A12B)上的开放且可复现后训练方案,组织为八阶段串行流水线:SFT、推理 RL、编码 RL、指令遵循 RL、通用 Agent、编码 Agent、搜索 Agent 和 RLHF。它基于开源组件和公开数据构建,其中大部分按原始发布状态使用,没有新增人工标注,也没有内部蒸馏教师。
- 该方案围绕四项原则组织:多样且高质量的 SFT 建立较强能力下限;难度过滤让 RL 提示保持在有产出的学习区间;阶段顺序按奖励可靠性排列,从硬可验证奖励过渡到更依赖评判的软信号。token-in/token-out rollout、一致的聊天模板、可靠的沙箱,以及带 Rollout Routing Replay 的大批次等基础设施选择,被视为方案的一部分,而非实现细节。
- Rufus-Air 在除 Arena-Hard v2 Creative Writing 之外的所有报告基准上均领先官方 GLM-4.5-Air 发布版本,并与包括 INTELLECT-3 和 Nemotron-3-Super 在内的同规模开放模型保持竞争力。
引言
开放权重基座模型让后训练研究更容易开展,但实际训练方案的报告通常很简略,往往更像系统卡而非可复现流程。数据过滤、阶段顺序和基础设施等缺失细节,使其他团队难以复现或在已发表结果上继续构建。作者通过提出 Rufus-Air 来填补这一空白,这是一个完全文档化的后训练方案,基于 GLM-4.5-Air-Base,使用开源组件,并具有在顶尖实验室之外也可行的算力规模。其主要贡献是可复用的方案本身,围绕若干关键决策组织:将监督微调视为能力构建阶段、按难度过滤提示、按奖励可靠性排列 RL 阶段顺序,以及将基础设施细节作为方法的一部分。
数据集
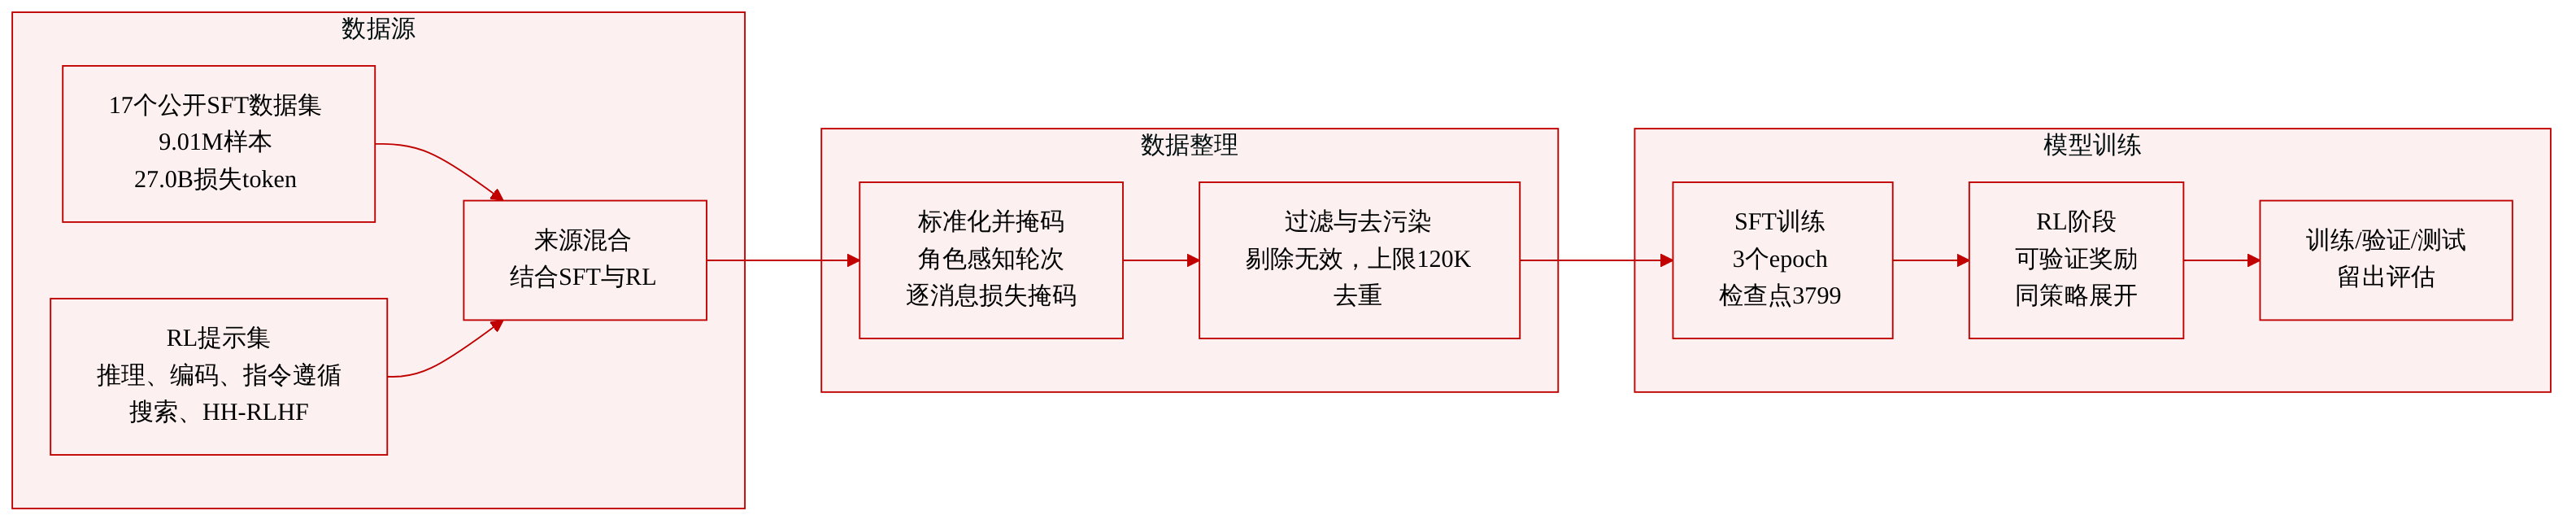
数据集描述
监督微调
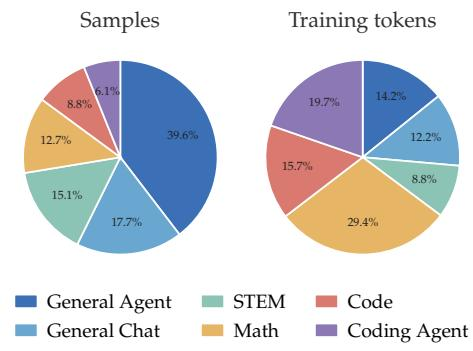
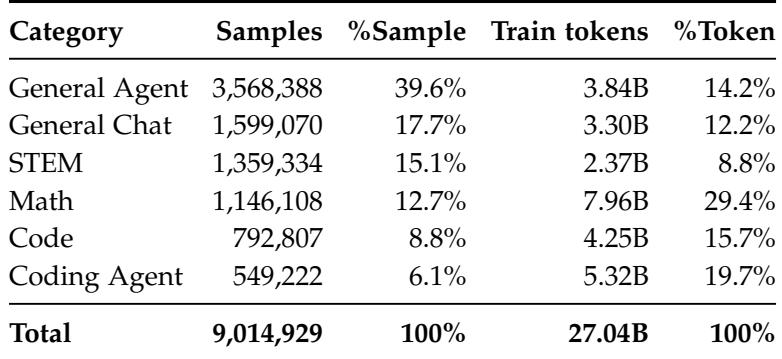
- 来源与构成: SFT 混合数据包含 9.01M 个样本和 44.5B 个原始 token,共有 66.7M 个对话轮次和 23.5M 个受监督轮次。在屏蔽系统消息、用户轮次和工具观察后,27.0B 个 token(占 60.8%)对训练损失有贡献。数据被分为六个能力类别:General Agent、General Chat、STEM、Math、Code 和 Coding Agent。样本数量与训练 token 占比差异很大,因为推理轨迹和多轮编码轨迹要长得多。所有提示和响应均来自 17 个公开数据集。作者未进行新的再生成,也未委托新增人工标注。
- 预处理: 每个来源都被规范化为带有逐消息损失掩码的角色感知多轮模式。无效记录以及没有受监督助手响应的记录会被丢弃。Agent 轨迹被转换为交错的思想、工具调用和观察链。仅当助手轮次构成最后一个真实用户请求之后的完整响应的一部分时,才对其进行监督;更早的助手推理过程会被剥离并屏蔽。系统、用户和工具观察消息的损失为零。
- 验证与长度过滤: 基于规则的验证器检查推理标签是否平衡、角色转换是否有效,以及工具交互周围的掩码是否正确。序列长度在应用生产聊天模板后测量,包括角色标记、推理包装、工具 schema、调用和观察,上限为 120K token。
- 去污染: SFT 混合数据使用词级 8-gram 重叠对已报告基准进行筛查,并对数学和知识基准额外使用穷举 n-gram 与稠密检索筛查。链式基准筛查移除了 3,529 个样本,额外检测器和人工审核使总移除量达到 4,187 个唯一实例。
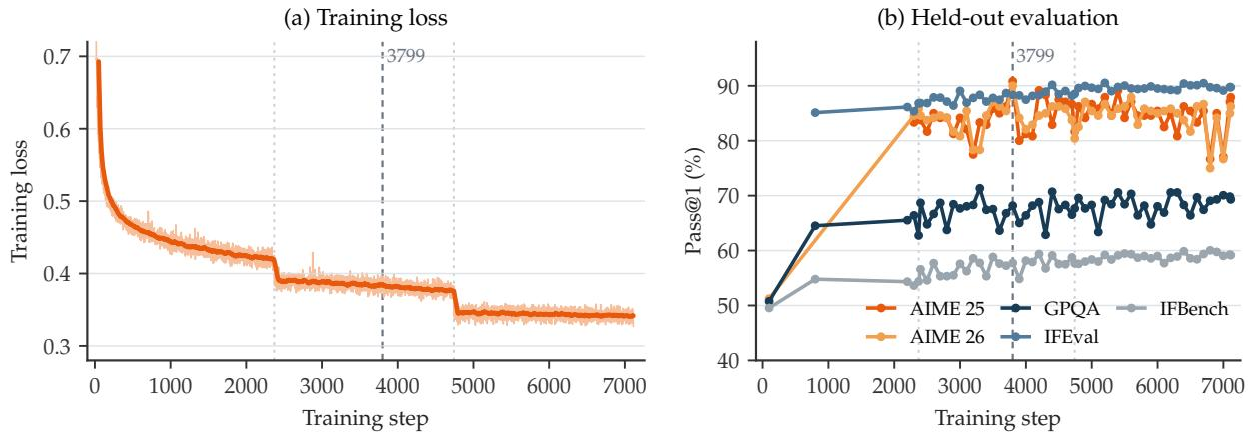
- 使用方式: 模型从 GLM-4.5-Air-Base 开始,对完整的 9.01M 示例混合数据进行三轮训练,并打包到 128K token 上下文。只有助手 token 参与 token 级损失。从第一个训练平台期选出的检查点 3799 初始化后续 RL 阶段。
推理 RL
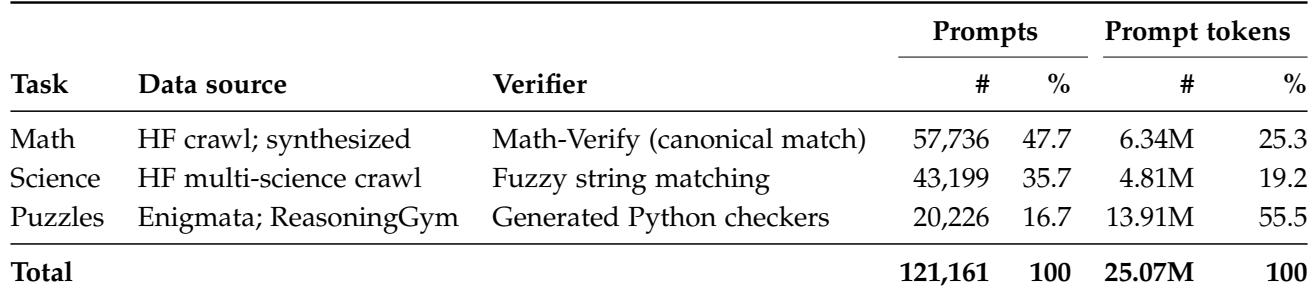
- 来源与构成: 推理提示集结合了公开推理问题与参考解答、通过 Enigmata 和 ReasoningGym 生成的合成与增强数据,以及高难第三方数学集。问题被自动打上细粒度领域标签并去重。提示集涵盖三个可验证的单轮任务族。数学在提示数量上占主导,而逻辑谜题在提示 token 上占主导,在 15 个推理类别的 134 个任务生成器中平均每个提示约 688 个 token。
- 处理: 采用与 SFT 相同的污染筛查。正确性过滤器会移除教师模型 GPT-OSS-120B 无法获得正奖励的提示。可学习性过滤器随后保留当前策略解决率大于 0 且至多 0.8 的提示,从而移除太简单或当前不可学习的提示。在线动态采样进一步仅保留平均奖励处于有效区间的组。
- 使用方式: 过滤后的提示用作可验证单轮 RL 训练提示。大多数提示(83.5%)要求给出 boxed 答案,并与简短金标签匹配。rollout 采样 256 个提示,每个提示 16 个响应,响应预算为 30,000 token。
编码 RL
- 来源与构成: 编码问题集汇总了四个来源:EvolveCoder、Nemotron、Dolci 和 ADR。它混合了带有基于断言单元测试的功能性问题,以及带有输入/输出字符串对的 stdin/stdout 问题。Codeforces 是最大的单一平台,约占 8,700 道题,约占总数的 30%。
- 处理: 没有非空测试负载的记录会被丢弃。去重使用空白归一化、小写化后问题陈述的 SHA-256 哈希。使用精确前缀哈希和字符级 60-gram 重叠对 LiveCodeBench v6 检查泄漏;没有训练问题与评估问题匹配。基于教师可解性的筛选仅保留至少一个采样的 GPT-OSS-120B 补全通过验证器的问题。难度过滤器移除四个基础策略热身样本全部解决的问题,从而有效丢弃简单提示。
- 使用方式: 过滤后的问题与基于执行的二元奖励一起使用。每个问题的测试被确定性下采样到至多 50 个。每次 rollout 初始使用 128 个提示、每个提示 64 个样本;在将响应预算扩展到 128K token 后,调整为 64 个提示。
指令遵循 RL
- 多约束 IF 数据: 作者合成了 14K 个单轮提示,其约束全部可由 Python 检查。教师 LLM Qwen3-235B-A22B 将手工编写的单约束指令池扩展为每个包含 2 到 6 个原子约束的提示,并为每个约束生成一个 Python 验证函数。难度过滤移除当前策略解决率超过 80% 的提示,质量过滤移除教师自身四次尝试都无法通过的提示。
- 多轮对话 IF: 作者对抗式合成了多轮对话。教师 LLM 扮演用户,通过叠加指令、修改先前要求和引入干扰项来尝试让助手模型失败。不同开放权重模型在不同示例中扮演助手角色。部分数据包含用于指令层级训练的系统提示。最终数据集包含 13K 个对话,平均每个对话 6.1 轮、2.7 个评分标准。
- 处理: 对多轮数据应用三个过滤器:合理性过滤移除过长对话和过度拒绝案例,质量过滤移除教师四次尝试无法通过的示例,难度过滤移除当前策略已经太容易解决的提示。
- 使用方式: 两个数据集混合后在一个阶段联合训练。奖励基于评分标准且为二元:所有评分标准都必须满足才能获得正奖励。评分标准可以是可代码验证的 Python 检查,也可以是 LLM 评判检查。作者有意排除可选评分标准,以避免奖励长度偏差。
Coding Agent
- 来源与构成: 训练任务来自 Endless-Terminal、SETA-Env 和 Scale-SWE。Endless-Terminal 提供程序化生成的容器化终端任务,并带有完成测试。SETA-Env 提供超过 4,500 个从网络来源合成并经验证的 Harbor 格式终端环境。Scale-SWE 提供由公开 GitHub pull request 构建的可执行软件工程任务,包括 Docker 镜像和 fail-to-pass 单元测试。
- 处理: 结构过滤器移除不适合规模化执行的任务,例如文件缺失或多容器组合的任务。可学习性过滤器移除当前策略可靠解决或从不解决的任务,留下约 4K 个训练任务。另有约 10K 个 Scale-SWE 任务仍可用但未被使用。
- 使用方式: 任务被转换为统一 Harbor 格式,包含指令文件、环境 Dockerfile 和测试验证器。Agent 使用单个 shell 命令执行工具。奖励是任务验证器在终止时简化为二元结果。
Search Agent
- 来源与构成: 从 MiroVerse 中抽取可验证问答对。需要视觉的问题被丢弃,代理策略几乎从不解决的来源子集被排除。由此得到 36,614 个候选样本,另有 4,069 个额外样本留作验证。
- 处理: 候选集通过两轮筛选缩小。第一轮移除在 8 次无工具 rollout 中任何一次被正确回答的问题,因为这些仅凭参数化知识就可解决。第二轮对每个问题使用 8 次完整工具 rollout,并使用评判分级奖励,保留原始正确次数在 0 到 4 之间的问题。最终留下约 2.2K 个问题的 RL 训练集。
- 使用方式: 过滤后的问题训练一个研究式网络 Agent。该 Agent 可以使用网络搜索、网页抓取和沙箱化 Python 解释器,训练期间最多进行 100 次工具调用。最终答案必须为 boxed。奖励使用 LLM 评判器并给予部分分数,且至少需要两次成功的工具调用才能获得正奖励。
RLHF
- 来源与构成: 作者考虑三个公开偏好数据集作为提示来源:Arena Human Preference、HelpSteer3 和 HH-RLHF。它们过滤掉响应缺失、为空或退化的示例,并用 Skywork-Reward-V2-Qwen3-8B 对剩余响应打分。HH-RLHF 的响应远短于 Arena Human Preference,而 HelpSteer3 响应较短,但 chosen 与 rejected 响应之间的平均分数差距最大。
- 处理与使用: 最终 RLHF 阶段使用有效性过滤后剩余的 75,815 个 HH-RLHF 提示。RLHF 训练仅使用提示。chosen 和 rejected 响应及偏好标签仅用于离线数据集分析。未引入新的人工标签。开放奖励模型在训练期间对策略自身的 on-policy rollout 打分。
方法
作者设计了一个串行后训练流水线,将 GLM-4.5-Air-Base 混合专家模型转换为最终 Rufus-Air 检查点。该流水线由八个顺序阶段组成,每个阶段都基于前一个阶段产生的检查点继续构建。这些阶段从基础能力构建和硬可验证奖励,逐步过渡到高级工具使用和更软的偏好对齐。
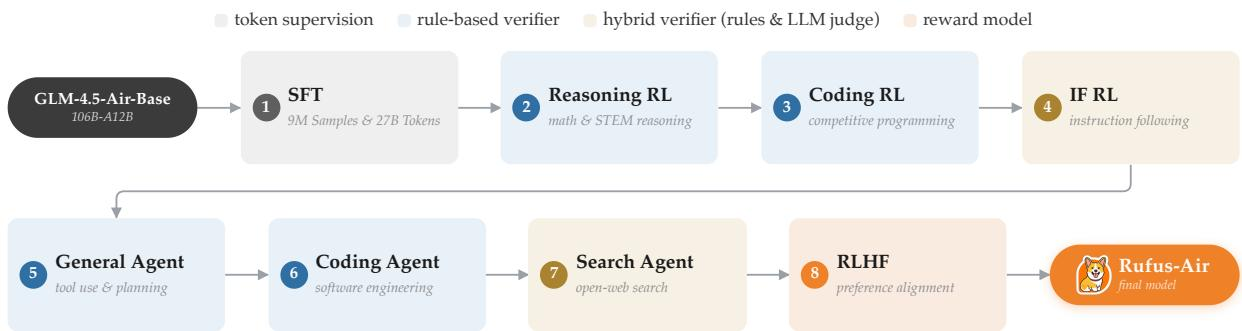
第一阶段是监督微调(SFT),它在规范输出格式的同时,建立对聊天、数学、STEM、编码和工具使用的广泛覆盖。作者构建了一个多样化 SFT 混合数据,包含 9.01M 个样本和 44.5B 个原始 token。数据分为六个能力类别,这些类别之间样本分布与贡献损失的 token 分布差异显著。
在 SFT 训练期间,模型使用 AdamW 和余弦学习率调度优化三轮。训练损失随轮次稳步下降,而留出评估指标较早进入平台期,表明模型迅速获得必要的基础能力。作者从该平台期选择一个中间检查点来初始化后续强化学习阶段。
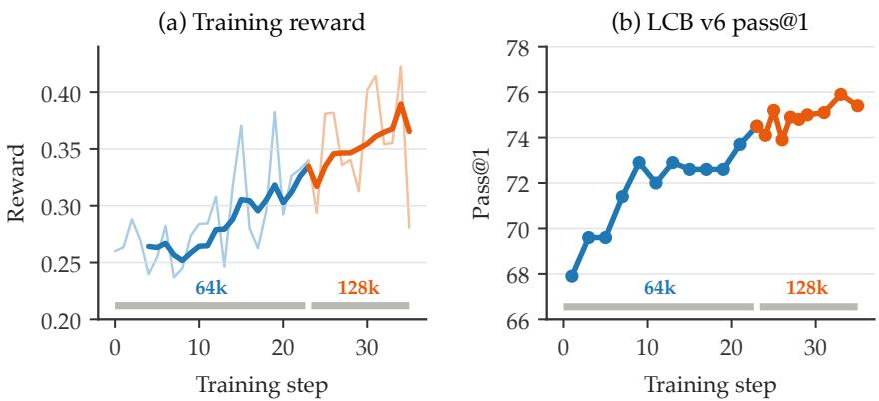
在 SFT 之后,流水线应用带可验证奖励的强化学习来增强特定能力。推理 RL 使用确定性验证器和 Group Sequence Policy Optimization 针对数学和科学推理。作者采用严格的数据过滤,确保提示既可解,又处于策略的有效学习区间内。随后编码 RL 使用基于执行的奖励提升竞赛编程表现。训练动态显示训练奖励和编码基准通过率均稳步上升,并在运行中期将响应预算从 64K 扩展到 128K token,以消除截断掩码并进一步提升性能。
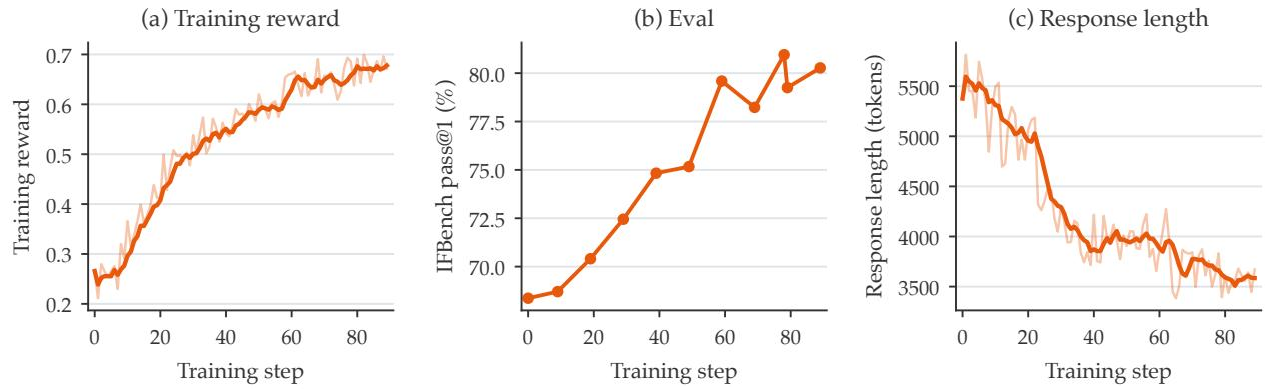
指令遵循 RL 是下一阶段,旨在提升模型遵循复杂多约束指令以及在多轮对话中保留分层指令的能力。作者为单轮和多轮指令遵循合成了数据集,采用基于评分标准的二元奖励系统,只有所有必要条件都满足时才给予奖励。使用 Group Relative Policy Optimization 训练使训练奖励和评估分数持续上升,同时响应长度下降,因为模型学会了精确遵循指令而不进行不必要的填充。
接下来的三个阶段在专门环境中引入工具使用。General Agent 训练通过合成 Model Context Protocol 任务建立广泛的工具编排习惯。Coding Agent 训练专注于沙箱环境中的终端和软件工程任务,使用基于执行的验证器。Search Agent 训练面向开放网络上的多跳事实性问题,依赖 LLM 评判器提供基于结果的奖励,并使用仅均值的组优势来处理噪声奖励信号。最后,RLHF 使用学习到的奖励模型和 on-policy RL 塑造开放式回答质量,优化简洁、有帮助且无害的响应,以降低奖励黑客风险。
实验
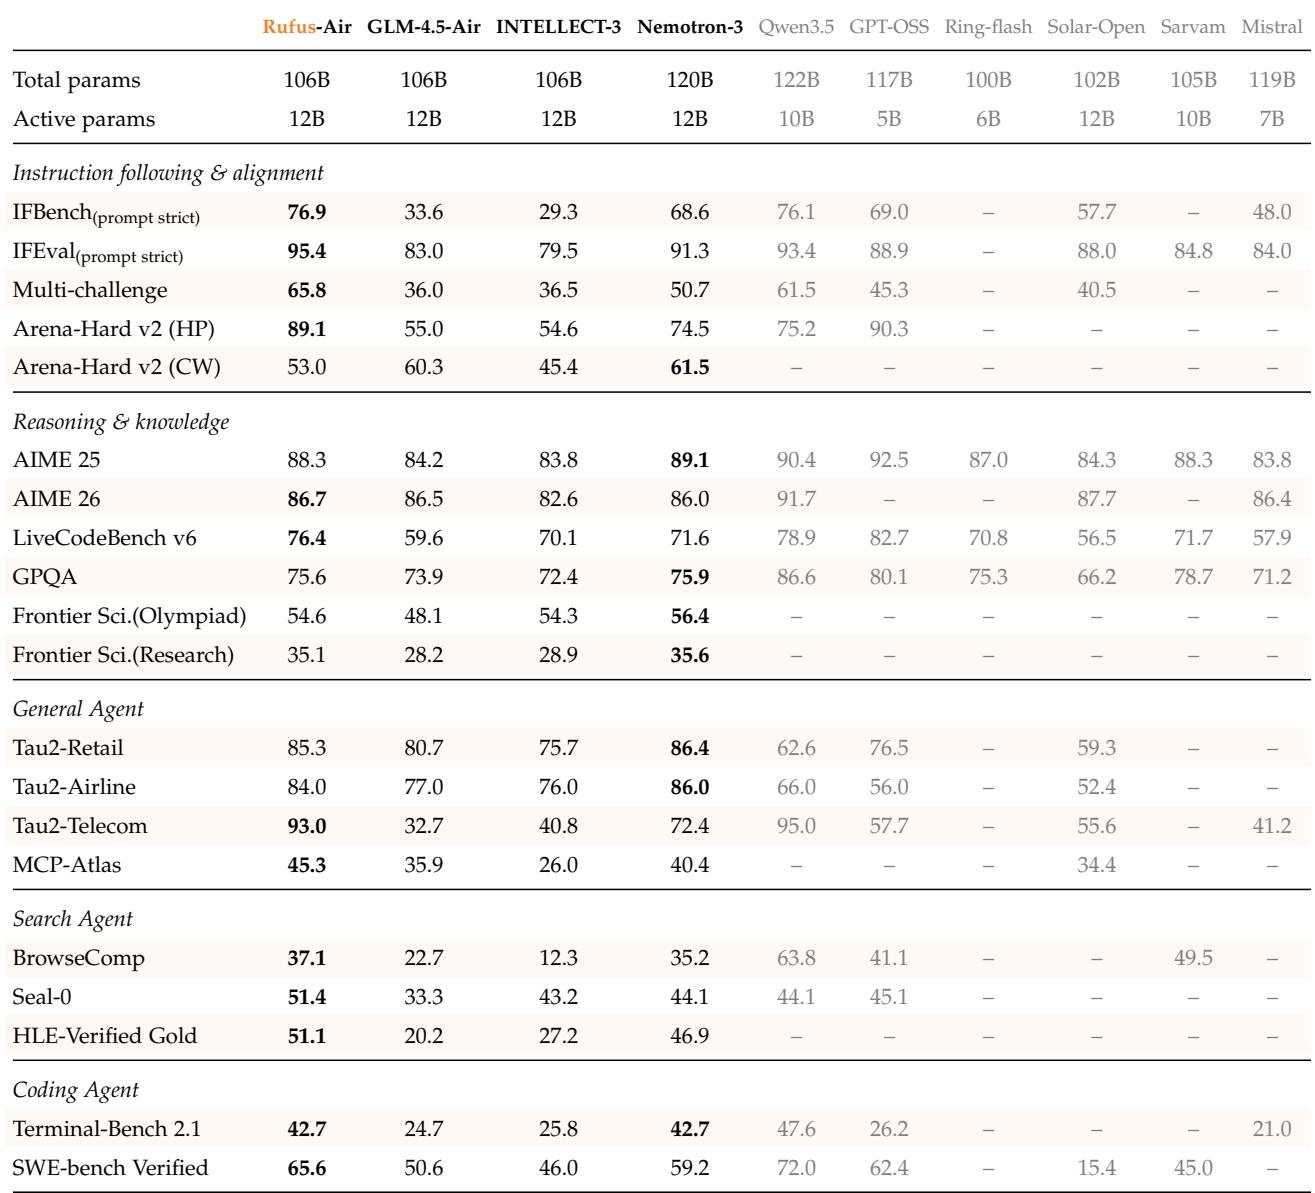
评估将 Rufus-Air 与活跃参数量级相近的开放权重模型进行比较,其中包括同一基座检查点的两个后训练版本,以及一个来自不同基座的模型;比较范围涵盖指令遵循、推理与知识,以及通用、搜索和编码 Agent 基准,同时追踪能力在八阶段训练流水线中的累积。主要结果表明,Rufus-Air 在几乎所有行上领先同一基座基线,并在指令遵循和大多数 Agent 类任务上领先更强的不同基座基线;收益集中在方案投入训练信号的领域,而数学和科学保持接近,创意写作是一个显著例外。逐阶段结果表明,每个阶段主要推动自身目标,SFT 已经提供了较强的 RL 前下限;讨论强调可学习性过滤、按奖励脆弱性排序阶段、基础设施选择,以及 Agentic RL 的额外成本是关键跨阶段发现。作者还限定结论,指出串行阶段顺序未被证明是最优的,且 Coding Agent 仅训练到可用算力预算。
在相同评测框架下评估的模型中,Rufus-Air 在指令遵循以及大多数对齐和 Agent 类基准上领先,同时在竞赛数学和知识上保持接近。主要例外是 Tau2-Airline、Tau2-Retail 和 Arena-Hard v2 Creative Writing,对比模型在这些基准上仍然领先。收益在获得最多训练信号的领域最大。在统一评测框架下评估的四个模型中,Rufus-Air 在指令遵循以及大多数对齐和 Agent 类基准上领先。Nemotron-3-Super 在 Tau2-Airline 和 Tau2-Retail 上保持领先,Nemotron-3-Super 和 GLM-4.5-Air 均在 Arena-Hard v2 Creative Writing 上领先。在竞赛数学和知识基准上,Rufus-Air 与其他模型表现接近,并在 Terminal-Bench 2.1 上与 Nemotron-3-Super 打平。最强收益出现在方案投入最多训练信号的领域。
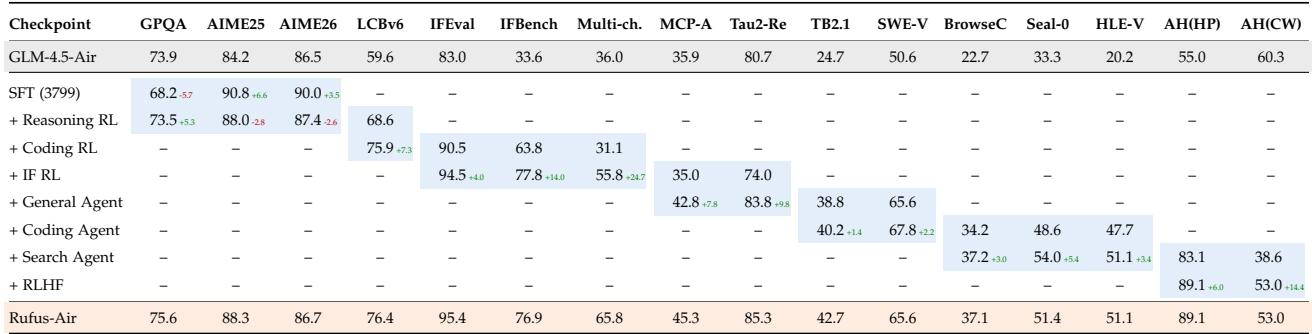
流水线显示出分阶段能力累积:监督微调提高了数学基准,但降低了 GPQA;随后推理 RL 恢复 GPQA,同时略微降低数学分数。编码 RL 随后提升 LiveCodeBench,指令遵循 RL 在 IFBench 和 Multi-challenge 上产生最大的定向收益。之后的 Agent 阶段改善工具使用和软件工程基准,RLHF 改善两个 Arena-Hard 子项,尤其是创意写作。监督微调将 AIME 分数提高到基座模型之上,但使 GPQA 低于基座;推理 RL 将 GPQA 恢复到接近基座水平,同时适度降低 AIME。指令遵循 RL 在编码检查点基础上构建,并在 IFBench 和 Multi-challenge 上取得最大相对收益,在 IFEval 上还有较小进一步收益。推理 RL 之后,接下来两个阶段在增加编码和指令遵循技能的同时,使 GPQA 和 AIME 26 几乎保持不变。General Agent 和 Coding Agent 阶段改善其目标基准,包括 MCP-Atlas、Tau2-Retail、Terminal-Bench 和 SWE-bench Verified。
SFT 混合数据涵盖六个能力类别,并显示样本占比与贡献损失的 token 占比之间存在很大错配。按样本数计,General Agent 是最大的类别;而 Math 和 Coding Agent 因推理轨迹和多轮轨迹更长,在 token 占比中占主导。各类别的样本占比与训练 token 占比差异显著,因此样本数反映来源覆盖,而 token 占比反映监督工作的集中位置。Math 和 Coding Agent 合计仅占样本的少数,却占助手训练 token 的近一半。
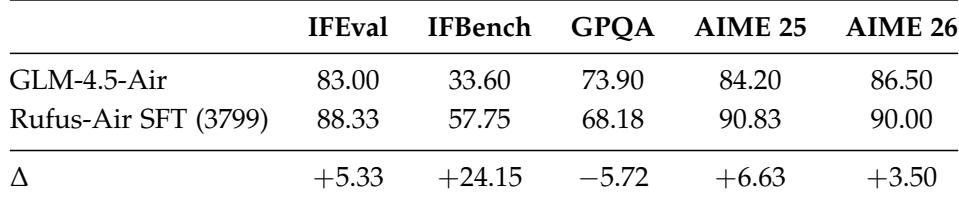
在任何 RL 之前,仅 SFT 检查点已在指令遵循和两个 AIME 基准上超过公开 GLM-4.5-Air 发布版本,并在 IFBench 上领先幅度尤其大。它仅在 GPQA 上落后,这一差距正是后续 RL 阶段旨在弥补的。这使得 SFT 检查点成为 RL 的有竞争力起始下限,而不仅仅是热身。仅 SFT 检查点在 IFEval、IFBench、AIME 25 和 AIME 26 上超过了包含 RL 的公开版本。GPQA 是 SFT 检查点落后的唯一报告指标,后续 RL 阶段针对这一差距。
RLVR 提示集组合了数学、科学和谜题任务,每个任务使用不同验证器。数学提供最大提示份额;谜题按提示数是最小族,却因题干长得多而占提示 token 的大多数。科学在提示数上位于其他两者之间,并具有最低 token 占比。数学贡献略低于一半提示,科学约三分之一,谜题约占六分之一。尽管谜题提示份额较小,但占全部提示 token 的一半以上,谜题题干大约比其他类型长六倍。每个任务族使用不同验证器:数学使用规范答案匹配,科学使用模糊字符串匹配,谜题使用生成的 Python 检查器。
实验在统一评测框架下将 Rufus-Air 与同类模型进行比较,并追踪训练阶段间的能力变化。Rufus-Air 在指令遵循和大多数对齐及 Agent 类基准上领先,同时在数学和知识上保持接近,Tau2-Airline、Tau2-Retail 和创意写作是主要例外。逐阶段结果表明,监督微调提高数学但降低 GPQA,推理 RL 恢复 GPQA,编码和指令遵循 RL 增加定向技能,随后的 Agent 阶段改善工具使用和软件工程。仅 SFT 检查点已在指令遵循和 AIME 基准上超过公开 GLM-4.5-Air 发布版本,数据分析还揭示 SFT 和 RLVR 提示混合中样本占比与 token 占比的巨大错配。