Command Palette
Search for a command to run...
后训练在不相关决策上留下行为阴影
后训练在不相关决策上留下行为阴影
Ziyang Zhang Yubin Jing Yuanhao Zeng Yuyao Li Haofan Wang Yichen Gong
摘要
我们发现语言模型能够通过任务无关文本实现能力迁移。后训练通常使用任务特定数据改进语言模型。先前关于阈下学习的研究表明,这些更新信息可以经由无关生成内容传递,但主要聚焦于利用大量教师输出来研究特质或偏好。我们提出主动无任务蒸馏(ATD),该方法仅利用教师针对每个提示给出的一个单词即可实现能力迁移。ATD 通过选择教师与学生共享的公共祖先模型对两个普通单词几乎无偏好的提示,来探测后训练的行为阴影。从该祖先模型初始化的学生仅从这些提示—单词对中学习,不使用目标任务示例、教师 logits 或教师参数。在 Qwen2.5-1.5B 的主要编程实验中,相较于在干扰因素上精确匹配并打乱提示—响应对应关系的对照组,教师给出的 5,664 个单词响应在 HumanEval+ 上带来 5.34 个百分点的增益。进一步实验表明,这种迁移还出现在科学知识、常识推理和阅读理解中,并在更多模型代际、规模和家族上取得正的平均增益。功能性分析表明,所学信号具有来源特异性和可组合性,且其强度随教师更新强度的变化而变化。代码可在 github.com/myboker/ATD 获取。
一句话总结
北京大学、佐治亚理工学院及其他机构的研究人员提出主动无任务蒸馏(Active Taskless Distillation,ATD),该方法通过单字教师响应传递能力,其选择方式是挑选共享公共祖先在两个普通单词之间几乎无差别偏好的提示词;在 Qwen2.5-1.5B 的主要编码实验中,5,664 条此类响应带来 5.34 个百分点的 HumanEval+ 提升,并在推理、知识与理解任务中实现迁移。
核心贡献
- 本文提出主动无任务蒸馏(ATD),这是一种从后训练教师向同一祖先学生传递能力的方法,仅以每个提示词中的一个普通单词作为监督,选择共享公共祖先在两个单词之间几乎无差别之处,且无需目标任务示例、教师 logits 或教师参数。
- 在 Qwen2.5-1.5B 的主要编码实验中,5,664 条单字教师响应相对于精确干扰匹配的对照组带来 5.34 个百分点的 HumanEval+ 提升;进一步实验显示在科学知识、常识推理与阅读理解上的迁移,并在更多模型代际、规模与家族上获得正的均值提升。
- 功能性分析表明,所学到的信号具有来源特定性与可组合性,其强度跟随教师的更新强度变化,且在目标任务增益达到统计显著之前,学生中已可测得早期与教师对齐的变化。
引言
后训练通常通过目标任务的改进加以评估,但一次更新也可能改变模型在无关输入上的偏好,作者称此现象为行为阴影(behavioral shadow)。这一问题的重要性在于,此类非预期变化可能在不接触更新后参数或目标任务数据的情况下,泄露有关私有模型适配的信息。此前关于潜隐学习的研究表明,可见内容并不完全决定一个训练样本所暴露的信息,但现有蒸馏与提取方法通常依赖教师 logits、目标任务响应或较长的生成输出。作者提出主动无任务蒸馏(ATD),该方法利用公共祖先寻找两个普通单词几乎并驾齐驱的提示词,观察私有更新后的教师选择哪个单词,并在这些一位元选择上训练学生。结果表明,这种无任务信号携带有与能力相关的信息,在不使用任何目标任务示例或教师概率的情况下提升了学生在代码生成与多项选择基准上的表现。
方法
作者提出主动无任务蒸馏(ATD),这是一种黑盒蒸馏流程,在不使用目标任务数据的情况下从私有教师中提取与能力相关的信号。该设定假设存在一个公共祖先模型 M0,其参数为 θ0,以及一个私有教师 MT,后者由 M0 在目标任务上后训练得到:
θT=θ0+δ,其中 δ 是未知的后训练更新。学生由同一 θ0 初始化。在蒸馏过程中,教师仅通过黑盒接口提供,该接口每次查询通过全词表的贪心解码返回一个 next token,学生不接收任何目标任务数据。
ATD 围绕载体(carriers)与行为阴影的概念构建。载体是一个提示词-响应对,其可见文本与目标能力无关。在这类与任务无关的输入上,私有教师仍可能表现出不同于其公共祖先的行为。这些差异就是私有更新的行为阴影。为了确定阴影是否载有有用信号,在同一祖先的学生上用所得提示词-单词对进行训练,并在目标任务上评估。与打乱提示词-响应对应关系的匹配对照组相比的提升,表明能力通过这些观察实现了迁移。
该方法使用近似并列的提示词,因为它们可以通过微小的偏好变化暴露私有更新。对于载体提示词 xi 以及两个普通单 token 候选项 ai 与 bi,logit 差定义为
mi(θ)=zθ(ai∣xi)−zθ(bi∣xi),其中 zθ(w∣xi) 是单词 w 的 next-token logit。围绕 θ0 的一阶展开给出
mi(θ0+δ)≈mi(θ0)+gi⊤δ,gi=∇θmi(θ0).在并列附近,∣mi(θ0)∣ 很小,因此相对偏好的微小变化就可能翻转所选择的单词。因此,观测到的教师选择建模为
yi≈sign(mi(θ0)+gi⊤δ).每条保留的教师响应提供行为阴影的一位元观测:教师偏好哪个单词,但不提供偏好变化的幅度。
ATD 分为三个主要阶段。首先,作者构造候选提示词,要求模型在两个普通单 token 单词 ai 与 bi 之间作出选择。仅使用公共祖先 M0,计算 bi 在两个候选项上的归一化概率:
qi=expz0(ai∣xi)+expz0(bi∣xi)expz0(bi∣xi).当满足以下条件时保留提示词:
∣qi−0.5∣≤ϵ,其中 ϵ=0.02。作者还要求在全词表上公共模型下概率最高的 token 是两个候选项之一。这保证了近似并列涉及模型的实际输出选择。
其次,选定的提示词与候选对在观测任何教师响应之前固定。每个提示词仅查询一次,教师返回其在全词表上概率最高的 next token。响应 wiT 仅当其属于 {ai,bi} 时才被保留;否则该示例被丢弃且不重采样。每条保留的二选一选择形成训练对 (xi,wiT),即使提示词和响应都未提及目标任务。
第三,学生由同一公共祖先 M0 初始化。对于 n 条保留的提示词-单词对,作者最小化全词表交叉熵:
LCE(θ)=−n1i=1∑nlogpθ(wiT∣xi).只有响应 token 对损失有贡献,提示词提供上下文。
作者还探索了同一工具的两个改进。第一个是参照相对对边际(RPM)目标,它学习由 δ 引入的残差偏好,而非 M0 中已有的偏好。令 wˉi 表示对中的另一个单词。RPM 减去两个候选词之间冻结的公共边际:
LRPM=−Eilogσ(β[logpθ(wˉi∣xi)pθ(wiT∣xi)−logp0(wˉi∣xi)p0(wiT∣xi)]).第二个扩展将每条观察从单个硬 token 扩展为同一载体上的 K 个单词答案 yi=(yi,1,…,yi,K)。学生随后通过 K 个位置上的普通全词表交叉熵训练:
Lmulti=−n1i∑K1k=1∑Klogpθ(yi,k∣xi,yi,<k),当 K=1 时退化为单 token 目标。这些扩展是对同一近边界工具进行的探索性改进,而非独立方法。
实验
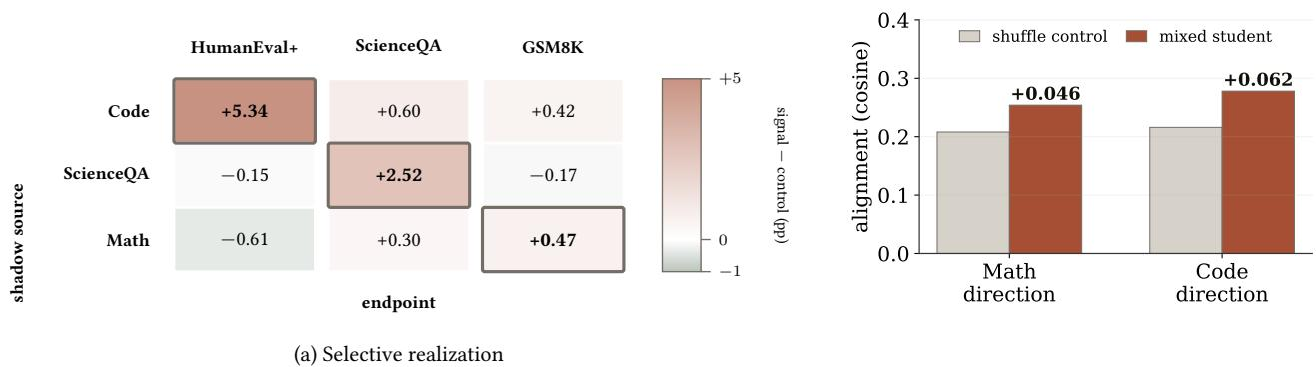
实验评估了一种隐式蒸馏设定:从公共祖先初始化的学生仅用与目标无关、近似并列载体提示词上的单 token 教师响应进行训练,然后在编码、数学与多项选择基准上针对匹配对照组进行测试。核心发现是,此类训练在 HumanEval+ 上恢复了私有教师的能力,其效果经得起精确干扰匹配对照组与打乱标签对照组的检验,并且在不同批次采集、重新训练的教师、不同适配方式、模型家族与多个无关任务上保持稳健。分析表明,迁移来自主动查询祖先的决策边界而非查询数量,具有来源特定性与可组合性,并且不单由教师的大幅提升所导致,说明该通道传递的是可表达的能力而非教师的原始优势;多 token 观察以任务相关的强度扩展了同一效果。
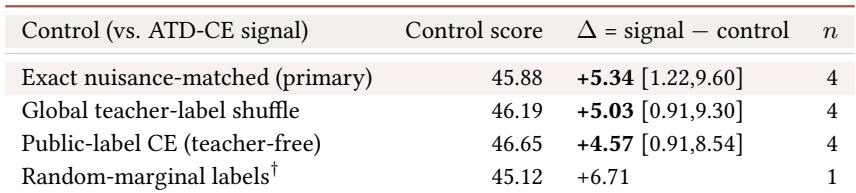
在 Qwen2.5-1.5B 学生的 HumanEval+ pass@1 上,信号模型达到 51.22%,超过每一个识别对照组。相对于精确干扰匹配、打乱标签及无教师对照组的差距约为五个百分点,主要对照组的 95% 置信区间不包含零。单种子随机边际诊断也比信号低约七个百分点。信号超出精确干扰匹配对照组约五个百分点,95% 置信区间不包含零。无教师与打乱标签对照组同样比信号低约五个百分点,因此通用载体微调与教师标签统计无法解释该增益。
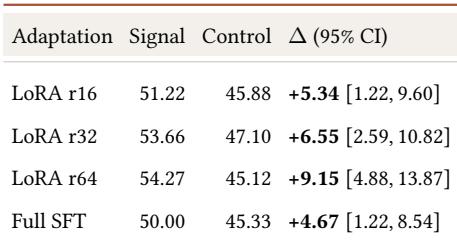
在所有适配方式上信号与对照组的差距均为正,置信区间高于零。LoRA r64 下估计效应最大,全 SFT 下最小,显示在适配选择上的稳健性。每种被测试的适配方式都表现出正的信号-对照效应,置信区间完全高于零。较大的 LoRA 秩对应较大的信号-对照差距,而全 SFT 在各方式中差距最小。
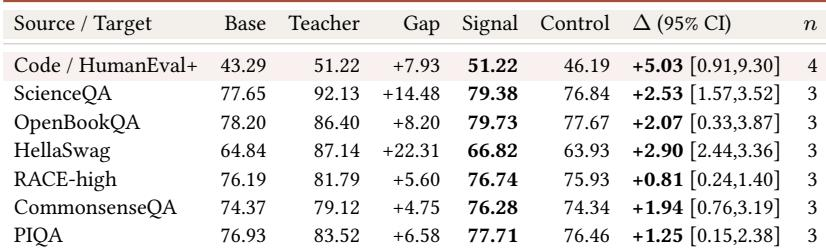
在涵盖代码生成、科学知识、常识推理与阅读理解的七个目标任务上,用与目标无关的教师响应训练的学生在每个设定中都优于匹配对照组。所有迁移增益的置信区间均不包含零,范围从不到一个百分点到约五个百分点。最大的迁移出现在代码生成上,而一些教师优势更大的任务则表现出较小或中等的提升。每个被评估的目标任务相较于教师标签打乱对照组均表现出正的迁移效应,增益从不到一个百分点到约五个百分点。更大的教师优势并不必然转化为更大的迁移;HellaSwag 与 ScienceQA 的教师增益属于最大之列,但与代码生成相比迁移提升有限。
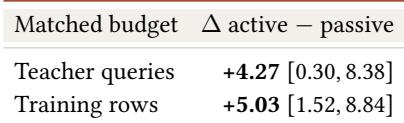
在匹配预算下,主动采集在教师查询与训练行两方面均优于被动采集。报告的差异为正且置信区间高于零,表明存在一致优势。训练行的增益略大于教师查询的增益。主动采集在教师查询上相对被动采集表现为正差异。主动采集在训练行上相对被动采集表现为正差异,其增益略大于教师查询。
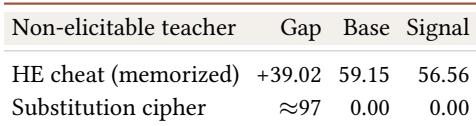
对不可引出的教师优势的分析表明,仅凭教师大幅提升本身并不会传递给学生。一个记住了 HumanEval+ 解答的教师产生了较大的目标任务差距,但学生信号仍低于其基线;替换密码教师未带来任何相对于零基线的提升。这些案例表明迁移取决于学生可被引出表达的能力,而非教师的原始优势。一个记住了 HumanEval+ 的教师在其端点达到较大增益,但 ATD 学生未比其基线模型有所提升。一个替换密码教师达到近乎完美的差距,然而基线与学生均保持为零,说明该不可引出能力没有迁移。
实验评估了一种基于信号的方法,使用 Qwen2.5-1.5B 学生在代码生成、科学知识、常识推理与阅读理解上进行测试,并与干扰匹配、打乱标签、无教师及被动采集对照组比较。信号模型一致优于这些对照组,在适配方式与目标任务上均呈现正差距,且主动采集在教师查询与训练行两方面均优于被动采集。增益无法用通用载体微调或教师标签统计解释,而记住解答或密码技能等不可引出的教师优势不会迁移,表明迁移取决于学生实际能够表达的能力。