Command Palette
Search for a command to run...
在世界模型中训练客体永久性
在世界模型中训练客体永久性
摘要
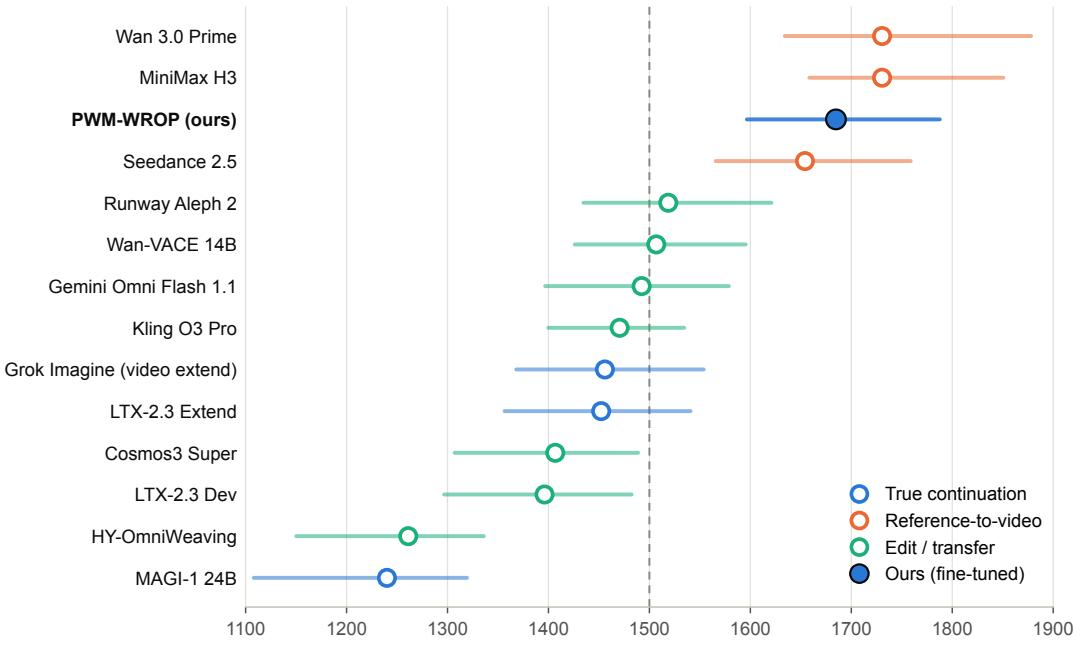
客体永久性和实体性是人类认知先验的重要标志。近期研究表明,视频生成模型作为当前世界模型的一个代表性类别,已开始展现出涌现的推理能力,这使它们成为构建类人物理智能的理想候选者。视频模型内部是否已经涌现出客体永久性?若否,我们能否利用受核心认知启发的数据集来训练它们?我们提出了 WROP(World Reasoning with Object Permanence,即具备客体永久性的世界推理),一个包含 150 个手工设计且受认知科学启发的任务的数据基础设施,这些任务被划分为六个认知类别。我们构建了 Blender 生成器,在保持每个任务认知结构不变的前提下,对速度、光照、摄像机角度和其他干扰参数进行随机化,从而为每个任务生成超过 10,000 个样本。我们发布了包含 1.5M 样本的训练语料库和一份 300 题的考试。在这份考试中,我们评估了 14 个视频模型:3 个参考到视频(reference-to-video)模型、7 个编辑(edit)模型和 4 个续写(continuation)模型,其中包括我们的 16B 世界模型 PWM-WROP。在一项盲法成对比较 Elo 研究中,PWM-WROP 在续写模型中排名第一,在全部模型中排名第三,仅落后于两个在统计上并列的 reference-to-video 模型。我们发布了数据、考试、模型答案、分数、权重,以及 PWM(我们在 AWS Trainium2 上构建的原生 PyTorch 训练栈)。
一句话总结
南加州大学及其合作者推出了 WROP(World Reasoning with Object Permanence),这是一个受认知科学启发的数据基础设施,包含跨六个类别的 150 个手工设计任务、一个 150 万样本训练语料库,以及一项 300 题考试;该工作利用这些资源训练并评估 PWM-WROP,这是一个 16B 世界模型,在盲测成对 Elo 研究中在续写模型中排名第一,在总排名中位列第三。
核心贡献
- 本文介绍了 WROP,一个由 150 个手工设计的 Blender 任务生成器构建、覆盖六个认知类别的基准和训练资源,产生 150 万样本训练语料库和一项用于客体永久性与物体实体性的固定 300 题考试。
- 该工作评估了 14 个视频生成模型,涵盖参考到视频、编辑和续写设置,并采用盲测成对人工 Elo 评分;16B 的 PWM-WROP 模型在续写模型中排名第一,总排名第三,仅次于两个在统计上并列的参考到视频模型。
- 该工作发布了语料库、考试、模型答案、分数、权重以及基于 AWS Trainium2 的 PWM 训练栈,并提供了初步证据:在基于认知原理的合成数据上训练,是为视频生成模型赋予物理推理能力的一条可行路径。
引言
近期的视频生成模型能够生成逼真、时间上连贯的视频片段,并越来越被视为世界模型;然而它们在客体永久性和物体实体性方面仍然失败,例如让被遮挡的物体在不合理的位置重新出现,或穿过实体障碍物。这一点很重要,因为客体永久性和实体性是人类物理智能中的基础核心知识能力,也是有效碰撞、支撑移除和更高层因果推理的上游要求。先前的基准通常仍局限于 2D 或图像到视频的设置,提供很少或根本不提供训练数据,并且依赖基于 VLM 的评分,尽管 VLM 在被测的相同物理推理能力上存在系统性缺陷。作者用 WROP 解决这些空白。WROP 是一个由 150 个 Blender 生成器构建的 3D 合成基准,覆盖六个任务族,包括 150 万样本训练语料库、固定的 300 题人工评估考试,以及一个后训练的 16B 续写模型 PWM-WROP。该模型在人工成对比较中在真实续写模型中排名第一。
数据集
作者使用一个由 150 个参数化 Blender 任务生成器构建的合成数据集。它并非来自真实视频;所有片段均为手工创作的 3D 动画,以 1280×720 和 24 fps 渲染。这些生成器按照两个认知维度组织为六个族:客体永久性(OP)和物体实体性(OS)。结构参数控制物理和认知挑战,而颜色、材质、光照和相机视角等表面参数则随机化以保证视觉多样性。
任务族
- OP-1:Baillargeonian 遮挡。目标移动到遮挡物后方,必须保持身份、大小和运动完整地重新出现。
- OP-2:物体静态遮挡。移动遮挡物遮住静态物体;移除遮挡物后必须恢复原来的数量、身份和空间排列。
- OP-3:容器永久性。物体被隐藏在可能移动或交换的容器内;物体必须继续跟随容器的新位置。
- OS-1:Baillargeonian 阻碍。移动物体接近带有开口的障碍物,必须根据物体与开口的尺寸被阻挡或允许通过。
- OS-2:物体下落。支撑面被移除;物体必须下落,并由尺寸与开口的过滤关系决定其是穿过还是停留。
- OS-3:物体碰撞。移动物体撞击静止结构,必须产生物理一致的碰撞后轨迹,不发生合并或相互穿透。
规模与样本格式
- 训练语料库:来自 150 个生成器的 1,500,000 个样本,每个生成器 10,000 个样本。
- 评估考试:300 道题,使用来自 150 个生成器中每个生成器的 2 个样本。
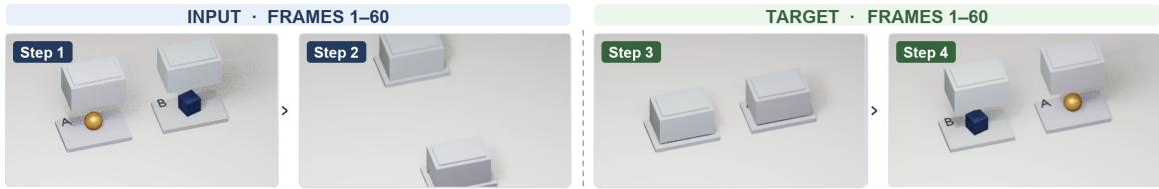
- 每个样本是一个 120 帧的物理一致动画,在关键事件处切分为 60 帧输入视频和 60 帧目标视频。
- 每个样本包含一个自然语言提示、逐帧物体位姿轨迹,以及描述场景状态的元数据记录。
- 运动以 Blender 关键帧动画编写,而非由物理引擎生成;轨迹数组从该动画中采样。
生成与验证
- 每个任务都实现为一个独立、参数化的 Blender 生成器,指定物体、场景几何、初始条件、关键帧运动、相机设置、提示和预期物理结果。
- 不使用刚体求解器;轨迹以解析方式编写,使遮挡、接触和重新出现在受控帧发生。
- 共享驱动器通过 Blender 4.4.3 和 EEVEE Next 进行渲染。随机种子控制表面变化,同时保留相机、几何、空间配置和物理机制。
- 120 帧动画在第 60 帧处切分为 60 帧输入和 60 帧目标。
- 每个样本被打包为一个五元组:输入视频、目标视频、提示、轨迹和元数据。
- 自动验证检查所有五个组件是否存在且可读,两个片段具有相同帧率,每个片段正好有 60 帧,并且两个片段在第 60 帧处相接,没有间隔或重叠。
- 检查轨迹和元数据文件的必需字段。元数据记录生成器身份、样本索引、随机种子和渲染配置。
- 失败或无效的样本会被拒绝并重新生成。发布前,每个生成器的代表性样本会被人工检查。
数据用途
- 输入半段建立事件前的场景上下文,目标半段捕捉物理事件及其后果。
- 该切分与视频到视频评估协议一致,即模型从 60 帧输入生成 60 帧目标。
- 训练对每个生成器等量采样,而评估从每个生成器抽取两个样本,以覆盖全部 150 个任务。
方法
作者设计了一条数据生成流水线,其中每个生成器将任务族的物理场景实例化为一个独立的 3D Blender 场景。使用多样化的日常物体和场景配置,在视觉上不同的设定中测试相同的物理原理。为避免模型仅依赖最终位置,作者在单个生成器内引入多种物理上有效的结果。例如,在 Marked Boxes Swap 任务中,两个带标签的盒子分别盖住不同物体,交换屏幕位置后重新打开,每个物体仍与原来带标签的盒子相关联。这种构造要求模型在运动和遮挡中追踪盒子身份和隐藏内容。只要在检查中发现物体相互穿透或其他物理违规,场景几何、物体轨迹、接触时机、遮挡范围以及相机位置都会被修正。
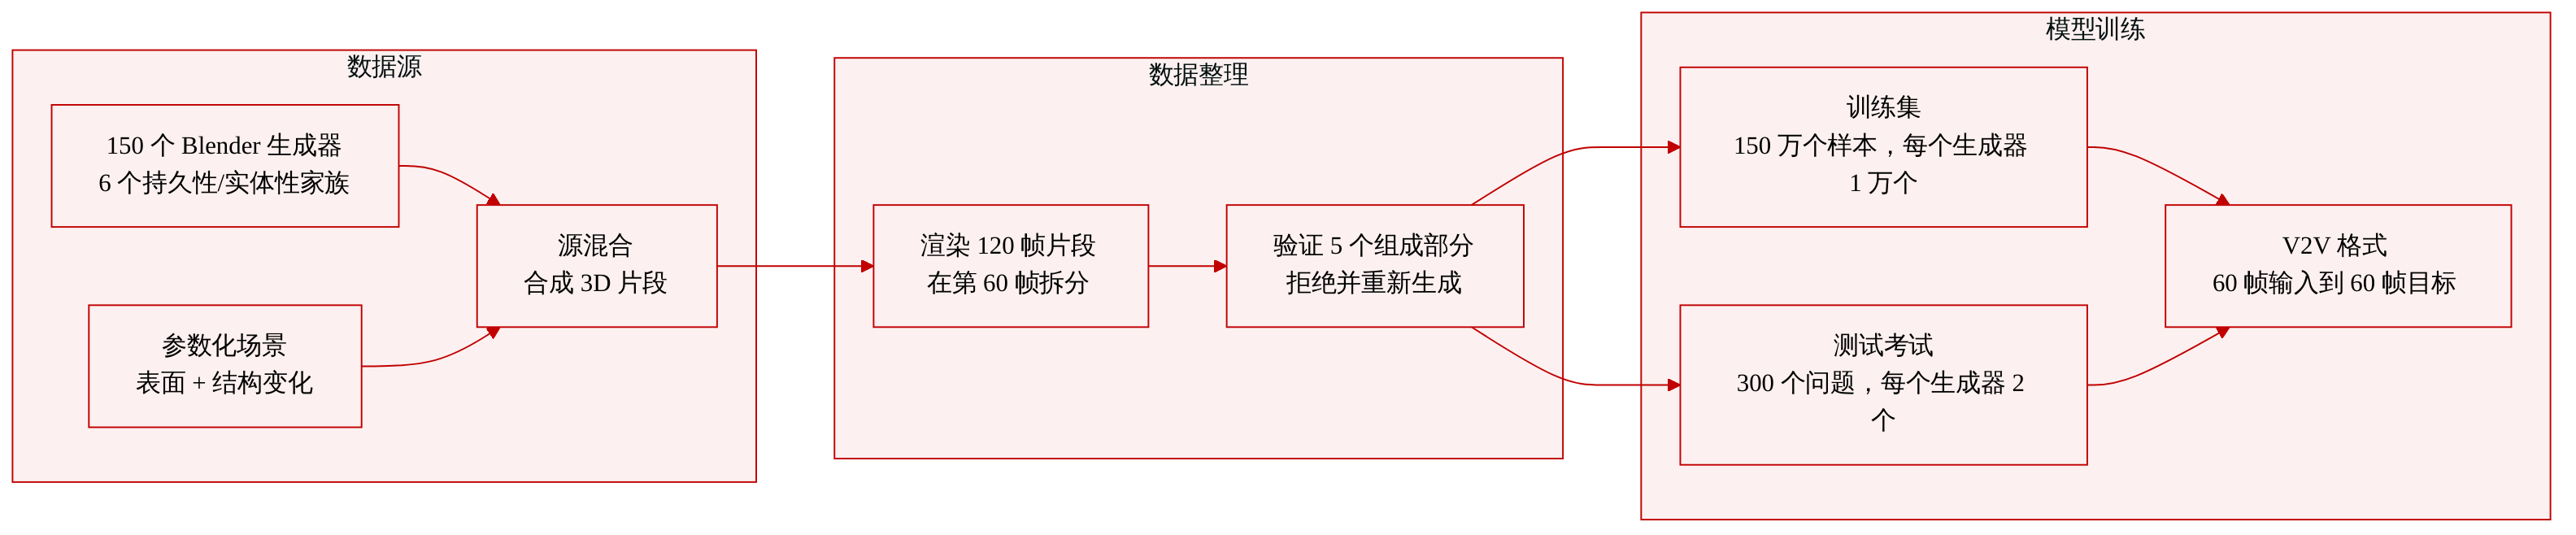
数据生成流水线包含三个主要阶段。第一,在任务特定生成器实现阶段,150 个任务中的每一个都被实现为独立、参数化的 Blender 生成器。该生成器指定物体及其语义角色、场景几何、初始条件、构成任务的关键帧运动和接触事件、相机配置、自然语言提示以及预期物理结果。不使用刚体求解器;每条轨迹都以解析方式编写,使遮挡、接触和重新出现在受控帧发生,因此物理合理性由场景作者而非模拟器负责。
第二,在样本生成与构造阶段,共享驱动器通过统一的 Blender 渲染后端执行每个生成器。记录的随机种子控制物体颜色、材质和场景光照的表面变化,同时保留编写好的相机、几何、空间配置和物理机制。渲染器生成 120 帧动画,并在第 60 帧处切分,产生 60 帧输入视频和 60 帧目标视频。每个样本被打包为一个五元组,包括输入视频、目标视频、提示、轨迹和元数据。
第三,在大规模生成与验证阶段,生成器在并行工作进程上独立运行,每个贡献 10,000 个训练样本。失败的渲染会自动重试并记录,自动审计会验证文件完整性和模式有效性。每个生成的样本在进入数据集之前都会经历自动验证。作者验证所有五个组件都存在且可读,两个片段具有相同帧率,并且每个片段正好包含 60 帧,在第 60 帧处相接,没有间隔或重叠。检查轨迹和元数据文件的必需字段,元数据记录生成器身份、样本索引、随机种子和渲染配置,使每个样本都能追溯到其生成条件。未通过任何检查的样本会被拒绝并重新生成。发布前,每个生成器的代表性样本都会经过人工检查,以确认渲染序列符合预期的任务定义,并且切分边界位置正确。
实验
本评估通过在 WROP 语料库上微调 PWM-WROP,并将其与十三种系统在真实续写、参考到视频以及编辑或迁移接口中进行比较,测量视频到视频模型在客体永久性和实体性上的表现。人类偏好结果显示,参考到视频模型总体领先,而 PWM-WROP 是最强的真实续写模型,这表明特定领域的微调可以改善物理推理,且接口类别比模型规模更重要。任务族和定性分析表明,遮挡追踪与基于接触的实体性提出了不同要求;PWM-WROP 在遮挡任务上表现突出,但在实体性任务上更不稳定,而常见失败涉及表征丢失或因果解耦。自动指标被视为次要指标,因为它们衡量的是参考相似度而非物理正确性。
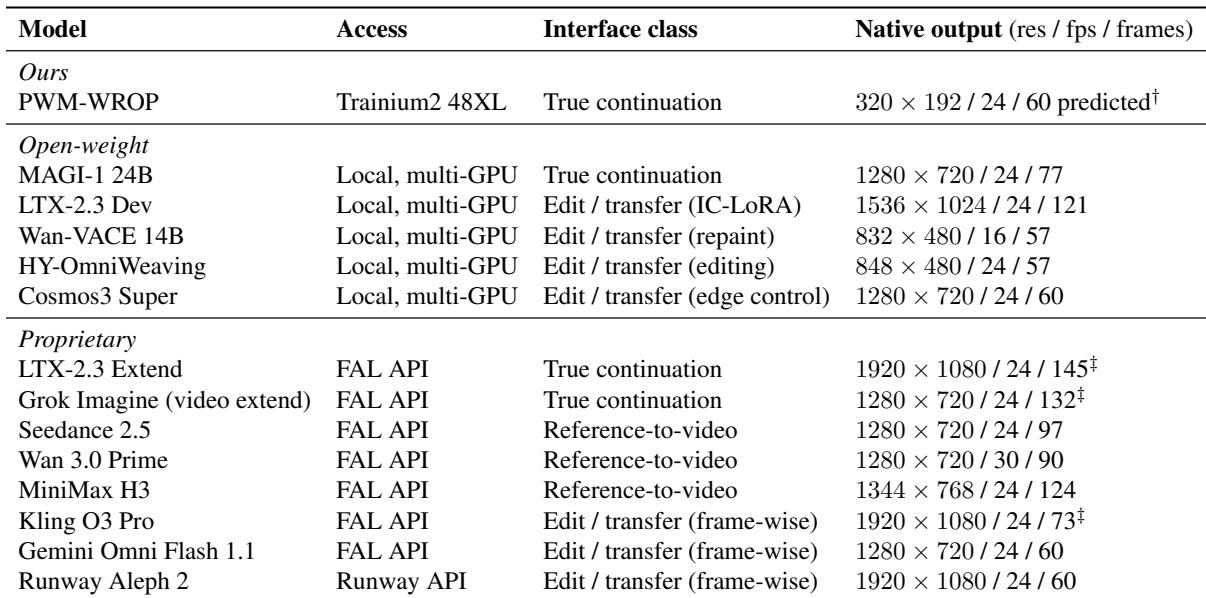
该评估覆盖 14 个视频到视频模型,并按来源、访问途径、接口类别和原生输出几何进行分组。这些系统分为真实续写、参考到视频和编辑/迁移类别,其中开放权重模型在本地运行,专有模型通过托管 API 访问。原生输出分辨率和帧数在整个集合中差异很大,所提出的模型生成的片段分辨率低于若干开放权重替代方案。这 14 个系统分为真实续写、参考到视频和编辑/迁移接口类别,反映了它们与条件片段的不同关系。开放权重模型在多 GPU 硬件上本地运行,而专有模型通过托管 API 访问。真实续写模型包括所提出的 PWM-WROP、MAGI-1、LTX-2.3 Extend 和 Grok Imagine;编辑和迁移模型包括 Wan-VACE、HY-OmniWeaving、带 IC-LoRA 条件的 LTX-2.3 Dev、Cosmos3 Super、Kling O3 Pro、Gemini Omni Flash 和 Runway Aleph 2。所提出的模型输出的空间分辨率片段低于若干开放权重基线,后者的原生分辨率达到远高于此的尺寸。
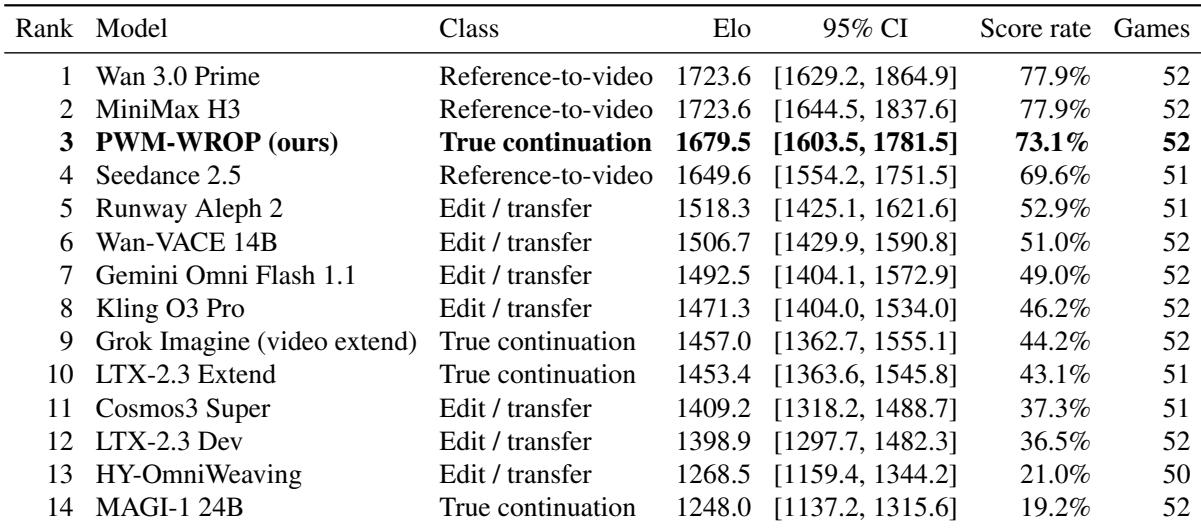
参考到视频模型在人类偏好排名中领先,Wan 3.0 Prime 和 MiniMax H3 并列第一,Seedance 2.5 也位居前列。PWM-WROP 是排名最高的真实续写模型,总排名第三,并明显领先于下一个真实续写系统。编辑和迁移模型集中在排行榜中部,而其余真实续写模型排名较低。参考到视频模型在排行榜中占主导地位,Wan 3.0 Prime 和 MiniMax H3 并列第一,Seedance 2.5 位列第四。PWM-WROP 是表现最好的真实续写模型,总排名第三,并以较大 Elo 差距超过次优的真实续写模型。
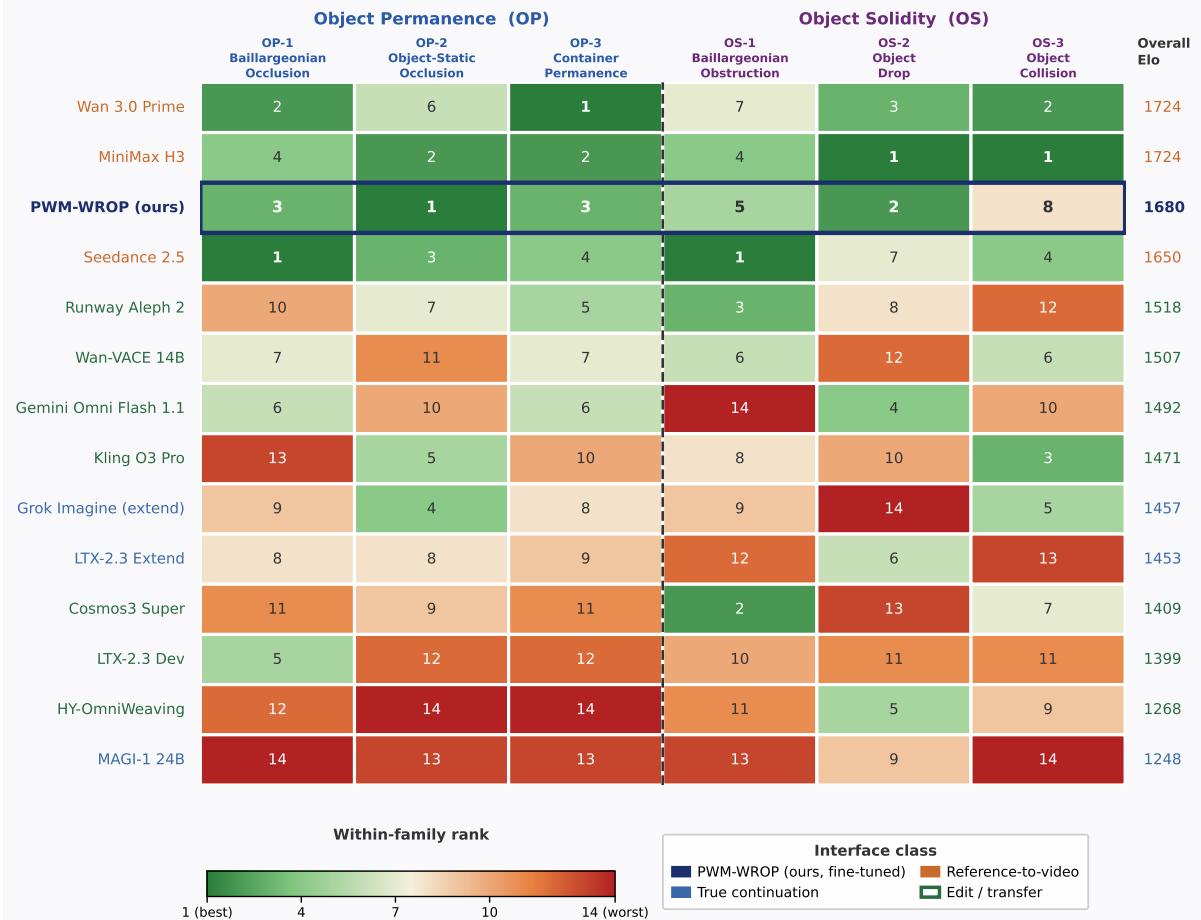
人类偏好排名在六个客体永久性和物体实体性任务族之间差异很大,没有模型在所有任务上一致领先。PWM-WROP 总体属于第一梯队,并在物体静态遮挡和物体下落任务中表现出最强的族级结果,但在物体碰撞上表现相对较差。这种差异与遮挡追踪和阻碍或碰撞推理之间的更大分野一致。没有模型在全部六个任务族中占主导地位;排名靠前的位置在遮挡、阻碍和碰撞任务之间变化。PWM-WROP 在物体静态遮挡和物体下落任务中表现最佳,但在物体碰撞任务中属于较弱模型。MiniMax H3 在各任务族中始终表现强劲,而总排名较低的模型如 Seedance 仍能在个别遮挡和阻碍案例中获胜。
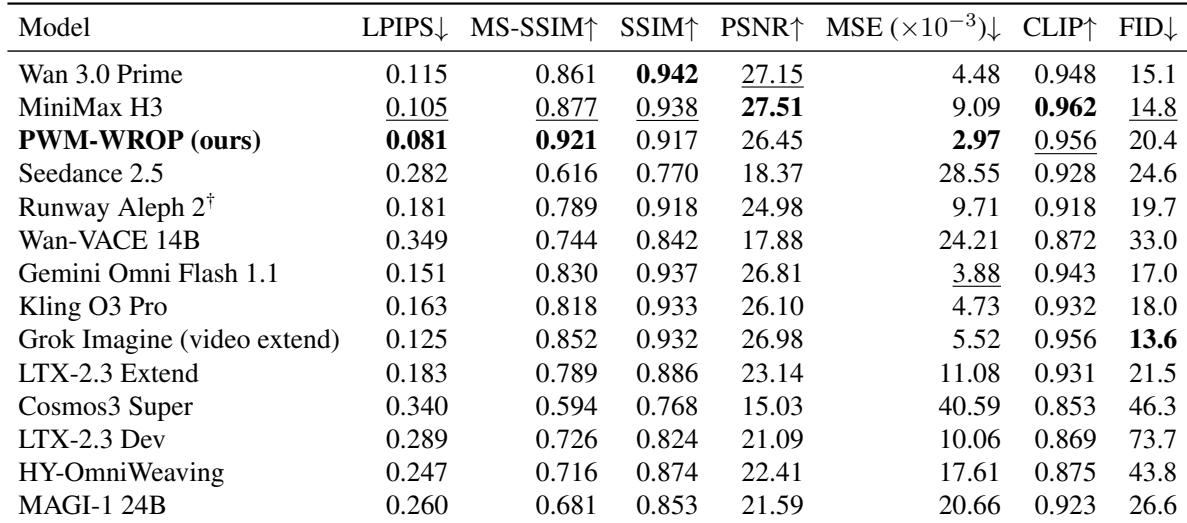
全参考指标显示,PWM-WROP 在感知距离、多尺度结构相似性和像素误差上领先,而 MiniMax H3 在 CLIP 相似度、PSNR 和 FID 上领先。PWM-WROP 的优势在分辨率敏感的指标上减弱,其上采样输出显示出相对较高的 FID。这些指标衡量的是与目标视频的相似性,而非物理推理,因此能够在静态场景外观上复现的模型可能排名靠前,却未描绘出正确的客体永久性。PWM-WROP 在评估模型中取得了最佳的 LPIPS、MS-SSIM、MSE 和最终帧 MSE,并在 CLIP 相似度上排名第二。MiniMax H3 在 CLIP 相似度、PSNR 和 FID 上领先,而编辑或迁移模型可以在未生成必要重新出现的情况下,在结构指标上取得良好分数。
该研究评估了 14 个视频到视频模型,涵盖真实续写、参考到视频和编辑/迁移类别,并将本地开放权重推理和托管 API 访问与人类偏好排名、任务族分解和全参考指标相结合。参考到视频模型在总体人类偏好中领先,而所提出的 PWM-WROP 是最强的真实续写模型,总排名第三,在物体静态遮挡和物体下落上表现良好,但在物体碰撞上相对较差。全参考指标在感知和结构相似性上有利于 PWM-WROP,而 MiniMax H3 在分辨率敏感的指标上领先,尽管这些指标反映的是外观相似性而非物理推理。