Command Palette
Search for a command to run...
Agent-Editing World Model:重新思考面向 LLM 智能体的世界建模
Agent-Editing World Model:重新思考面向 LLM 智能体的世界建模
Shuang Sun Guoxin Chen Fanzhe Meng Jia Deng Huatong Song Jinhao Jiang Wayne Xin Zhao Hongteng Xu Ji-Rong Wen
摘要
大语言模型(LLM)的近期进展使智能体能够在多种环境中处理长时程任务。为了进一步提升智能体表现,现有语言世界模型通常预测环境观测;然而,当可获得真实反馈时,重建高熵且依赖执行的工具响应价值有限。与此同时,智能体面临任务状态污染问题:无依据的假设和过时的计划持续存在于历史中,并扭曲后续决策。我们提出 Agent-Editing World Model(AEWM),它建模的是推理与行动如何塑造未来任务进展,而非模拟工具响应。AEWM 将 Action Judge 和 State Revision 相结合:Action Judge 用于区分 CRITICAL、EXPLORATORY 和 NOISY 决策,State Revision 用于编辑来自同一观测历史的含噪推理-行动延续。EditAct 将这些能力与真实执行集成,直接改变后续决策所依赖的状态,而不仅仅是提供批判性意见。我们在 Search、Terminal 和 Software Engineering 上通过中期训练和监督微调训练 AEWM。AEWM 在我们的 Action Judge 基准上达到 70.5% 的 macro-F1,比最强前沿基线高出 10.6 个百分点。在六个基准和三种智能体主干上,EditAct 的平均得分比最强基线提升 3.2–6.7 个百分点。此外,基于经过验证的 EditAct 轨迹进行拒绝采样微调(称为 AEWM-RFT),在三个领域上比 Self-RFT 提升 2.2–2.6 个百分点,且无需在线 AEWM 指导。
一句话总结
中国人民大学的研究人员提出Agent-Editing World Model(AEWM),该模型建模推理和动作如何塑造未来任务进展,而非模拟工具响应,并结合Action Judge和State Revision对含噪的推理-动作续段进行分类和编辑;其EditAct将这些能力与真实执行集成,在六个基准和三种agent骨干上平均得分提升3.2–6.7分。
核心贡献
-
本文提出Agent-Editing World Model(AEWM),该模型建模推理和动作如何塑造未来任务进展,而非模拟依赖执行的工具响应。AEWM结合Action Judge(用于将决策分类为CRITICAL、EXPLORATORY或NOISY)与State Revision(用于编辑含噪的推理-动作续段),EditAct则将这些能力与真实执行结合,以改变后续决策背后的状态。
-
工作开发了一个跨领域训练框架,利用轨迹合成、中期训练和监督微调,覆盖搜索、终端和软件工程领域。还贡献了一个包含3,000个决策的Action Judge基准以及AEWM-RFT,后者在已验证的EditAct轨迹上执行拒绝采样微调,以在没有在线AEWM指导的情况下迁移决策模式。
-
AEWM在Action Judge基准上达到70.5%的macro-F1,比最强的前沿基线高出10.6分。EditAct在六个基准和三种agent骨干上平均得分提升3.2至6.7分,AEWM-RFT在三个领域上超过Self-RFT 2.2至2.6分。
引言
世界模型被视为通用智能的基础,对于需要理解任务环境并维持连贯决策的长程LLM agent越来越重要。先前的语言世界模型通常遵循以环境为中心的目标,预测以动作为条件的下一状态或工具响应,但在开放式agent任务中,这些观察通常具有高熵且依赖执行,重建它们的价值有限,同时可能产生模拟或虚构的证据。作者识别出一种反复出现的失败模式,称为任务状态污染,即agent接受无依据的假设、保留过时的计划,或将部分进展误认为已完成。为解决这一问题,作者提出Agent-Editing World Model(AEWM),将世界建模从重建观察转向建模决策效果和编辑agent状态。AEWM包含Action Judge,用于将提出的推理-动作对分类为critical、exploratory或noisy,以及State Revision,用于在执行前通过EditAct替换含噪续段,并在搜索、终端和软件工程领域演示了训练和迁移。
数据集
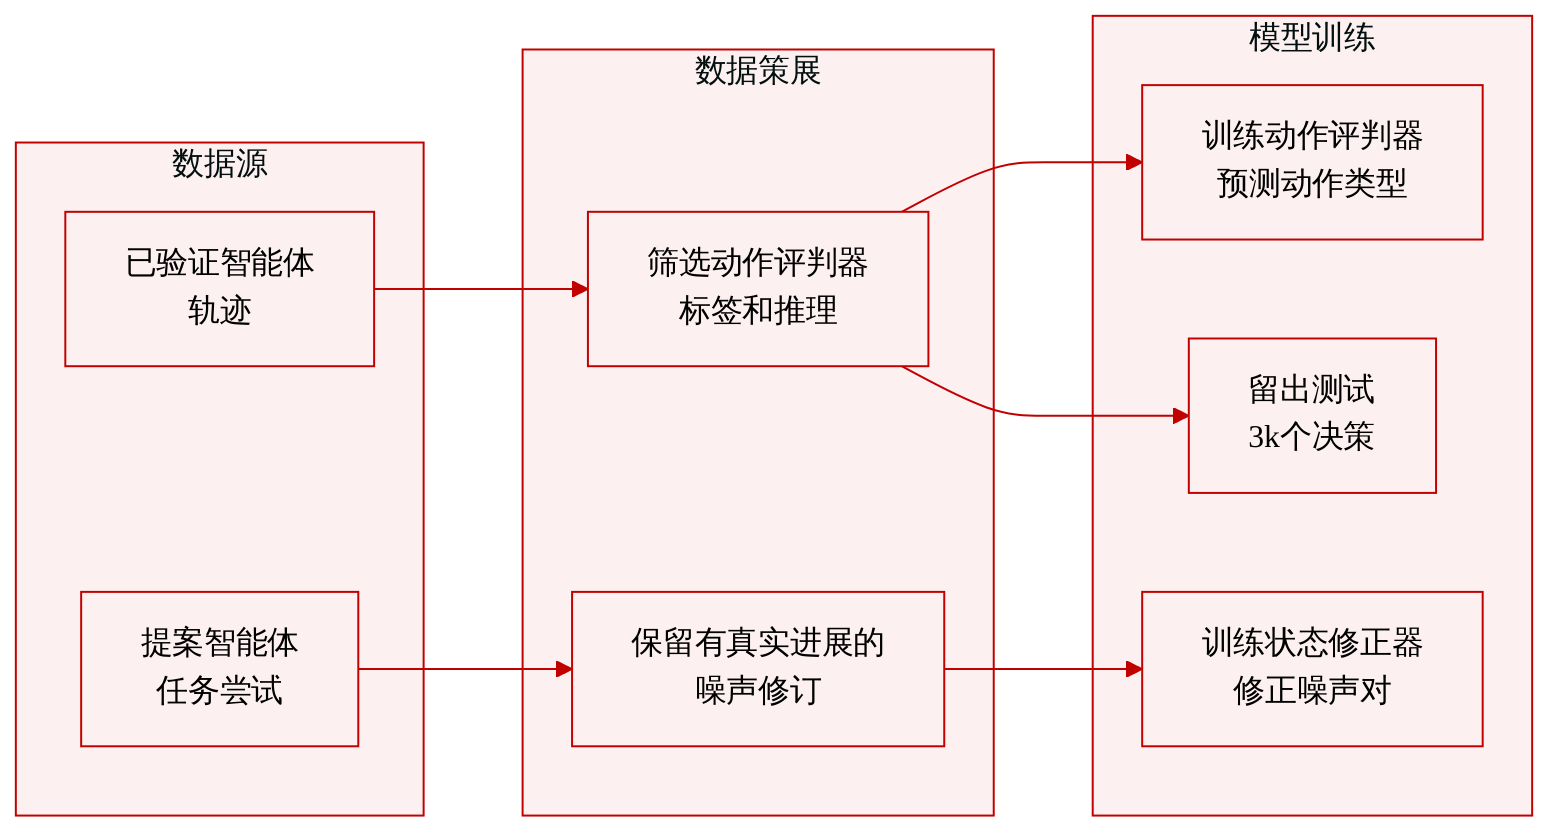
数据集构建自经过验证的agent轨迹,分为Action Judge和State Revision两个组成部分。
Action Judge数据
- 组成:来自成功且经过验证的agent轨迹的轮次级标注。每个示例涵盖单个轮次。
- 标注与schema:一个标注agent根据环境观察及其在后续任务完成中的作用,将每个动作标记为CRITICAL、EXPLORATORY或NOISY。标注agent还撰写前瞻性推理轨迹。输入包含截至第t轮的可见历史以及提出的推理和动作。输出包含回溯性推理轨迹和动作类型。
- 过滤:作者对标签一致性、动作-观察对齐、动作有效性以及仅基于执行前历史进行推理进行过滤。
- 基准:包含3,000个决策的留出集,在搜索、终端和SWE上均匀分布。该基准构建自经过验证的轨迹,经过重复标注、一致性过滤、基于模型的审核和多样性感知采样。准确率和macro-F1是主要评估指标。
- 规模:基准规模为3,000。文本未指定总训练集规模。
State Revision数据
- 组成:由一个提案agent尝试的任务创建,修订由单独的修订agent生成,并由Action Judge检查点评判。
- 过滤:作者仅保留提出的动作被标记为NOISY且修订后的推理-动作对在后续真实环境轨迹中带来实质性进展的样本。
- Schema:输入包含可见历史和含噪的提出推理-动作对。输出包含修订后的推理-动作对。
在模型中的使用
- Action Judge数据训练模型根据执行前上下文预测动作的下游贡献。
- State Revision数据训练模型将含噪的提出推理-动作对修订为改进版本。
- Action Judge基准留出用于评估执行前的动作判断。
方法
作者提出Agent-Editing World Model(AEWM),这是一个旨在缓解长程agent任务中任务状态污染的框架。任务状态污染发生在agent将无依据的假设视为事实或保留过时计划时,从而使错误在交互历史中持续存在并放大。AEWM不预测高熵的环境观察,而是在执行前直接建模和编辑agent的推理与动作状态。
有关AEWM架构、数据合成流程和集成过程的全面概述,请参考框架图。
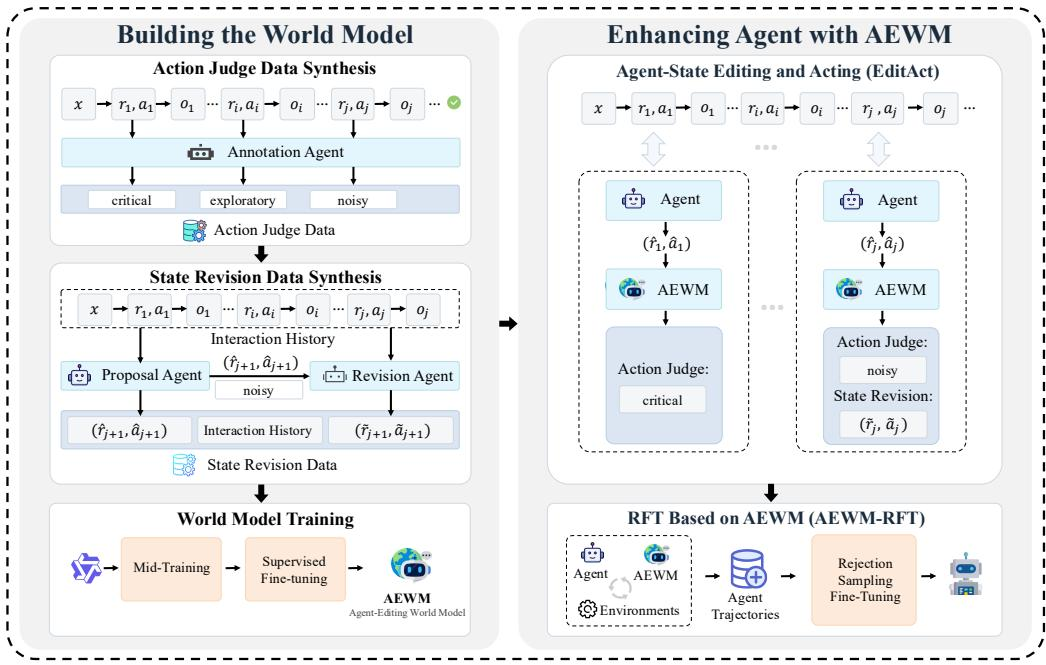
Agent状态建模与编辑 给定任务x,第t步之前的交互历史表示为ht=(x,(ri,ai,oi)i=0t−1)。agent提出一个推理和动作对(r^t,a^t),形成执行前状态st=ht⊕(r^t,a^t)。AEWM(记为M)通过两个主要模块对此状态进行干预:Action Judge和State Revision。
Action Judge模块MAJ评估提出的续段并预测决策效果标签yt∈{critical,exploratory,noisy}。critical决策弥合关键差距或执行必要的状态变更,exploratory决策减少不确定性或测试合理分支,noisy决策几乎不带来进展或助长重复和约束违反。
如果Action Judge将某个提案分类为noisy,State Revision模块MSR会生成修订后的推理和动作对(rt,at),形成编辑后的状态st。这种基于依据的干预不同于传统的观察预测型世界模型:
Conventional WM: observation predictionstMobsotvs.AEWM: agent - state editingstMSRst=ht⊕(rt,at)EditAct:集成状态编辑与执行 在推理过程中,作者通过称为EditAct的流程将AEWM集成到agent循环中。在每一步,Action Judge产生标签yt=MAJ(st)。提交到轨迹的推理和动作对由以下方式决定:
(rt,at)={(r^t,a^t),(rt,at),yt∈{critical, exploratory},yt=noisy.State Revision仅在noisy情况下被调用。选定的动作at随后在真实环境E中执行,产生观察ot∼E(⋅∣ht,at),并将历史更新为ht+1=ht⊕(rt,at,ot)。此循环使得状态编辑能够重定向有问题的决策,同时真实环境观察为后续演化提供依据。
学习并内化Agent编辑 为训练AEWM,作者合成了专门的数据集并采用两阶段训练过程。Action Judge数据通过分解成功的agent轨迹并使用标注agent根据每轮的下游贡献将其标记为critical、exploratory或noisy而创建。State Revision数据通过让提案agent尝试任务来生成;当其含噪提案被修订agent修订并带来实质性进展时,修订后的配对被保留。
统一的AEWM在搜索、终端和SWE领域上进行训练。第一阶段是在约520亿token的语料上进行的中期训练(Mid-Training),将原始轨迹与合成数据结合,使模型学习广泛的任务知识和决策效果判断能力。第二阶段是监督微调(SFT),在精心筛选的120,000个示例上进行,在Action Judge和State Revision任务之间均匀分配,以校准这两种能力。
最后,作者通过基于AEWM的拒绝采样微调(AEWM-RFT)将编辑能力内化到基础agent中。通过在真实环境中运行带EditAct的agent,收集包含AEWM状态修正的高质量轨迹。在这些经过验证的轨迹上微调基础agent,使其能够学习局部状态修正并独立维持任务进展,从而有效内化避免和恢复任务状态污染的能力。
实验
实验在六个基准上使用ReAct和Best@3基线评估EditAct,覆盖搜索、终端和SWE领域,同时单独评估Action Judge和State Revision组件。AEWM在动作判断上优于前沿模型,EditAct在各种模型规模上和分布外基准上均优于基线,AEWM-RFT提供可迁移的监督,提高成功率并通常减少轮次。消融实验表明,学习式干预选择、直接联合推理-动作修订以及完整的中期训练加SFT配方都很重要,而分析表明AEWM通过重新检查证据、验证执行和保留需求来修复任务状态污染。
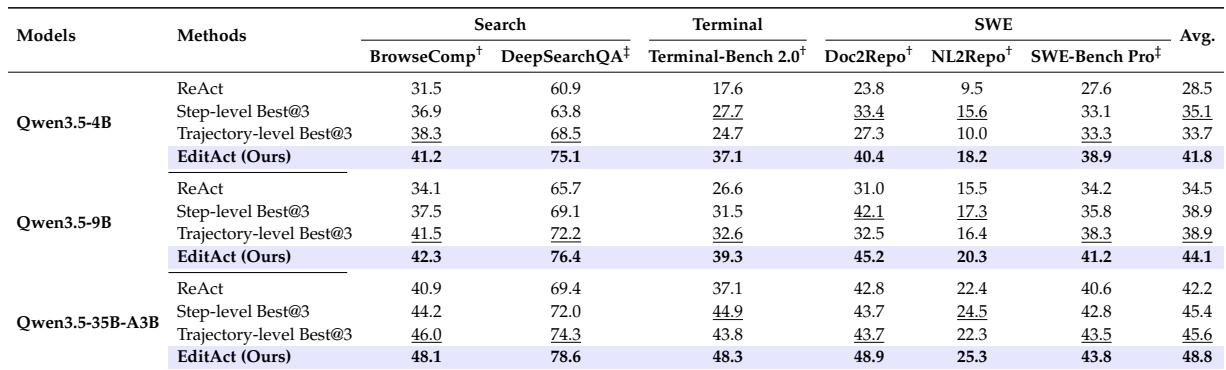
EditAct在各基准和模型规模上均优于ReAct和Best@3基线。增益在分布内和分布外任务上均保持一致,在终端和代码库相关基准上改进尤其显著。使用EditAct的中等规模模型可以超过使用ReAct的更大模型,表明该方法缩小了不同agent规模之间的性能差距。EditAct在每个基准和每个测试模型规模上均优于ReAct和两种Best@3变体。随着模型规模增大,相对于最强基线的平均得分增益有所缩小,但保持为正。与ReAct相比,EditAct产生的平均改进大于相对于最强Best@3基线的改进,使用EditAct的中等规模模型超过使用ReAct的更大模型。改进在分布内和分布外基准上均成立,在Terminal-Bench和Doc2Repo上相对增益更强。
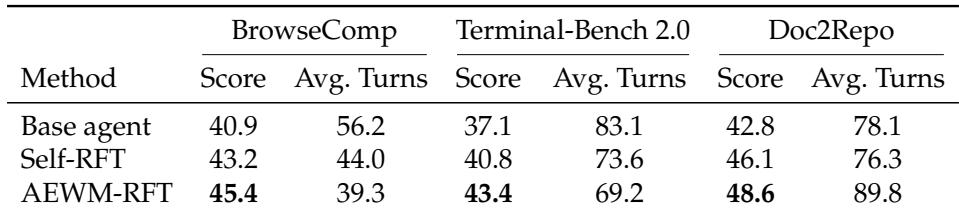
在BrowseComp、Terminal-Bench 2.0和Doc2Repo上,基于AEWM引导轨迹的微调优于基础agent和在其自身轨迹上微调的agent。前两个基准的效率得到改善,得分更高且平均轮次更少,而Doc2Repo在更多轮次下改进。这一模式表明基于EditAct的轨迹提供了超越自生成成功rollout的有用监督。AEWM-RFT在所有三个基准上取得最高得分,超过Self-RFT约两到三分。它在BrowseComp和Terminal-Bench 2.0上减少平均轮次,而Doc2Repo在额外轮次下改进。
带EditAct的完整AEWM设置在BrowseComp、Terminal-Bench 2.0和Doc2Repo上取得最佳得分,优于所有测试的推理干预和训练阶段组合。学习式干预选择和直接状态修订有助于这一优势,因为随机门控、agent重采样、提示引导、单组件编辑和替代世界模型均产生较低得分。中期训练加SFT的完整配方比任一单独阶段更强,在Terminal-Bench 2.0和Doc2Repo上增益最大。带EditAct的完整AEWM在BrowseComp、Terminal-Bench 2.0和Doc2Repo上取得最高得分。随机门控、agent重采样和AEWM提示干预均不如完整方法,支持学习式干预选择和直接编辑优于重采样或类critic引导。仅动作修订和仅推理修订均不如完整EditAct,表明联合推理-动作编辑更有效。使用推理agent作为世界模型不如完整方法,且在Terminal-Bench 2.0上尤其薄弱;DeepSeek-V4-Pro世界模型也不如完整AEWM。中期训练后进行SFT优于任一单独阶段,完整配方在Terminal-Bench 2.0和Doc2Repo上产生更大增益。
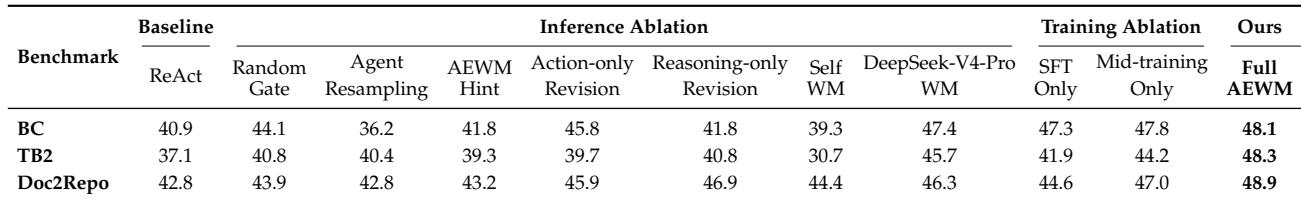
在BrowseComp、Terminal-Bench 2.0和Doc2Repo上,实验在多个模型规模上比较EditAct与ReAct和Best@3基线,然后评估AEWM引导轨迹的微调并对完整AEWM流程进行消融。EditAct在分布内和分布外任务上均持续优于基线,中等规模的EditAct模型可以超过更大规模的ReAct agent。基于AEWM引导轨迹的微调优于自生成的成功rollout,而带联合推理-动作编辑以及中期训练加SFT完整配方的完整AEWM设置取得最佳结果,确认了学习式干预选择和直接状态修订的价值。