Command Palette
Search for a command to run...
即时记忆:学习为 LLM 智能体策展任务自适应记忆
即时记忆:学习为 LLM 智能体策展任务自适应记忆
Yefan Zhou Yang Li Zeyu Leo Liu Semih Yavuz Shafiq Joty
摘要
智能体记忆系统复用过去的经验以提升未来表现,但现有设计大多在写入时策展记忆:任务一旦完成,其轨迹就被蒸馏成一个固定产物,例如反思、工作流、技能或推理策略,并在之后通过相似度被检索。这迫使系统在知晓未来查询之前就决定什么值得记住,不可逆地丢弃信息,并产生一个与查询无关、却必须服务于许多可能下游任务的摘要。学习这样的写入时策展器也很困难,因为一次存储决策的价值可能要到某个相关查询出现时才显现,而这可能在很多任务之后,从而形成长时程信用分配问题。我们改为保留原始轨迹,将策展推迟到读取时,即当前任务已知时进行。给定检索到的轨迹和新任务,记忆策展器合成一个紧凑、任务自适应的载荷,专门针对当前需求。由于该载荷在同一任务上被使用,策展器可以直接根据即时任务成功与否训练,从而避免延迟的效用信号,也无需人为地将相关任务分组。在 ALFWorld、WebShop 和 τ2-bench 上,我们的即时记忆(JITMEM)始终优于无记忆智能体以及启发式和基于学习的写入时记忆方法,在绝对成功率上分别比最强基线高出 16.2、16.3 和 3.9 个百分点。值得注意的是,即使未经训练的策展器也已与这些基线相当甚至超越它们,表明任务自适应的读取时策展本身就是收益的主要来源;训练策展器进一步放大了这种改进。
一句话总结
Salesforce AI Research 提出 Just-in-Time Memory (JITMEM),该方法保留原始轨迹,并把整理延迟到读取时,使记忆整理器能够根据检索到的轨迹和当前任务合成任务自适应载荷,从而支持从即时成功中直接训练;JITMEM 在 ALFWorld、WebShop 和 τ 2-bench 上相较写时记忆基线分别高出 16.2、16.3 和 3.9 个绝对成功率点。
核心贡献
- Just-in-Time Memory (JITMEM) 在写入时保留原始轨迹,将整理推迟到读取时,从检索到的轨迹和当前任务合成紧凑且任务自适应的载荷。
- 这种读取时整理将记忆整理从一个延迟的未来效用信用分配问题转变为即时单步目标,使整理器可以直接从任务成功中训练,而不需要人为分组相关任务。
- 在 ALFWorld、WebShop 和 τ²-bench 上,JITMEM 相较最强基线分别提升 16.2、16.3 和 3.9 个绝对成功率点;即使未训练的整理器也具备竞争力或更优,RL 训练进一步改善有效性、效率以及跨执行器模型的迁移。
引言
大型语言模型 agent 越来越需要解决任务序列,因此复用过去轨迹作为持久记忆变得有价值。以往记忆系统通常在写入时整理经验,在已知未来任务之前就把每条已完成轨迹蒸馏为固定产物;这会导致过早且不可逆的信息损失,并迫使一个抽象服务于许多不同下游查询。作者提出 JITMEM,通过将原始轨迹保留在流式记忆库中,并仅在已知当前任务时使用经 RL 训练的整理器合成任务条件载荷,从而把整理推迟到读取时。这使得信用分配变得即时,并允许同一条已存储轨迹为不同任务产生不同经验;该方法在 ALFWorld、WebShop 和 τ²-bench 上优于写时整理基线。
方法
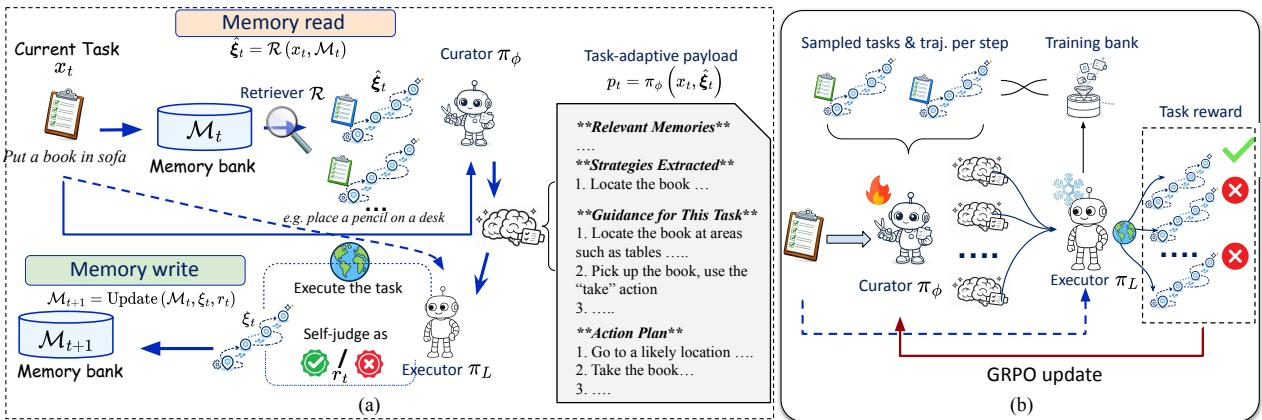
作者提出 JITMEM,一种面向流式任务场景的即时记忆框架,其中 agent 依次解决一系列任务。整体架构由四个核心组件构成:存储原始轨迹的记忆库、检索器、可训练的记忆整理器,以及冻结的 agent 执行器。主要目标是通过将记忆整理推迟到读取时,最大化期望累计任务成功率,确保提取的信息严格面向当前任务。
如下图所示:
在推理阶段,流水线按检索、整理、执行和更新步骤依次运行。记忆库维护完整且未经抽象的轨迹,其中包括任务描述和完整的交错观察-动作序列。通过避免过早总结,系统保留所有原始细节,使整理器能够根据下游查询从同一条轨迹中提取不同经验。由于部署时无法获得任务成功标签,执行器模型充当判断者,控制哪些轨迹被追加到记忆库,从而只保留正样本。
当新任务到来时,检索器使用 BM25 在任务描述上从记忆库中选取最相关的 top-k 条原始轨迹。这些检索到的轨迹被拼接后传给记忆整理器。整理器结合当前任务描述处理检索到的轨迹,合成紧凑的自然语言载荷。该载荷识别相关的过去经验,并针对当前任务提取具体策略。由于载荷生成以当前任务为条件,同一条检索到的轨迹会针对不同查询产生不同的蒸馏结果。
随后,冻结的 agent 执行器接收当前任务和整理后的载荷。载荷被前置到执行器提示中,提供与任务相关的指导,执行器无需直接处理原始轨迹。执行结束后,系统评估所得到的轨迹和奖励,如果轨迹达到质量门槛,则更新记忆库。
为训练记忆整理器,作者使用 Group Relative Policy Optimization (GRPO)。为确保整理器奖励反映载荷质量,而不是可用轨迹的随机性,训练前先通过基础执行器在训练集上运行,并只保留成功轨迹,从而构建固定的训练记忆库。
在每个训练步骤中,采样一个任务,检索器从这个固定记忆库中获取相关轨迹。整理器生成一组 G 个候选载荷。冻结的执行器分别使用每个候选载荷尝试该任务,并返回即时任务奖励,该奖励作为原生评估指标。GRPO 通过从每个单独奖励中减去组内平均奖励来计算组内优势。随后使用以下损失函数更新整理器:
LGRPO=−G1i=1∑GA^i⋅logπϕ(pt(i)∣xt,ξ^t)其中 A^i 表示第 i 个载荷的优势。该设计确保整理器生成载荷与收到奖励之间的时间间隔为零,使信用分配即时化,并消除对延迟回报机制的需求。执行器在整个过程中保持完全冻结,维持模块化,并使训练后的整理器无需重新训练即可服务于多个不同执行器。
实验
在 ALFWorld、WebShop 和 τ²-bench 上的实验比较了读取时记忆整理与无记忆 agent 以及写时记忆基线,使用多个冻结执行器,包括 Qwen3-8B、Gemini-2.5-Pro 和 GPT-5.4。结果表明,在整理器能力匹配的情况下,读取时整理通常优于写时整理;经 RL 训练的读取时整理进一步提升,并能迁移到更强的执行器,同时产生更紧凑的上下文。消融实验验证了任务自适应条件、仅存储成功的原始轨迹,以及将学习到的整理建立在检索经验而非参数化知识之上的重要性。定性分析表明,整理器可以将同一存储经验适配到不同任务需求,并且 RL 训练会诱导出环境特定的程序性指导。
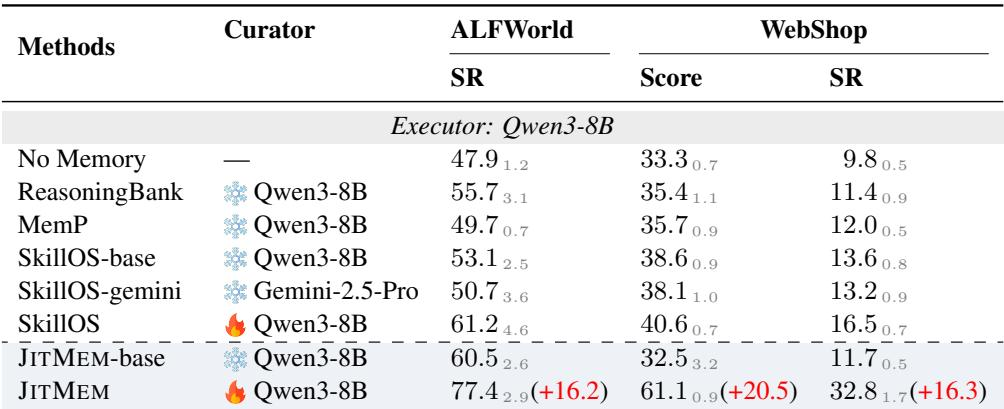
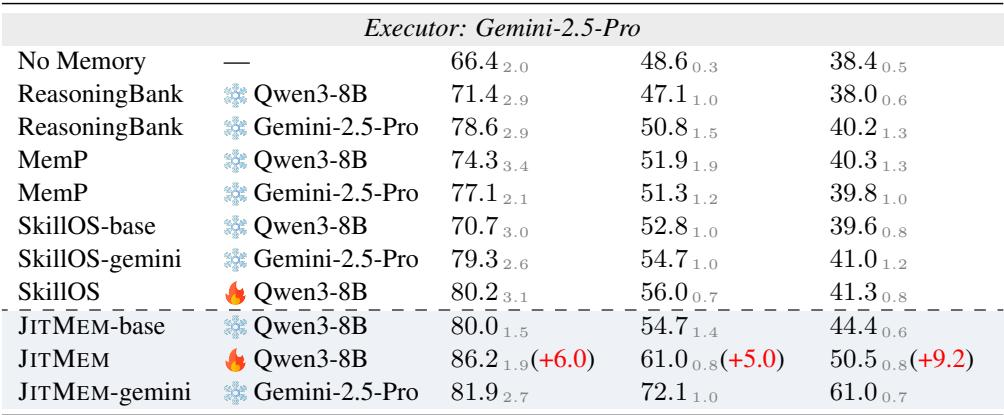
在 ALFWorld 和 WebShop 上,当使用相同整理器时,读取时整理通常优于写时整理,包括在免训练设置下。经 RL 训练的读取时整理相较学习到的写时基线有大幅提升,并且这些提升在更强的执行器下仍然保持。使用一个执行器训练的整理器也能在无需重新训练的情况下迁移到更强的执行器,并优于未训练的读取时变体。免训练的读取时整理在匹配的整理器和执行器选择下,优于免训练的写时基线。经 RL 训练的读取时整理相较学习到的写时整理带来显著提升,并且这一优势在更强的执行器下依然存在。学习到的读取时整理器可跨执行器迁移,无需重新训练即可优于未训练的读取时基线。
在以 GPT-5.4 作为执行器的基准上,读取时整理在相同零样本整理器下始终优于写时整理。这一优势体现在领域级成功率以及宏平均和微平均中,个别领域的提升尤其大。由于该基准不存在标准训练划分,因此只评估免训练变体。在相同零样本整理器下,读取时整理变体相比写时对应方法取得了更高的成功率。提升在个别领域以及宏平均和微平均中均可见,单领域改进尤其显著。
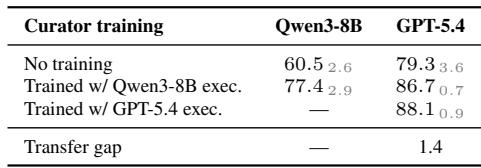
在 ALFWorld 上,以 Qwen3-8B 作为执行器训练的整理器,在 Qwen3-8B 和 GPT-5.4 测试执行器上均比未训练整理器提高了成功率。迁移后的整理器几乎与直接使用 GPT-5.4 训练的整理器相当,差距缩小到 1.4 个 SR 点以内。这表明训练后的整理器学到的是可泛化策略,而不是执行器特定模式。使用 Qwen3-8B 训练整理器提升了 ALFWorld 在较弱和较强执行器上的成功率。迁移后的、由 Qwen3-8B 训练的整理器几乎弥补了与直接使用 GPT-5.4 训练的整理器的差距。单一训练后的整理器可以服务多个执行器,降低部署成本。
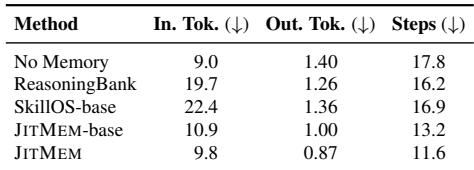
在 GPT-5.4 执行器的 ALFWorld 上,与无记忆相比,记忆方法会增加输入 token,但通常会减少输出 token 和执行步数。JITMEM-base 比 ReasoningBank 或 SkillOS-base 更有效地实现这一权衡:它增加的输入开销少得多,同时仍能减少步数。RL 训练进一步改善相对于 JITMEM-base 的全部三个效率指标。与无记忆相比,JITMEM-base 将执行器步数减少 18.5% 至 21.9%,同时只增加很少的输入 token 开销。RL 训练相较 JITMEM-base 将输入 token 降低 10.1%,输出 token 降低 13.0%,步数降低 12.1%。
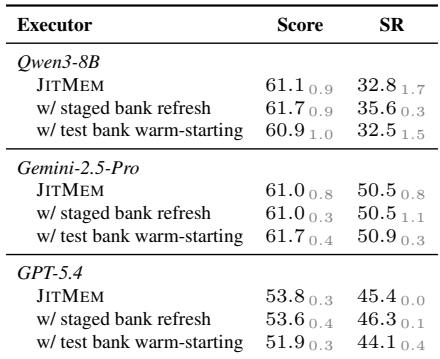
在 WebShop 上,阶段性记忆库刷新只给 Qwen3-8B 带来微弱成功率提升,Gemini-2.5-Pro 没有变化。使用训练样本热启动测试记忆库几乎不改变性能。这些干预相比标准 JITMEM 设置几乎没有额外收益。阶段性记忆库刷新提升了 Qwen3-8B 的成功率,而 Gemini-2.5-Pro 保持不变。测试记忆库热启动对 Qwen3-8B 产生可忽略的变化。静态训练记忆库似乎已经提供了足够的训练信号。
实验在 ALFWorld 和 WebShop 以及 GPT-5.4 更广泛基准上评估了读取时与写时整理,结果表明在匹配的整理器和执行器选择下,读取时整理始终优于写时整理;经 RL 训练的读取时整理器带来进一步提升,并无需重新训练即可跨执行器迁移。ALFWorld 上的其他分析表明,诸如 JITMEM 的记忆方法通过减少执行器步数并以低输入开销改善效率,RL 训练进一步减少输入 token、输出 token 和步数。在 WebShop 上,阶段性记忆库刷新和测试记忆库热启动仅带来微弱变化,说明静态训练记忆库已经提供足够的训练信号。