Command Palette
Search for a command to run...
SPEAKERMEM-R1:面向多方对话的以说话人为中心的双轨记忆
SPEAKERMEM-R1:面向多方对话的以说话人为中心的双轨记忆
Haobo Zheng Tan Tang Yan Chen Weijie Wang Yingcai Wu
摘要
多方环境中的长期对话记忆不仅仅需要从长期对话中检索相关内容:它还必须区分谁说了什么、每句话涉及谁、个体之间如何相互认知、群体共享哪些信息,以及状态如何随时间变化。近期针对多方对话基准的研究表明,现有通用 LLM 记忆系统往往丢失人物关系与群体关系,或难以整合分散在成员、群体和时间中的线索。这些问题共同暴露出两个核心瓶颈:多方对话中的消息归属与关系理解,以及从交织历史中进行状态重建。为同时解决这两个问题,我们提出 SPEAKERMEM-R1:其双轨记忆存储带说话人标注的逐字消息以及按人物级和群体级视图组织的派生状态,并在查询时按实体、事件和时间结合来自两条轨道的证据。为了在结构化记忆构建过程中减少归属和更新错误并支持本地部署,我们使用 SpeakerLevenshtein 和以说话人为条件的 GRPO 训练 Writer-R1。在 Group-MemBench、SocialMemBench 和 EverMemBench 上,SPEAKERMEM-R1 分别取得了 47.9%、69.2% 和 61.9% 的二元准确率。这些分数分别比各基准上评估的主流框架的最佳结果高出 3.3、12.4 和 9.4 个百分点。在 EverMind-AI 公开报告的 EverMemBench 排行榜上,SPEAKERMEM-R1 取得 62.33%,为目前最先进框架中的最佳报告结果。它还在全部 1,986 个 LoCoMo 问题上取得 70.85%;我们将这些问题用作两人长期对话边界测试。在一项包含 305 个问题的受控评估中,在查询/回答流水线冻结的条件下,RL 将 SFT Writer 的平均准确率从 57.38% 提高到 68.20%。我们同时报告二元准确率和 token-F1;消融实验表明,在标准化评估接口下,逐字轨道与结构化轨道以及人物级与群体级视图具有互补性。
一句话总结
浙江大学 CAD&CG 国家重点实验室的研究人员提出 SPEAKERMEM-R1,这是一种双轨记忆系统,存储带说话者标签的逐字消息以及结构化的个人级和群组级状态,使用 SpeakerLevenshtein 和说话者条件化 GRPO 训练,将多方对话记忆基准最多提升 12.4 个百分点,并在 EverMemBench 上达到 62.33%。
核心贡献
- 提出 SPEAKERMEM-R1,一种双轨记忆系统,在个人级和群组级视图中存储带说话者标签的逐字消息与派生状态,然后按实体、事件和时间组合两条轨道的证据,用于多方对话回忆。
- 使用 SpeakerLevenshtein 和说话者条件化 GRPO 训练 Writer 组件,以减少归属和更新错误,同时支持本地部署;在受控的 305 个问题评估中,在冻结查询/答案流水线下,RL 将 SFT Writer 的平均准确率从 57.38% 提升到 68.20%。
- 在 Group-MemBench、SocialMemBench 和 EverMemBench 上报告 47.9%、69.2% 和 61.9% 的二元准确率,分别比各基准上评估的主流框架最佳结果高 3.3、12.4 和 9.4 个百分点;还在 EverMemBench 排行榜上达到 62.33%,为已报告的最新最先进框架中的最佳结果,并在全部 1,986 个 LoCoMo 问题上达到 70.85%。消融实验表明逐字轨道与结构化轨道、个人级视图与群组级视图相互补充。
引言
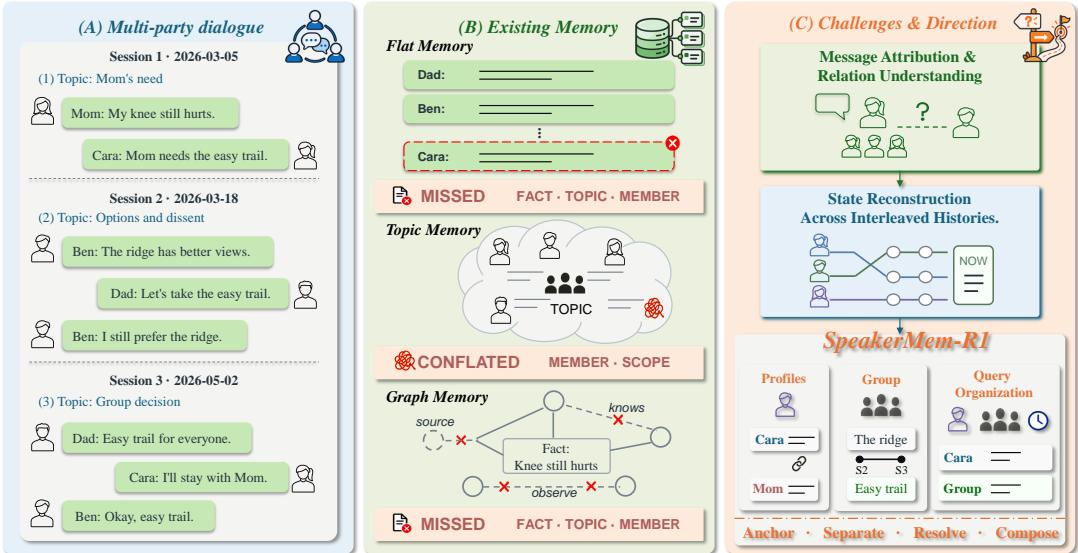
长期对话记忆有助于语言 agent 跨会话保留事实、偏好和社交关系,但大多数先前系统面向单用户或两人历史,并将对话压缩为扁平消息流。多方群聊增加了说话者关系、回复结构、跨话题分支和状态修订,因此通用记忆框架即使在词法检索或稠密检索仍具竞争力时也会退化。核心挑战包括消息归属,例如谁说了什么、信息是共享的还是私人的,以及状态重建,这需要从分布在成员和时间中的线索恢复当前或历史状态。作者提出 SPEAKERMEM-R1,这是一种双轨记忆系统,保留可追溯的带说话者标签的消息以及带来源链接的个人级和群组级结构化视图,然后使用 Anchor-Separate-Resolve-Compose 查询时组织方式,以及本地可部署的 Qwen2.5-3B Writer,该 Writer 使用 SpeakerLevenshtein 和说话者条件化 GRPO 训练,以减少归属和更新错误。
方法
作者提出 SPEAKERMEM-R1,一个设计用于处理多方消息流的系统,通过构建可追溯的双轨记忆并为冻结的回答器检索查询特定证据。给定对话流 D={ut}t=1T,其中每条 utterance ut 包含文本、说话者、时间和频道信息,系统首先将消息写入记忆 M,然后检索证据 Eq 并生成答案 y^。
如下图所示:
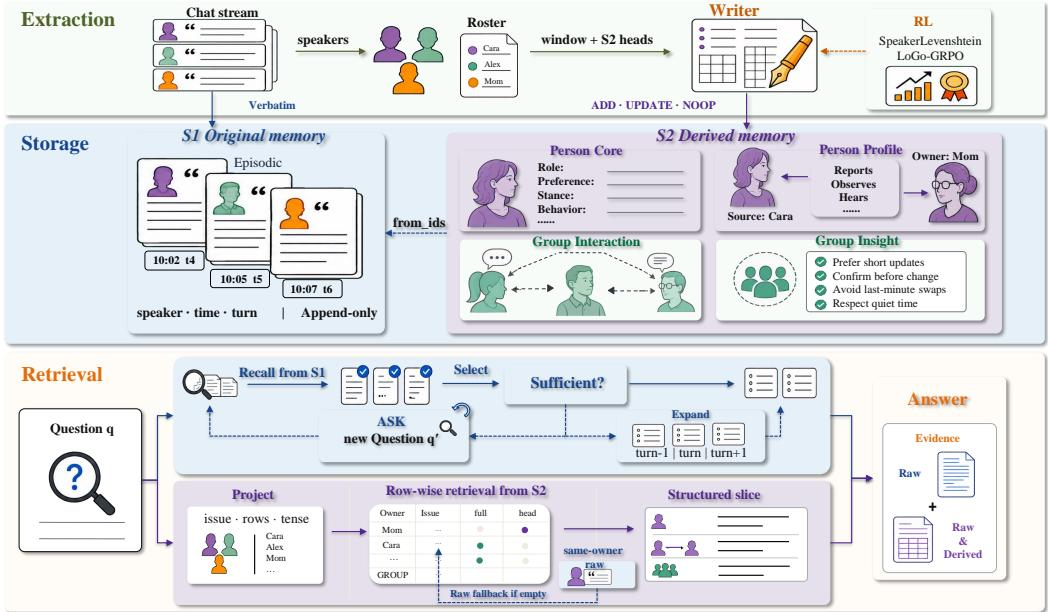
整体架构按提取、存储、检索和回答阶段运行。Writer 是核心组件,负责将局部消息转换为结构化记忆动作,而检索和回答阶段基于得到的记忆进行。
存储模块维护一个五层可追溯的双轨记忆。System 1 是唯一的逐字层,以只追加方式存储每条消息及其精确文本、说话者、时间和频道。System 2 是四层派生结构,包括 PERSON-scoped Core 和 Profile 层,以及 GROUP-scoped Interaction 和 Insight 层。PERSON 层捕获稳定身份、事实、立场和跨人员认知,而 GROUP 层跟踪跨说话者事件、关系和群组规范。每条派生记录表示为一个结构化元组,包含内容、来源、所有者、作用域、事件、时间、状态和来源引用。该设计明确区分信息提供者和内容所涉及的人,并将每条派生记录链接到 System 1 中支持它的消息。
在检索阶段,系统生成以查询为条件的证据。Project 模块将查询和确定性名册编译为通用查询约束,指定目标个人或群组、议题约束、时间模式以及来源-所有者约束。检索沿两条独立路径进行。System 1 检索精确措辞和局部上下文,可选地扩展相邻消息。System 2 扩展相关的 PERSON 或 GROUP 行,并选择匹配议题、关系、事件和时间约束的记录。如果派生行为空,系统回退到对应的逐字消息。最后,Compose 操作按人员、关系和更新链组织来自两条轨道的证据,再传递给冻结的回答器。
为了实现高效的本地部署,作者利用强化学习训练一个小模型,以替代昂贵的基于提示的 Writer。RL 过程训练 Writer 的 ADD、UPDATE 和 NOOP 决策,而 System 1 写入、查询组织和回答保持冻结。训练使用从局部到全局的回报机制。局部结构信号使用 SpeakerLevenshtein 评估所有者级写入错误,该方法将 token 级 F1 与归一化序列匹配率结合,在所有者桶内进行坐标一致的匹配。局部结构势定义为:
ΦSL(M,M⋆)=w1∣P∣1p∈P∑Fp+w2p∈PminFp其中 P 是所有者集合,Fp 是所有者 p 的匹配结果。该宏平均项衡量整体状态,而最差所有者项防止频繁参与者掩盖不频繁参与者。
全局信号衡量 System 1 加 System 2 相对于仅 System 1 的下游 QA 增益。在轨迹 g 上的写入位置 t 处的回报结合有效性、记忆结构和 QA 增益:
rg,t=wvalidRg,tvalid+wmemRg,tmem+Pg,t+wQAγT−1−tRgQA作者对同一网络采样多条轨迹,仅在相同写入位置计算组相对优势,并使用截断 GRPO 更新 Writer。
实验
评估使用 GroupMemBench、SocialMemBench 和 EverMemBench,并以 LoCoMo 作为两人边界测试,将所提系统与检索和记忆基线进行比较。结果表明,双轨记忆方法在各基准上改善了多方问答,消融实验确认每个说话者轨道和群组轨道互补地起作用,并且分层设计很重要。完整的 R1 目标相比监督微调显著改善了小 Writer 模型,但该提升并不能证明广泛的跨领域泛化能力。剩余弱点集中在多跳、开放域、跨证据、偏好和角色归属问题上。
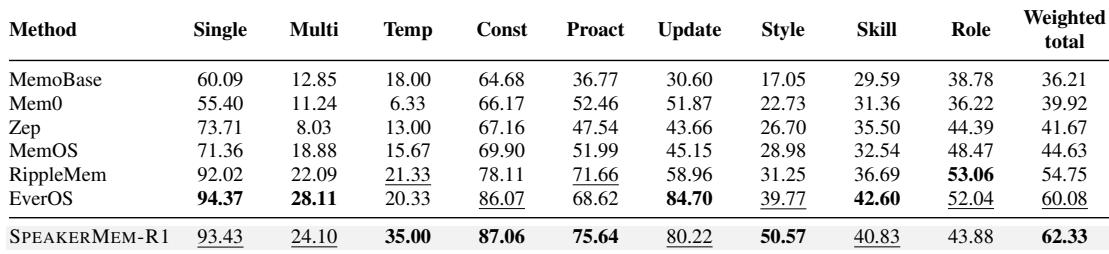
SPEAKERMEM-R1 在已报告的多方记忆基准上取得最佳的非全上下文准确率,相对于顶级主流基线,在 SocialMem 和 EverMem 上相对提升最大。全上下文仅在 SocialMem 上可行,在该基准上此方法几乎匹配全上下文准确率;准确率和 token-F1 并不总是一致,因为重叠答案仍可能因作用域或额外人员错误而被判为无效。所提方法在全部三个基准上优于最强的检索和记忆基线,在 SocialMem 和 EverMem 上提升更大。在 SocialMem 上,该方法接近全上下文准确率,而其他基准无法使用全上下文。
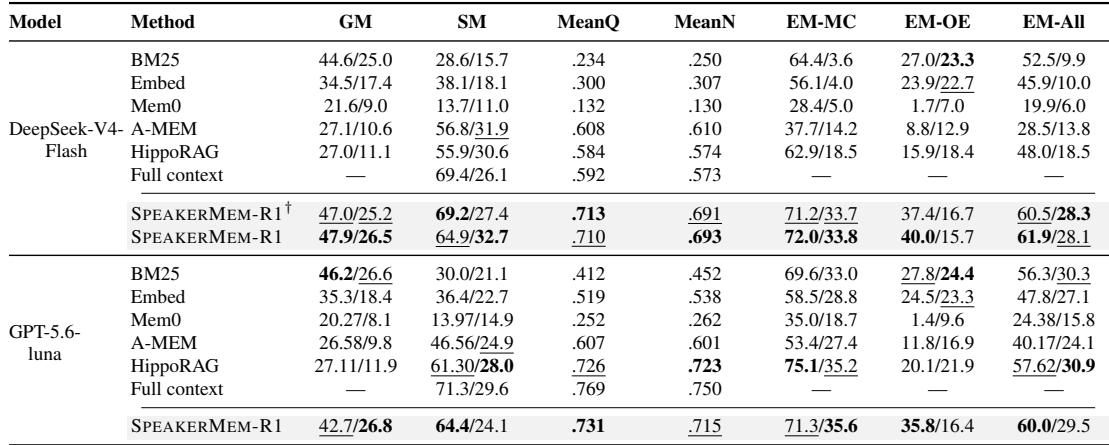
在使用 GPT-4.1-mini 进行回答、Gemini-3-Flash 进行判分的公开 EverMemBench 配置下,SPEAKERMEM-R1 取得最高的问题加权准确率 62.33%,领先于 EverOS 和 RippleMem。其类别级优势包括 single、constraint、proactive、update、temporal 和 style,而 multi、skill 和 role 较弱。EverOS 在若干单独类别上领先,但由于 style 和 temporal 分数较低而在总体上落后。SPEAKERMEM-R1 以 62.33% 的加权总分领先,并且是 temporal、constraint、proactive 和 style 类别中最好的方法。EverOS 拥有最佳的 single、multi、update 和 skill 类别分数,但其较低的 temporal 和 style 结果使其总体排名第二。Multi 是所有方法中得分最低的类别,最佳结果仅为 28.11%。Role 准确率仍然是共同瓶颈,最佳结果来自 RippleMem,刚超过 53%。
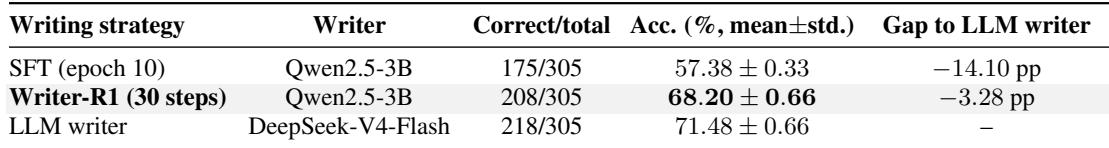
在留出的 SocialMem 网络上,强化学习相比监督微调显著改善了小 Writer。在相同的冻结查询和回答协议下,它缩小了与 LLM Writer 参考之间的大部分准确率差距,尽管参考仍略领先。RL 训练的 Writer 比 SFT Writer 提升约 11 个百分点,并多正确回答 33 个问题。与 LLM Writer 的差距从 SFT 的约 14 个百分点缩小到 RL 训练 Writer 的约 3 个百分点,达到参考准确率的 95% 以上。
在 LoCoMo 非 AD 类别上,LightRAG 和 MemOS 总体领先,其中 LightRAG 在单跳和多跳问题上最强。SPEAKERMEM-R1 在时间类和单跳类别上具有竞争力,但在多跳和开放域问题上排名接近底部,使其非 AD 总体准确率低于前两名方法。多跳和开放域问题仍然是 SPEAKERMEM-R1 的明显弱点。LightRAG 取得最高的非 AD 总体准确率,并在单跳和多跳类别中领先,而 MemOS 是最强的时间类方法,总体排名第二。SPEAKERMEM-R1 在时间类问题上排名第二,但在多跳和开放域问题上属于最弱方法之一,总体准确率低于 LightRAG 和 MemOS。
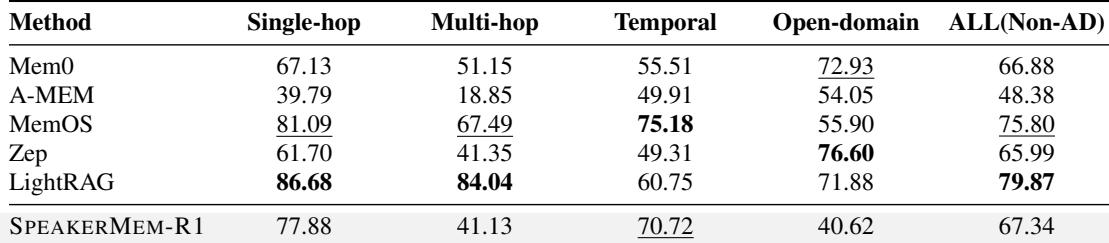
实验在多方记忆基准、EverMemBench 配置、留出 SocialMem 网络上的强化学习 Writer 以及 LoCoMo 非 AD 类别上评估了 SPEAKERMEM-R1。该方法在多方基准上取得最强的非全上下文结果,并在 EverMemBench 总体上领先,尤其在 temporal、constraint、proactive 和 style 类别上表现突出,而 multi 和 role 问题仍然是共同瓶颈。强化学习相比监督微调显著改善了小 Writer,缩小了与 LLM Writer 参考的大部分差距。在 LoCoMo 非 AD 问题上,LightRAG 和 MemOS 总体领先,SPEAKERMEM-R1 在 temporal 查询上具有竞争力,但在多跳和开放域问题上较弱。