Command Palette
Search for a command to run...
有品位的智能体:在长时程任务中度量与提升品味
有品位的智能体:在长时程任务中度量与提升品味
Wenbo Pan Zhichao Liu Shujie Liu Jingying Zeng Chin-Yew Lin Xianfeng Tang Yan Lu Qi He Xiaohua Jia
摘要
LLM 智能体越来越多地从事长时程任务,而它们在此过程中的决策——例如测试哪个假设或基于哪个实现继续构建——决定了整个运行的结果。做好这些决策正成为工程智能体与研究智能体的关键能力。我们将这种做出良好长时程决策的能力称为智能体的品味。现有基准衡量智能体在长时程任务上的端到端成功率,但没有一个衡量智能体的品味。为解决这一问题,我们构建了 Taste-Bench,这是一个从智能体在工程与研究任务中产生的轨迹自动构建的品味问题基准。每个问题呈现一个决策分叉点,即轨迹中多个方向可选且其中一个会带来更好结果的节点;被评估模型需在这些方向中做出选择,而看不到分叉点之后发生的情况。我们从同一任务的并行尝试和单条轨迹内部的绕行中自动挖掘这些分叉点,无需人工标注。我们在 Taste-Bench 上评估了前沿模型,发现最佳模型仅正确回答 59.7% 的问题。我们进一步发现,决定性证据出现在轨迹较后位置的分叉点对所有模型都更难,并且更大的推理预算并不会提高准确率。最后,我们表明品味是可以被训练的。我们将已经看到结果的教师模型的判断蒸馏到学生模型中,学生模型在未见任务上做出更好的决策,并在留出的 SWE-bench Pro 任务上提高了端到端成功率。
一句话总结
来自香港城市大学和微软的研究者提出了 Taste-Bench,这是一个从 agent 轨迹中自动挖掘决策分叉以衡量长期品味的基准。他们发现,前沿模型仅正确回答了 59.7% 的问题,决策证据在轨迹中出现得越靠后的分叉难度大幅上升,而更大的推理预算并不能提升准确率;此外,将结果知情的教师判断蒸馏到学生模型中可以改善决策,并在留存的 SWE-bench Pro 任务上提升端到端成功率。
核心贡献
- 本文将品味形式化为 agent 在决策分叉处选择更优方向的能力,并表明这种能力可以在无需人工标注的情况下,通过现有轨迹的事后信息来衡量。
- 本文构建并发布了 Taste-Bench,一个包含 502 个品味问题的基准,这些问题从软件工程和机器学习研究任务中的并行尝试与绕行轨迹中自动挖掘;最佳前沿模型正确回答了 59.7% 的问题,而决策证据出现得越靠后的分叉难度更高。
- 本文表明,可以将结果知情教师的推理蒸馏到学生模型中,从而训练品味;这能提升在未见任务上的决策质量,并在留存的 SWE-bench Pro 任务上带来端到端收益。
引言
作者研究 LLM agent 中的品味:即做出良好长期决策的能力,这些决策的影响只有在之后才会显现,例如选择研究假设或实现方向。此前的基准衡量端到端任务完成情况,但并未评估中间决策的质量;专家标注成本高昂,且难以跨领域扩展。作者利用现有轨迹中的事后信息,识别尝试发生分叉的决策点,并由后来记录的结果标注更优方向。他们构建了 Taste-Bench,一个包含 502 个此类问题的基准,问题来自软件工程和机器学习研究;他们表明品味可以被自动衡量,并通过蒸馏教师的推理得到改善,这也能在留存的 SWE-bench Pro 任务上带来端到端收益。
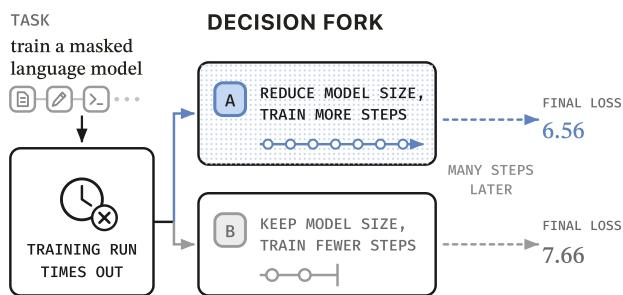
数据集
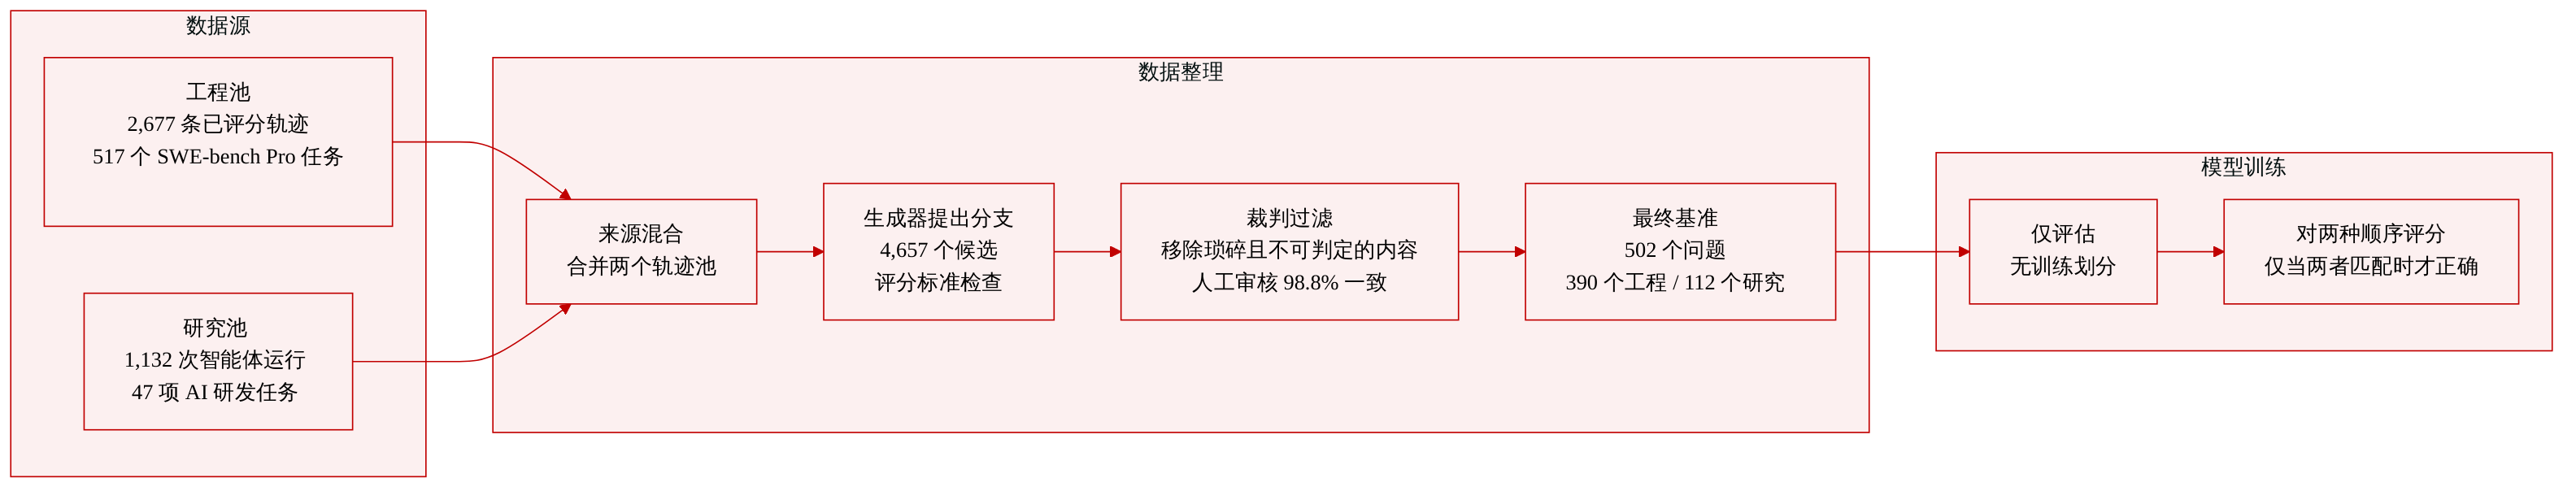
作者提出了 Taste-Bench,一个包含 502 个品味问题的基准,这些问题来源于真实 agent 轨迹。每个问题都通过从非结构化记录中恢复任务、决策分叉前的轨迹前缀、两个候选方向以及标签来构建。
来源与构成
- 该基准使用两类轨迹池:
- 工程池:来自 GPT-5.4 和 GPT-5.5 agent 在 517 个 SWE-bench Pro 任务上的 2,677 条已评分 rollout。
- 研究池:来自 RE-Bench 和 HCAST 研究子集的 47 个 AI 研发任务上的 1,132 次 agent 运行,下载自 MALT,即 METR 的公开轨迹发布。
- 问题由两种互补的分叉类型构建:
- 并行轨迹:同一任务上的一对尝试在相同分叉处发生分歧,并得到相反结果。共享前缀作为问题前缀,两个分歧方向作为候选项,通过测试或达成目标的分支决定标签。
- 绕行轨迹:单个轨迹中 agent 采取错误方向、观察到失败后又自我纠正。被放弃的方向和后来的恢复方向成为候选项。分叉位置设在被放弃方向之前,前缀不得暴露失败或后续修复。
处理与过滤
- 生成模型读取轨迹,提出候选分叉,应用评估标准,并仅保留能够形成有效问题的候选。
- 与生成模型不同的评判模型会移除两类失败问题:
- 平凡问题:每名评判者仅根据两个候选项、无需轨迹就能正确回答。
- 不可判定问题:记录的结果与标签并非明确一致。
- 只有每名评判者在阅读完整任务记录、轨迹和结果后都与标签一致时,问题才会被纳入。
- 生成模型提出 4,657 个候选分叉;10.8% 通过所有过滤,得到 502 个问题。
- 最终基准采用 2 × 2 设计,将构建类型(并行或绕行)与领域(工程或研究)交叉。工程提供 390 个问题,研究提供 112 个。
人工验证
- 在对 100 个抽样问题的审查中,两名审查者先分别选择一个方向,然后在查看记录延续和结果摘要后判断哪个决策更好。
- 在 172 个明确的 A/B 判断中,170 个与挖掘得到的标签一致,一致率为 98.8%。
- 在两名审查者都选择 A 或 B 的 74 个问题上,审查者间一致率为 98.6%,Cohen's κ = 0.973。
使用方式
- Taste-Bench 仅用于评估,不用于训练。没有训练划分或混合比例。
- 每个问题以轨迹前缀和两个候选方向上的二选一决策形式呈现给被评估模型。
- 为降低位置偏差,每个问题评估两次:一次按确定性种子顺序,一次按完全相反顺序。
- 在主要准确率指标中,只有在两种顺序下均回答正确时,该问题才计为正确。本文还报告两种顺序上的平均准确率。
方法
作者将品味视为一种长期判断,所选方向的好处只有在后续工作中才会显现。为在无需专家标注的情况下衡量品味,他们从现有 agent 轨迹中挖掘事后信息。他们识别这样的决策分叉:同一任务上的尝试共享等价前缀,却分化为不同候选方向。这些分支的结果用于估计判断质量。形式上,对于任务 q、轨迹前缀 ht 以及两个候选方向 c1 和 c2,受支持候选基于结果度量 U 标注:
y=argi∈{1,2}maxU(Ei)被评估模型 π 接收问题 x=(q,ht,c1,c2),其品味估计为正确选择的占比。为构建 Taste-Bench 基准,作者从两类轨迹中提取这些分叉:并行轨迹,即 agent 多次尝试同一任务并发生分歧;绕行轨迹,即 agent 在单次运行中自我纠正。
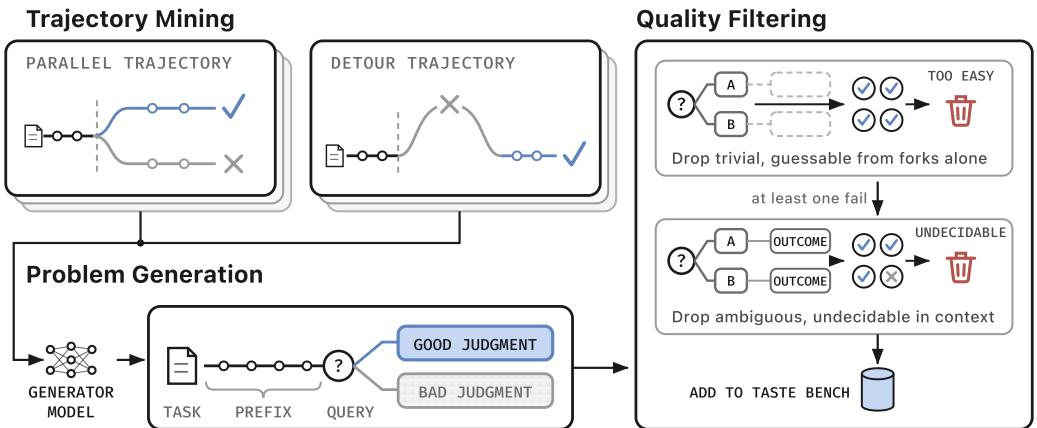
如上图所示,该流程包括轨迹挖掘、问题生成和质量过滤。生成模型读取工程池和研究池中的轨迹,提出候选分叉。在过滤阶段,评判模型移除平凡问题(仅凭候选表述就能猜出答案)和不可判定问题(记录的结果与标签并非明确一致)。这确保每个发布的问题都需要对轨迹上下文进行真实判断。
为改善模型品味,作者利用构建的问题将判断能力蒸馏到基础模型中。训练池由任务不相交的划分组成,以防止数据泄漏。他们不是直接在二值标签上微调,因为那样容易造成记忆,而是蒸馏由特权教师生成的完整推理序列。
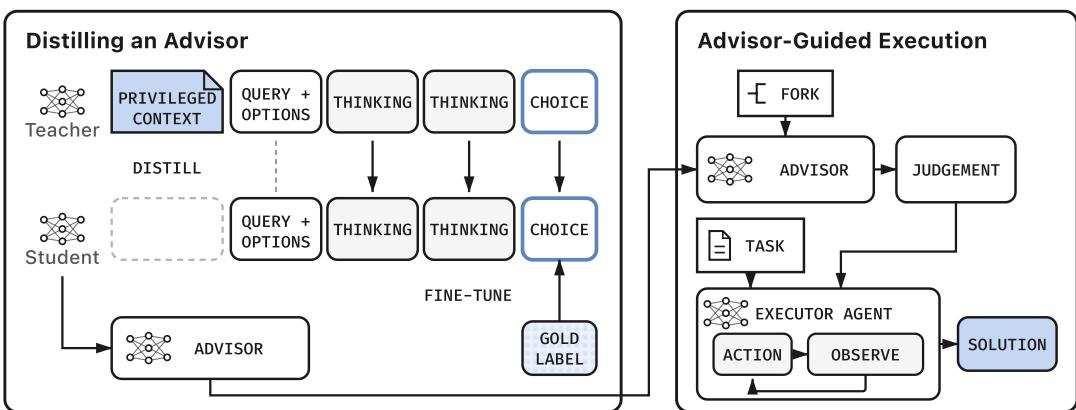
如上图所示,蒸馏过程涉及一个教师模型,它接收问题以及受支持候选的演示。教师生成推理序列和最终选择。学生模型只看到任务、轨迹前缀和打乱顺序的候选项,并被训练以对齐教师生成的 token。损失是在推理 token 和最终选择上计算的 token 级前向 KL 散度。评估时,蒸馏得到的顾问模型在每个分叉处提供判断,这些判断作为建议注入任务上下文,供执行 agent 独立完成任务。
实验
评估使用以两种顺序呈现的二选一品味问题,要求模型在两种顺序下均回答正确,才算正确判断。在 14 个前沿模型中,没有模型接近解决该基准;随着分叉时间跨度的增长,准确率下降;更大的推理预算并未改善品味;与 SWE-bench Verified 的比较仅显示出部分相关性。蒸馏表明品味可以泛化到未见任务,蒸馏学生的建议将下游执行器的成功率从 14.6% 提高到 33.7%,接近使用正确建议时取得的 39.0% 上限。