Command Palette
Search for a command to run...
RULER:面向 SVG 生成的实例感知评分量规奖励
RULER:面向 SVG 生成的实例感知评分量规奖励
Hangyu Ran Yuhao Zheng Yingying Zhang Kevin Qinghong Lin Han Peng
摘要
从自然语言指令生成可缩放矢量图形(SVG)代码是一项开放式任务,缺乏绝对视觉真值,导致评估和策略优化都缺少可靠信号。在自然图像上校准的标量指标(CLIP、Aesthetic)迁移到风格化矢量内容时效果较差,将其复用为 RL 奖励会引发奖励黑客行为。我们通过基于评分量规的评分方法来解决这两个局限性。我们首先通过实验证明,用多轴评分量规提示视觉—语言评判模型时,其与人类判断的相关性远高于标量指标,无论是在样本间还是指令内部。基于这一发现,我们提出 RULER(Instance-aware Rubric Rewards for Reinforcement LEaRning,即面向强化学习的实例感知评分量规奖励),它将每条指令转换为包含六个评分项的实例感知评分量规,涵盖语义、视觉和风格轴;评判 VLM 逐项对渲染出的 rollout 进行评分,加权满意度构成细粒度奖励,并通过 Group Relative Policy Optimization 进行优化。由于评分量规仅由文本推导得出,RULER 既不需要成对的 SVG 真值,也不需要人类偏好标签。在 MMSVG-Illustration 和 MMSVG-Icon 上,RULER 将评分量规得分从 0.432/0.395 提升至 0.693/0.683,超过专用 SVG 专家模型,并匹敌规模大得多的 DeepSeek-V3;消融实验表明,评分量规设计是开放式 SVG 生成强化学习中的关键杠杆。项目主页见 https://hangyuran.github.io/RULER/。
一句话总结
来自蚂蚁集团、香港科技大学(广州)和牛津大学的研究人员提出 RULER,一种实例感知的六项评分细则,覆盖语义、视觉和风格三个轴,由评判 VLM 逐项评分,并用于分组相对策略优化(Group Relative Policy Optimization)。该方法避免了标量指标奖励攻陷和成对标签,将 MMSVG-Illustration 和 MMSVG-Icon 的评分细则分数从 0.432/0.395 提升到 0.693/0.683,超越专用 SVG 专家,并匹敌 DeepSeek-V3。
核心贡献
- 建立了面向 SVG 生成的基于评分细则的评估范式,表明视觉语言评判给出的多轴评分细则分数与人类判断的相关性显著强于标量指标,无论是在样本间还是在指令内部。
- 引入 RULER,对每条指令生成实例感知的六项评分细则,覆盖语义、视觉和风格三个轴,并由评判 VLM 逐项对渲染出的 SVG 评分;加权满意度形成稠密奖励,通过分组相对策略优化进行优化,无需成对 SVG 真值或人类偏好标签。
- 在 MMSVG-Illustration 和 MMSVG-Icon 上,RULER 将评分细则分数从 0.432/0.395 提升到 0.693/0.683,超越专用 SVG 专家,并匹敌更大的 DeepSeek-V3;消融实验确认评分细则设计是开放型 SVG 生成强化学习中起作用的关键因素。
引言
从自然语言生成可缩放矢量图形(Scalable Vector Graphics,SVG)已成为视觉代码生成的重要基准,因为 SVG 是结构化、可执行和可控的,这与描述性文生图输出不同。然而,开放式指令到 SVG 的合成没有唯一的真值渲染,现有标量指标如 CLIPScore、美学分类器和偏好分数大多在写实图像上校准,因此移植到风格化矢量内容时效果不佳,并可能奖励损坏的 SVG 而非更忠实的 SVG。这些不可靠信号也会削弱强化学习,因为策略可能漂向容易膨胀的奖励而不是更好的生成结果。作者首先表明,基于评分细则并由视觉语言评判进行评估,与人类偏好的相关性远强于标量指标;随后引入 RULER,将每条指令转换为实例感知的六项评分细则,覆盖语义一致性、视觉质量和渲染风格,并使用这些评分细则分数作为稠密强化学习奖励,无需成对 SVG 真值或人类标签。
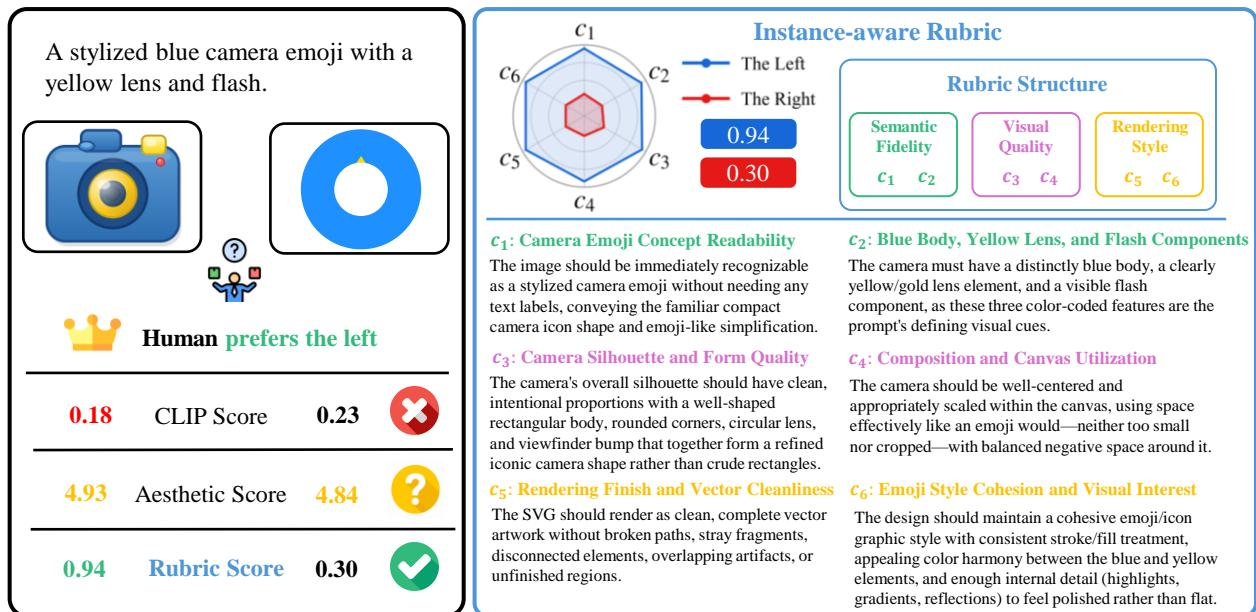
方法
作者将开放式 SVG 生成建模为 token 级马尔可夫决策过程。给定文本指令 Q,语言模型策略 π 自回归地生成结构化 SVG 序列 Y=(y1,…,yT)。在每个步骤 t,状态 st=(Q,y<t) 将指令与已生成前缀结合,动作 at=yt 从策略中采样。确定性渲染引擎 E 随后将完整代码执行成视觉表示 Tgen=E(Y)。由于开放式生成缺乏绝对视觉真值,设计稳健的奖励函数 R(⋅) 是核心挑战。
为了解决这一问题,作者提出 RULER,一个用定制化、实例感知评估标准替代不透明标量指标的框架。整体流程如下图所示。
如下图所示:
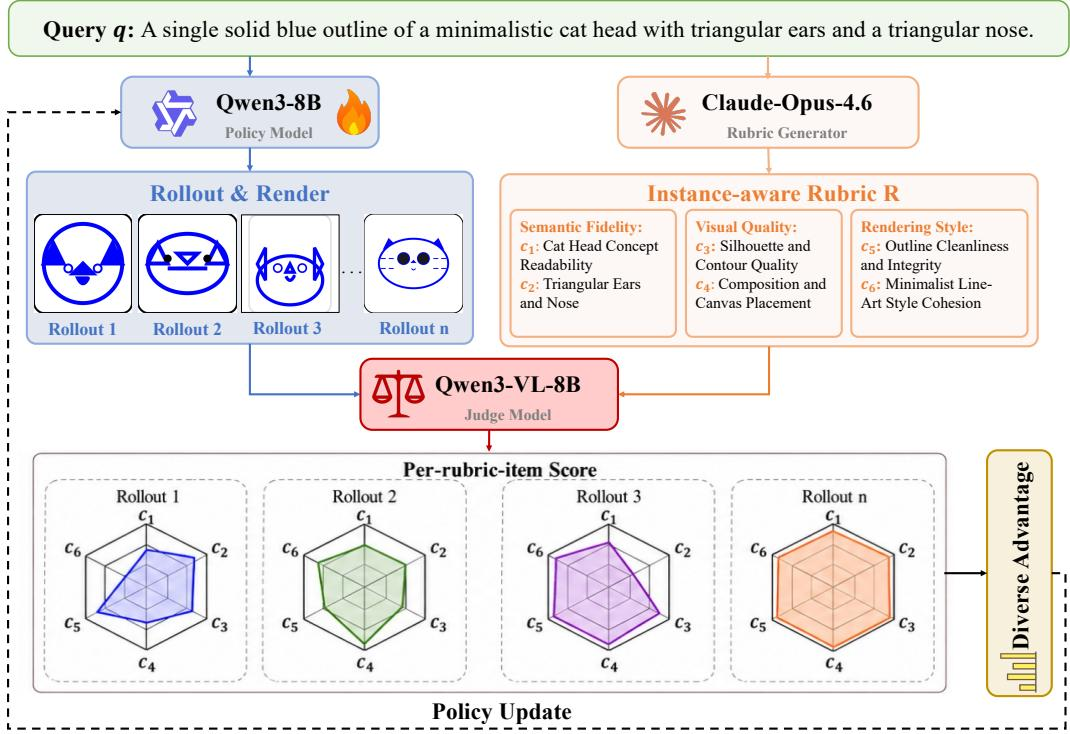
该框架从一个可扩展流程开始,直接从无标注文本指令构建实例感知评分细则。前沿模型 Mrub 被提示生成一个离散评分细则,包含六个项目,沿三个互补轴分组:语义一致性、视觉质量和渲染风格。这些项目在设计意图层面指定,而不是精确像素约束,以保留开放式解空间。评分细则正式定义为 CQ={(ck,wk)}k=16,其中 ck 封装第 k 项的实例感知描述和连续评分指南,wk 是其重要性权重。
在强化学习阶段,策略对给定指令生成多个 SVG 展开。每个渲染图像由评判视觉语言模型 Mjudge 评估。评判不是查询整体分数,而是依照评分细则 CQ 对每个项目 ck 独立评分,产生连续满意度分数 sk。最终奖励计算为归一化加权平均:
R(Igen)=∑k=16wk∑k=16wksk该方法产生稠密、多维的奖励信号。
为优化策略,作者采用分组相对策略优化(Group Relative Policy Optimization,GRPO),该算法自然利用多轴评分细则产生的多样奖励信号。对每条指令 Q,系统从旧策略 πθold 采样 G 个展开 {Yi}i=1G。每个展开都被渲染和评分以获得奖励 Ri。组归一化优势按下式计算:
Ai=std({Rj}j=1G)+ϵRi−mean({Rj}j=1G)模型参数通过最大化截断代理目标来更新:
LGRPO(θ)=EQ[G1i=1∑Gmin(ρiAi,clip(ρi,1−ϵ,1+ϵ)Ai)]其中 ρi=πθ(Yi∣Q)/πθold(Yi∣Q) 是序列级重要性比。通过这一迭代过程,策略被优化以在语义、视觉和风格维度上最大化满意度。
实验
研究在 MMSVG Illustration 和 Icon 基准上评估 RULER,即一种用于开放式 SVG 生成的实例感知评分细则奖励方法,对比扩散式、基础 LLM 和 SVG 专家基线。人类评估首先证实,基于评分细则的打分比 CLIP 或美学指标更符合人类判断。主实验显示 RULER 改善整体质量和人类偏好;奖励设计分析表明实例感知评分细则避免了标量奖励攻陷;消融实验确认所有评分细则轴都有贡献,其中视觉质量影响最大;稳健性在不同基础模型和评分细则生成器上均成立。定性结果进一步显示 RULER 保留了提示特定的细节,并生成更丰富、更连贯的构图。
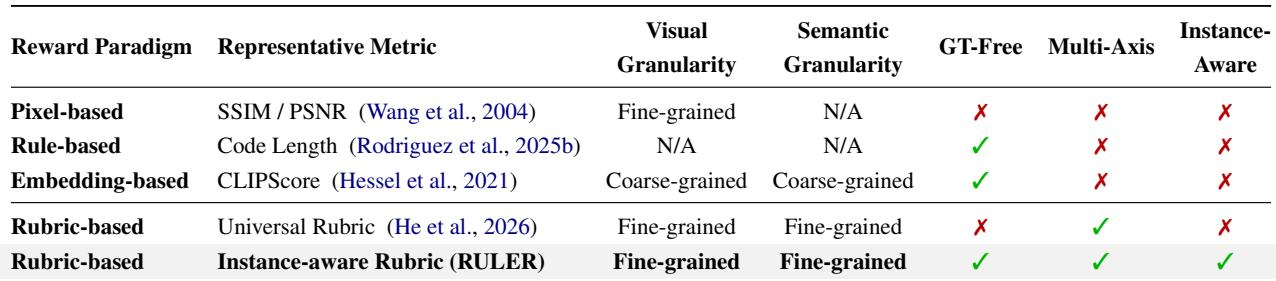
该比较从视觉粒度、语义粒度、无真值操作、多轴反馈和实例感知等方面评估 SVG 生成的奖励范式。现有大多数范式只满足部分要求:基于像素和通用评分细则的方法依赖参考,而基于规则和基于嵌入的方法缺乏细粒度或多轴评估。实例感知评分细则是唯一同时结合细粒度视觉和语义反馈、无真值操作、多轴评分和实例感知的范式。基于像素的奖励如 SSIM 或 PSNR 在视觉上细粒度,但需要真值参考,也不是多轴或实例感知。基于规则的奖励如代码长度不需要真值,但不检查渲染图像,也没有视觉或语义粒度。基于嵌入的奖励如 CLIPScore 无参考,但只是粗粒度,也不是多轴或实例感知。通用评分细则打分提供细粒度多轴反馈,但仍需要真值参考,缺乏实例感知。实例感知评分细则打分为唯一满足全部五项要求的范式,包括细粒度粒度和无真值操作。
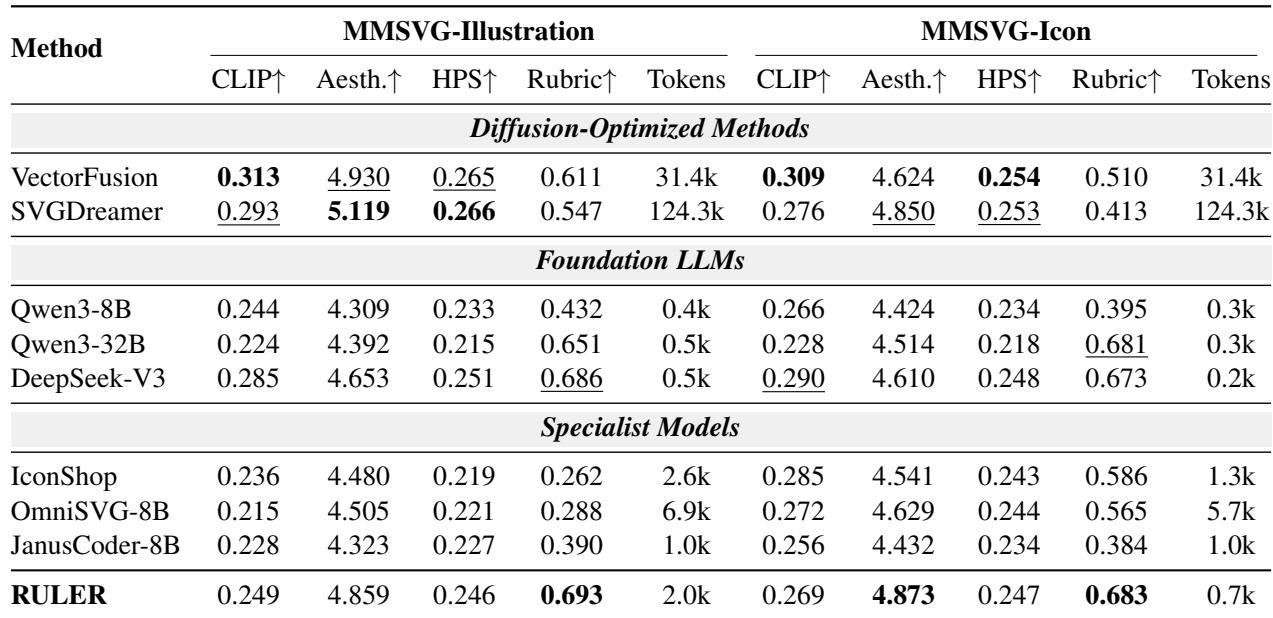
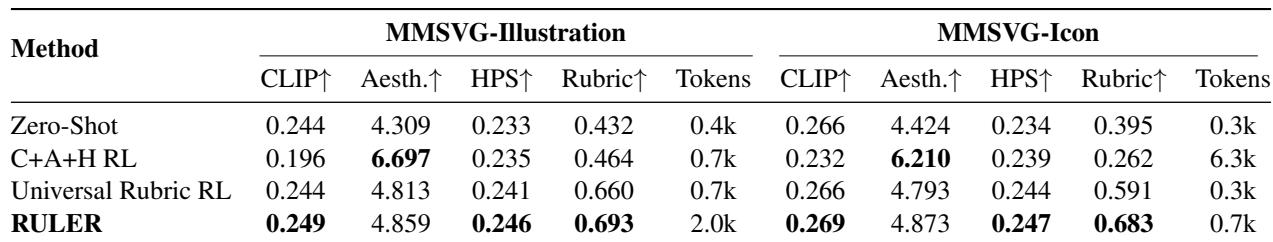
RULER 在两个 MMSVG 基准上取得最佳通用评分细则分数,同时在 CLIP、美学和 HPS 指标上保持竞争力。它优于扩散优化、SVG 专家和基础 LLM 基线,包括其自身骨干,并达到与更大模型相当的视觉质量。它使用的 token 数也远少于基于优化的方法。RULER 在 Illustration 和 Icon 基准上将通用评分细则分数大幅提升,超过专用 SVG 专家及其 Qwen3-8B 骨干。扩散优化基线每个输出需要数万 token,而 RULER 用少得多的 token 实现最高评分细则分数,并在辅助指标上保持竞争力。
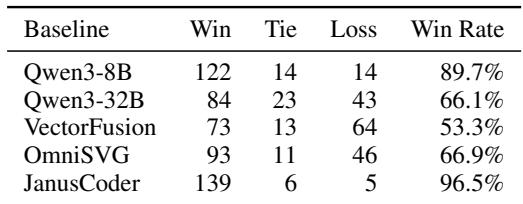
在 MMSVG-Bench 的 150 条提示上进行的盲测成对人类评估中,剔除平局后 RULER 的胜出次数高于所有被评估基线。其非平局胜率在所有比较中均超过 50%,相对 JanusCoder 的优势最大,相对 VectorFusion 的优势最小。这些结果提供了直接的人类证据,表明 RULER 的收益不仅限于自动指标。RULER 对五个基线的非平局胜率均高于 50%。最强的人类偏好出现在对 JanusCoder,最接近的较量是对 VectorFusion。
在两个 MMSVG 基准上,RULER 取得最高评分细则分数,同时相对于零样本基线改善 CLIP、美学和 HPS。通用评分细则 RL 大幅提高评分细则分数,但缺乏提示特定粒度,仍低于 RULER。相比之下,标量 C+A+H 奖励急剧拉高美学分数,同时降低 CLIP 和 Icon 评分细则性能,显示奖励攻陷。RULER 在 Illustration 和 Icon 上取得最佳评分细则分数,并在 CLIP、美学和 HPS 上相对零样本带来均衡提升。通用评分细则 RL 将评分细则分数提高到显著高于零样本和 C+A+H RL,但 Icon 评分细则与 RULER 的差距大于 Illustration 差距。C+A+H RL 以 CLIP 和 Icon 评分细则分数为代价过度优化美学质量,并在 Icon 上 token 数量大幅增加。
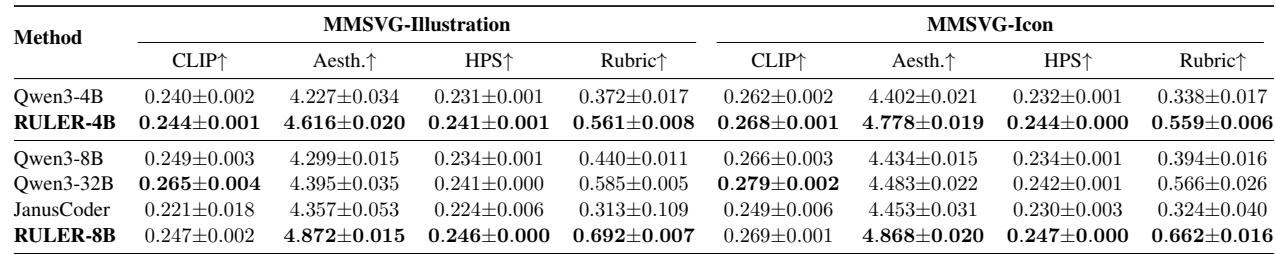
RULER 在 MMSVG illustration 和 icon 任务上相对于其基础模型在 4B 和 8B 规模均有提升。CLIP、美学、HPS 和通用评分细则分数均出现提升,8B 变体在评分细则指标上仍领先于更大的 Qwen3-32B。多次运行显示低标准差,表明跨基础模型规模的稳定改进。RULER-4B 在 Illustration 和 Icon 基准上将通用评分细则分数相对 Qwen3-4B 大幅提升。RULER-8B 尽管参数更少,但在通用评分细则指标上得分高于更大的 Qwen3-32B。相对基础模型的改进在所有报告指标上均一致,包括 CLIP、美学、HPS 和评分细则分数。
实验首先比较 SVG 生成的奖励范式,发现只有实例感知评分细则打分同时满足细粒度视觉和语义反馈、无真值操作、多轴评估和实例感知。RULER 在两个 MMSVG 基准上取得最佳通用评分细则结果,同时在 CLIP、美学和 HPS 指标上保持竞争力,且使用的 token 远少于基于优化的方法。盲测人类评估确认 RULER 优于所有被评估基线,消融研究表明实例感知评分细则强化学习产生均衡的质量提升,而标量奖励过度优化美学并降低其他指标。规模实验进一步显示在 4B 和 8B 规模上的稳定改进,RULER-8B 在评分细则指标上超越更大的 Qwen3-32B。