Command Palette
Search for a command to run...
GameHorizon Suite:游戏玩法中的多时间尺度数据与评估
GameHorizon Suite:游戏玩法中的多时间尺度数据与评估
摘要
现代电子游戏为 AI 模型提供了一个可量化的测试平台,融合了视觉理解、指令分解、目标规划以及跨多个时间尺度的精确动作控制等能力。然而,现有数据集和基准要么覆盖的游戏范围较窄,要么缺乏语言指令,要么依赖高方差的在线 rollout。为应对这些挑战,我们提出了 GameHorizon,一个统一的数据与评估套件,用于衡量不同模型家族在多个时间尺度上的游戏玩法能力。GameHorizon Suite 由三个部分组成。首先,GameHorizon-Annotator 是一个可扩展、自动化的多时间尺度指令标注流水线。其次,利用该流水线,我们构建了 GameHorizon-Data,这是首个大规模 AAA 游戏玩法数据集,包含时间对齐的视频、玩家动作和多时间尺度指令。该数据集包含来自 21 款游戏的 5,000 小时录像,由 100 名人类专家玩家采集。第三,我们构建了 GameHorizon-Bench,提供可复现的离线测试和逐步在线测试。离线评测通过数千个标准化问题实现可复现评估,这些问题被组织为三项主要任务和一系列诊断变体;在线评测则检验离线得分是否反映真实游戏玩法能力,并将失败定位到长时间尺度游戏玩法中的具体步骤。基于我们的 GameHorizon Suite,我们对 47 个模型进行了超过一百万次模型调用评估,揭示了有意义的任务难度层级和显著的模型能力差异。我们的工作可为跨时间尺度和模型家族的游戏玩法能力评估提供标准化标尺。我们将发布数据集、标注器和基准,以促进未来研究。
一句话总结
来自 ARC Lab、腾讯等机构的研究者推出了 GameHorizon,一个统一的游戏数据与评估套件,包括自动化多时间尺度指令标注器、覆盖 21 款游戏的 5000 小时 AAA 数据集,以及可复现的离线基准和分步在线基准;他们评估了 47 个模型,调用超过一百万次,揭示了任务难度层级和能力差异。
核心贡献
- GameHorizon-Annotator 是一个可扩展的自动化标注流程,生成覆盖短时间尺度操作、中等时间尺度目标和长时间尺度策略的密集指令金字塔。
- GameHorizon-Data 是一个大规模 AAA 游戏数据集,包含时间对齐的视频、玩家操作和多时间尺度指令,包含由 100 位人类专家玩家采集的 21 款游戏共 5000 小时录像。
- GameHorizon-Bench 将可复现的离线评估与分步在线测试相结合;离线赛道包含覆盖三项主要任务和一系列诊断变体的数千个标准化问题,在线赛道检查离线分数是否反映真实游戏能力,并将失败定位到具体步骤。通过超过一百万次模型调用对 47 个模型进行评估,揭示了任务难度层级和模型能力差异。
引言
作者研究现代 AAA 游戏中的 AI 玩法,其中单一原始动作流必须同时支撑短期操作、中期目标和长期策略。以往工作存在两方面局限:专用游戏 agent 偏重高频动作控制,但缺乏规划能力;通用视觉语言模型能够规划,但缺乏标准化动作评估;现有数据集还存在游戏覆盖范围窄、指令标注稀疏、在线推演可信度低的问题。作者提出 GameHorizon,一个统一的数据与评估套件,组合了自动多时间尺度指令标注器、跨 21 款 AAA 游戏的对齐视频、动作和指令三元组大规模数据集,以及可复现的离线基准和分步在线基准,用于比较不同模型家族。
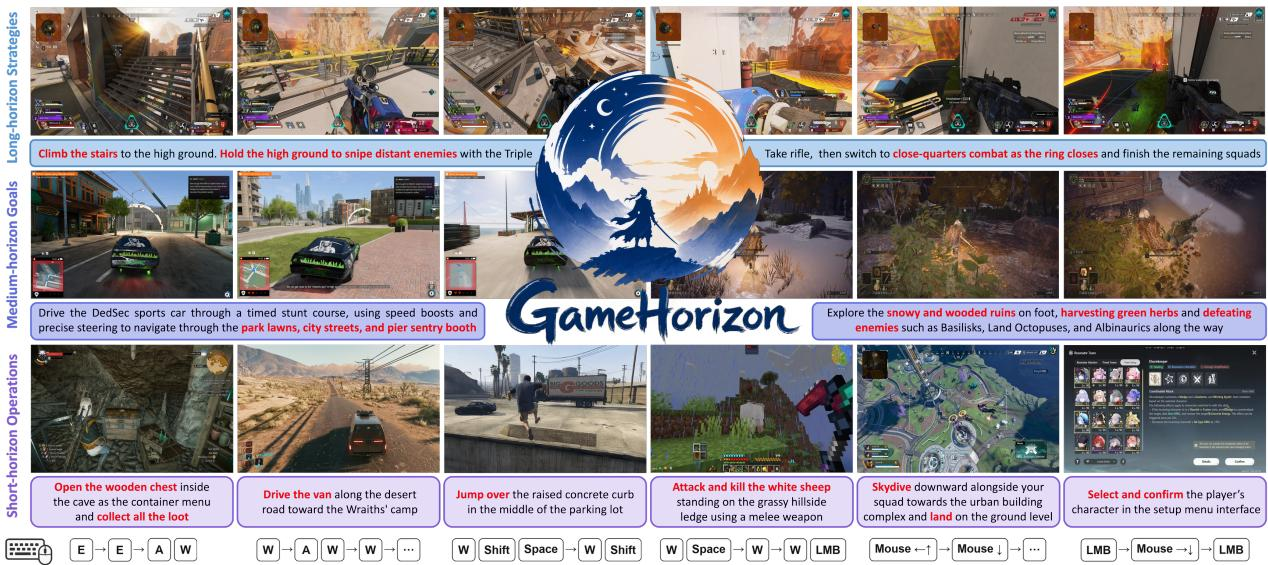
数据集
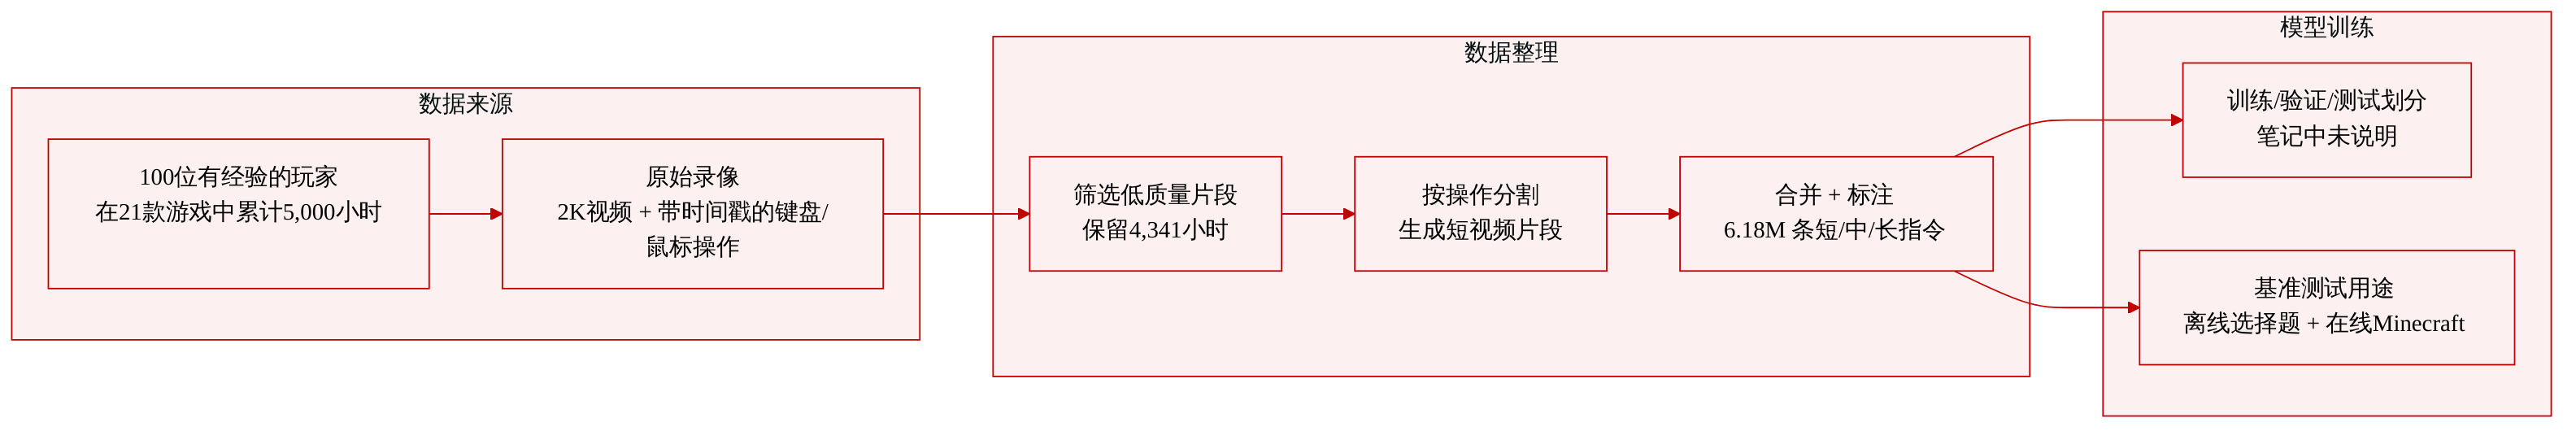
数据集构成与来源
- 作者提出 GameHorizon Suite,由 GameHorizon-Annotator、GameHorizon-Data 和 GameHorizon-Bench 组成。
- 原始游戏过程采集自 100 位有经验的人类玩家,使用专用的录制和上传系统。
- 录像包含 2K 视频和带时间戳的键鼠操作,避免了来自逆动力学模型或手柄分割的伪标签。
- GameHorizon-Data 被描述为第一个将视频、玩家操作和多时间尺度指令对齐的大规模 AAA 游戏数据集。
规模与子集细节
- 语料库覆盖 21 款游戏的 5000 小时人类游戏过程,涵盖开放世界、动作角色扮演、竞技射击、沙盒生存和生物收集冒险等类型。
- Valorant 是时长最大的游戏,为 617.5 小时,占 12.35%;Honor of Kings: World 最小,为 35.9 小时,占 0.72%。
- 低质量或信息不足的录像通过自动规则和 VLM 评估进行过滤。示例包括长时间无操作的过场动画和切换离开游戏窗口。
- 过滤后,保留 4341 小时(86.8%)用于指令标注。所有 5000 小时仍保留同步的键鼠操作。
- 保留数据包含 4571 段以 60 fps 录制的视频,以及 4.1103 亿个键鼠操作事件。
- 动作标注平均为每秒 22.84 个事件,包括以 20 Hz 采样的鼠标输入和平均每秒 2.84 个键盘事件。
- 按时间尺度的指令数量:
- 短时间尺度操作,L1:5,947,588 条指令,平均跨度为 2.63 秒。
- 中等时间尺度目标,L2:189,158 条指令,平均跨度为 82.6 秒。
- 长时间尺度策略,L3:47,290 条指令,平均跨度为 330.4 秒。
- 每一帧都与三个时间尺度的指令对齐,形成密集的多时间尺度指令金字塔。
处理流程
- 标注流程自底向上工作,因为 VLM 难以在超长视频中解析细粒度视觉和动作细节。
- 动作感知视频分割将原始键鼠事件映射到游戏特定的动作语义,将持续事件中的连续动作分组,使用跳跃或攻击等离散动作作为初始边界,并使用 VLM 消解输入语义歧义并细化短片段。
- 自底向上的时间合并将相邻 L1 片段融合为 L2 片段,将相邻 L2 片段融合为 L3 片段。
- 动态规划步骤强制时长范围:L1 为 1 到 5 秒,L2 为 1 到 2 分钟,L3 为 5 到 8 分钟。
- 多时间尺度指令标注使用针对各级别的 VLM 提示:
- L1 使用采样帧和对齐动作生成以动作为基础的操作,细节包括坐标、物体描述和空间关系。
- L2 使用帧、动作和组成它的 L1 指令生成中等时间尺度目标。
- L3 使用帧和组成它的 L2 指令,不使用动作轨迹,生成高层策略。
- 提示包含游戏名称、片段时长、帧率、采样帧索引,以及 L1 和 L2 的游戏特定按键绑定。
- 提供文本中未描述空间裁剪策略;处理聚焦于时间分割、合并和指令标注。
数据使用方式
- GameHorizon-Data 用于构建 GameHorizon-Bench,以进行可复现的离线评估和分步在线评估。
- 离线赛道从对齐帧、指令和玩家操作构建标准化多选题。
- 离线任务包括:
- 基于帧和 L1 指令的单时间尺度动作选择。
- 从 L2 目标到有序 L1 操作的多时间尺度分解。
- 跨 L3、L2、L1 和动作序列的跨时间尺度一致性。
- 变体任务比较不同设置,例如仅帧、帧加短指令、帧加多时间尺度指令、自顶向下分解与自底向上抽象,以及仅指令与指令加动作选项。
- 在线赛道包含 10 个因果任务和 10 个主题任务,共 62 个短时间尺度子任务。它使用分步重置,使失败可以定位到具体步骤。
- 在线赛道在 Minecraft 中实现,因为大多数 AAA 游戏的底层游戏状态不可访问。
- 所提供的章节未指定训练划分或数据集混合比例;所述用途聚焦于评估和基准构建。
方法
作者提出 GameHorizon Suite,一个用于在复杂游戏环境中评估和训练 agent 的综合框架。如框架图所示,该套件包含三个集成组件:GameHorizon-Annotator、GameHorizon-Data 和 GameHorizon-Bench。
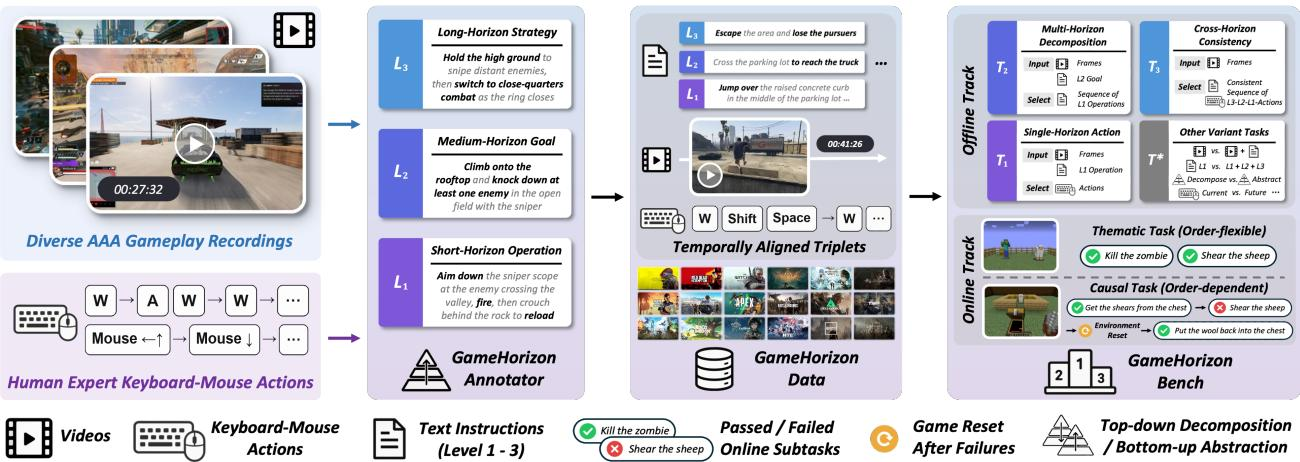
工作流从高保真数据采集开始。为克服来自逆动力学模型或手柄分割的伪标签的局限性,作者招募了 100 位有经验的人类玩家。专用录制系统同步采集 2K 分辨率游戏视频以及带时间戳的键盘和鼠标操作。这些真实数据为后续标注和评估流程奠定了基础。
方法的核心是 GameHorizon-Annotator,它构建三层文本指令金字塔:短时间尺度操作(L1,1 到 5 秒)、中等时间尺度目标(L2,1 到 2 分钟)和长时间尺度策略(L3,5 到 8 分钟)。
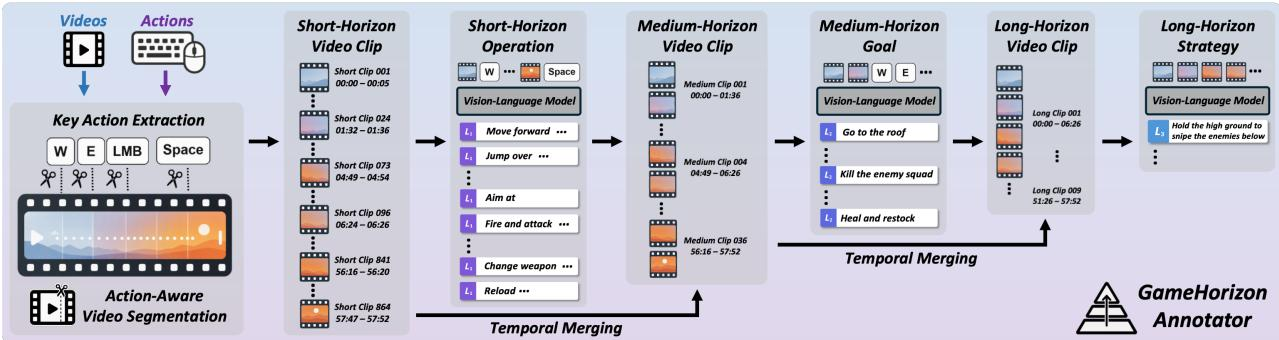
标注流程自底向上运行,经过三个不同阶段:动作感知分割、时间合并和指令生成。
首先,作者采用动作感知视频分割,将长时间游戏会话划分为易于处理的片段。与仅依赖视觉的分割工具不同,后者在摄像机快速移动时可能过度分割,该方法利用键鼠轨迹识别关键动作转换。原始输入被映射到游戏特定语义(例如将“Shift”键映射为冲刺)。离散动作定义初始边界,并采用视觉语言模型(VLM)消解上下文相关输入的歧义,例如区分左键点击是攻击还是选择物品。
接下来,系统执行自底向上的时间合并。VLM 判断相邻 L1 片段是否构成朝向中等时间尺度目标的连续进展,并类似地将 L2 片段合并为 L3 策略。动态规划算法对每个级别施加特定时长约束,以确保片段保持在当前模型推理能力范围内,同时避免原始动作碎片化。
最后,多时间尺度指令标注使用针对每个级别的特定提示进行。对于 L1 片段,VLM 接收视频帧和对齐动作,以生成详细的、以动作为基础的指令。对于 L2 片段,输入包含帧、动作和组成它的 L1 指令,以合成中等时间尺度目标。对于 L3 片段,VLM 使用帧和 L2 指令(省略底层动作)生成高层策略。这种分层方法确保指令以实际玩家控制为基础,同时为长期规划进行适当抽象。
应用该标注器得到 GameHorizon-Data,一个在 21 款 AAA 游戏中对齐视频、动作和多时间尺度指令的大规模数据集。利用该数据,作者提出 GameHorizon-Bench,其包含两条评估赛道。离线赛道使用数千道多选题测试单时间尺度动作、多时间尺度分解和跨时间尺度一致性。在线赛道通过因果(顺序相关)和主题(顺序灵活)场景中的可验证子任务评估长时间尺度游戏过程。关键的是,在线协议在失败时将环境重置到上一个成功状态,从而实现分步错误定位和可复现评估。
实验
该研究使用包含 5000 道题的离线基准评估五类共 47 个模型,然后抽样 12 个模型进入包含短时间尺度子任务和长时间尺度任务的分步在线赛道。离线主实验验证了基准的区分性和难度梯度,表明闭源 VLM 和编程 agent 表现强劲,统一多模态模型、GUI agent 和专用游戏 agent 的迁移较弱,并且只有具备可靠思考能力的模型才获得推理增益。变体实验确认,当前动作感知比未来动作规划更容易,文本指令和多时间尺度指令改善目标理解,关键瓶颈是自顶向下分解,而不是动作解码。在线结果与离线排名一致,并表明长时间尺度游戏过程仍然困难,而分步重置支持细粒度失败诊断。
GameHorizon-Data 包含 21 款游戏共 5000 小时人类游戏过程,过滤后保留 4341 小时有效数据,有效率为 86.8%。语料库同时提供直接人类操作和多时间尺度指令,时长占比最大的游戏为 Valorant、Minecraft 和 Grand Theft Auto V。指令跨度在不同时间尺度之间急剧增加,从短时间尺度指令的几秒增长到长时间尺度指令的约五分钟。按录像时长计,Valorant 是最大来源,Honor of Kings: World 在 21 款游戏中最小。质量过滤保留了大部分数据,在所报告游戏中,长时间尺度指令平均跨度约为五到五分半钟。
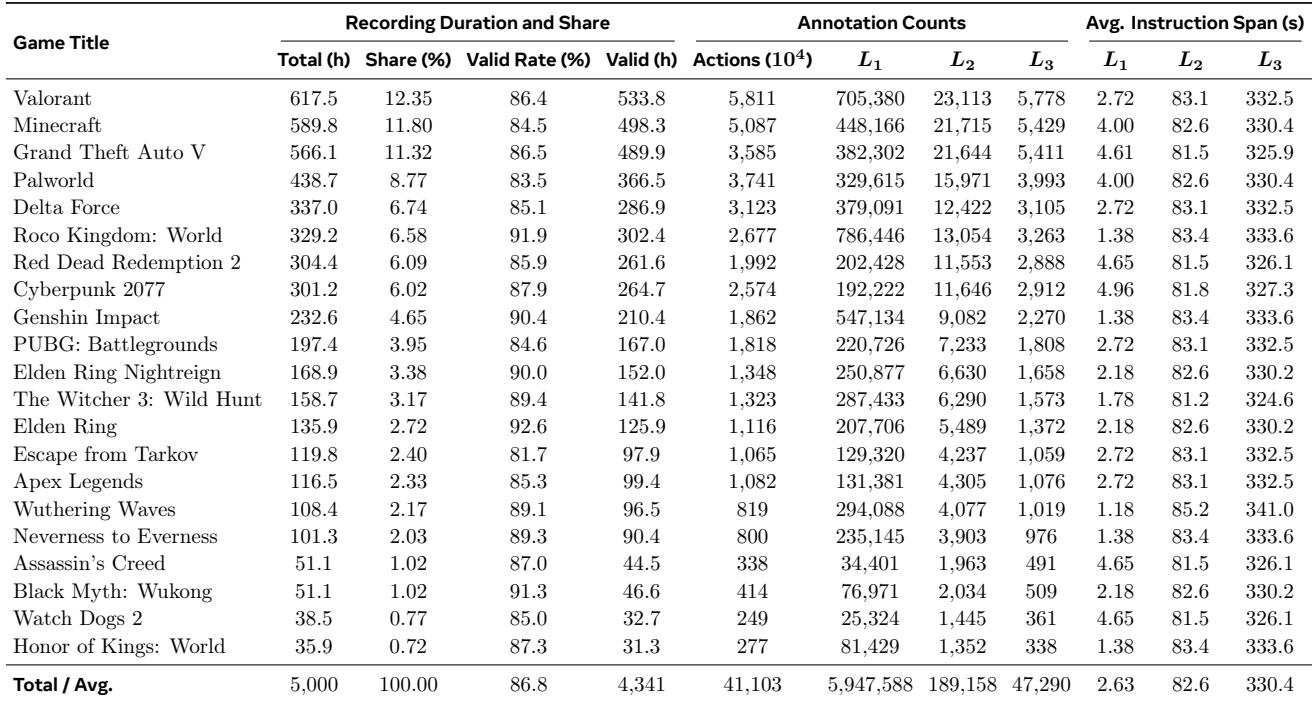
被比较的游戏数据集大多是单游戏基准,其中大多数集中在 Minecraft。大规模数据、直接人类操作和指令标注分别出现在不同数据集中,但所列数据集没有一个同时提供大规模 AAA 覆盖、直接人类操作和密集多时间尺度指令。GameHorizon-Data 被呈现为第一个在多个 AAA 游戏中结合这些特性的语料库。现有数据集主要是单游戏且以 Minecraft 为中心;MineRL、MineDojo、VPT、STEVE-1 和 PLAICraft 都仅限于 Minecraft。大规模覆盖、直接人类操作和指令标注在现有数据集中仅部分出现,而 GameHorizon-Data 被描述为第一个同时提供大规模 AAA 游戏过程、直接人类操作和密集多时间尺度指令的数据集。
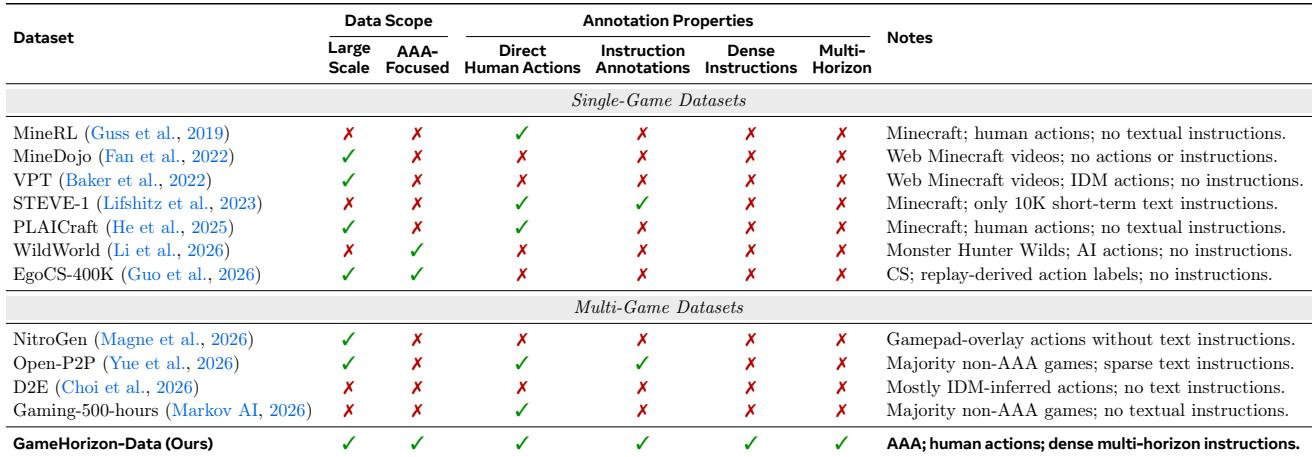
现有游戏基准在模型多样性和评估范围方面都存在局限。单游戏基准集中在 Minecraft,并且只支持特定模型家族;多游戏基准覆盖非 AAA 游戏,并且只涵盖较窄的模型范式。GameHorizon-Bench 则不同,它将广泛模型多样性与直接人类动作标注、多时间尺度任务,以及可复现的离线评估和分步在线评估相结合。单游戏基准仅限于 Minecraft,并且只评估游戏 agent 或 VLM 等较窄的模型家族。所列现有基准没有一个同时结合可复现的离线评估和分步在线评估,也没有一个包含广泛模型多样性、面向 AAA 的设置、直接人类操作和多时间尺度标注的完整组合。
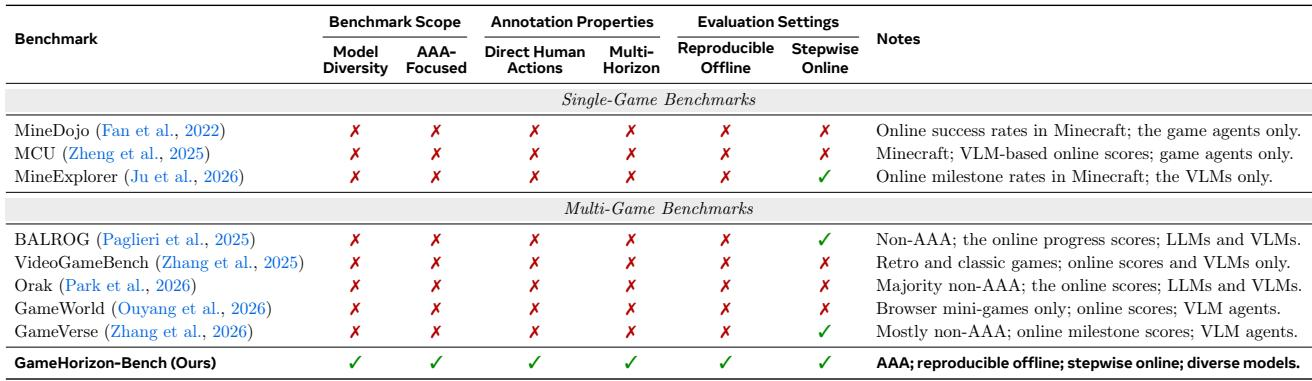
在所有被评估模型中,平均准确率远高于随机基线,基准将模型划分到清晰的能力层级。闭源模型主导第一梯队,而近期开放权重模型在中游排名中具有竞争力。统一多模态模型和 GUI agent 往往落入更低层级,细粒度动作预测任务难度最高,跨时间尺度理解难度最低。闭源模型在基准中领先,占据大多数第一梯队位置,而一些近期开放权重模型在该梯队之下排名具有竞争力。统一多模态模型和 GUI agent 通常位于更低层级;在各项任务中,细粒度动作预测最难,跨时间尺度理解最容易。
三个游戏 agent 均在单时间尺度动作任务上以零样本方式评估,表现出较弱的绝对性能。其中 JARVIS-VLA 排名最高,其后是 Open-P2P 和 NitroGen,但三者之间差距很小。它们的结果聚集在随机基线附近,表明零样本动作预测能力有限。三个游戏 agent 均在单时间尺度动作任务上以零样本方式测试。JARVIS-VLA 获得最高的 T1 准确率,其后是 Open-P2P 和 NitroGen。NitroGen 和 Open-P2P 低于 25% 随机基线,而 JARVIS-VLA 仅略微超过该基线。
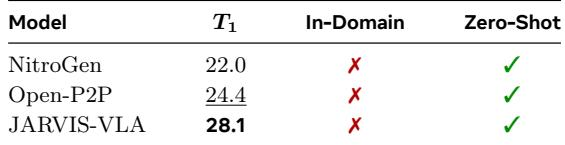
实验介绍了 GameHorizon-Data,一个覆盖 21 款 AAA 游戏、过滤后保留 4341 小时有效数据的 5000 小时人类游戏语料库,并验证其是第一个同时结合大规模 AAA 覆盖、直接人类操作和密集多时间尺度指令的数据集。将 GameHorizon-Bench 与现有基准进行比较,显示其具有更广泛的模型多样性、多时间尺度任务覆盖,以及离线评估和分步在线评估。结果表明,闭源模型占据第一梯队,开放权重模型在中游排名中具有竞争力,统一多模态模型和 GUI agent 排名较低,细粒度动作预测是最难任务,零样本评估的游戏 agent 表现接近随机基线。