Command Palette
Search for a command to run...
WorldCrafter:具有隐式 3D 感知记忆的一致性视频世界模型
WorldCrafter:具有隐式 3D 感知记忆的一致性视频世界模型
摘要
视频世界模型能够对动态环境进行交互式探索,但在长时程和跨视角条件下仍难以遵循先前观测。我们提出 WorldCrafter,一种视频世界模型,为此学习了一种可由相机查询的隐式 3D 感知记忆。其核心思想是让所请求的视角塑造多视角证据被压缩进视频生成器有限 token 预算的方式。在与视频生成器联合训练的过程中,记忆编码器和姿态条件化读取模块在去噪之前将历史观测整合为一组固定的目标视角特定 token,而无需显式的基于深度的对应关系。通过将该记忆与近期时序上下文和少步蒸馏相结合,WorldCrafter 能够从单张输入图像或文本提示出发进行流式场景探索。在静态和动态场景上的实验表明,该方法在分钟级探索过程中显著提升了长时程一致性和相机控制精度,同时保持了视觉质量。
一句话总结
来自 ARC Lab、腾讯 IEG 和北京大学的研究人员介绍了 WorldCrafter,一种视频世界模型。其相机可查询的隐式 3D 感知记忆使用位姿条件读取模块,将多视图证据压缩为目标视图特定的 token,从而支持从单张图像或文本提示进行流式场景探索,并提升了长时程一致性和相机控制精度。
核心贡献
- WorldCrafter 是一种视频世界模型,学习相机可查询的隐式 3D 感知记忆。联合训练的记忆编码器和位姿条件读取模块在去噪前将多视图历史观测压缩为固定的、目标视图特定的 token,无需显式基于深度的对应关系。
- 该模型将这种记忆与近期时序上下文和少步蒸馏相结合,实现从单张输入图像或文本提示进行流式实时场景探索。
- 在静态和动态场景上的实验表明,相比最强基线,重访一致性提升 47.6%,相机控制精度提升,同时在分钟级探索期间保持视觉质量。受控消融实验验证了记忆设计。
引言
视频世界模型通过生成新视图实现交互式探索,用户移动相机时即可获得新视图,但在长轨迹上保持一致性需要超出近期上下文的记忆。先前的方法要么使用全历史注意力而计算成本较高,要么使用检索在效率与视图覆盖之间权衡,要么依赖精确几何并因空间记忆在动态场景中表现不佳,要么偏向几何预测而牺牲复现先前已观察内容所需的外观保真度。作者介绍了 WorldCrafter,一种具有隐式 3D 感知记忆的视频世界模型,将历史潜变量帧编码为紧凑表示,该表示由预训练的 3D 编码器初始化,并与视频扩散 Transformer 联合优化。位姿引导的读取在固定预算下提取与视图相关的 token,少步蒸馏实现实时流式生成,同时保持相机控制和分钟级重访一致性。
数据集
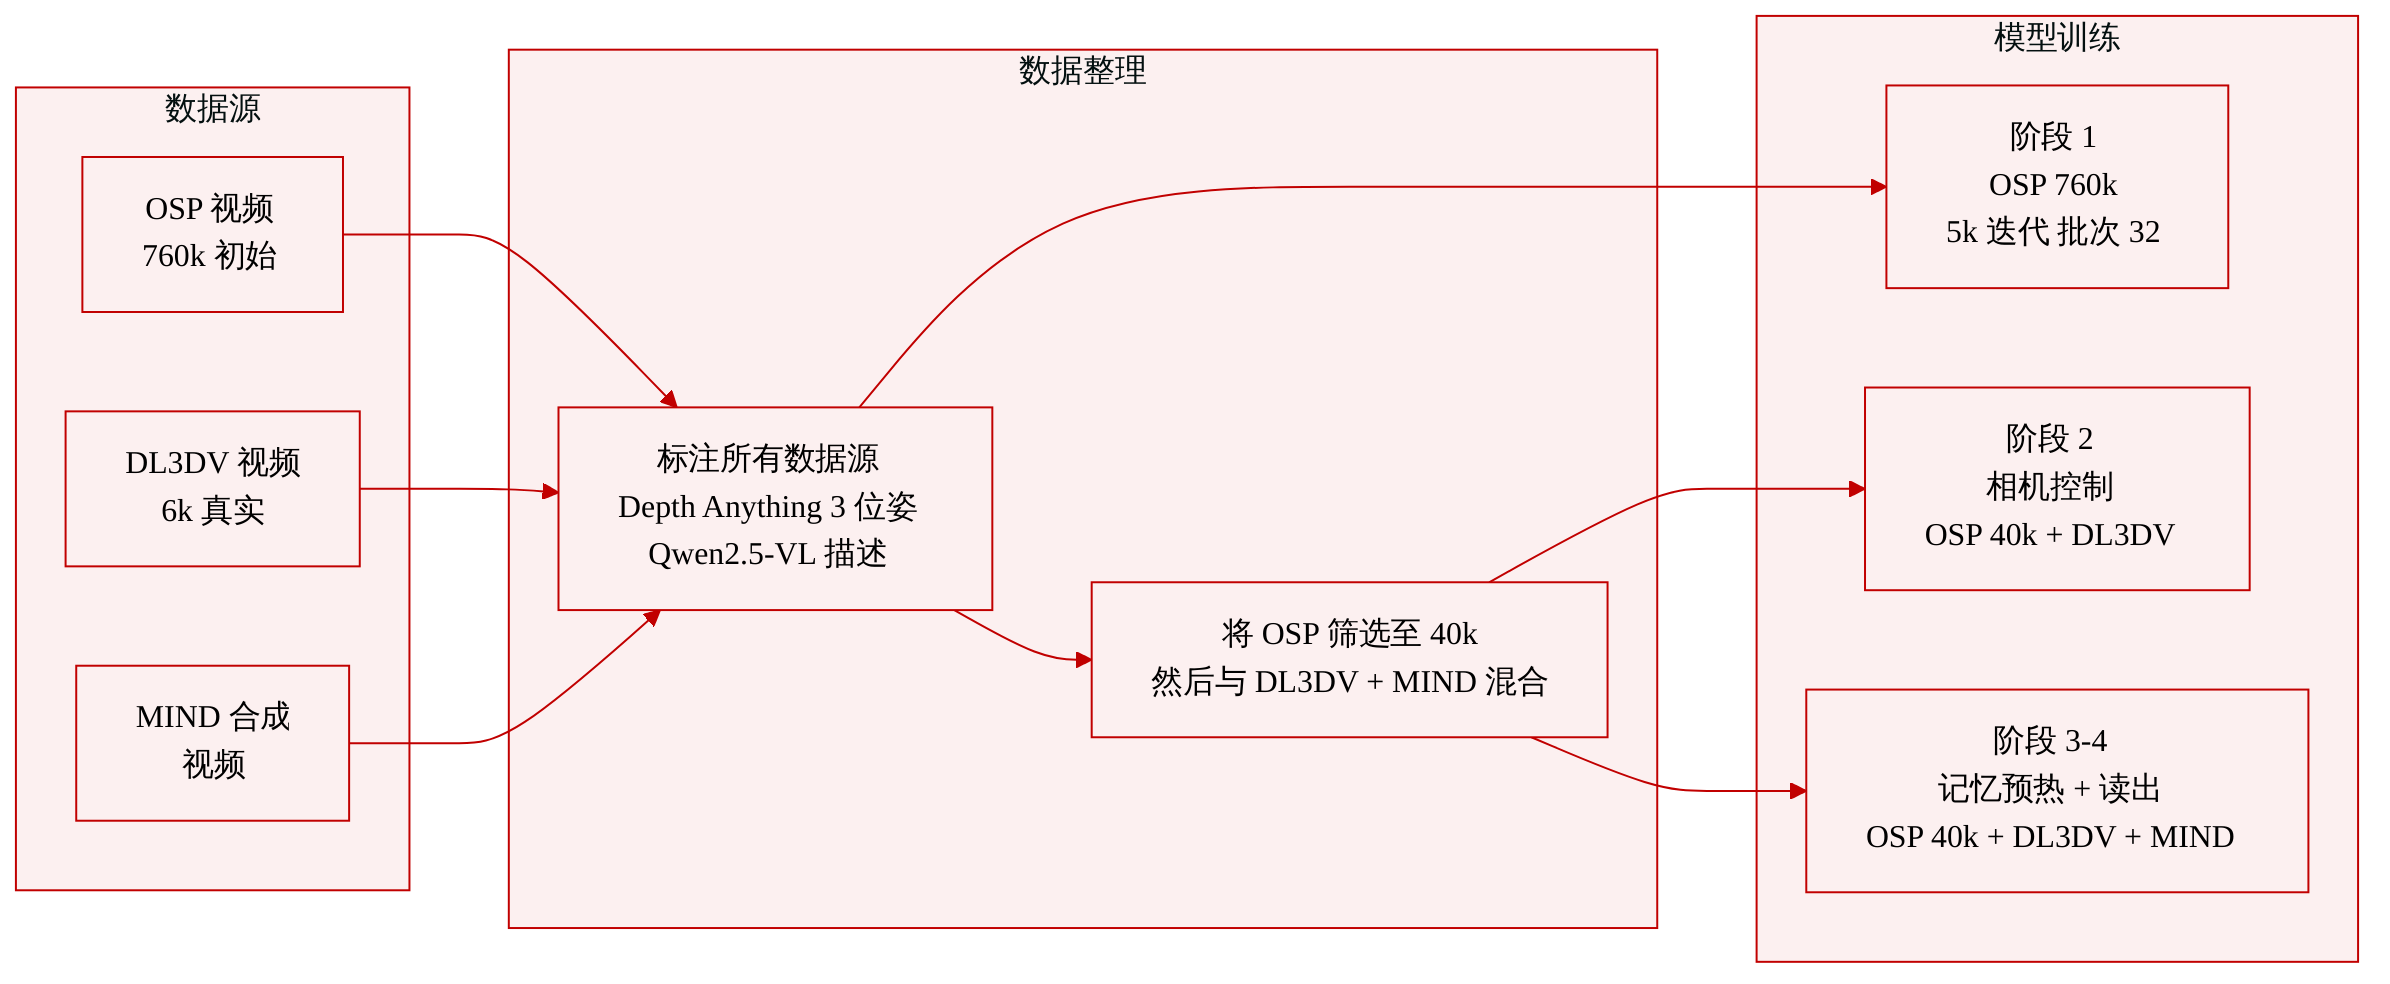
作者描述了以下数据集的构建和使用方式。
来源与构成
- OSP 数据集:大规模视频数据,覆盖多样的室内外场景和物体运动。论文使用 760,000 个 OSP 视频进行初始训练,并使用过滤后的 40,000 个视频子集进行相机控制和记忆相关训练。
- DL3DV:作为额外的真实视频来源,主要用于相机条件训练和记忆编码器适配。
- MIND:合成视频,用于在最终训练阶段改进动态主体建模。
处理与过滤
- 作者应用 Depth Anything 3 在所有数据源上获得公制尺度的相机位姿标注。
- 作者使用 Qwen2.5-VL 生成视频描述。
- 利用生成的视频描述和估计的相机轨迹,作者过滤 OSP 数据集的一个子集,保留相机跟随运动主体的视频。该过滤后的 OSP 子集旨在帮助模型学习协调的相机和主体运动。
数据在训练中的使用方式
- 阶段 1:使用 OSP 数据集中的 760,000 个视频,训练 5,000 次迭代,全局 batch size 为 32。
- 阶段 2:使用过滤后 OSP 子集中的 40,000 个视频和 DL3DV 中的 6,000 个视频,全局 batch size 为 128。
- 阶段 3:使用 DL3DV 和过滤后的 OSP 子集对记忆编码器进行 5,000 次迭代预热,全局 batch size 为 16。
- 阶段 4:使用 DL3DV 和过滤后的 OSP 子集训练 8,000 次迭代,全局 batch size 为 32,随后使用 MIND 中的合成视频进行 1,000 次额外迭代。
方法
作者提出了 WorldCrafter,一种相机可控的自回归视频世界模型,配备隐式 3D 感知记忆机制。系统基础依赖于潜空间视频扩散,其中视频变分自编码器将干净视频帧映射到时空潜空间。基于扩散 Transformer(DiT)的去噪器在这些潜变量上运行,通过条件流匹配训练以预测速度场。为了将生成扩展到固定片段之外,模型采用逐块自回归方式。在每个 rollout 步骤中,当前潜变量通过条件流演进,该条件流同时包含紧凑的记忆表示和目标相机轨迹。
如下图所示:
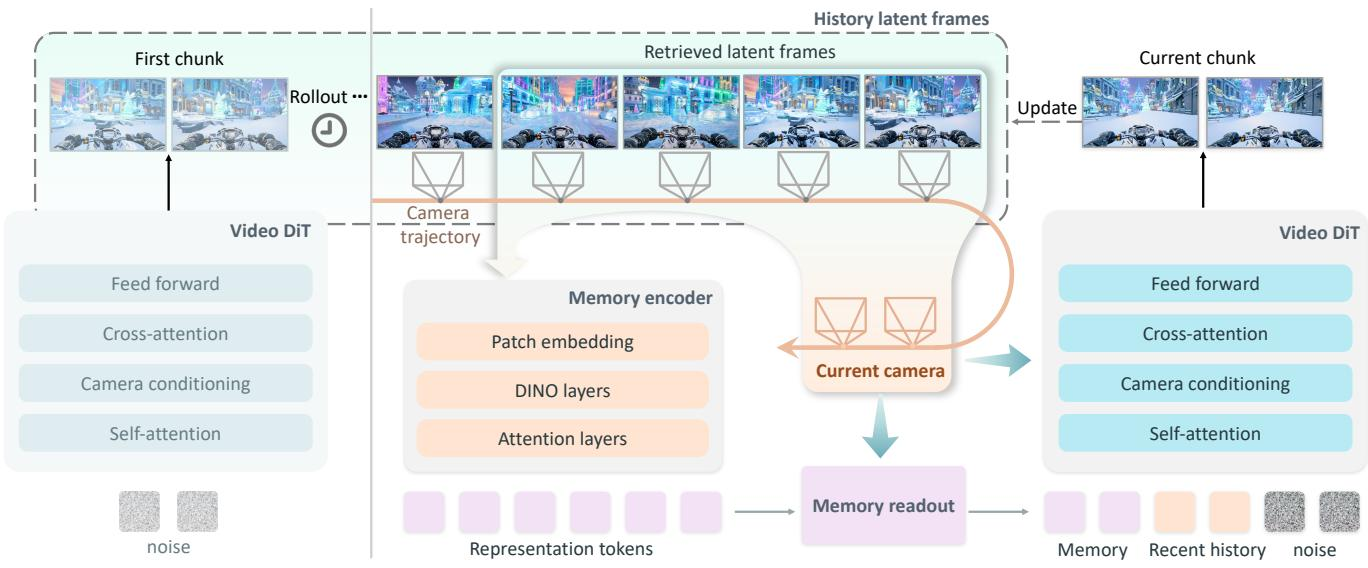
流程概览展示了这一自回归过程。视频 DiT 仅以相机位姿为条件生成初始块,因为此时没有历史可用。随着生成推进,系统累积历史潜变量帧。为了在不超过计算预算的情况下保持长时程一致性,作者实现了一个记忆编码器,将选定的历史潜变量及其对应相机参数映射为隐式 3D 感知表示。与直接检索固定长度的上下文不同,记忆编码器聚合同一输入历史中的几何和外观信息。为了限制编码成本,系统将输入限制为固定数量的历史潜变量帧。推理期间,系统保留最新潜变量帧,并贪心地选择互补帧,以最大化沿即将到来的相机轨迹的视场覆盖。
在记忆写入阶段之后,位姿引导的记忆读取模块使用从目标相机轨迹采样的固定大小查询位姿集合来查询隐式表示。该机制提取固定数量的与即将生成高度相关的记忆 token。在每个去噪步骤中,DiT 处理由记忆 token、近期历史帧和带噪当前块拼接而成的序列。该设计增加了专门的记忆流,同时保持块级因果性。
对于相机条件,目标轨迹指定每帧的相机到世界位姿和内参。作者将相对相机几何编码为自注意力中的位置变换。具体实现使用并行相机注意力分支,采用独立的 query、key 和 value 投影。其输出通过零初始化投影添加到原始自注意力中,该相机分支仅应用于拼接序列中的带噪部分。
基础模型训练分四个不同阶段进行。首先,对视频 DiT 进行微调,以适应包含记忆 token 的修改后的推理窗口。第二阶段通过训练相机条件分支引入相机控制,同时保持 DiT 主干冻结。第三阶段,通过将浅层图像处理层替换为潜变量 patch 嵌入层,使记忆编码器适应处理 VAE 潜变量。最后阶段联合训练记忆读取模块、记忆编码器、视频 DiT 和相机条件分支,使学习到的记忆表示与 DiT token 空间协同适配。
为了实现实时交互,作者应用金字塔蒸馏方案。采用从粗到细的金字塔去噪方法,结合分布匹配蒸馏,利用多个空间分辨率减少采样步数。为了平衡视觉保真度和主体跟随能力,构建了混合蒸馏模型。低噪声模型使用专注于自然外观的数据集蒸馏,而高噪声模型使用混合数据集蒸馏,以保留动态主体建模能力。推理期间,高噪声模型执行前置去噪步骤,低噪声模型执行最后一步,从而实现高速生成。
实验
评测使用包含 145 张图像的基准,覆盖动态和静态场景,每张图像有五条公制相机轨迹,将 WorldCrafter 和 WorldCrafter-fast 与八个近期相机可控视频世界模型进行比较。记忆和闭环重访实验表明,所提模型在长时间范围内最好地保留了先前观察到的外观和场景结构。相机控制和视觉质量评测进一步表明轨迹跟随准确、场景一致性强、时序连贯性好,其中 WorldCrafter 取得最高总体视觉质量分数。消融实验验证了学习到的隐式 3D 感知记忆、记忆编码器与视频生成器的联合优化、位姿引导读取和最大覆盖历史检索,同时显示记忆处理成本远低于基于深度的空间变换。
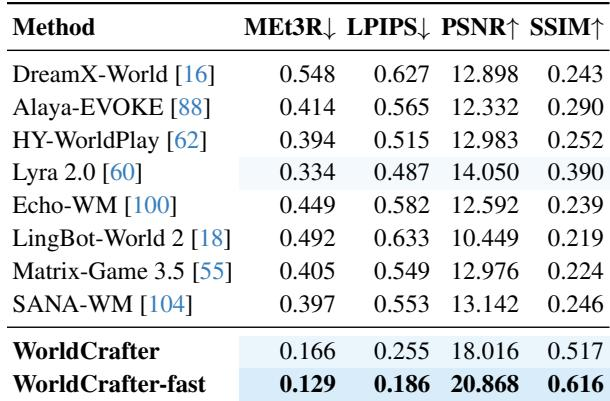
WorldCrafter 和 WorldCrafter-fast 在长时程重访一致性上领先,WorldCrafter-fast 取得最佳总体结果,WorldCrafter 也在全部四个指标中进入前两名。相对于 Lyra 2.0,WorldCrafter 将 LPIPS 从 0.487 降至 0.255,将 PSNR 从 14.050 dB 提升至 18.016 dB。这些增益表明在重访先前已看过的位置时,能更忠实地恢复外观和结构。WorldCrafter-fast 在 MEt3R、LPIPS、PSNR 和 SSIM 上排名第一,WorldCrafter 排名第二。WorldCrafter 相对于 Lyra 2.0 将 LPIPS 降低约一半,并将 PSNR 从 14.050 dB 提升至 18.016 dB。Lyra 2.0 是这些一致性指标上的最强基线,但所提模型在全部四个指标上均超越它。
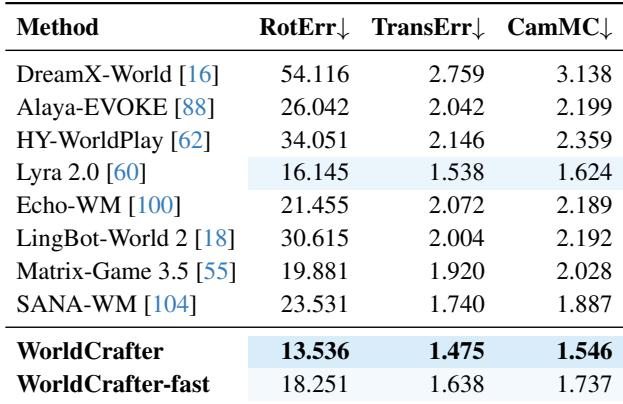
WorldCrafter 在评估的生成视频上取得最低的旋转、平移和位姿矩阵差异误差。WorldCrafter-fast 在每项指标上排名第三,表明其相对于完整模型存在速度与精度的权衡。结果表明相机轨迹对齐优于所有比较方法。WorldCrafter 在所有三个相机控制指标上均优于每个比较方法。WorldCrafter-fast 是旋转误差、平移误差和位姿矩阵差异上第三好的模型。完整模型在相机轨迹精度上优于 Lyra 2.0 和 Alaya-EVOKE 等基于几何的基线。
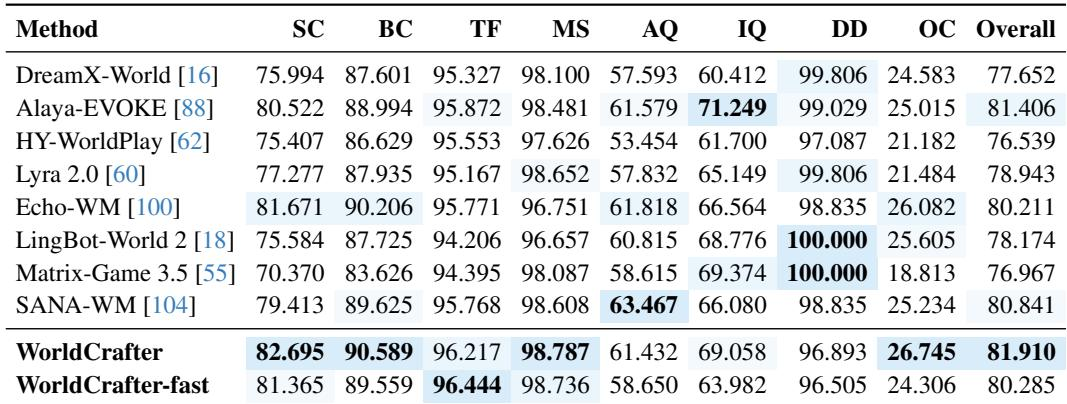
WorldCrafter 在比较方法中取得最高的 VBench 视觉质量综合得分,而 WorldCrafter-fast 获得最佳时序闪烁得分。所提模型在报告的八个视觉质量维度中有五个领先,提升主要集中在场景一致性和时序连贯性。在所列基线中,Echo-WM 和 Alaya-EVOKE 总体最强,而 Matrix-Game 3.5 和 HY-WorldPlay 显示较低的总体一致性。WorldCrafter 在 VBench 综合得分上领先,WorldCrafter-fast 在时序闪烁上领先。所提模型在八个视觉质量维度中有五个排名第一,反映更强的场景一致性和时序连贯性。Echo-WM 和 Alaya-EVOKE 是所列基线中总体最强的,Echo-WM 在主体一致性、背景一致性和总体一致性上领先。
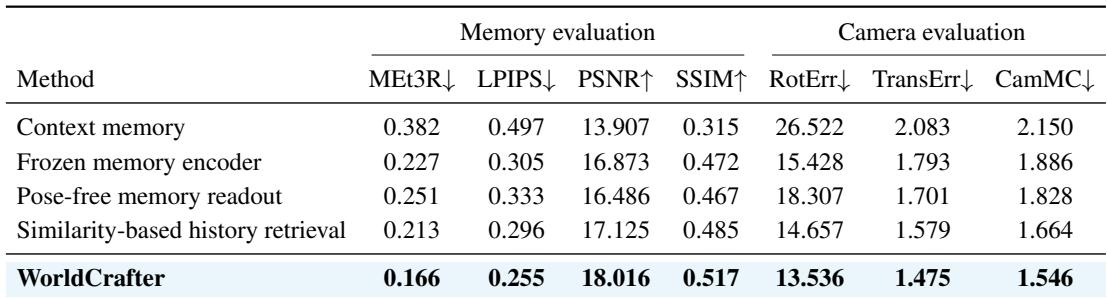
完整记忆设计在所有报告指标上取得最佳记忆重建和相机控制。用检索到的上下文潜变量帧替换学习到的记忆 token 导致最大性能下降,而冻结编码器、无位姿读取和基于相似度的检索均降低性能。联合优化、位姿引导读取和最大覆盖历史选择都有助于更一致的重访和更好的相机估计。用检索到的历史潜变量帧替换学习到的记忆 token 在所有变体中给出最弱的记忆和相机控制结果。与冻结编码器相比,联合优化记忆编码器和视频生成器提高了记忆质量和相机估计。位姿引导的记忆读取优于无位姿读取,表明目标位姿查询对记忆和相机控制都有帮助。最大覆盖历史检索相比基于相似度的检索提高了重访一致性和相机控制,而无需增加历史输入数量。完整模型在所有测试的记忆设计变体中取得最佳记忆保真度、PSNR、SSIM 和相机误差指标。
实验评估了 WorldCrafter 在长时程重访一致性、相机轨迹控制、视觉质量和记忆设计消融上的表现。WorldCrafter 及其快速变体在重访一致性和 VBench 视觉质量上领先,具有更强的场景一致性和时序连贯性,而完整模型也取得最低的相机控制误差。消融结果表明,学习到的记忆 token、联合编码器优化、位姿引导读取和最大覆盖历史选择均改善记忆保真度和相机估计。总体而言,所提出的记忆和控制机制提升了生成质量、时空一致性和轨迹精度。