Command Palette
Search for a command to run...
GAE:学习面向 3D 一致世界生成的几何原生潜在空间
GAE:学习面向 3D 一致世界生成的几何原生潜在空间
Jiahao Lu Minghao Yin Wenbo Hu Hengyu Liu Wang Zhao Sai-Kit Yeung Ying Shan Yuan Liu
摘要
我们提出一种紧凑的几何原生潜在空间,作为感知与生成的共享基础。视觉生成器能够生成逼真的帧,却无法保持一致的 3D 场景。我们认为,这不仅是一个建模问题,也是一个表示问题:生成器通常演化出以外观为中心的潜在表示,而感知模型则在编码跨视角结构的语义丰富空间中恢复几何。我们没有将几何作为另一项输出附加,而是将几何基础模型的特征重新参数化为用于生成的紧凑潜在空间。我们通过几何原生自编码器(GAE)实现了这一转变,其潜在表示可被联合解码为外观、深度、相机和点图。利用这一状态,标准条件流模型可支持多样的生成任务。在固定生成器和训练协议的受控比较中,将潜在表示替换为 GAE 可同时提升视觉质量与独立测量的 3D 一致性:FVD 在 RealEstate10K 和 DL3DV 上分别下降 12.7% 和 23.1%,相机轨迹误差在 RealEstate10K 上减半。这些结果共同表明,潜在空间对几何一致的生成至关重要,并且可以作为感知与生成之间的共享接口。
一句话总结
来自香港科技大学、ARC Lab、腾讯 IEG 等机构的研究者提出几何原生自编码器(GAE),将几何基础模型特征重新参数化为一个紧凑的 latent,可解码为外观、深度、相机和点图,使标准条件流能够生成多样的 3D 一致场景,在 RealEstate10K 上 FVD 降低 12.7%,在 DL3DV 上降低 23.1%,并在 RealEstate10K 上使相机轨迹误差减半。
核心贡献
- 几何原生自编码器(GAE)将几何基础模型的特征重新参数化为一个紧凑的 latent 空间,该空间可联合解码为外观、深度、相机和点图。
- 该 latent 空间作为标准条件流模型的演化状态,使生成的目标视图 latent 能够原生解码为 RGB 和几何信息。
- 在固定生成器和训练协议的受控对比中,GAE 在 RealEstate10K 上将 FVD 降低 12.7%,在 DL3DV 上降低 23.1%,并在 RealEstate10K 上将相机轨迹误差约减半,证明视觉质量和 3D 一致性得到改善。
引言
逼真的视频生成对于世界建模而言并不足够:生成的视图看起来可能合理,但其恢复的几何结构会漂移,相机轨迹会偏离,因此持久的 3D 结构必须嵌入生成 latent 状态中。现有方法要么使用外观或语义 latent,这些 latent 无法原生读取深度、相机几何和跨视图关系,要么将几何作为辅助信号附加到以外观为主导的状态上。几何基础模型已经包含所需结构,但其多层级特征层次冗余、各向异性,并将互补线索分散在不同层级,使得难以用单一生成流直接建模。作者引入几何原生自编码器 GAE,将 DA3 的冻结多层级几何特征压缩为一个紧凑 latent,并为冻结几何解码重建完整特征层次,同时从同一 latent 解码 RGB。token 级和成对对齐目标对该 latent 进行组织以实现平滑传输,该模型支持文本到图像、相机控制的视频和新视图合成。在受控对比中,GAE 相对于像素、语义和原始几何 latent 提升了生成质量和 3D 一致性。
方法
作者提出几何原生自编码器(GAE),一个将 3D 归纳偏置直接嵌入生成状态的框架。该方法通过两阶段训练流程运作。如下图所示:
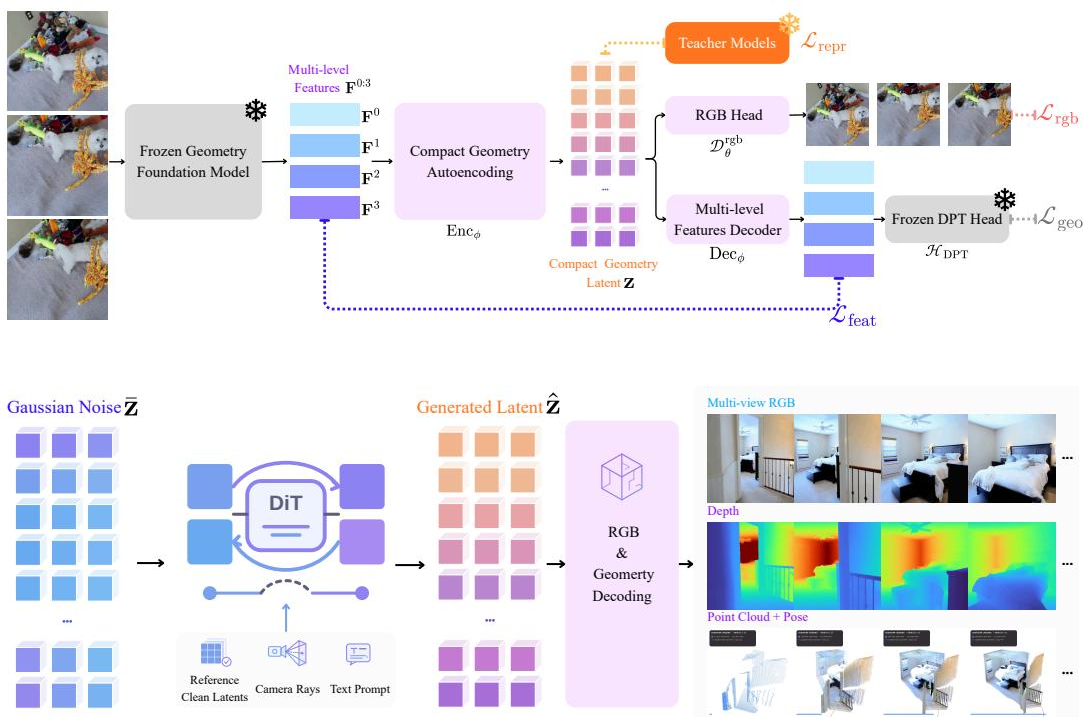
在第一阶段,作者训练编解码器,将冻结几何骨干的多层级特征压缩到一个紧凑 latent 空间中,该空间可联合解码为 RGB 和几何信息。给定 V 个输入视图,冻结的 DA3 编码器 E 提取四层级特征层次。固定算子 P 使用训练集统计量对每个层级进行归一化,并沿通道维度拼接形成融合张量 Xv。可训练编码器 Encϕ 将该张量压缩为网格状 latent zv,而解码器 Decϕ 重建完整特征层次。
为确保紧凑 latent 同时支持两种模态,该框架采用两条不同的解码路径。单独的可学习头 Dθrgb 直接从 latent zv 渲染 RGB 图像。同时,重建的特征层次通过冻结的稠密预测 transformer 头 HDPT 输出深度、射线和点图。该设计确保 latent 保持可几何解码,无需逐层级生成级联。编解码器通过一个复合目标进行优化,包括特征重建、RGB 和几何损失、KL 散度项以及表征塑造项 Lrepr。为组织 latent 空间以供后续生成,作者利用冻结的 C-RADIO 和 DINOv2 教师模型。C-RADIO 教师提供 token 级语义对齐,而 DINOv2 教师通过在 latent 空间中直接匹配成对空间相似性来强化关系结构。
在第二阶段,作者冻结训练好的编解码器,并在标准化 latent 空间内训练条件流模型。编解码器的后验均值使用训练集统计量进行标准化以提供流目标。流模型通过条件流匹配进行训练,预测速度场将高斯噪声传输到目标 latent 分布。
条件集 C 包含文本提示、用于相机控制的度量 Plucker 射线嵌入以及来自参考视图的干净 latent token。为防止集合条件几何编码器固有的训练-推理不匹配,作者不将全集合参考 latent 直接放入流状态。相反,联合编码观察到的参考视图以产生干净 latent zˉref,将其作为条件 token 前置在时间步 t=0。这些参考 token 与含噪目标视图 token 联合参与注意力,但在解码器预测头之前被移除,使得单个标准 Euler 采样器能够在没有去噪层级不匹配的情况下运行。在推理过程中,高斯目标视图 latent 从 t=1 积分到 t=0,经过反标准化,并通过冻结编解码器和相应头解码为最终 RGB 和几何输出。
实验
实验在 RealEstate10K 和 DL3DV 上的受控流匹配设置下评估 latent 表征和编解码器,涵盖 latent 空间属性、RGB 和几何重建、生成质量、3D 一致性和消融研究。GAE 将完整 DA3 层次融合为紧凑 latent,在几何原生表征中提供最佳整体平衡,并在不牺牲外观的情况下提升 RGB 保真度、几何恢复、相机控制和多视图一致性。消融研究表明,表征塑造和更大的骨干容量带来互补增益,而干净参考 token、度量射线条件和文本到图像联合训练改善了外观、几何和相机运动。定性结果进一步展示了长时 rollout 和文本条件 RGB 与几何生成。
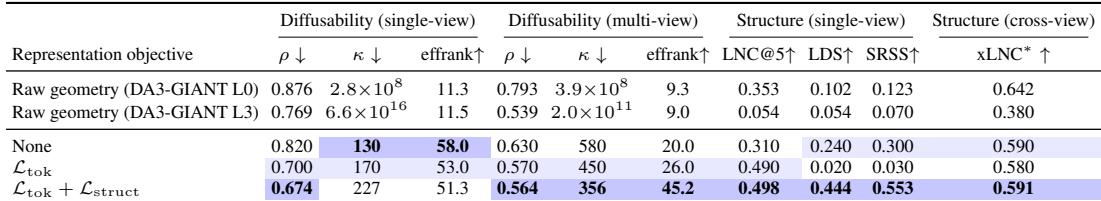
表征消融研究显示相对于原始几何层次有逐步改进。仅重建大幅改善条件化,但传输平滑性和语义邻域仍然较弱。token 对齐改善了传输和语义一致性,但压缩了关系结构,添加结构目标在保留这些增益的同时恢复单视图和跨视图结构。相对于原始几何,仅重建基线大幅降低了条件化难度并提高了有效秩,但其传输和语义指标仍然较弱。token 对齐改善了可扩散性和语义邻域一致性,但导致关系结构分数大幅下降,而组合目标恢复了这些分数并改善了跨视图组织。
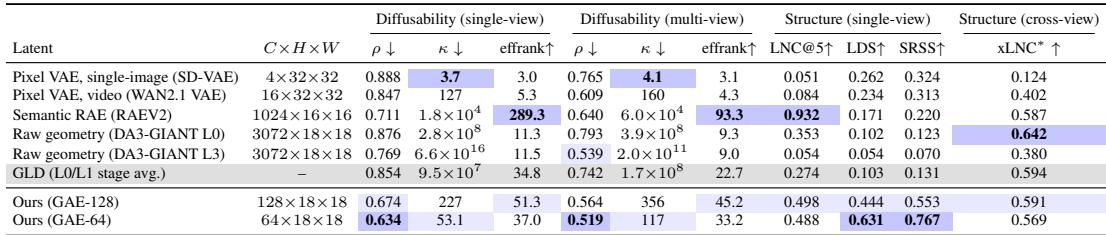
没有单一 latent 在每个维度上都表现强劲:像素 VAE 条件化良好但结构薄弱,语义 RAE 具有强语义邻域但条件化差且没有原生几何读出,原始 DA3 特征维度高且条件化差。在原始 DA3 内部,浅层特征保留跨视图对应关系,而深层特征以空间和跨视图结构换取更低的传输成本。GAE 将层次融合为紧凑的几何原生状态,在传输、条件化、空间和跨视图结构以及语义组织方面实现最佳整体平衡。像素 VAE latent 条件化良好但结构薄弱,而视频变体比单图像变体表现出更好的跨视图结构。原始 DA3 L0 特征保留更强的跨视图对应关系,而原始 L3 改善了传输但丢失了空间和跨视图结构。GAE 将层次融合为紧凑的几何原生状态,比原始层级更好地平衡了传输、条件化、空间和跨视图结构以及语义组织。
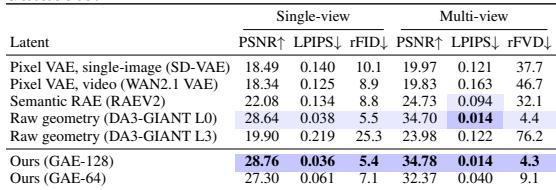
所提出的 GAE-128 latent 在单视图和多视图 RGB 重建上与来自 DA3-GIANT L0 的原始几何特征相当或略优,同时使用的通道数减少 24 倍。原始 L3 以及测试的像素 VAE 和语义 RAE latent 重建外观的效果显著较差。GAE-128 和原始 L0 在保真度和分布对齐方面远强于其他方案。GAE-128 实现了最佳或并列最佳的单视图和多视图重建质量,在 PSNR、LPIPS、rFID 和 rFVD 上基本匹配原始 DA3-GIANT L0。原始 DA3-GIANT L3 相比 L0 丢失了显著更多的可重建外观信息,其 LPIPS 和分布指标差得多。像素 VAE latent 和语义 RAE 在 RGB 重建上远落后于 GAE-128 和原始 L0,特别是在多视图 rFVD 上。
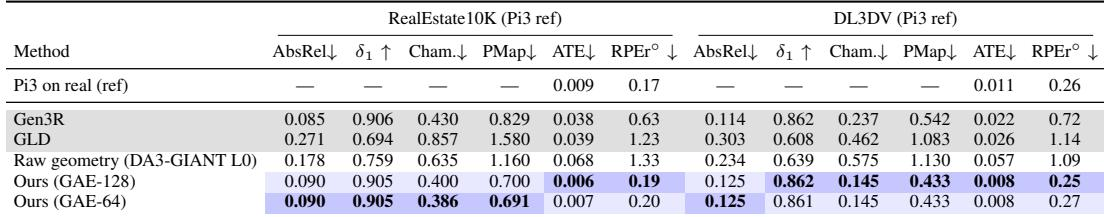
编码 latent 保留了超出 RGB 保真度的几何相关信息。两种 GAE 变体在 RealEstate10K 和 DL3DV 的深度、点图和相机位姿指标上均优于原始几何基线。与外部重建系统相比,GAE 的相机误差低于 Gen3R 和 GLD,点云误差低于 GLD,而 Gen3R 在某些深度指标上略优。GAE-64 和 GAE-128 在两个数据集上的深度、点图和位姿指标均优于原始几何基线。GAE 的相机误差低于 Gen3R 和 GLD,点云误差低于 GLD,而 Gen3R 在某些深度指标上略领先。
所提出的 GAE latent 族在相机条件外观生成方面优于像素 VAE、语义和原始几何 latent。据报道,GAE-64 在 RealEstate10K 和 DL3DV 上提供了最强的整体分布和成对保真度,而 GAE-128 在比较变体中实现了最佳的 RealEstate10K FID。像素 VAE、语义 RAE 和原始几何 latent 等替代方案通常在 FVD/FID 和重建保真度上较弱。相对于两个数据集上最佳的非 GAE 受控 latent,GAE-64 将 FVD 降低了两位数百分比,并在成对保真度指标上领先。GAE-128 在比较变体中实现了最佳的 RealEstate10K FID。像素 VAE 视频 latent 结果尤其弱,在两个数据集上具有最高的 FVD 和最低的 PSNR 与 SSIM。
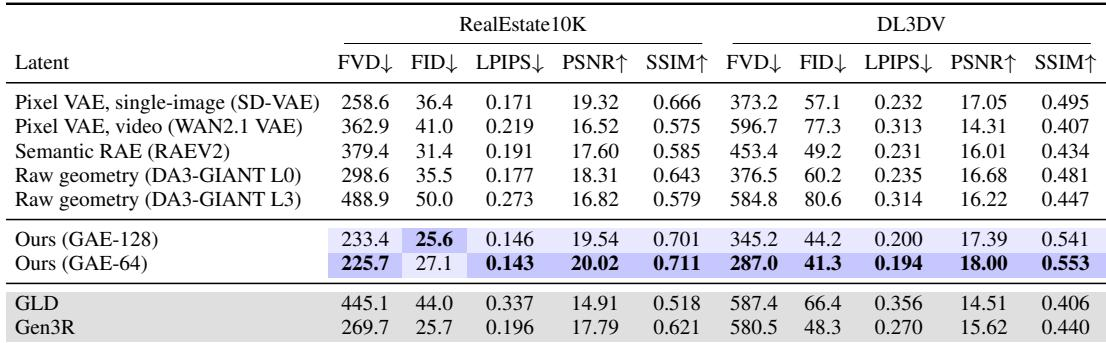
实验通过表征消融、重建、几何估计和相机条件生成,评估了所提出的几何原生自编码器与原始 DA3 几何层级、像素 VAE 和语义 RAE 的对比。消融研究表明,重建改善条件化,token 对齐改善传输和语义一致性,添加的结构目标恢复了关系和跨视图结构。总体而言,GAE 将几何层次融合为紧凑 latent,在 RGB 重建上以远少得多的通道数匹配或超越原始浅层几何,相对于原始基线和外部系统改善深度、点图和位姿指标,并在相机条件外观生成上领先于测试的替代方案。