Command Palette
Search for a command to run...
RRSI:智能体框架的正则化递归自我改进
RRSI:智能体框架的正则化递归自我改进
摘要
LLM 智能体的能力在很大程度上被其框架(agent harness)所放大,该框架包括围绕冻结骨干模型的提示、控制流、工具、记忆和上下文管理。近期方法越来越多地通过迭代提出并选择智能体框架的组件级编辑来实现这一过程的自动化,从而在智能体系统层面实际构成了一种递归自我改进(RSI)形式。然而,这种递归演化可能因记忆训练任务而过拟合,表现出较大的分布内收益,但这些收益在分布外基准上会缩小甚至消失。我们提出了智能体框架的正则化递归自我改进(RRSI),该方法通过约束演化候选的提出与选择,将正则化原则纳入框架自我改进。提出器在时间退火预算下运行,限制候选方案所能捆绑的编辑数量,并基于演化历史鼓励未探索的轨迹。选择器配有评判器与剪枝器:评判器过滤针对特定基准的提案,而剪枝器移除过小、代价过高或不再有用的更改。这些约束共同使可复用的智能体机制比特定基准机制乃至噪声更受青睐。在涵盖编码、智能体工作空间和工程设计任务的八个基准上,RRSI 在其演化所用的数据划分上最多提升 14.1 分,在五个分布外基准上最多提升 4.7 分,同时所产生的框架运行所用的策略 token 比未正则化演化少 30%。
一句话总结
来自 Google Cloud AI Research、北卡罗来纳大学教堂山分校、斯坦福大学和圣路易斯华盛顿大学的研究人员提出了 Regularized Recursive Self-Improvement of Agent Harnesses (RRSI)。该方法通过时间退火的提案预算和 critic-pruner 选择来约束 harness 进化,使可复用机制优先于针对特定基准的过拟合;在覆盖编程、智能体工作空间和工程设计任务的八个基准上,RRSI 最高获得 14.1 个分布内点和 4.7 个分布外点收益,同时策略 token 用量比未正则化进化少 30%。
核心贡献
- RRSI 在迭代 harness 进化过程中约束候选提案与选择,同时保持 harness 编辑空间开放。
- 提案阶段使用时间退火的编辑预算和历史信息引导的探索,以鼓励未被探索的轨迹;选择阶段使用 critic 筛选针对特定基准的提案,并使用 pruner 删除过小、成本过高或不再有用的改动,从而优先保留可复用的 agent 机制,而非仅针对特定基准的机制。
- 在覆盖编程、智能体工作空间和工程设计任务的八个基准上,RRSI 将进化划分的性能最高提升 14.1 个点,将五个分布外基准的性能最高提升 4.7 个点,同时产出的 harness 比未正则化进化少使用 30% 的 policy token。
引言
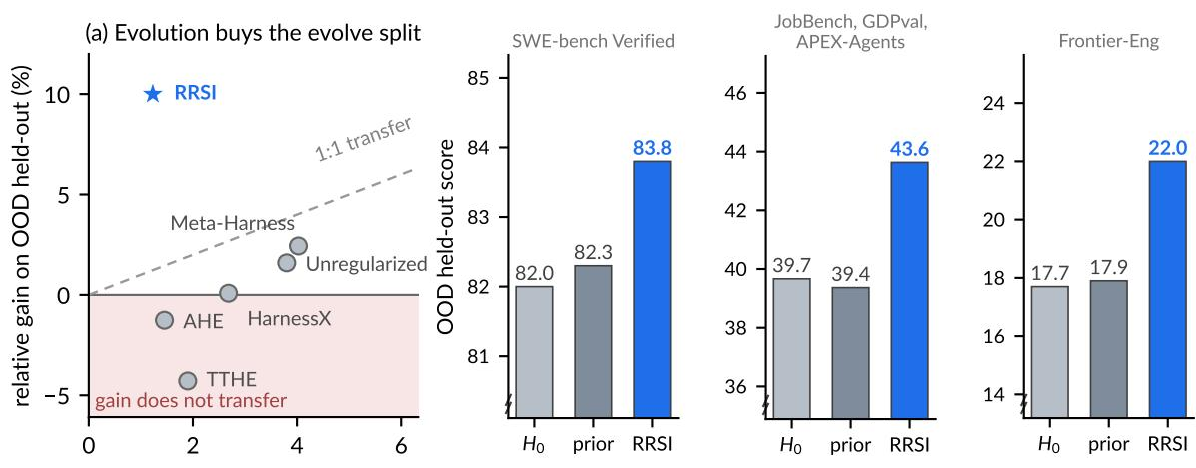
现代 LLM agent 是将冻结的主干模型包裹在由提示、控制流、工具接口、记忆和上下文管理构成的 harness 中的系统。近期 agent 的许多进展来自 harness 工程,但这项工作主要依赖人工,受限于人类工程师能够检查的失败轨迹数量。使用 LLM 进行自动化 harness 进化能够实现递归自我改进,但它会自适应地重复使用有限的 evolve 集,带来基准特定拟合、评估噪声和复杂度累积导致的过拟合风险,这些风险无法迁移到未见任务。作者提出 RRSI,该框架在 harness 进化过程中对提案和选择同时进行正则化,同时保持所有 harness 组件可编辑,偏好更简单、更可复用的编辑,并针对噪声反馈应用稳健的选择标准。
方法
作者提出了 Regularized Recursive Self-Improvement (RRSI),一种递归 harness 进化流程,它保持可能 harness 编辑的空间开放,同时正则化搜索在该空间中的轨迹。harness 可包含提示、控制流、配置、上下文管理、工具、技能、记忆和子 agent,其中任何部分都可以被修改、添加或删除。RRSI 并不直接限制这个假设空间,而是约束进化在其中的移动方式。
在每一轮 t 中,提案器使用有限 evolve 集的反馈为当前 harness Ht 生成候选编辑,选择器决定是否有候选应替换当前版本。正则化作用于两侧。在提案侧,RRSI 限制单轮可使用的自适应容量以及容量投向何处。在选择侧,RRSI 约束哪些经验改进足够强、足够高效且足够无泄漏,才能存活。
该方法与经典正则化有三个类比。退火编辑预算类似于对更新的 L0 风格基数约束。结构剪枝类似于 Lasso 或 L1 风格稀疏化。复杂度感知接受类似于 Ridge 或 L2 风格收缩,在不强制删除任何特定组件的情况下,抑制总资源占用的无约束增长。
正则化提案分布
提案器通过三种主要方式正则化:退火更新稀疏性、证据感知的信用分配和结构化探索。
L0 风格的退火更新稀疏性
无约束提案可能将多个不相关的修改捆绑到一个候选中,使测量变化难以归因于某个具体机制。因此,RRSI 对提案中可独立归因的编辑数量设上限。对于 T 轮运行,第 t 轮的编辑预算为
bt=⌈bmin+(bmax−bmin)⋅21(1+cos(πt/T))⌉.该时间表从 bmax 下降到 bmin。早期轮次可以组合若干协调变化以发现新机制,后期轮次则变得越来越稀疏且易于归因。如果可独立归因的编辑被表示为二元活动指示符,该预算以 L0 风格限制其基数。
证据感知的信用分配
由于评估会反复观测相同的有限 evolve 集,重新测试早期轮次已经证伪的假设会浪费搜索容量。RRSI 对每个被评估候选记录其修改的组件、测试的假设、源 diff、最终得分与成本变化,以及该候选是否被接受。提案器在后续轮次中以该历史为条件。被拒绝的机制仍作为负证据,成功机制则保留明确信用。随着后期每轮允许的每个候选编辑变少,观测到的改进更容易归因于具体改动。
结构化探索
同样的历史会揭示搜索是否已经塌缩到某个狭窄编辑族,例如反复重写提示而完全不触及结构性 agent 机制。当过去 k 轮内的进展仍处于经验噪声带 δ 内时,RRSI 将搜索视为停滞。停滞期间,提案预算的一小部分会保留给本轮尚未被使用过的组件。这类似于多样性或熵正则化,将有限的提案容量重新导向探索不足的机制,而不改变 harness 被允许包含的机制。
正则化候选选择
标准 harness 进化可能提升测量得分最高的候选,即使该得分反映的是泄漏、随机波动或昂贵的增长。RRSI 保留相同的经验目标,但要求候选在替换当前版本之前通过若干非补偿性检查。
泄漏筛选
在完整评估之前,一个 critic 会读取每个候选 diff,并拒绝那些显式编码任务名称、实体名称、任务特定值、答案或其他 evolve 基准特定逻辑的编辑。它也会拒绝添加无效机制的编辑。该筛选针对基准特定内容,而不是特定的 harness 组件,因此通用提示或工具描述改进仍然是有效候选。评估前筛选很重要,因为泄漏候选不会获得可能使其在后续轮次中具有吸引力的虚高 evolve 集得分。
稳定性感知接受
在噪声评估之间反复选择,可能将随机胜者转化为永久搜索状态。进化前,RRSI 反复评估未改动的基础 harness,并估计经验噪声带 δ。令 S⋆ 表示目前观察到的最佳 evolve 集得分。候选必须满足经过噪声调整的下界
S^(H′)≥S⋆−δ.该下界可防止搜索通过一系列小到可被误认为噪声的退化步骤持续下坡。
Ridge 或 L2 风格的复杂度感知接受
对于候选 H′ 相对当前 harness Ht,定义
ΔS=S^(H′)−S^(Ht),ΔC=C^(Ht)C^(H′)−C^(Ht).对于测量增益超过噪声带的候选,即 ΔS>δ,RRSI 要求
ΔC≤β0+β1ΔS.其中,β0 设置了在可忽略得分增益下所容忍的成本增加量,β1 控制随着测量改进增大而允许的额外成本。这些值在 evolve 集上选择并保持固定。因此,额外推理成本必须由可测量的性能改进来证明。该流程使用策略 token 成本作为总资源占用的通用可测量代理,对无约束增长产生类似 Ridge 的收缩效应。
Lasso 或 L1 风格的结构剪枝
式 (4) 中的退火预算使每次更新稀疏化,而剪枝使保留的 harness 稀疏化。RRSI 跟踪最近被使用过的组件是否在固定剪枝窗口内产生严格为正的测量增益。始终保持无效的组件会在后续轮次中被报告给提案器作为删除目标。这类似于 Lasso 风格稀疏化:效用证据不足的机制会被完全移除,因此保留的 harness 在结构上变得更稀疏,而不仅仅是总体成本更低。机制必须持续证明其存在价值,而不能仅因为只看得分的进化没有动力删除它而一直保留。
实验
RRSI 在覆盖编程、智能体工作空间和工程设计任务的八个基准上进行了评估,进化后的 harness 在分布内留出划分以及搜索期间从未见过的分布外基准上进行测试。与相同基础 harness、策略和候选预算下的未进化基线和先前 harness 进化基线相比,RRSI 是唯一在留出和分布外性能上持续提升且无退化的方法,其增益在确定性模拟器评分下仍然保持。消融实验表明,提案侧和接受侧正则化器对迁移和成本控制都很重要,进一步分析表明 RRSI 能跨不同策略族泛化,并泛化到搜索期间从未使用的更小 backbone,同时产出最轻量的进化 harness。
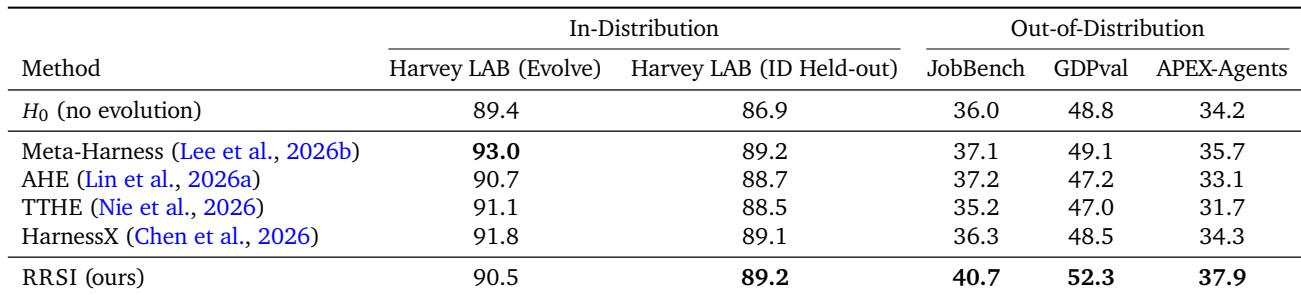
在智能体工作空间任务上,先前 harness 进化方法能改善 evolve 划分,但增益大多无法迁移到分布外。RRSI 在进化方法中取得最小的 evolve 集增益,却相对未进化的 harness 产生了最清晰的分布外改进,且没有留出退化。分布内留出性能在各方法之间相近,而分布外结果颠倒了 evolve 集排名。所有先前方法都改善了 evolve 划分,但只有 RRSI 在分布外平均得分上比基础 harness 高出超过一个点。Meta-Harness 是 evolve 划分上最强的基线,但在分布外只增加不到一个点;HarnessX 与基础持平,AHE 和 TTHE 则低于基础。分布内留出得分在不同方法之间保持紧密聚集,因此 evolve 集增益并不能预测迁移。
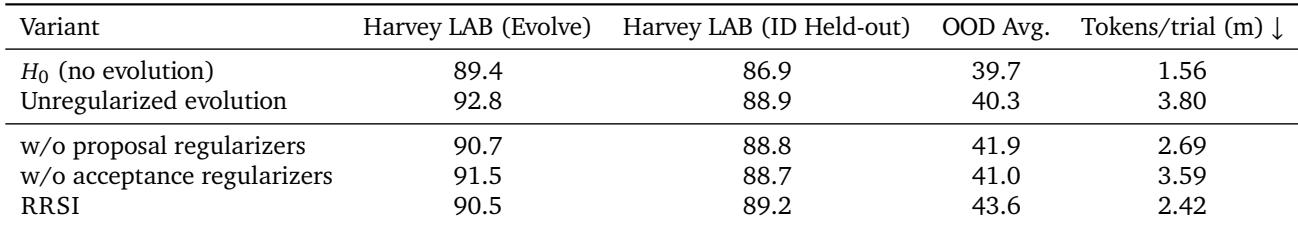
消融任意一组正则化器都会提高 evolve 集得分,但会降低分布外性能;移除接受侧约束还会急剧增加 token 成本。移除两类约束会获得最高的 evolve 集得分,但迁移性能仍接近未进化基线。完整的 RRSI 配置在进化变体中获得最佳的分布外和留出结果,且 token 使用量低于任何消融或未正则化的进化 harness。移除提案侧或接受侧正则化器会用迁移性能换取 evolve 集增益;移除接受侧还会大幅增加 token 成本。完整 RRSI 配置在进化 harness 中获得最高的分布外平均得分和留出得分,同时每次试验使用的 token 少于所有消融或未正则化的进化变体。
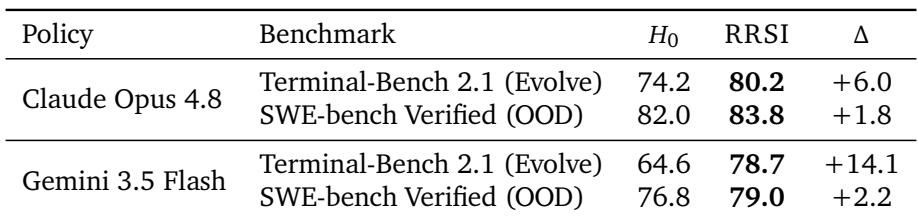
正则化 harness 进化在 Terminal-Bench 上同时提升了 Claude Opus 4.8 和 Gemini 3.5 Flash 的编程性能,并将增益迁移到未见过的 SWE-bench Verified。得分较低的 Gemini 策略获得更大的域内增益,而较强的 Claude 策略提升较小,因为它起始时更接近上限。两种策略都表现出相似的适度迁移增益,说明该收益并不局限于某个策略族。RRSI 在两种策略下都提升了 Terminal-Bench 2.1,其中 Gemini 3.5 Flash 的增益大于 Claude Opus 4.8。两种策略在 SWE-bench Verified 上都有提升,且迁移增益相近。较强的 Claude 策略起点更高,总体增益更小,这与剩余空间较少一致。
进化后的 harness 同时提升了 Gemini 3.5 Flash 搜索策略和未见过的 Gemini 3.1 Flash Lite backbone 在 Terminal-Bench 2.1 上的准确率。较弱的未见过模型显示出更小的绝对增益,但相对提升显著,表明该 harness 机制可以跨能力级别迁移。搜索策略在进化 harness 下于 Terminal-Bench 2.1 上获得 14.1 个点。未见过的较弱策略获得 3.4 个点,相对其基础得分提升 30.4%,尽管它从未参与搜索。
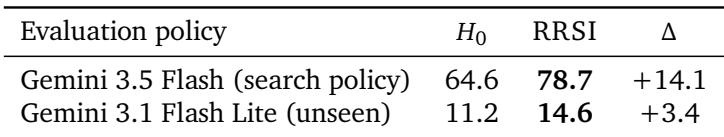
实验在智能体工作空间和编程基准上评估了正则化 harness 进化,将 RRSI 与先前 harness 进化方法和消融进行了比较。RRSI 仅产生适度的 evolve 划分增益,但具有最清晰的分布外和留出迁移,token 成本低于消融或未正则化变体;移除任意正则化器会用迁移性能换取 evolve 集增益,移除接受侧约束会急剧增加 token 使用量。进化后的 harness 还能在多个策略上提升 Terminal-Bench,并迁移到 SWE-bench Verified,较弱的模型表现出更大的相对增益,包括未见过的较弱 backbone 获得 30.4% 的相对提升。