Command Palette
Search for a command to run...
用于量子增强扩散语言模型的电路超网络
用于量子增强扩散语言模型的电路超网络
Xiaoqiang Wang Mengyang Xiong Jun Dai Bang Liu
摘要
语言模型可以通过改变应用于单个 token 的计算方式进行适配。量子电路提供了一种这样的方法,但在大型模型内部评估更宽的电路可能带来较高的计算开销。本文提出 HyperQ,它向冻结的掩码扩散语言模型中添加以 token 为条件的量子残差分支。量子残差分支是每个 Transformer 块中的一个模块,它读取 token 的隐藏状态,生成该 token 电路的坐标,执行该电路,并将测量值通过残差连接加回。主干网络保持冻结,仅训练新增分支。在每个分支内部,轻量级电路超网络在共享的稀疏电路结构中生成针对各 token 的旋转角度、耦合强度和测量轴。所需期望值具有精确的经典表达式,其求值成本随量子比特数线性增长,从而能够在 11 亿参数的主干网络内训练 16 至 64 量子比特的电路。在下游基准测试中,增加电路宽度将平均得分从 47.65 提高到 54.30。在 64 量子比特下,HyperQ 分别比主干网络及其低秩适配对应模型高出 4.71 和 3.67 分。HyperQ 在 20,000 个提示—响应对上进行微调,而经典基线使用 200,000 个。这些发现支持将以 token 为条件的电路生成作为一种易处理的架构方法,用于量子增强语言建模。
一句话总结
蒙特利尔大学、Mila、魁北克人工智能研究所和麦吉尔大学的研究人员提出 HyperQ,它在冻结的掩码扩散语言模型中添加以 token 为条件的量子残差分支,由轻量级电路超网络在共享稀疏电路结构中生成针对具体 token 的旋转角度、耦合强度和测量轴。精确的经典期望值使 16 到 64 量子比特的电路能够在 11 亿参数骨干网络中被训练,将下游基准平均分从 47.65 提高到 54.30。
核心贡献
- 论文提出 HyperQ,一种在冻结的掩码扩散语言模型中添加以 token 为条件的量子残差分支的架构。每个分支读取 token 隐藏状态,轻量级电路超网络在共享稀疏电路结构中生成针对具体 token 的旋转角度、耦合强度和测量轴,量子读出被投影回查询、键和值张量。
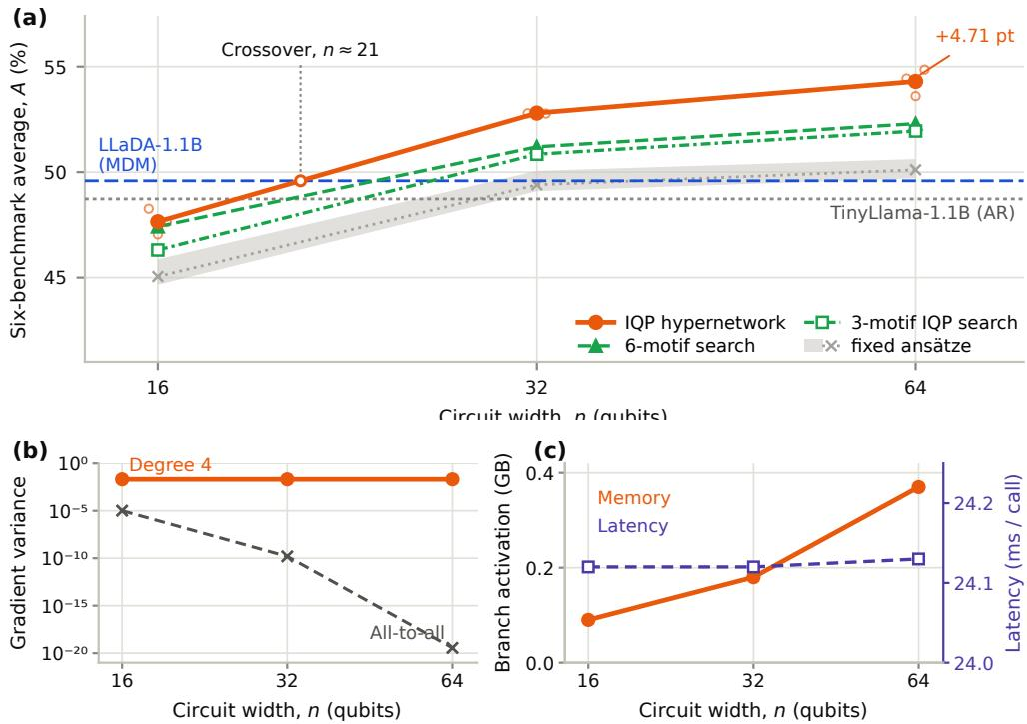
- HyperQ 将生成的电路限制为固定环加弦骨架上的二体 IQP 电路,且量子比特度为四,从而得到精确的经典期望值,成本随量子比特数量线性增长,梯度方差有界。这使 16 到 64 量子比特电路能够在 11 亿参数骨干网络中被训练,而无需完整态矢量模拟。
- 在六个下游基准上的实验表明,增加电路宽度将平均分从 47.65 提高到 54.30,64 量子比特模型比冻结骨干网络高 4.71 分,比经典低秩适配器高 3.67 分,同时使用 20,000 个提示-响应对,而不是 200,000 个。没有声称量子优势,且读出在每个测试宽度下仍保持经典高效。
引言
大语言模型依赖基于注意力的 transformer,掩码扩散模型现在通过在双向上下文下对掩码位置去噪,提供了一条非自回归路径。由于模型和数据的规模扩展推动了大部分进展,目前仍不清楚另一种网络内部计算,例如以 token 为条件的量子电路层,是否会随着电路宽度增加而变得更有用。先前的量子 transformer 工作主要研究固定电路资源下的参数高效适配,因此没有说明增加量子比特是否改善语言建模质量。主要障碍是可训练性和模拟成本:非结构化变分电路可能出现贫瘠高原,而通用态矢量模拟随量子比特数量呈指数扩展。作者提出 HyperQ,一种以 token 为条件的量子分支,以并行方式附加到掩码扩散骨干网络中冻结的查询-键-值投影上。低秩超网络将每个隐藏状态映射到具有环和弦骨架的二体 IQP 电路参数,实现 Θ(n) 读出成本和度为四的梯度方差,且该方差在测试宽度范围内不会缩小。在 11 亿参数冻结骨干网络上,随着宽度从 16 量子比特增加到 64 量子比特,HyperQ 将下游基准性能从 47.65 提高到 54.30,超越冻结骨干网络和经典低秩适配器,同时作者声明没有量子优势。
数据集
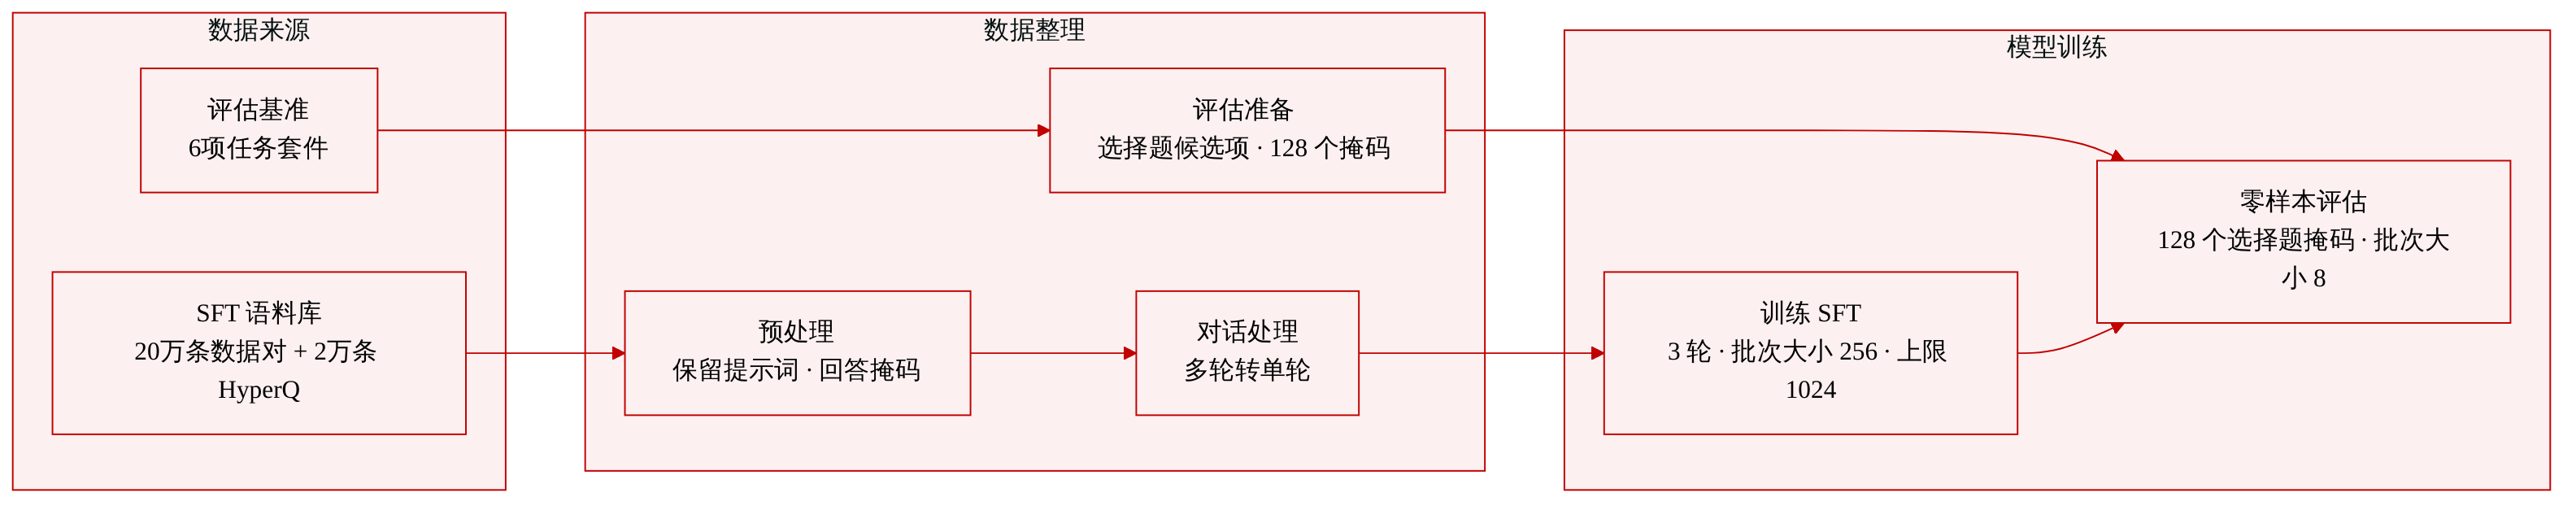
作者描述两种数据工作流:监督微调和零样本评估。
监督微调数据
- 来源:遵循 LLaDA 8B 所报告的监督微调设置的指令微调语料库。
- 基线子集:200,000 个提示-响应对。
- HyperQ 子集:均匀采样的 20,000 对子集,包含基线所用 token 的大约十分之一。
- 预处理:提示 token 保持不被损坏;响应 token 被独立掩码。
- 目标掩码:掩码交叉熵扩散目标仅应用于被掩码的响应位置。
- 填充约定:序列结束填充 token 被视为响应的一部分,因此模型学习何时停止。
- 对话处理:多轮对话被拆分为单轮对话对。
- 训练格式:三个 epoch,全局批次为 256 对。
- 序列长度:对于 HyperQ,每个序列都限制在 L = 1024 个 token 的块上限内。
评估数据
- 完整任务套件包括 HellaSwag、ARC-e、ARC-c、WinoGrande、PIQA、OpenBookQA、MMLU、BoolQ、RACE、GSM8K、LAMBADA cloze 和 TruthfulQA mc2。
- 主要摘要平均值使用六个基准:ARC-e、HellaSwag、PIQA、BoolQ、RACE 和 GSM8K。
- 额外提到的评估公开数据包括用于困惑度的 WikiText 和 GLUE。
- 评估处理:零样本评估使用 eval mdm pipeline,这是一套适配掩码扩散读出的 lm-eval 风格测试框架。
- 对于多项选择题,每个候选补全通过扩散界下的条件对数似然打分,每个项最多 128 个蒙特卡洛掩码样本,评估批次大小为 8。
- 硬件验证:在每个基准中,从完整发布划分中均匀随机抽取 256 个项,使每个基准具有相等代表性。每个 token 生成并执行一个电路,选定项在完全相同的模型权重下同时使用精确解析读出和硬件读出进行打分。
方法
作者提出 HyperQ,一种将量子残差分支集成到其 22 个 transformer 块中的掩码离散扩散模型。底层扩散模型通过迭代预测掩码位置来解码文本。在中间轮次 t,去噪器预测 token 分布 pθ(⋅∣xt),对最有信心的预测进行提交,并对其余位置进行掩码以进一步细化。HyperQ 保留这一迭代去噪过程,但通过将量子电路读出作为残差注入融合的查询-键-值投影,修改了每轮计算的内部表示。
在每个 transformer 块中,量子残差分支计算一个 n 量子比特瞬时量子多项式时间(IQP)块。电路骨架由固定边集 E 定义,包括连接相邻量子比特的环层和以与 n 互质的固定步长连接量子比特的弦层。该结构确保每个量子比特恰好有四个耦合,保持 ∣E∣=2n。不是从离散目录中选择电路,而是由条件超网络为每个 token 生成连续坐标。低秩适配器将骨干隐藏状态 h 映射到秩 r 编码 b,并馈入三个头。第一个头生成单量子比特旋转角 α=πtanhb。第二个头为 E 中的边生成双量子比特耦合角 ωE,第三个头生成每个量子比特的读出轴 ψ∈S2。
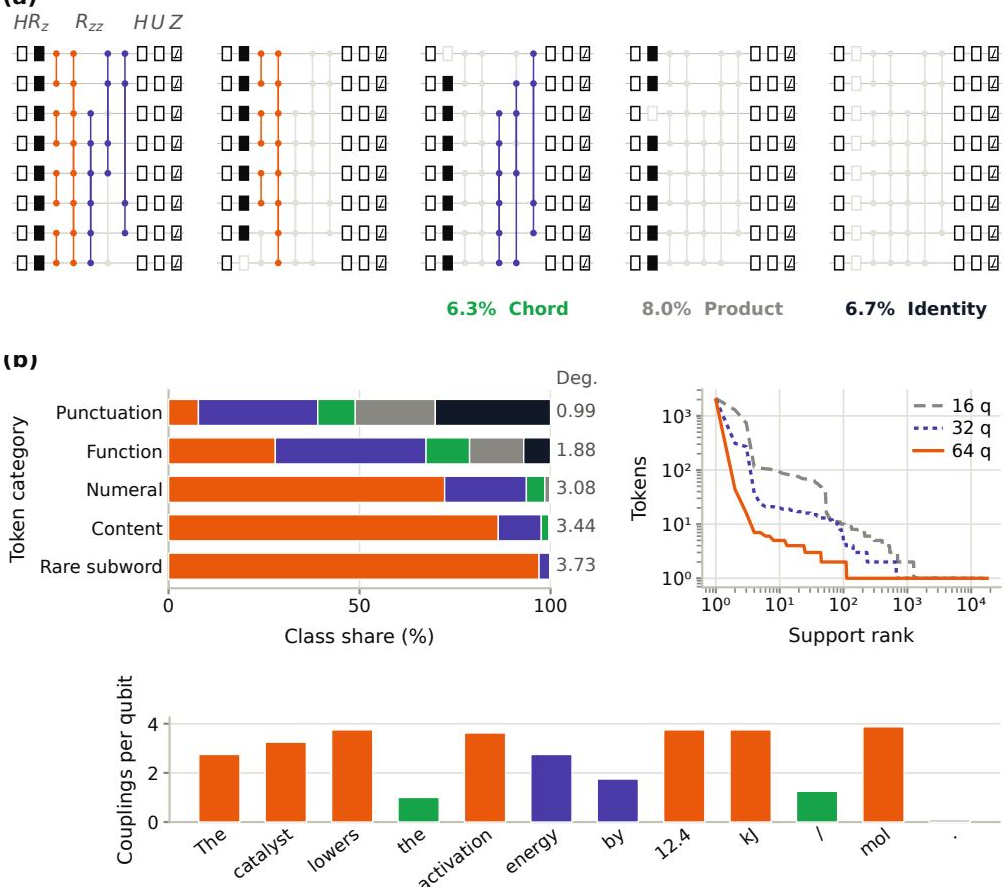
生成的坐标指定严格 IQP 块,该块应用 Hadamard 层、包含单量子比特 Rz 旋转和双量子比特 Rzz 耦合的对角内部层,以及第二个 Hadamard 层。然后读出旋转 U(ψ) 设置测量轴。由于内部生成元的权重至多为二,并且位于固定边集 E 上,期望值 ⟨Zq⟩ 可以闭式求值为 zq=(ψq,zcosαq−ψq,ysinαq)∏k∈N(q)cosωqk。该解析表达式允许在 Θ(n) 时间内计算读出,而无需构建完整的 2n 态矢量,使每 token 模拟在 64 量子比特下可行。此外,相对于所生成坐标的梯度方差仅取决于量子比特度,该度保持为四,从而在寄存器宽度增加时避免贫瘠高原。
对于硬件执行,综合过程将生成的架构降低为具体电路,方法是将每个耦合编译为对应边上的受控 Z 旋转。由于边集 E 固定,电路布局和深度在不同 token 之间保持恒定,因此每个寄存器宽度只需路由一次。在转译过程中,电路被映射到目标后端的原生门集。
训练过程仅优化低秩量子分支及其电路头,同时保持 11 亿参数骨干网络冻结。模型使用掩码交叉熵扩散界训练,该界限是干净序列负对数似然的上界。目标在干净序列、掩码水平和所得损坏序列上最小化。作者使用 AdamW 和余弦学习率调度,在八块 NVIDIA A100 GPU 上训练三个 epoch。LoRA 适配器使用秩 16 和缩放因子 32。
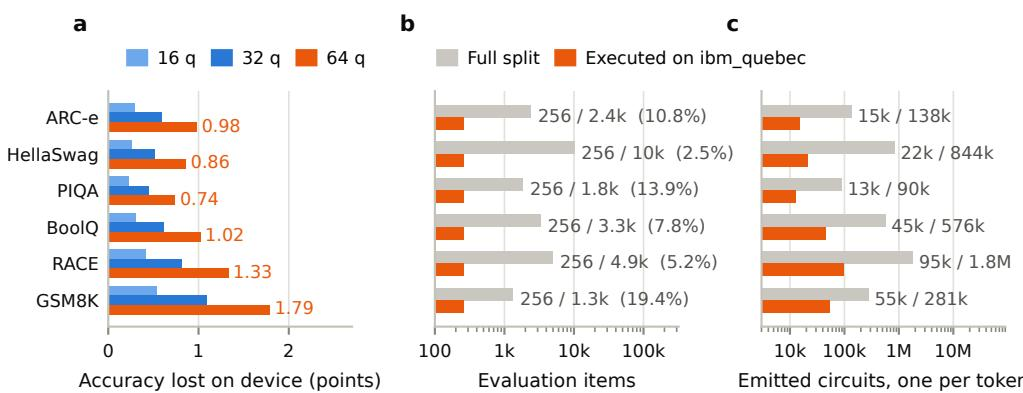
为了验证硬件执行,作者比较训练期间使用的解析闭式读出与从 ibm_quebec 处理器获得的设备读出。评估表明,虽然设备读出误差会因噪声而随寄存器宽度增加,但生成的电路在不同基准上保持性能。硬件运行将转译后的电路批量提交到单个作业中,在执行前验证编译后的电路在严格容差内与张量网络收缩一致。
实验
实验评估 HyperQ,即添加到冻结 LLaDA 掩码扩散骨干网络的量子残差分支,使用六个基准零样本套件以及 WikiText 和 GLUE,并与经典基线、固定量子拟设、离散 motif 搜索以及 16、32 和 64 量子比特下的连续逐 token 生成进行比较。HyperQ 在整体下游准确率上达到最高,并随着寄存器宽度增加继续改善,不同于会饱和的固定电路;经典低秩适配器只占收益的一小部分,表明以 token 为条件的连续电路坐标带来好处。辅助评估显示,生成的电路按 token 类别调整纠缠支持,允许线性时间经典读出和硬件转译,保持任意顺序并行解码,在噪声超导处理器上仅出现有界准确率损失。
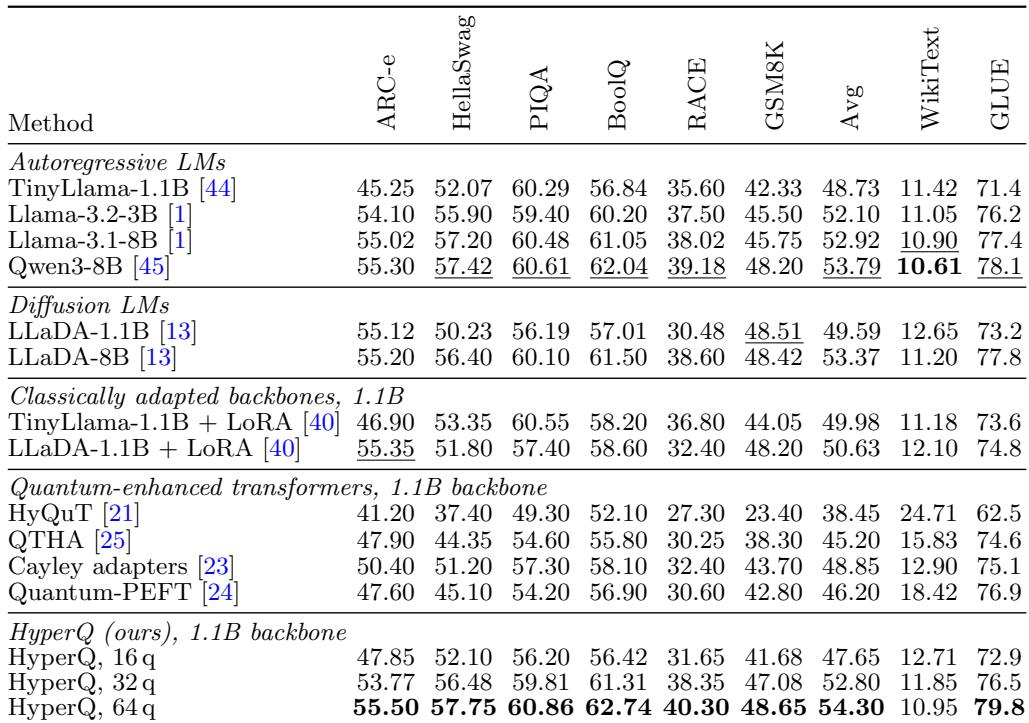
HyperQ 在所有六个评估基准上取得了最高零样本准确率,超越更大的经典基线,同时仅使用其微调 token 的一小部分。低秩适配器对冻结扩散骨干网络只带来适度提升,因此大部分收益归因于生成的量子电路。WikiText 困惑度是已报告指标中 HyperQ 未领先的唯一一项;Qwen3-8B 取得了更好的困惑度。HyperQ 在每个零样本准确率列中领先,并超越规模达其八倍的经典模型。低秩适配器将冻结骨干网络提高约 1.25 个点,而完整的量子增强模型在已适配骨干网络之上带来更大的提升,表明生成的电路推动了大部分改进。WikiText 困惑度仍是已报告列中 HyperQ 落后的唯一一项,Qwen3-8B 得分更低。早期的量子增强模型使用不同的评估套件,因此没有共享基准可供直接比较。
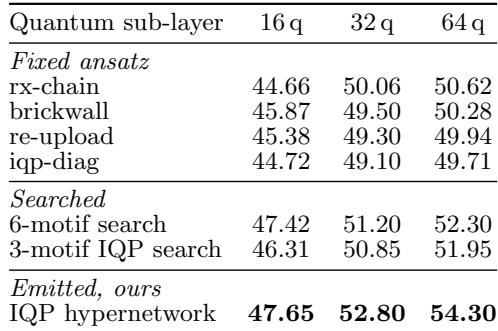
连续逐 token 电路生成在所有寄存器宽度上优于手工设计的拟设和离散 motif 搜索,并且优势随着量子比特数增加而扩大。手工设计电路在 32 量子比特后开始饱和,而生成的电路继续改进。生成方法仍处于 IQP 家族内,却仍然超过可以离开该家族的搜索。随着寄存器宽度从 16 量子比特增加到 64 量子比特,生成的电路相对于最佳固定拟设的优势幅度不断扩大。在 16 量子比特时,两条自动路径都没有超过冻结骨干网络基线,但这一劣势在更大宽度下消失。生成的电路超过最接近的固定类似电路的幅度,大于固定电路家族之间的整体差异。连续生成仍处于 IQP 家族内,同时优于可以选择家族外电路的离散 motif 搜索。
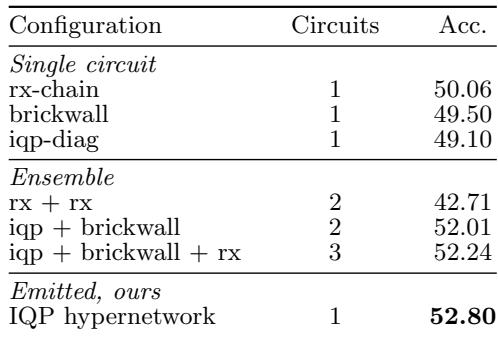
在 32 量子比特下的六个基准平均值上,测试时集成受益于组合不同电路家族,而不是在同一家族中增加更多电路。混合 iqp 加 brickwall 集成优于单个固定电路,而 rx 加 rx 集成表现更差。即使是最好的固定集成也仍低于连续逐 token 生成的电路,后者在单次推理中取得更高准确率。在 32 量子比特下,混合 iqp 和 brickwall 电路相比任何单个固定电路都能提高准确率。与单电路基线相比,组合两个 rx 家族电路会大幅降低准确率。单个生成的电路超过固定测试时集成,表明生成带来的多样性比集成固定家族更有效。
HyperQ 在六个零样本准确率基准和 WikiText 困惑度上接受评估,在所有准确率列中领先,并超越规模达其八倍的经典模型;低秩适配器仅带来适度提升,生成的量子电路贡献了大部分改进;WikiText 困惑度是 Qwen3-8B 表现更好的唯一指标。连续逐 token 电路生成在各个寄存器宽度上优于手工设计的拟设和离散 motif 搜索,且优势从 16 量子比特到 64 量子比特不断扩大;生成的电路仍处于 IQP 家族内,却优于可以离开该家族的搜索。测试时集成显示,混合 IQP 和 brickwall 等不同电路家族有帮助,但混合同一家族的 RX 电路有害,而单个生成的电路仍超过固定集成。总体而言,结果验证了学习到的连续电路生成提供了超出固定电路家族和经典基线的多样性与规模收益。