Command Palette
Search for a command to run...
Tactile-JEPA:面向分布式触觉传感器的拓扑感知自监督表示学习
Tactile-JEPA:面向分布式触觉传感器的拓扑感知自监督表示学习
Elizaveta Kovtun Matvey Konovalov Andrey Sakhovskiy Semen Budennyy
摘要
触觉感知是机器人在执行接触密集、灵巧操作时的一种关键模态,尤其是在视觉遮挡情况下。虽然预训练图像编码器已是机器人学习流程中的标准组件,触觉编码器通常仍从原始噪声信号从头训练,这可能限制其表达能力。现有自监督学习(SSL)方法主要关注基于视觉的触觉传感器,分布式电子皮肤在很大程度上尚未得到解决。然而,这些传感器具有一个独特性质:其传感单元在覆盖表面上稀疏且不规则排列,这使得直接复用视觉 SSL 方法并非最优。我们提出 Tactile-JEPA,一种高效的自监督预训练方法,利用触觉传感器的空间排列来学习拓扑感知表示。具体而言,它被训练为根据未被掩码的剩余部分预测被掩码传感单元的嵌入,并利用传感器连接图引导空间掩码。我们的分析表明,有效的触觉表示需要同时捕获局部接触细节和触觉表面的全局状态,我们通过双尺度掩码实现这一点。在覆盖磁传感器和压阻传感器、不同机器人本体以及单传感器和成对传感器配置的三个不同数据集上,Tactile-JEPA 相比先前最优方法将力估计误差降低 6.3%,将手内姿态误差降低 20.8%,并在包括策略学习在内的其他下游应用中取得一致增益。总体而言,我们的结果表明,触觉感知的益处关键取决于编码器预训练的质量,而 Tactile-JEPA 直接解决了这一问题。代码可在 https://github.com/E-Kovtun/tactile 获取。
一句话总结
作者提出了 Tactile-JEPA,一种面向分布式触觉传感器的拓扑感知自监督预训练方法,该方法利用传感器连接图和双尺度掩码,从可见的剩余部分预测被掩码传感单元嵌入,以捕获局部接触细节和全局表面状态,将力估计误差相较先前最优方法降低 6.3%,将手中姿态误差降低 20.8%。
核心贡献
- Tactile-JEPA 是一种面向分布式触觉传感器的自监督预训练方法,它利用传感器连接图和双尺度掩码,根据可见 taxel 预测被掩码 taxel 的嵌入,从而直接从多元时间序列信号中学习拓扑感知的多尺度表示。
- 在磁阻和压阻传感器、不同机器人本体以及单传感器和配对传感器配置上,Tactile-JEPA 相比先前最优方法将力估计误差降低 6.3%,将手中姿态误差降低 20.8%,并在包括策略学习在内的下游应用中取得一致提升。
- 实验研究表明,在传感器连接图上采样的掩码优于图像式块掩码,并且掩码尺度决定了局部性:局部或全局掩码分别有利于特定下游任务,而混合使用时迁移效果更广泛。
引言
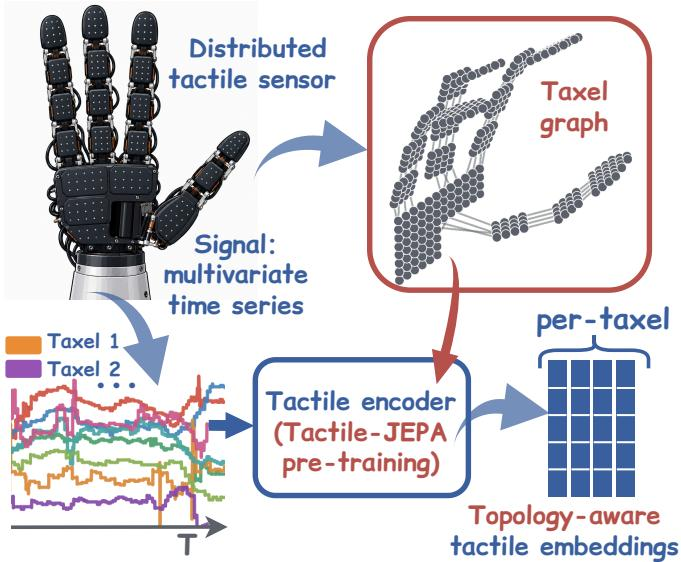
机器人日益需要在许多任务和环境中泛化,视觉-语言-动作模型支持这一目标,但主要依赖视觉。在严重遮挡、灵巧接触密集操作和易碎物体抓取等场景下,仅靠视觉会受到限制,此时触觉感知至关重要。分布式电子皮肤是一种有前景的触觉形态,但其输出是分布在稀疏、不规则 taxel 上的多元时间序列,而不是图像,因此缺乏视觉领域可用的大规模预训练表示。先前的自监督触觉方法通常继承了像素网格假设,仅编码每个 taxel 的位置而没有传感器连接关系,或依赖任务特定标签和仅来自仿真的几何信息。作者用 Tactile-JEPA 填补这一空白,这是一种面向分布式触觉传感器的自监督表示学习方法,利用在传感器连接图上按局部和全局尺度采样的掩码,根据可见 taxel 预测被掩码 taxel 的嵌入,从而产生拓扑感知的多尺度表示。
数据集
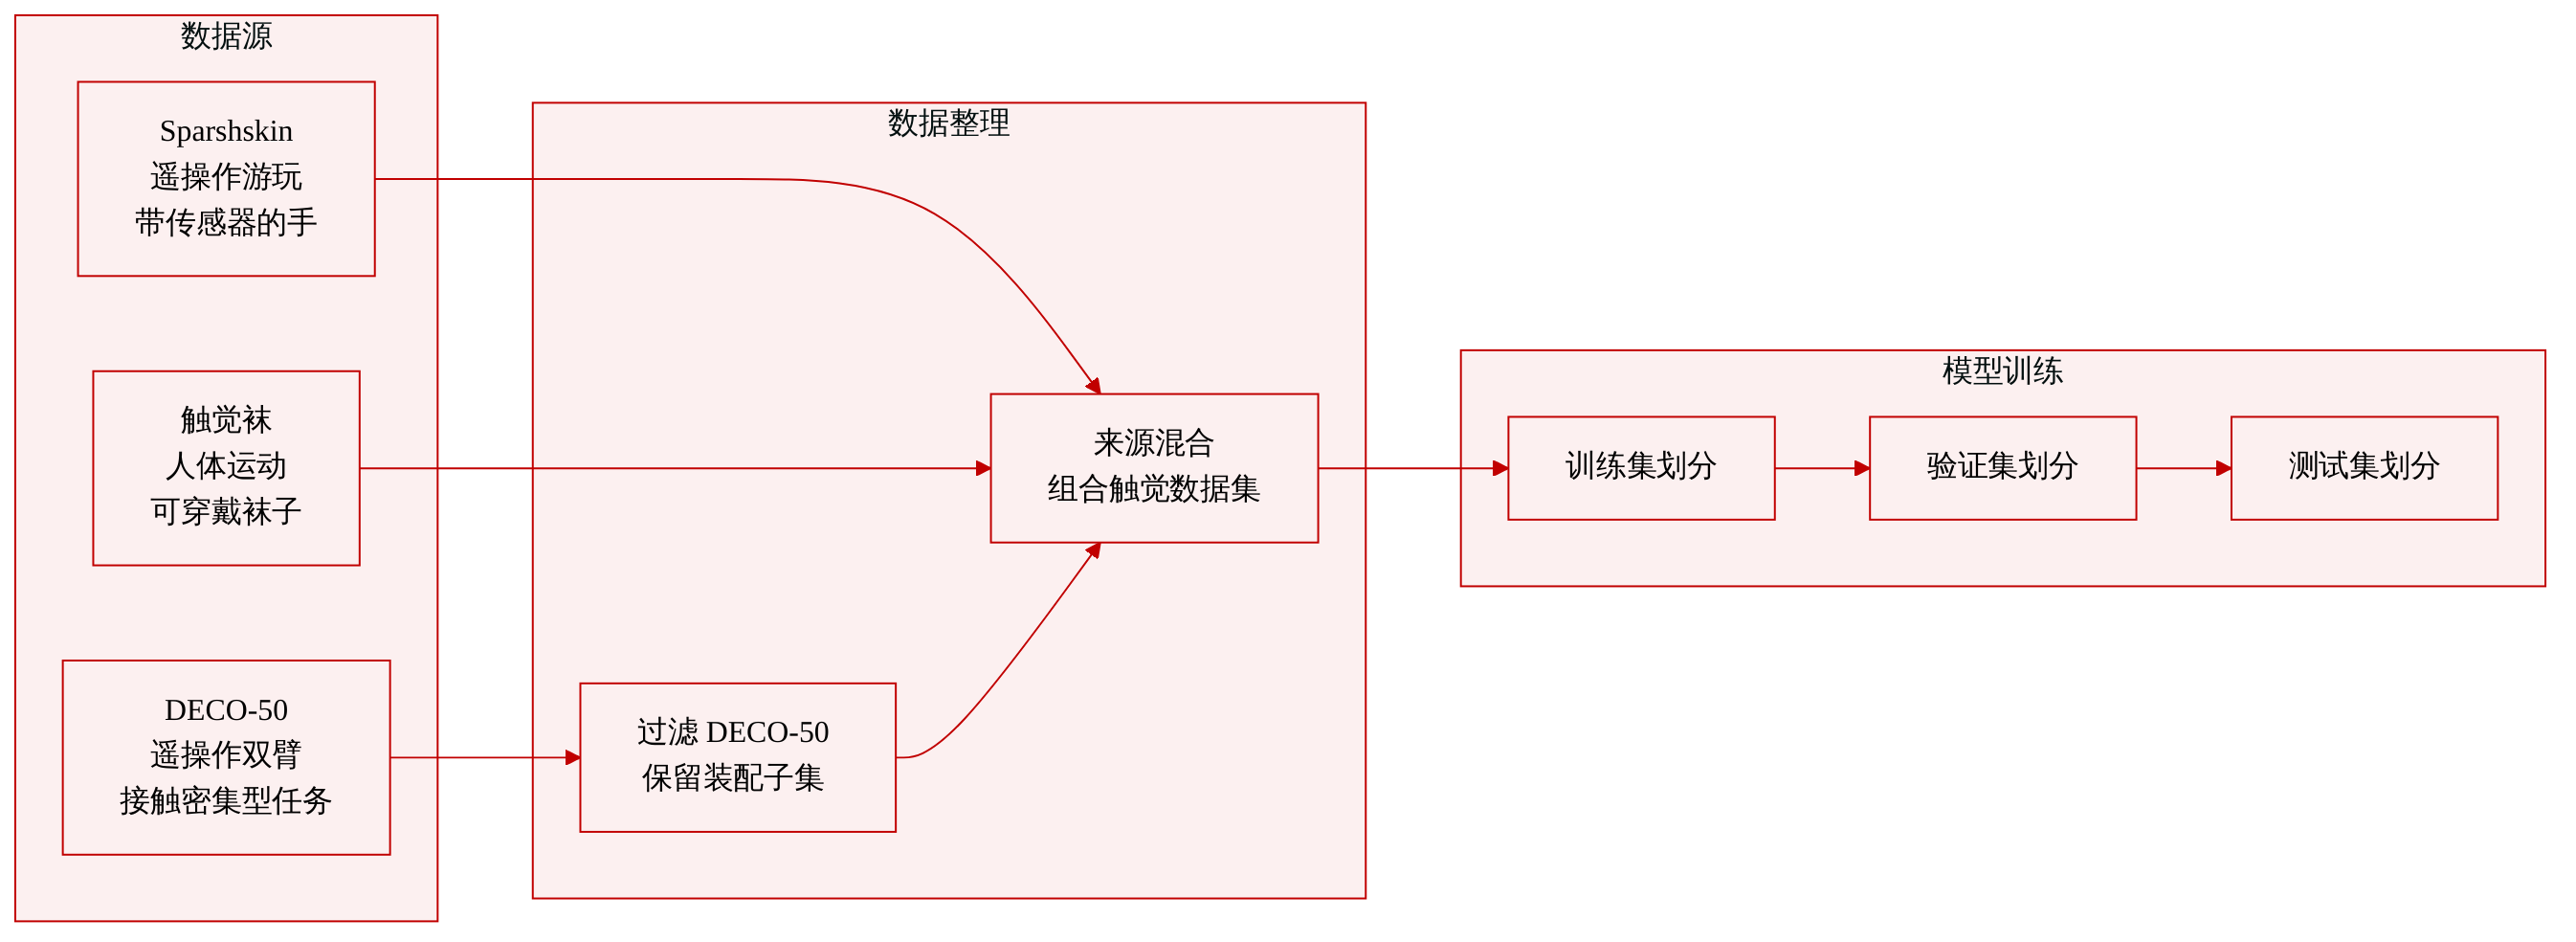
作者在三个公开触觉数据集上评估 Tactile-JEPA,这些数据集经过选择以覆盖不同的传感原理、机器人本体和下游任务。
-
Sparshskin 来源:使用配备传感器的机器人手采集的遥操作交互数据。
-
Tactile socks 来源:从可穿戴触觉袜子记录的人体运动数据。
-
DECO-50 来源:在双臂机器人上采集的接触丰富操作任务的遥操作演示。 筛选:仅使用 Assembly 任务子集,因为它是最依赖触觉的子集。
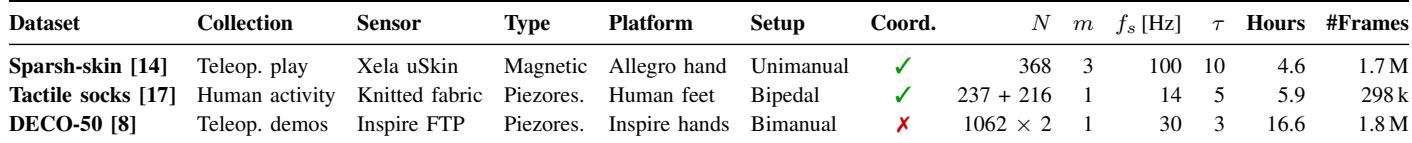
本节未包含完整数值规模、筛选阈值、裁剪或元数据构造细节。这些特征在论文表 I 中报告。
在使用上,作者用这些数据集在多种触觉传感设置和任务类型中评估 Tactile-JEPA。节选内容未描述训练划分比例或混合权重,重点在于评估所用的数据集选择。
方法
作者提出了 Tactile-JEPA,这是一种为分布式触觉感知定制的自监督表示学习框架。该方法在嵌入空间中学习根据可见触觉传感器预测被隐藏触觉传感器的潜在表示,从而有效避免直接预测含噪原始信号。
如框架图所示:
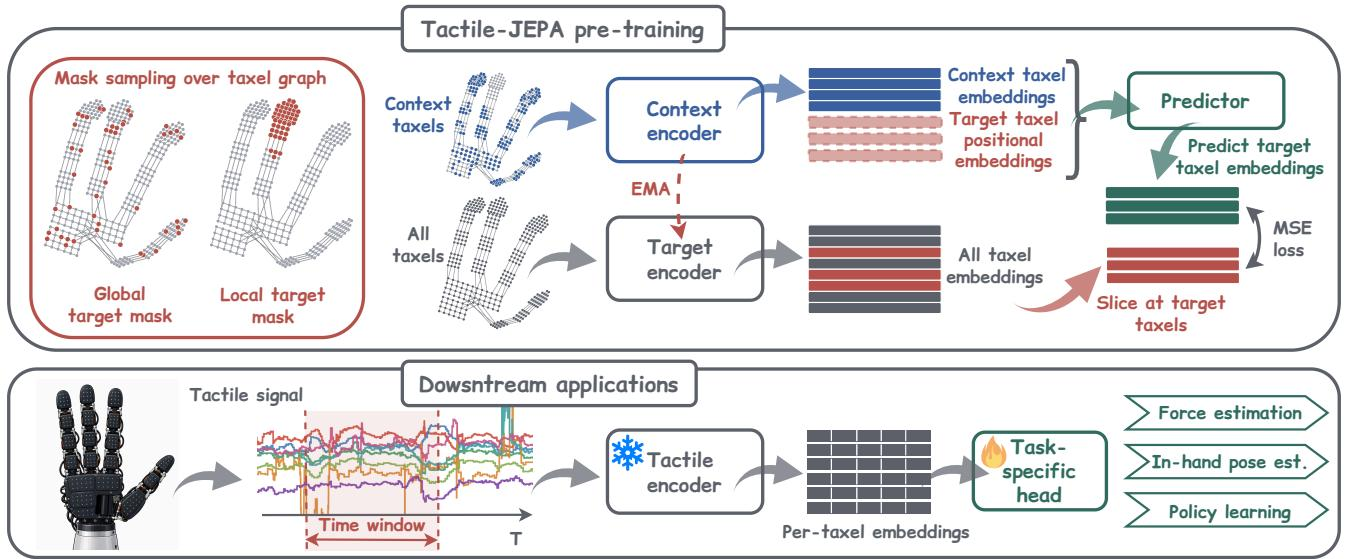
整体流程分为两个主要阶段:自监督预训练和下游任务适配。在预训练期间,模型处理触觉信号的短时间窗口,以捕获接触动态,而不建模长期时间结构。这种设计使编码器能够在推理时以控制环频率被调用,较长历史由连续嵌入组合而成。
输入表示与图构建 设特定 taxel 在 τ 帧时间窗口内的响应表示为 xi(k)∈Rτ×m。作者使用共享仿射投影和随后的层归一化,将该窗口响应映射为 d 维嵌入:
x~i(k)=LN(Wvec(xi(k))+b)∈Rd其中 vec(⋅) 将信号展平,W 和 b 是可学习的投影参数。对所有 N 个 taxel 堆叠这些嵌入,得到输入表示 X~τ(k)∈RN×d。
为捕获传感器的空间拓扑,作者构建一个 taxel 连接图 G=(V,E)。节点 V 表示 taxel,边 E 根据已知传感器布局连接物理相邻的 taxel。该图在时间窗口之间保持不变,并且不需要显式坐标信息。
基于图的掩码采样 自监督任务依赖于将 taxel 划分为可见上下文区域和隐藏目标区域。作者直接在 taxel 连接图上采样这些区域,而不是在标准像素网格上采样。他们定义两种不同的目标掩码来捕获多尺度接触模式。局部掩码形成一个覆盖紧凑传感器区域的连通子图,以学习局部接触线索。相反,全局掩码由均匀散布在整个图上的 taxel 组成,以反映本体整体的接触状态。两种掩码类型在训练中联合使用。上下文掩码的构造方式与全局掩码类似,确保与目标 taxel 不重叠。
编码与预测 触觉编码器采用 transformer 实现。处理前,每个 taxel 嵌入与一个可学习位置嵌入相加。预训练阶段使用两个编码器实例。上下文编码器 Eθ 只处理上下文区域 Cj 内的嵌入:
ZcontextCj=Eθ({x~i(k)+ei}i∈Cj)∈R∣Cj∣×d目标编码器 Eθˉ 共享相同架构,但处理所有 taxel 以生成真实表示:
Ztarget=Eθˉ({x~i(k)+ei}i∈V)∈RN×d基于 transformer 的预测器 Pϕ 从观测到的上下文推断隐藏目标表示。对于给定的上下文-目标对,预测器接收上下文嵌入与目标 taxel 的位置嵌入相拼接的序列,其中每个都加上一个可学习的掩码向量 u:
Z^(Cj,Tl)=Pϕ(ZcontextCj∥{ei+u}i∈Tl)∈R∣Tl∣×d预测器内对拼接后的序列计算注意力,并仅保留目标位置的输出。
自监督训练目标 训练目标最小化预测目标嵌入与目标编码器实际输出之间的均方误差。损失在所有上下文和目标掩码对上取平均:
LSSL=ncnt1j=1∑ncl=1∑nt∣Tl∣1i∈Tl∑z^i(j,l)−sg(zi(l))22其中 sg(⋅) 表示停止梯度算子。反向传播只更新上下文编码器,而目标编码器参数维持为上下文编码器权重的指数滑动平均。
下游适配 在下游评估中,预训练的目标编码器被冻结,并用作触觉编码器。它将窗口化的触觉信号映射为每个 taxel 的嵌入,然后输入到在带标签数据集上训练的轻量任务特定头。这种模块化设计提供了灵活性,使相同嵌入能够支持多种应用,如力估计、手中姿态估计和策略学习,而无需在推理时提供布局信息。
实验
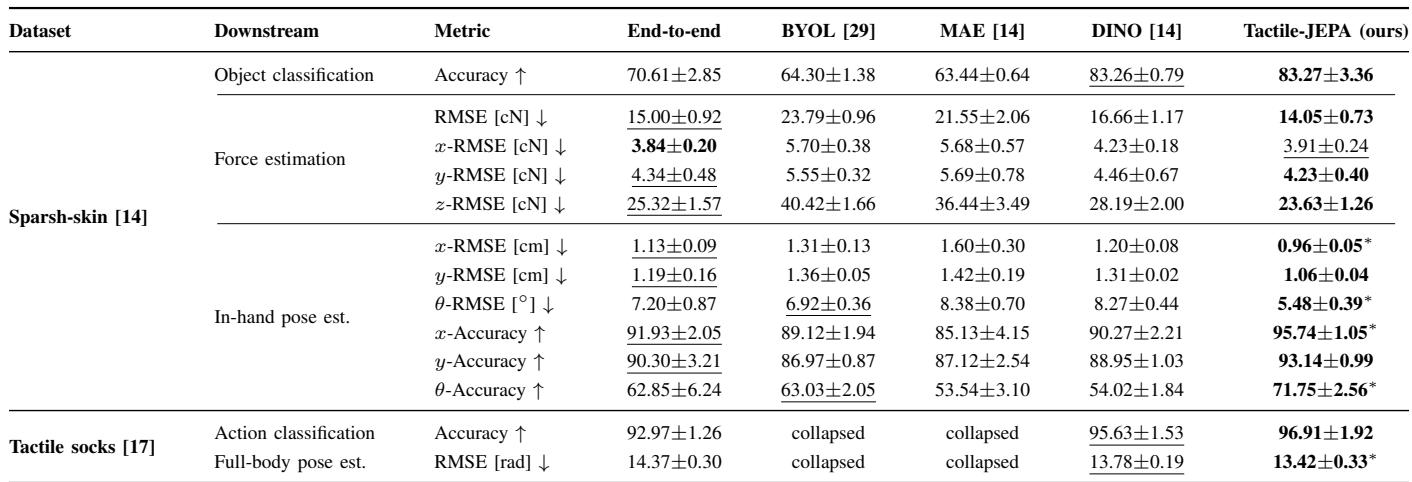
Tactile-JEPA 在三个公开触觉数据集 Sparshskin、Tactile socks 和 DECO-50 上进行评估,这些数据集涵盖不同的传感器类型、机器人本体和任务,包括力估计、手中姿态估计、物体和活动分类、全身姿态回归以及视觉-触觉操作策略学习。与 BYOL、MAE、DINO 和端到端基线相比,冻结的预训练表示将手中姿态 RMSE 降低 20.8%,将力 RMSE 降低 6.3%,同时在 DECO-50 上提供稳定的触觉感知策略学习。消融实验验证了混合局部和全局目标的基于图的多尺度掩码策略能产生稳健的通用先验,并且 Tactile-JEPA 在所有数据集上都稳定预训练,而若干竞争自监督方法在这些数据集上崩溃。
所比较的触觉数据集涵盖异构传感器、平台和采集设置,包括磁阻和压阻传感器,以及单臂、双足和双臂配置。Tactile-JEPA 在单一掩码配置下跨全部三个数据集稳定预训练,无需按数据集调参,而若干基线在特定数据集上崩溃。其预训练速度也明显快于 DINO,同时下游性能达到或超过 DINO。这些数据集在传感器类型、taxel 数量、传感轴、采样率和时长上差异很大,涵盖磁阻和压阻传感器,以及单臂、双足和双臂设置。Tactile-JEPA 在相同掩码配置下对所有异构触觉信号稳定训练,而 BYOL 在两个数据集上崩溃,MAE 在一个数据集上崩溃。混合局部和全局采样的多尺度目标掩码取得最佳的力估计和手中姿态精度,并在所有报告任务上优于不考虑图的掩码。Tactile-JEPA 在所有数据集上的预训练速度比 DINO 快 65% 至 75%,同时下游性能达到或超过 DINO。
Tactile-JEPA 学习到的通用触觉表示可跨机器人本体和下游任务迁移。它在物体分类、力估计和手中姿态估计上达到或超过强基线,在总体力和姿态误差上收益尤为明显。该方法还能高效预训练,并在异构触觉传感器上保持稳定,而一些自监督基线会崩溃。Tactile-JEPA 达到最高的物体分类准确率,并在所有评估方法中取得最低的总体力估计 RMSE。它产生最好的手中姿态估计,x 和 y 方向误差低于端到端基线和自监督基线。默认的多尺度目标掩码组合在力估计和手中姿态精度上表现强劲,并在各任务上优于不考虑图的掩码。Tactile-JEPA 的预训练速度明显快于 DINO,同时下游性能达到或超过 DINO。与 BYOL 和 MAE 不同,Tactile-JEPA 在不同触觉传感器类型上稳定训练。
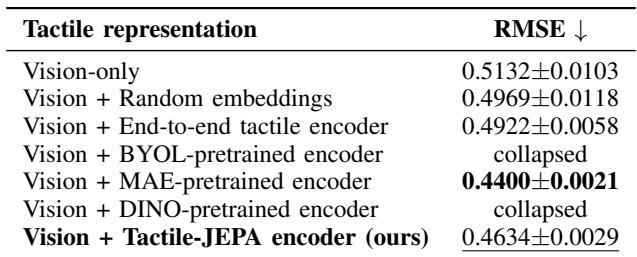
在 DECO-50 策略学习中,与仅视觉输入相比,加入触觉表示可降低 RMSE。预训练触觉编码器带来最大改进,其中 MAE 达到最低误差,Tactile-JEPA 在稳定方法中紧随其后。随机嵌入和端到端触觉编码带来的增益较小,而 BYOL 预训练和 DINO 预训练编码器崩溃。仅视觉策略的 RMSE 最高,而未崩溃的触觉表示改善了策略学习。MAE 预训练触觉编码器取得最低策略误差,其次为 Tactile-JEPA 编码器。随机嵌入和端到端触觉编码器优于仅视觉,但不如预训练编码器。BYOL 预训练和 DINO 预训练编码器在 DECO-50 上崩溃,而 MAE 和 Tactile-JEPA 没有。
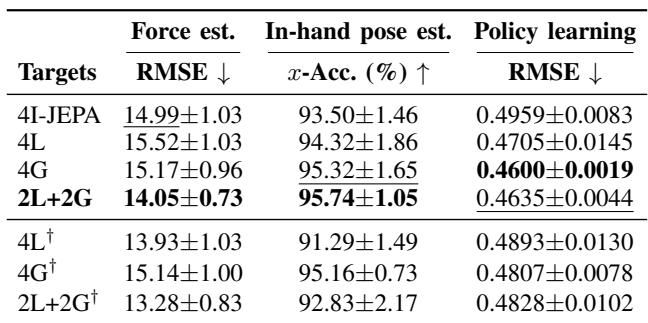
在目标掩码采样策略中,默认的多尺度组合(两个局部掩码和两个全局掩码)取得最强的力估计和手中姿态精度,同时在策略学习结果中紧排最佳结果之后。单尺度全局掩码在策略学习中表现最好,而多尺度设置在所有三个下游任务上优于不考虑图的 I-JEPA 掩码。将全局上下文替换为局部上下文可改善力估计,但会显著降低姿态和策略性能。默认的多尺度目标掩码组合在标准上下文设置中取得最佳的力估计和手中姿态精度。单尺度全局掩码取得最低策略学习误差,默认多尺度组合紧随其后。局部上下文采样改善力估计,但降低手中姿态和策略性能,证实全局上下文是更强的通用选择。
评估覆盖了异构触觉数据集,包括磁阻和压阻传感器以及单臂、双足和双臂设置,测试了物体分类、力估计、手中姿态估计和 DECO-50 策略学习上的表示质量。Tactile-JEPA 在一种掩码配置下稳定预训练,而 BYOL 和 MAE 在一些数据集上崩溃;其预训练速度明显快于 DINO,同时下游性能达到或超过 DINO。默认的多尺度目标掩码组合带来最佳的力和姿态精度,而单尺度全局掩码在策略学习中表现最佳,全局上下文仍是更强的通用选择。在策略学习中,预训练触觉编码器相比仅视觉输入降低了误差,MAE 和 Tactile-JEPA 是最有效的稳定方法。