Command Palette
Search for a command to run...
HappyWorld-Bench
HappyWorld-Bench
摘要
评估世界模型需要同时考察其生成世界的质量,以及它们在探索、交互和修改下的一致性与响应能力。我们提出了 HappyWorld-Bench,一个综合性基准,用于评估生成的世界在智能体与之交互时是否保持可靠。我们的设计建立在一个包含六项世界能力(W1–W6)的分层能力框架之上——从生成式构建到统一世界建模——并在三个独立评估轨道上实例化:视频世界模型、空间世界模型和具身世界模型。HappyWorld-Bench 包含 1,138 条视频提示、300 个空间场景和 254 个具身测试用例。在全部三个轨道中,我们构建并运营 HappyWorld-Arena,以组织人类 A/B 比较并得到模型级 Elo 评分,这些评分与新设计的、用于刻画行为正确性的自动化指标互为补充。我们在该统一框架下评估了 14 个视频世界模型、9 个空间系统和 8 个具身候选系统。结果揭示了三个轨道中仍然存在的可靠性差距:视频模型在长程推演和重复访问中表现出一致性下降,空间模型的放置准确率最高仅为 70.14%、编辑执行率最高为 73.33%,具身模型在多步动作中难以保持状态,并且难以精确响应被改变的动作条件和物理规则。这些发现强调,评估世界模型不仅需要看视觉质量,还需要看状态一致性以及它们对动作和干预做出响应的正确性。
一句话总结
作者提出了 HappyWorld-Bench,一个综合基准,通过结合 HappyWorld-Arena 人类 A/B 比较、Elo 评分和自动化行为指标,在视频、空间和具身三条轨道上评估六个层级世界能力(W1–W6);对 31 个系统的评估揭示了在一致性、状态保持和动作响应方面持续存在的可靠性差距。
核心贡献
- HappyWorld-Bench 是一个统一基准,通过从 W1 到 W6 的层级六级能力框架评估视频、空间和具身世界模型,包含 1,138 个视频提示、300 个空间场景和 254 个具身测试用例。
- HappyWorld-Arena 以人类 A/B 比较和模型级 Elo 评分补充自动化行为正确性指标,并应用于 14 个视频世界模型、9 个空间系统和 8 个具身候选系统。
- 该基准揭示了可靠性差距:视频模型在延长生成和重访中失去一致性,空间模型最高只有 70.14% 的放置准确率和 73.33% 的编辑执行率,具身模型在状态持久性和对改变后的动作或物理规则的精确响应方面存在困难。
引言
世界模型使 agent 能够在没有真实世界试错的情况下预测未来环境响应并选择动作,但这只有在模拟世界在交互下保持几何一致、物理合理、时间持久且可控时才行。现有基准仍然碎片化:它们在相互分离的设置中评估视频、空间和具身世界模型,通常衡量不同的能力子集,因此很难判断明显的生成质量是否反映了可靠的世界建模。作者提出 HappyWorld-Bench,一个统一基准,围绕层级 W1-W6 能力框架组织评估,并将其应用于视频、空间和具身轨道。它将自动化能力指标与 HappyWorld-Arena 中大规模人类 A/B 评分相结合,评估了 14 个视频模型、9 个空间系统和 8 个具身候选系统,表明当前系统在交互式模拟、持久状态和可编程动态方面仍然存在困难。
数据集
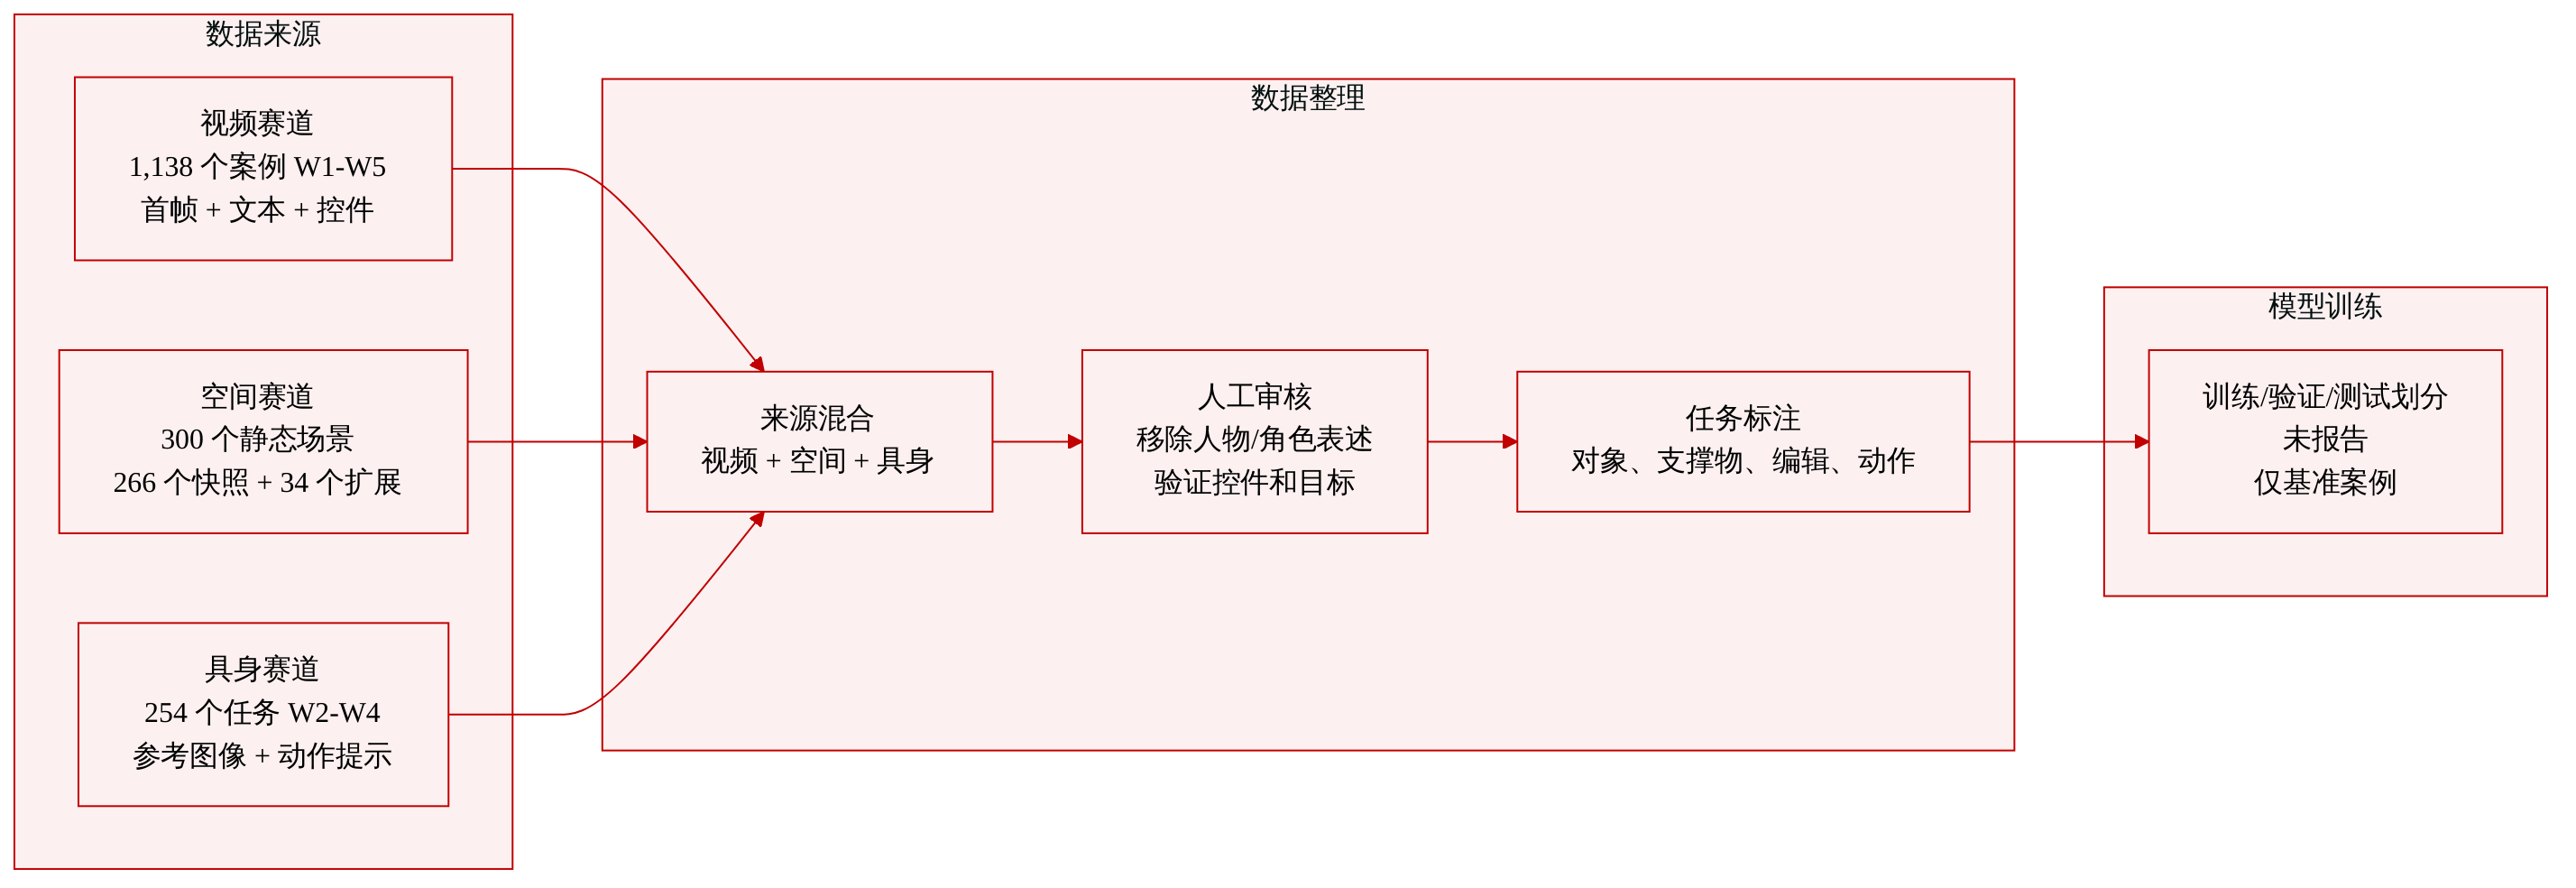
论文描述了用于世界模型评估的三条数据集轨道:视频轨道、空间轨道和具身轨道。这些部分定义的是基准数据而非训练划分,因此没有报告训练混合比例。所提供的文本中没有描述显式的裁剪策略。
视频世界模型轨道
- 组成与来源: 1,138 个覆盖 W1 到 W5 的结构化测试用例。每个用例包含首帧图像、场景和选定主体的文本描述,以及适用时带时间索引的控制序列。首帧图像来自真实世界影像、渲染环境和生成图像。
- 元数据与控制级别: 用例按目标能力、W 级别、应用领域、图像来源和视点进行标注。W1 用例不需要动作。W2 和 W3 控制序列指定运动或相机旋转方向和时间区间,而不是目标位置。W4 增加用于主体动作、交互和环境规则编辑的自然语言指令。W5 和 W6 支持将控制分配给特定主体。
- 筛选: 人工审核员验证图像与描述一致、控制可执行且时间连贯、评估目标可观察。目标模糊、控制不可行或可观察证据不足的用例会被过滤掉。
- 统计:
- W1:218 个用例
- W2:294 个用例
- W3:342 个用例
- W4:180 个用例
- W5:104 个用例
- 该池定义了五个维度上的 74 个细粒度评估方面:感知与表示 342 个用例,一致性与状态保持 228 个用例,因果与因果生成 299 个用例,可控交互与反事实 212 个用例,多主体协调 57 个用例。
- 用途: 该轨道为视频生成和能力导向评估提供结构化测试用例。
空间世界模型轨道
- 组成与来源: 共 300 个静态场景,包括 266 个快照场景和 34 个独立的空间扩展用例。数据来自经过筛选的视频轨道输入,并为特定空间任务额外收集了用例。
- 筛选与改写: 候选场景经过人工审核。包含人物或可见身体部位(包括手和腿)的初始图像被排除。视频轨道描述被改写,以去除第一人称和第三人称角色表述。
- 任务特定标注:
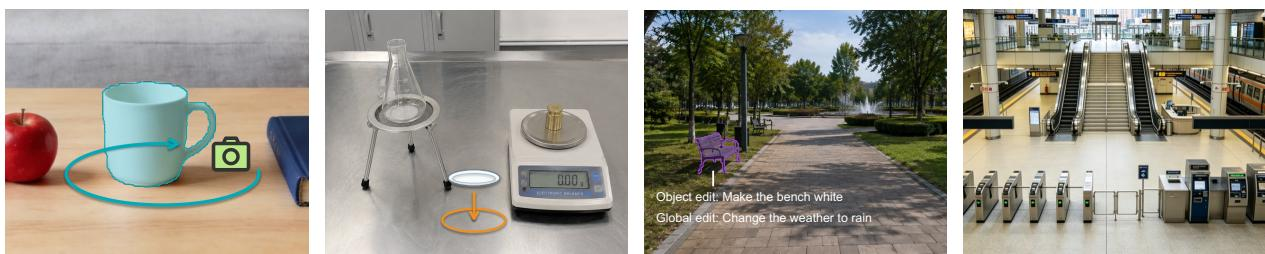
- 物体一致性: 每个场景最多标注两个可见、无遮挡的物体,用于基于环绕轨道的评估。总共标注了 424 个目标物体。
- 物理支撑: 选择具有可识别支撑面(如桌面)的场景。在 72 个场景中标注了支撑面,用于六次盘子放置试验。
- 编辑: 提供 30 对场景-指令对。涵盖 18 个物体级类别:添加、删除、替换、颜色、状态和材质,以及 12 个全局类别:天气、光照/时间、大气效果和地形。
- 扩展: 选择 34 个允许进一步空间扩展的场景,包括开放门口、走廊、路径和开放景观。
- 用途: 该数据集用于静态空间世界评估。作者只选择静态场景,因为当前没有现有方法支持完整的时空世界建模。
具身世界模型轨道
- 组成与来源: 254 个正式评估任务实例,覆盖 W2 到 W4。每个实例配有一张参考图像。记录包括唯一样本 ID、任务级别、任何必需的初始帧条件,以及结合机器人头部安装相机视点和完整动作条件的动作提示。
- 元数据构建: 每条记录包括标注的环境和主体描述,用于审计和编写 VLM 断言。W4 记录还包括共享的成对条件组、分支 ID,以及分支特定的动作或物理规则条件。
- 能力设计:
- W2: 单个原子机器人动作。每个用例指定执行主体、目标、方向和预期的动作后状态。
- W3: 更长视野的有序动作序列,带时间位置,用于评估动作顺序、状态持久性和累积效应。
- W4: 从共享初始状态出发的成对条件测试。动作条件变体改变运动方向、位移幅度、目标或动作类型。物理规则变体改变重力、摩擦、碰撞约束或材料刚性。
- 处理与评估格式: W2 和 W4 使用 5.0 秒 rollout;W3 使用 12.0 秒。视频标准化为 24 FPS,因此 W2/W4 为 120 帧,W3 为 288 帧。自动指标和 VLM 断言评估使用 4 FPS 采样,因此 W2/W4 得到 20 帧,W3 得到 48 帧。空间维度和编码被标准化。
- 动作词汇表: 该轨道涵盖抓取、抬起、打开、移动、推动、放置、释放、按压、拉动、折叠、插入、擦拭、滑动、转动、搬运、轻点、触摸、堆叠和切割。
- 用途: 该轨道使用带有显式初始帧条件的图像到视频 rollout 进行具身评估。
方法
作者提出了一个涵盖视频、空间和具身轨道的统一世界模型评估框架。该框架沿两个正交轴组织:一个是从 W1 到 W6 的能力轴,每个级别代表一次质的能力跃迁;另一个是包含感知、一致性、因果性和可控性的评分轴。这种设计使框架能够区分整体判断可能混淆的特定失效模式,例如达到了合理的最终状态,但省略了所需的动作过程。
对于视频世界模型轨道,作者构建了用于视频生成的结构化测试用例。每个用例包含首帧图像、场景文本描述和带时间索引的控制序列。任务分配遵循一个能力矩阵,该矩阵指定目标 W 级别和评估维度。控制规格针对目标能力定制;例如,W1 用例评估没有外部控制输入的自然场景演变,而 W4 用例支持用于主体动作和环境规则编辑的自然语言指令。用例设计涵盖世界建模的互补方面,包括自然动态、外观与空间结构、运动与环境响应、长期持久性和交互。
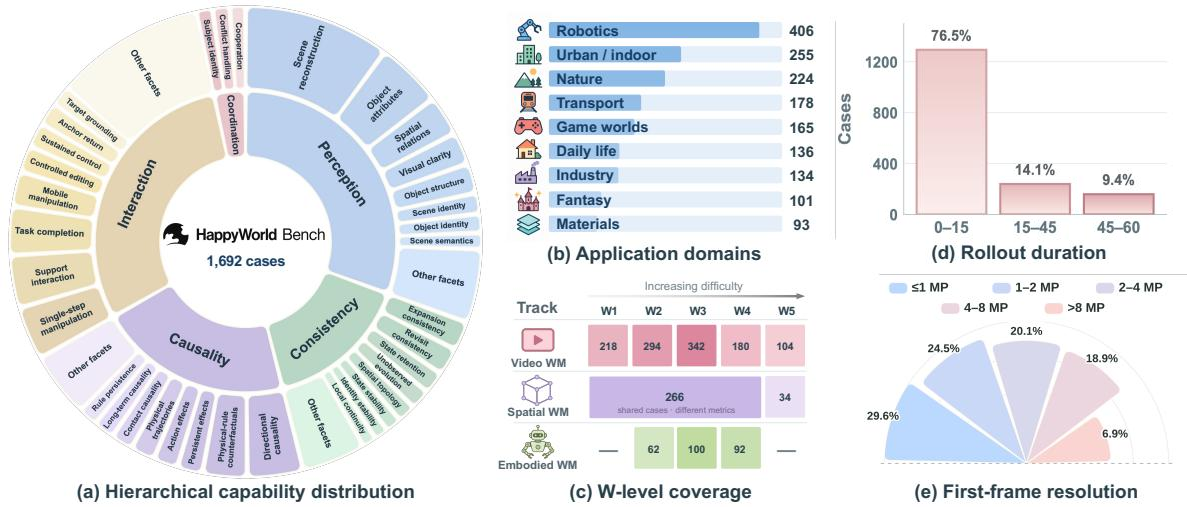
下图总结了不同轨道上的层级能力分布和 W 级别覆盖情况:
对于空间世界模型轨道,作者从经过筛选的视频轨道输入以及为特定空间任务额外收集的用例中构建数据集,专注于静态场景。他们选择候选场景并进行人工审核,排除包含人物或可见身体部位的初始图像。为了弥补通用视频条件的局限,所选用例补充了任务特定标注。这些包括为基于环绕轨道的评估标注可见物体,为盘子放置试验识别支撑面,构建物体级和全局编辑的场景-指令对,以及收集允许进一步空间扩展的场景。
下图展示了空间轨道的任务特定场景和标注示例:
对于具身世界模型轨道,作者将每个用例形式化为一个以图像为条件、由提示控制的视频生成问题。设 I0 表示动作前场景的自我中心观察的规定参考图像,设 p 表示指定执行主体、目标、动作类型和方向的动作提示。模型根据公式 Y1:T=Gθ(I0,p) 生成视频。该轨道评估三个递进挑战级别:W2 评估对单个原子机器人动作的即时响应,W3 评估具有持久状态的有序多步 rollout,W4 评估从共享初始状态出发、在改变后的动作条件或改变后的物理规则下的成对 rollout。所有生成视频都被转换为统一评估格式,具有标准化的帧率和空间尺寸,以确保跨不同模型输出的指标计算具有可比性。
实验
该评估涵盖三条世界模型轨道,并设置逐步提高的能力级别。视频世界模型轨道在感知、一致性、因果性和可控性方面评估交互式模型,发现整体偏好与级别特定优势并不一致,且成功的干预执行本身并不能保证稳定的规则驱动动态。空间世界模型轨道在视觉质量、物理可用性、持久性、编辑和扩展方面比较模型,表明强视觉质量并不能保证可导航性、一致性或可编辑性,并且扩展质量取决于保留已有区域。具身世界模型轨道在动作条件 rollout 上评估视频模型,视觉保真度仍然较强,但动作落地、持久状态转移和条件依赖物理响应仍然有限。
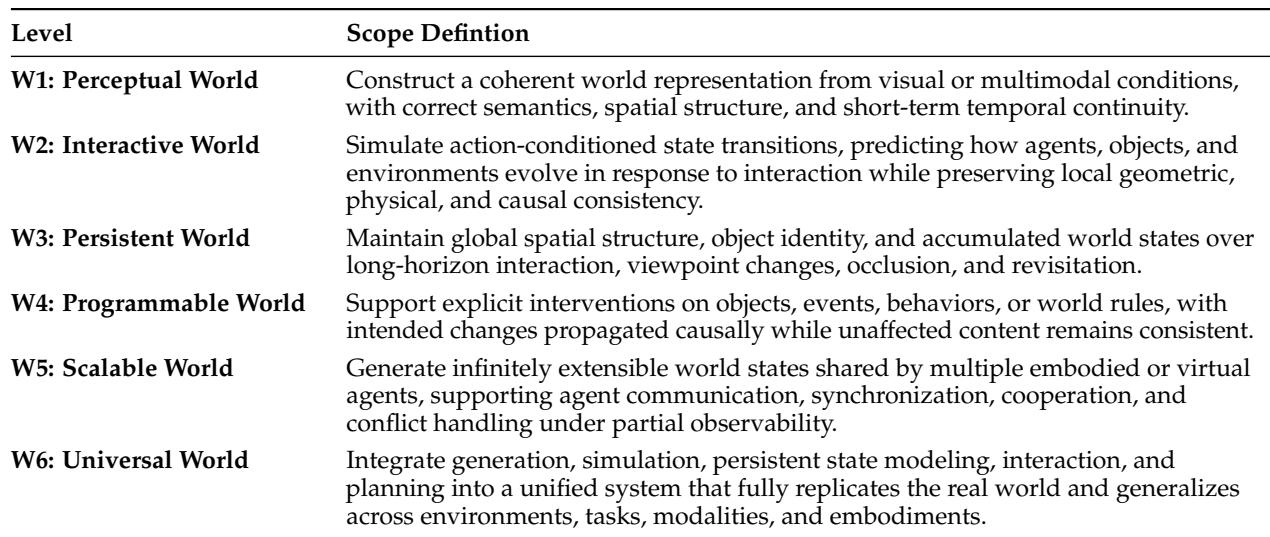
能力层级定义了六个世界级别,从构建短期连贯的感知世界到支持持久性、可编程干预、多 agent 可扩展性和通用模拟。评估涵盖感知与表示、一致性与状态保持,以及因果与因果 rollout。从交互级到可编程级,视觉保真度总体保持较强,但动作落地、持久状态演化和条件依赖物理响应逐步变弱。该层级从短期感知连贯性和动作条件转换,发展到长视野持久性、可编程干预、多 agent 世界和统一的通用模拟。从交互级到可编程级,视觉保真度和场景外观总体保持较强,但随着交互要求增加,对动作条件动态的忠实建模变得更加有限。持久世界场景显示,先前建立的状态向后续阶段的转移不可靠,导致长视野动作执行和累积场景变化失败。可编程世界场景通常对编辑后的物理规则(如材质、重力或摩擦)几乎没有可观察响应,对编辑后的动作条件也只有部分响应。当前视频模型生成逼真的以机器人为中心的 rollout,但在动作落地、持久状态演化和条件依赖物理响应方面仍然有限。
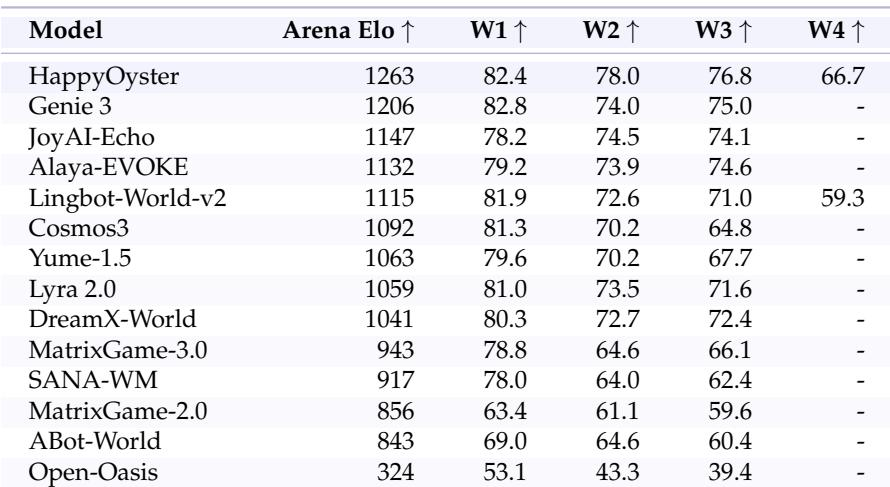
HappyOyster 在 Arena 总体偏好中领先,Genie 3 排名第二。特定能力得分呈现不同格局:Genie 3 在 W1 上以微弱优势最强,而 HappyOyster 获得 W2 和 W3 的最高分。W4 结果仅有两个模型可用,在该设置中 HappyOyster 优于 LingBot-World-v2。总体偏好和能力得分并不完全一致:HappyOyster 拥有最高 Arena Elo,但 Genie 3 在 W1 上略微超过它。HappyOyster 是唯一一个在 Arena 表现居首的同时还获得 W2 和 W3 最高能力得分并在有限的 W4 比较中领先的模型。
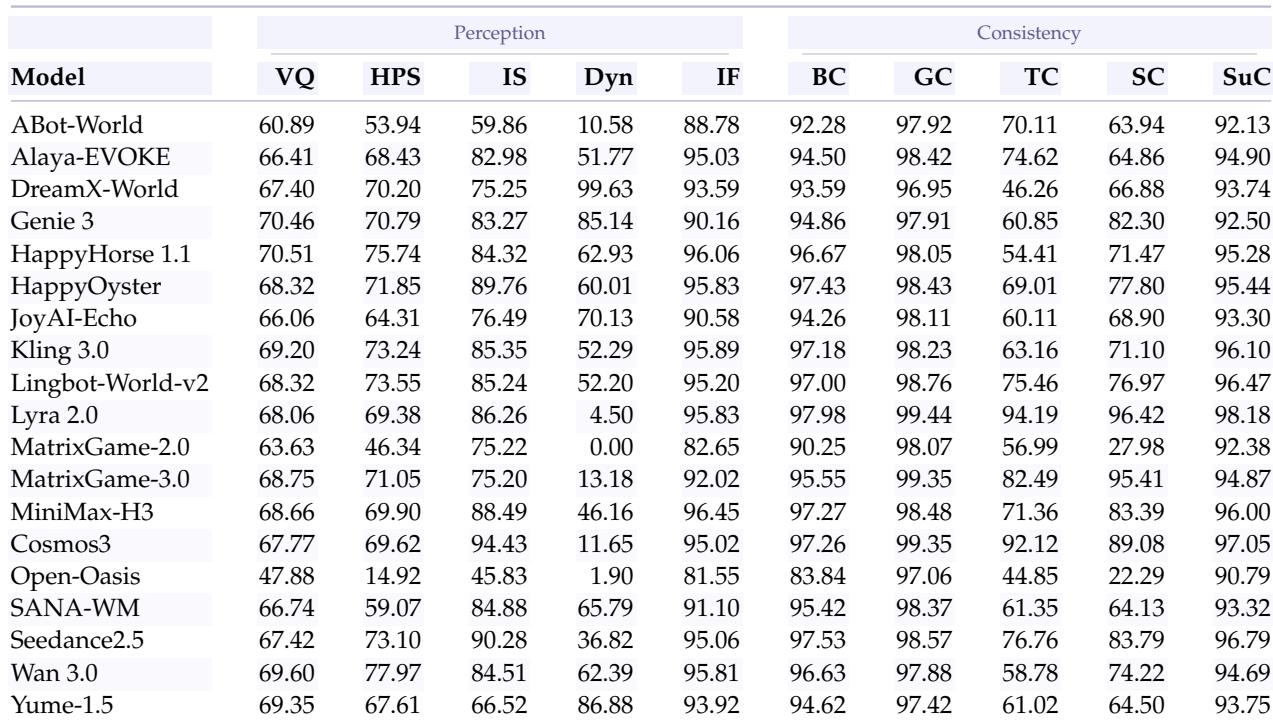
在评估的模型中,视觉质量和指令遵循总体较强,而一致性指标变化更大。多个感知得分较高的模型仍然在动态、时间或几何一致性上存在弱点,说明视觉上令人信服的生成并不能保证稳定的世界行为。结果支持将感知质量和世界一致性视为互补能力。HappyHorse 1.1 和 HappyOyster 表现出较强的视觉和指令遵循性能,但它们的动态一致性仅为中等,HappyHorse 还存在几何一致性较弱的问题。DreamX-World 产生近乎完美的动态得分,但几何一致性较弱,而 ABot-World 将较强的背景和几何得分与非常低的动态一致性结合在一起。
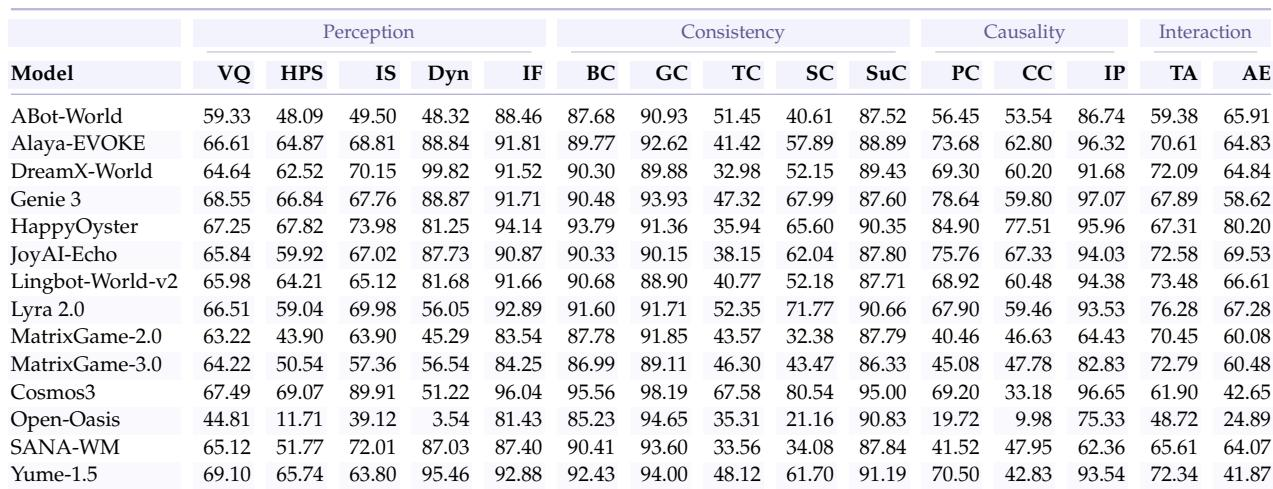
在这项交互式世界评估中,动作执行和因果一致性在不同模型之间差异很大。HappyOyster 在所报告的模型中实现了最强的动作执行和因果一致性,而 Genie 3 表现出较强的视觉质量和状态一致性,但动作执行较弱。视觉合理性和控制遵循并不能保证连贯的状态转换或因果一致的结果。HappyOyster 在动作执行和因果一致性上领先,但与其较强的交互和物理一致性得分相比,时间一致性相对较低。Genie 3 在视觉质量和状态一致性上表现良好,但在比较模型中记录了最弱的动作执行。具有相似控制遵循或目标准确率的模型,在状态一致性和因果一致性上可能差异显著,这表明动作相似性与可靠的世界转换之间存在差距。
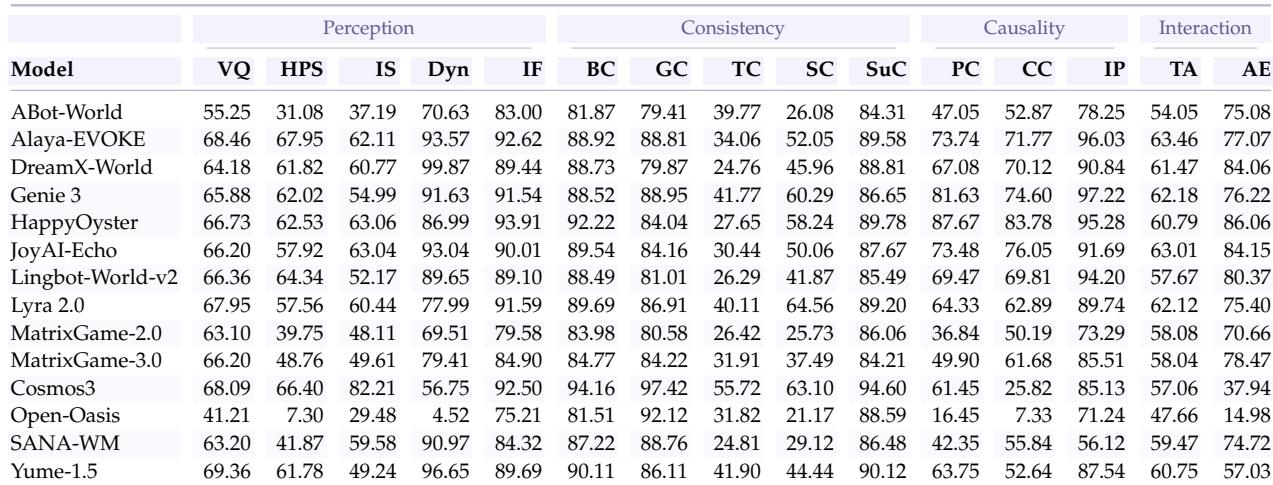
长视野世界持久性对评估模型仍然具有挑战性。视觉和几何一致性相对稳定,但在延长交互和重访下,时间和状态一致性显著减弱。HappyOyster 在该基准上总体领先,而 ABot-World 在视觉、一致性和因果性指标上落后。时间一致性和状态一致性是大多数评估模型中最弱的一致性维度。HappyOyster 在评估模型中实现了最高的总体世界持久性得分。ABot-World 在视觉质量以及若干状态和因果一致性指标上落后于其他模型。
评估涵盖六个世界能力级别,从短期感知连贯性到可编程和持久世界,并评估视觉质量、一致性、动作落地、因果性和长视野状态保持。视觉保真度和指令遵循总体较强,而时间、状态和几何一致性差异很大;模型经常无法遵循编辑后的物理规则,也无法在长交互中保持先前建立的状态。HappyOyster 在总体 Arena 以及大多数交互和持久性基准上领先,而 Genie 3 在早期视觉感知上具有竞争力,但在动作执行上较弱。总体而言,高感知质量并不能保证扎实、因果稳定的世界转换。