Command Palette
Search for a command to run...
文档检索感知分块(D-RAC):通过 PDF 归一化与多模态 Markdown 转换实现企业文档的通用检索感知摄取
文档检索感知分块(D-RAC):通过 PDF 归一化与多模态 Markdown 转换实现企业文档的通用检索感知摄取
Uday Allu Abhivanth Sivaprakash Pratik Singh Aman Manocha
摘要
面向企业知识库的检索增强生成(RAG)系统必须摄取异构文档格式——包括 PDF、Word 文档、演示文稿和扫描件——这些文档的内容被隐藏在复杂的视觉布局、多栏页面和密集表格中。传统摄取流水线依赖基于规则的文本提取或 OCR,这往往会破坏阅读顺序、压平表格并丢失标题层级,从而降低下游检索质量。对原始提取文本进行完全智能体式分块能够恢复一定的语义连贯性,但会带来高昂的 token 成本和幻觉风险。本文提出文档检索感知分块(D-RAC),它是我们将 Web 检索感知分块(W-RAC)框架扩展到任意文档格式的成果。D-RAC 首先将任意输入文档(DOCX、PPTX、XLSX、扫描图像或原生 PDF)归一化为 PDF,利用的是几乎所有文档格式都具有忠实、确定性的 PDF 渲染这一事实。随后,它通过一次多模态 LLM 处理将渲染后的页面转换为检索优化的 Markdown——将表格规范化为自包含的散文式陈述,并保留标题层级——之后的分块过程与 W-RAC 中完全一致:先进行确定性解析,将其划分为 ID 可寻址的单元,再由轻量级 LLM 基于标识符而非文本进行分块规划。源文本在分块过程中从不重新生成,这保留了 W-RAC 在成本、确定性和可观测性方面的优势,同时使每种可渲染的文档格式都能作为一等输入。在 RAG-Multi-Corpus 基准的 236 篇文档、795 页 PDF 子集上——涵盖汽车、学术、云服务、企业技术和银行等领域——D-RAC 在 72 分钟内以零错误完成整个语料库的转换与分块,生成 1,748 个检索就绪分块。与使用前沿 LLM 的智能体式分块相比,D-RAC 将分块阶段的输出 token 减少了 95.7%,在 GPT-4.1 定价下将分块成本降低 77.8%,在 Gemini 2.5 Pro 定价下降低 85.6%,并将分块时间缩短 75%。D-RAC 可线性扩展至 500 页以上的文档。
一句话总结
Yellow.ai 的研究人员提出 Document Retrieval-Aware Chunking(D-RAC),它在 W-RAC 的基础上扩展,将异构企业文档规范化为 PDF,并应用单次多模态 LLM 传递,以生成面向检索优化的 Markdown,随后进行确定性的基于 ID 可寻址解析,以及仅基于标识符的轻量级分块规划,不重新生成源文本;在 RAG-Multi-Corpus 基准的 236 篇文档、795 页 PDF 子集上,D-RAC 在 72 分钟内完成文档转换与分块,零错误,生成 1,748 个可检索块,并且与 agentic 分块相比,其分块阶段输出 tokens 降低 95.7%,在 GPT-4.1 定价下成本降低 77.8%,在 Gemini 2.5 Pro 定价下降低 85.6%,分块时间降低 75%。
核心贡献
- Document Retrieval-Aware Chunking(D-RAC)将检索感知分块从网页内容扩展到任意企业文档,通过将 DOCX、PPTX、XLSX、扫描图像和原生 PDF 统一为 PDF,并应用单次多模态 LLM 传递,将渲染页面转换为面向检索优化的 Markdown,保留标题层级并生成自包含的表格散文陈述。
- 分块阶段将转换后的 Markdown 解析为可通过 ID 寻址的单元,并仅对标识符执行轻量级基于 LLM 的分块规划,因此源文本在分块阶段不会被重新生成,一次性转换成本与可重复的重新分块解耦。
- 在 RAG-Multi-Corpus 的 236 篇文档、795 页 PDF 子集上,D-RAC 在 72 分钟内完成转换和分块,零错误,产生 1,748 个可检索块;与 agentic 分块相比,分块阶段输出 tokens 降低 95.7%,在 GPT-4.1 定价下分块成本降低 77.8%,在 Gemini 2.5 Pro 定价下降低 85.6%,分块时间减少 75%,同时可线性扩展到 500 页以上的文档。
引言
检索增强生成已经成为将大语言模型锚定到企业知识的标准方式,但企业语料以 PDF 为主,其面向呈现的布局会破坏传统文本提取。此前的工作 Web Retrieval-Aware Chunking(W-RAC)通过在确定性标识符上规划分块边界,降低了分块成本和延迟,但它假设存在可恢复的类似 HTML 的结构,因此无法处理 PDF;而基于规则、OCR/版面分析以及 agentic 方案要么继承提取伪影,要么反复支付文本生成成本。作者提出 D-RAC,将任意输入文档统一转换为 PDF,并增加一次面向检索感知的多模态传递,将渲染页面转换为结构化 Markdown,使未改动的 W-RAC 流水线能够摄取任意企业文档。
数据集
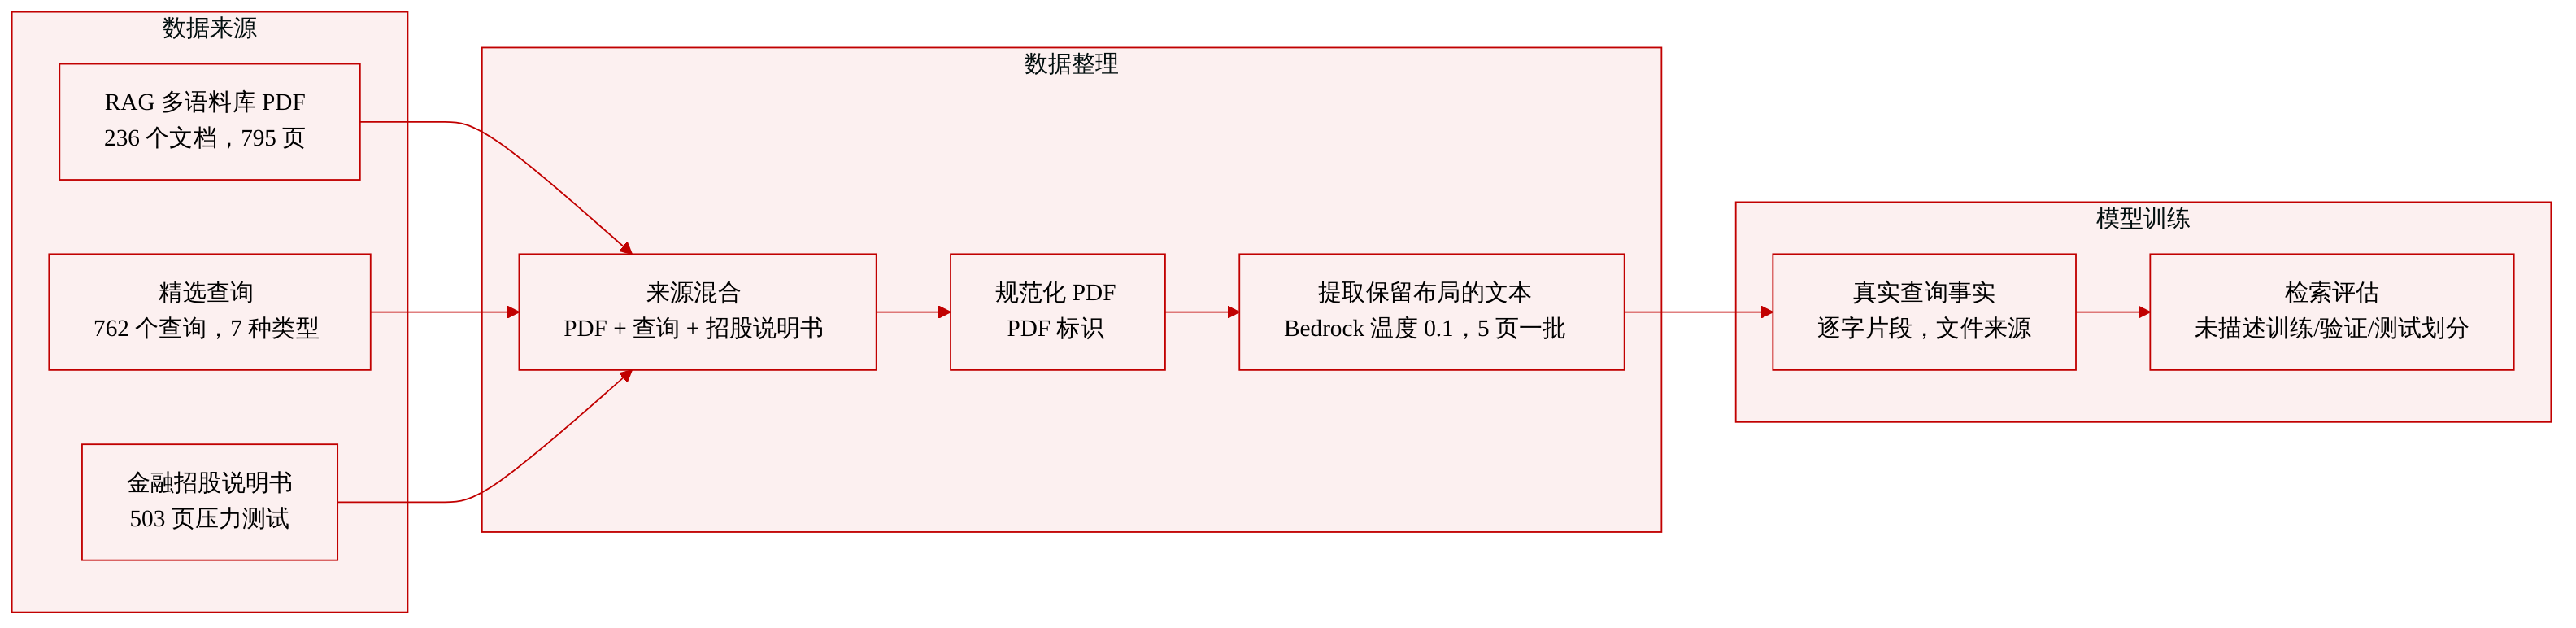
作者使用 RAG-Multi-Corpus 的 PDF 子集,该基准随 W-RAC 引入,用于评估。
数据集构成与来源
- 主要评估语料:236 篇 PDF 文档,共 795 页,覆盖五个不同行业垂直领域的虚构企业组织。
- 文档类型反映企业知识库内容:产品资料、FAQ、政策与流程文档、零部件目录和服务指南。
- 格式以表格密集和版式丰富为特点,符合各领域典型情况。
查询子集
- 使用 762 条经过整理并带支持事实真值的查询进行检索评估。
- 查询覆盖五个组织中的四个;CloudWay-24 在参考集中没有标注查询。
- 查询分为七类,用于测试事实回忆、推理、比较和流程理解。
- 每条查询标注一个或多个支持事实:来自源文档及其原始文件的逐字片段。
处理与使用
- 由于所有输入本身为 PDF,第 1 阶段的规范化被视为恒等处理。
- 另一份 503 页的金融招股说明书用作可扩展性压力测试。
- 处理使用 AWS Bedrock,温度设为 0.1。
- 转换时每批最多输出 8,192 个 tokens,分块规划为每次 section 调用 16,384 个 tokens。
- 文档以 5 页为一批处理,并使用 5 个并行 worker。
提供的摘录聚焦于评估数据,未描述训练划分、混合比例、过滤规则或裁剪策略。
方法
作者提出 Document Retrieval-Aware Chunking(D-RAC),这是一条旨在将异构文档转换为面向检索优化块的流水线。系统架构包含四个不同阶段:规范化与渲染、转换、解析与分节、规划与重建。
有关整体流水线结构,请参见框架图。
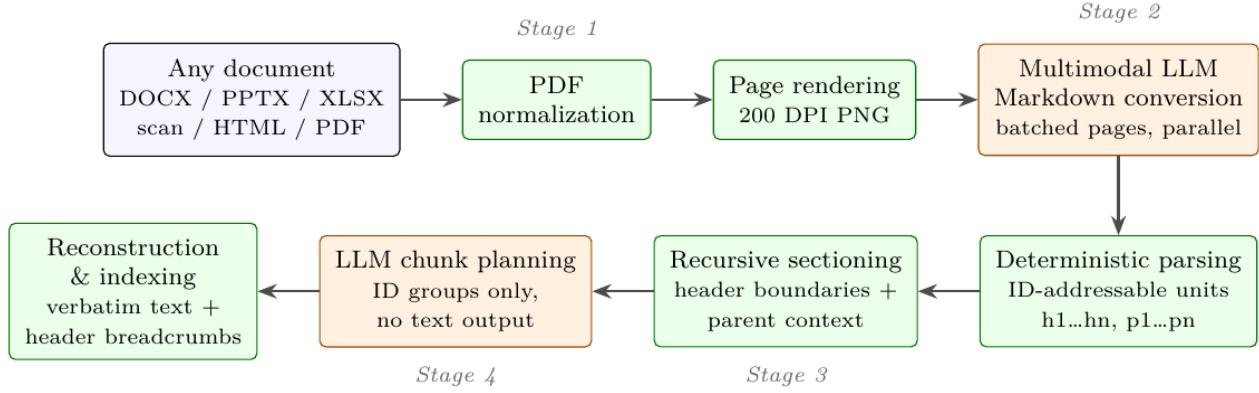
在第一阶段,作者将 PDF 作为通用视觉交换格式,以实现格式无关性。任何不是 PDF 的输入文档都使用标准确定性工具转换为 PDF。随后,规范化 PDF 的每一页以 200 DPI 渲染为 PNG 图像,并缩小以确保任何维度不超过 1,568 像素,以匹配常见视觉编码器的输入限制。此步骤完全确定,不涉及 LLM 调用。
第二阶段涉及多模态 Markdown 转换。渲染页面分组为批次并发送到多模态 LLM。转换提示强制执行严格的面向检索输出规则。文本内容逐字保留,并使用 Markdown 标题层级重建显式层级。关键的是,系统应用面向检索的表格规范化。系统不使用 Markdown 表格语法,而是将每个表格行转换为独立句子,使用列标题作为上下文。
如下图所示,这种行级表格散文确保每个表格事实都成为可独立嵌入的陈述。
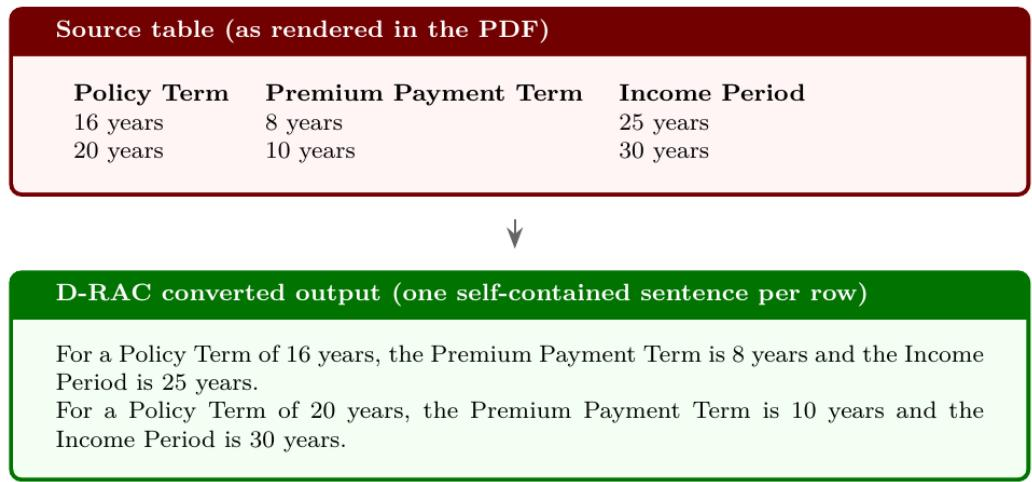
作者明确禁止将多行合并为析取句,以防止检索过程中的精度损失。还应用图像抑制来省略徽标和装饰图形,防止幻觉生成的标题污染索引。
第三阶段,转换后的 Markdown 经历确定性解析和分节。文本被解析为可通过 ID 寻址的元素,例如标题和内容块。对于超过规划预算的文档,递归分节算法在标题边界处拆分元素序列。每个 section 都附带其父标题上下文,使规划器无需重新发送内容即可理解文档层级。
最后阶段侧重于 LLM 分块规划与重建。LLM 仅接收元素 ID、截断的文本预览和层级元数据,并以有序 ID 列表的形式返回分块计划。规划器被指示将围绕单一主题的内容块分组,并在块之间复用标题 ID 以提供上下文。程序化地验证覆盖范围,以保证无损摄取。最终块通过将 ID 映射回逐字转换文本在本地重建。每个块在嵌入和索引之前,都会加上其完整祖先标题链前缀,并标注人类可读的 breadcrumb。由于转换后的 Markdown 和元素 ID 被持久化,检索策略发生变化时只需重新规划,无需对源 PDF 重新转换或重新 OCR。
实验
评估使用 RAG-Multi-Corpus 的 PDF 子集,覆盖五个企业领域,包含 762 条带标注查询,涵盖七种推理类型。实验表明,D-RAC 能够无错误地转换所有文档,并在大型压力测试中线性扩展,同时分块规划保持低成本、稳定且无损。检索结果表明,D-RAC 优于固定大小解析,并且与 agentic 分块持平或更优,尤其是在边界敏感查询类型上,跨领域性能一致。成本分析进一步表明,D-RAC 通过最小化输出 tokens 并避免重新生成散文,以 agentic 分块成本的一小部分达到该质量。
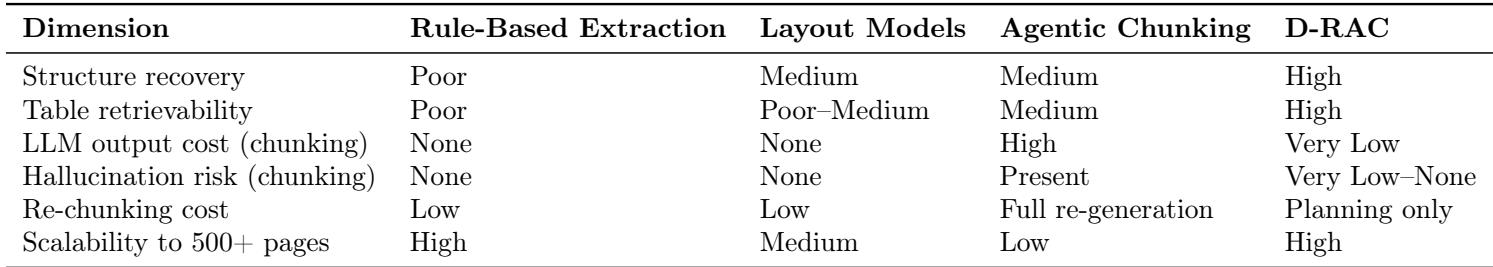
D-RAC 在对比的摄取策略中实现了最高的结构恢复和可检索性,同时保持极低的分块输出成本,并避免散文生成。即使处理渲染后的 PDF 页面,它也在整体指标上与 agentic 分块持平或更优,其仅规划式的重新分块比完全重新生成具有更高的扩展效率。该方法在各领域间稳定,并且在边界敏感查询类型上取得最大质量提升。D-RAC 是唯一同时具备高结构恢复、高可检索性和对大量页面高可扩展性的策略。Agentic 分块会产生较高 LLM 输出成本并存在一定幻觉风险,而 D-RAC 将输出缩减为仅用于规划的标识符,幻觉攻击面极低甚至没有。尽管 D-RAC 从渲染 PDF 页面这种最难的输入格式出发,它在全部七项整体指标上与 agentic 分块持平或更优。最大提升出现在时间类、比较类和分析类查询上,而布尔查询仍是 agentic 分块保持优势的边缘情形。
评估的 PDF 子集覆盖五个虚构企业领域,并包含现实的表格密集文档,如产品资料、FAQ、政策文档、零部件目录和服务指南。D-RAC 在直接处理渲染 PDF 页面时,在整体检索指标上与 agentic 分块持平或更优,其中时间类、比较类和分析类查询提升最大。相较于 agentic 重写,其规划阶段还大幅减少输出 tokens 和处理时间,同时各领域召回保持稳定。评估子集覆盖五个虚构企业领域,其中银行业和学术界的页面负载最重,云服务最轻。文档反映现实企业知识库内容,包括产品资料、FAQ、政策文档、零部件目录和服务指南,并具有表格密集布局。尽管 D-RAC 处理的是渲染 PDF 页面而非干净的结构化来源,它仍在整体检索指标上与 agentic 分块持平或更优。时间类、比较类和分析类查询从主题一致的分块边界获益最多;布尔查询是 agentic 分块仍然领先的一个领域。各组织的召回保持一致,表明该流水线不会对特定文档风格过拟合。D-RAC 的规划输出远小于 agentic 重写,因此输出 token 成本大幅下降,处理时间显著减少。
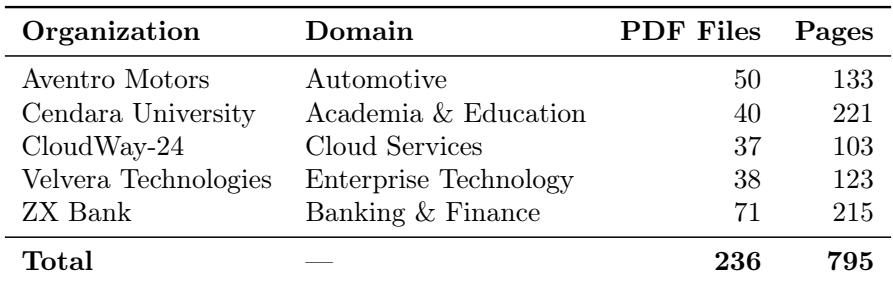
评估查询集涵盖七个类别,旨在平衡事实回忆、推理、比较和流程理解。流程类问题构成最大类别,而时间类问题最小。主题一致分块带来的检索收益在时间类、比较类和分析类查询上最明显,不过布尔查询仍是 agentic 分块保持优势的唯一类别。流程类查询是最大类别,其次是比较类和描述类问题。时间类查询是最小类别,但从主题一致的分块边界和行级表格散文受益最多。布尔查询是 agentic 分块相对于主题一致分块保持优势的唯一类别。
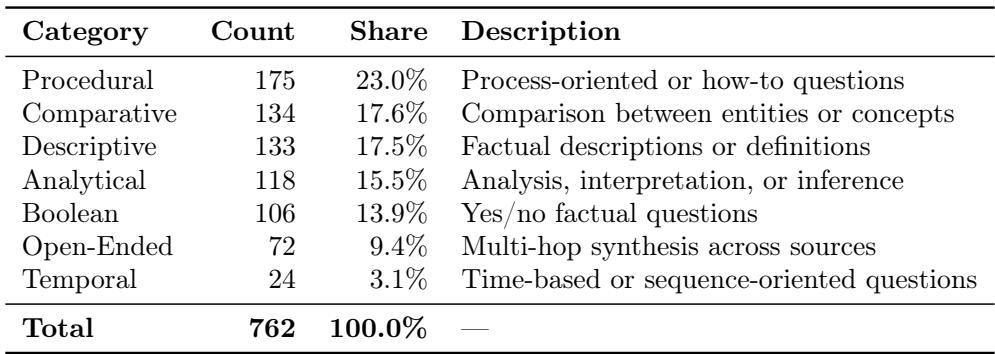
在五个组织中,236 篇 PDF 文档、795 页转换为约一百万个字符的 Markdown,零错误。平均文件转换时间约为 12 到 22 秒,页级吞吐量因组织而异,Cendara University 每页最快,Velvera Technologies 最慢。渲染开销极小,多模态推理主导转换成本。全部 236 篇文档转换无任何错误,包括零部件目录、费用表和多列产品资料。页面渲染开销可忽略,而多模态推理是转换时间的主要驱动因素,并随并行页面批次扩展。
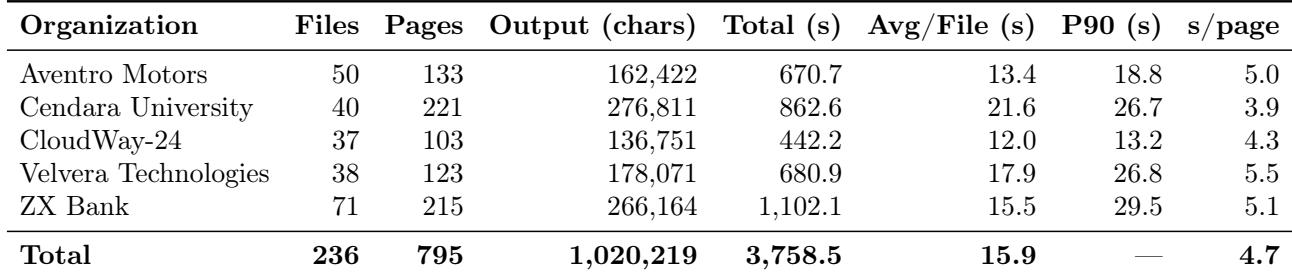
分块规划覆盖每个内容元素恰好一次,零分块错误,并且相对于转换和 agentic 分块仍然廉价,因为规划器仅输出 ID 数组。平均块大小在各组织之间保持稳定、密集且对检索器友好,没有硬性大小限制。规划成本只占转换时间的一小部分,并且远低于 agentic 分块,这得益于最小的仅 ID 输出。各组织的块大小保持稳定且对检索器友好,平均约在 580 到 850 个字符之间。
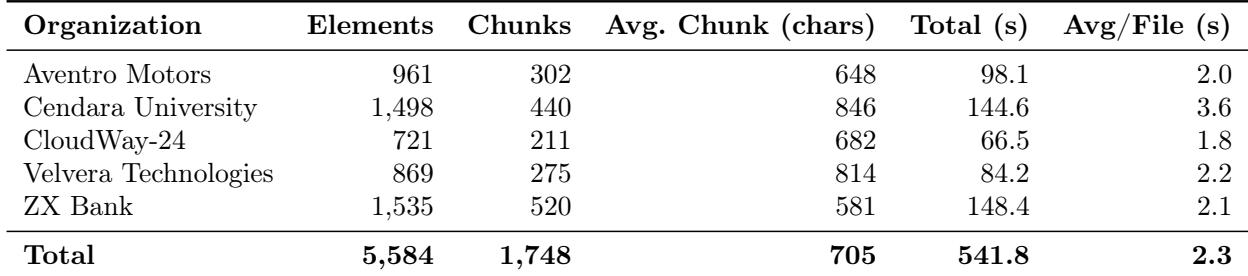
实验在跨五个虚构领域的表格密集企业 PDF 语料上,以及在涵盖事实、流程、比较、时间和布尔问题的查询集上,评估 D-RAC 与 agentic 及其他分块策略。D-RAC 证明,仅规划式、基于标识符的分块能够最准确地恢复文档结构、保持可检索性,并在无需散文生成或高 LLM 输出成本的情况下扩展到大量页面。即使从渲染 PDF 页面出发,它在整体检索质量上与 agentic 分块持平或更优,时间类、比较类和分析类查询提升最大,各领域召回稳定,而布尔查询仍是 agentic 分块保持优势的唯一类别。该流水线在实践中还表现出高可靠性,文档转换无错误,渲染开销可忽略并由多模态推理主导,分块规划零错误且成本低廉,产生的块大小稳定并适合检索器。