Command Palette
Search for a command to run...
基于文种感知混合专家的一体化多语言场景文本识别
基于文种感知混合专家的一体化多语言场景文本识别
Xingsong Ye Yongkun Du Jiaxin Zhang Zhixian Li Chong Sun Chen Li Jing LYU Lianwen Jin Zhineng Chen
摘要
多语言场景文本识别(STR)仍然具有挑战性,原因在于大多数语言训练数据稀缺,以及单一模型难以支持多种文种。现有方案要么为每种语言部署一个识别器,导致成本上升并引入误差累积,要么依赖大规模视觉语言模型(VLM),这些模型成本高昂且在许多文种上仍不准确。在本文中,我们致力于构建一种一体化多语言识别器,它比逐语言专家模型更简单、比 VLM 更轻量,且比两者都更准确。首先,我们构建了 TextMuSS-10M,一个涵盖 10 种文种和 229 种语言的大规模合成场景文本数据集,在真实数据不可用的场景中提供均衡且充分的监督。其次,我们提出了 ScriptMoE,一种文种感知的混合专家(MoE)架构。该架构共享一个视觉编码器,并将稠密解码器替换为稀疏 MoE 模块;该模块包含一个图像级路由器,将每张图像分派给前 2 个与文种对齐的专家,同时包含一个共享专家以吸收跨文种知识。在我们构建的 TextMuSS-Bench(10 种文种、10,899 张图像)上的大量实验表明,ScriptMoE 达到了 82.06% 的最高准确率,比最强 STR 基线高 1.31%。在 CC-OCR 端到端多语言任务中,仅将 PP-OCRv5 中的识别器替换为 ScriptMoE,便将 F1 分数从 65.71% 提升至 80.89%,以仅一小部分参数量略微超过最佳 VLM(80.73%)。
一句话总结
来自复旦大学、腾讯和华南理工大学的研究者提出了 ScriptMoE,一种脚本感知的 Mixture-of-Experts 识别器,使用图像级路由器将图像分派给 top-2 脚本对齐专家和一个共享专家;在覆盖 10 种脚本、229 种语言的 TextMuSS-10M 数据集上训练后,它在 TextMuSS-Bench 上达到 82.06%,并将 CC-OCR 的 F1 提升到 80.89%。
核心贡献
- 提出了 TextMuSS-10M,一个覆盖 10 种脚本和 229 种语言的大规模合成场景文本数据集,以及 TextMuSS-Bench,一个涵盖全部十种脚本、包含 10,899 张真实图像的基准。
- 提出了 ScriptMoE,一种脚本感知的 Mixture-of-Experts 架构,包含共享视觉编码器和稀疏 MoE 解码器,其中图像级路由器将每张图像分派给 top-2 脚本对齐专家和一个共享专家。
- 实验在 TextMuSS-Bench 上报告了 82.06% 的平均准确率,比最强 STR 基线高 1.31%;在 CC-OCR 任务中将 PP-OCRv5 识别器替换为 ScriptMoE 后,F1 从 65.71% 提高到 80.89%,以远少的参数量超过了最佳 VLM 分数 80.73%。
引言
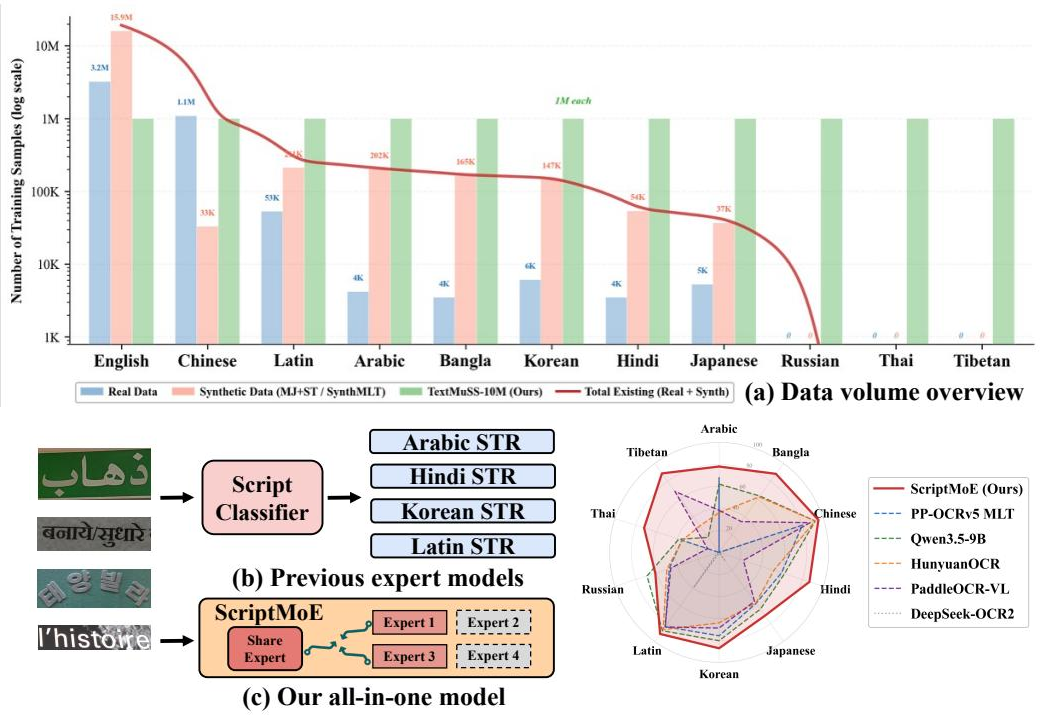
自然场景文本识别是核心 OCR 任务之一,但大多数高精度模型集中在英文和中文上,而实际部署系统必须处理阿拉伯文、西里尔文、印地文、日文、韩文、泰文等多种脚本。以往的多语言方法要么使用按语言划分的专家识别器并配合单独的语言识别步骤,这会增加成本并累积误差;要么依赖对边缘部署来说过重的大型视觉语言模型;此外,非英文和非中文脚本的真实训练数据也很稀缺。作者通过构建 TextMuSS-10M,一个覆盖 10 种脚本和 229 种语言的均衡合成数据集,和用于真实评估的 TextMuSS-Bench,并提出 ScriptMoE,一种脚本感知的 Mixture-of-Experts 识别器,共享视觉编码器,同时将每张图像路由到 top-2 脚本专家和一个始终启用的共享专家,来弥补这些缺口。由此得到单一轻量的一体化模型,在多语言基准上提高了平均准确率,并在端到端 OCR 性能上与参数量大得多的视觉语言模型相当。
数据集
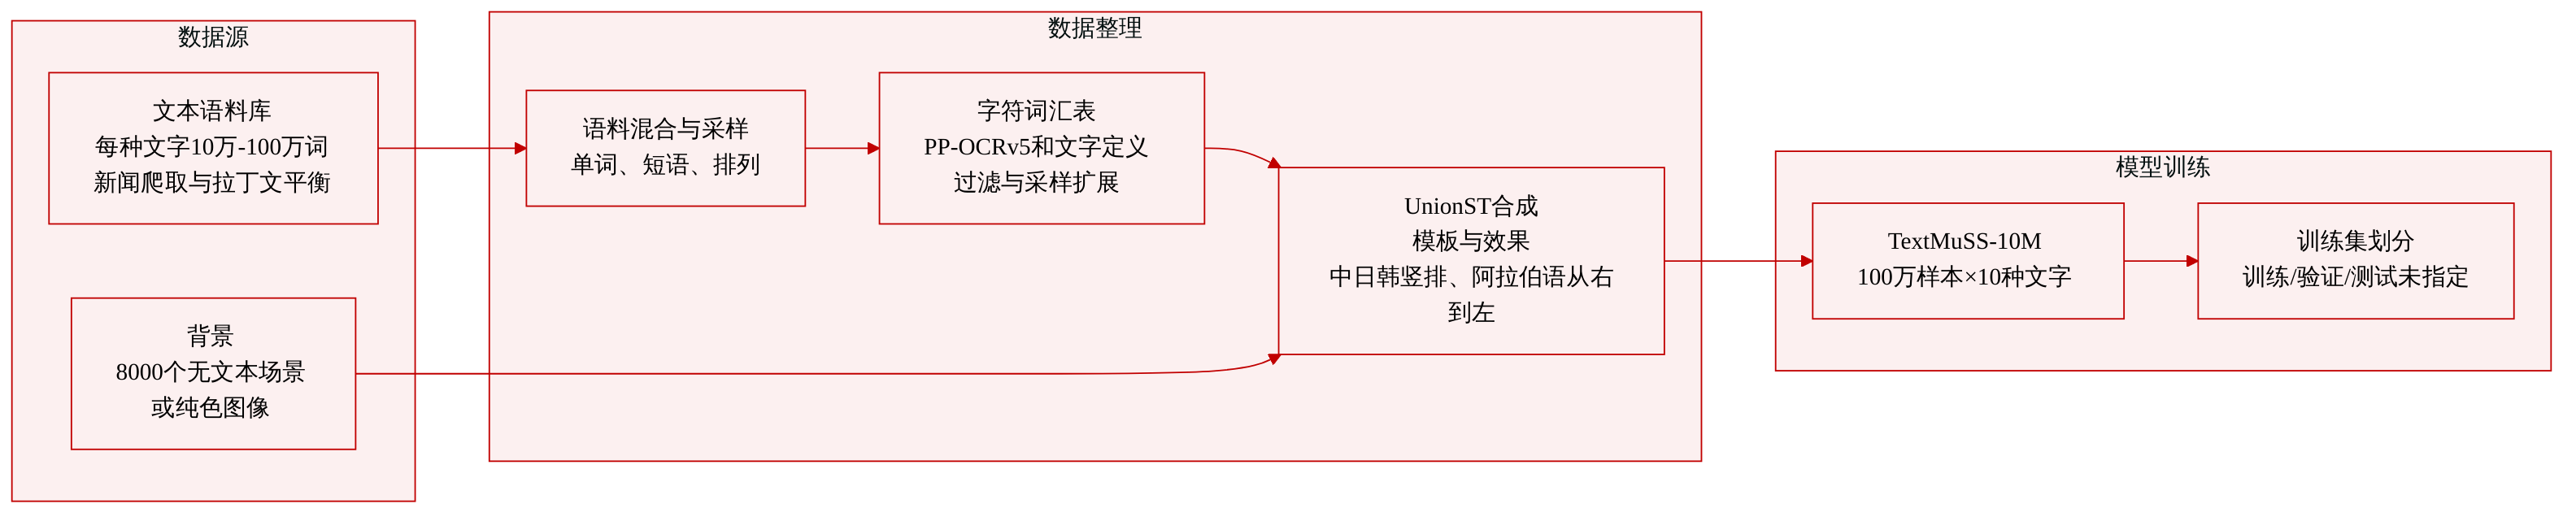
在得出 SynthMLT 规模过小、覆盖语言太少而无法支持高精度训练的结论后,作者构建了名为 TextMuSS-10M 的大规模合成多语言场景文本数据集。
-
数据集组成与来源
- TextMuSS-10M 在十种目标脚本上每种脚本包含 1M 个合成样本,总计 10M 个样本。
- 背景来自 8,000 张无文本场景图像或纯色图像。
- 文本语料按脚本收集,每种脚本包含 100K 到 1M 个词。
- 对于覆盖许多语言的拉丁文,作者收集了更多词,并在语言之间进行平衡。
- 通过用空格拼接词级文本来模拟更长的文本。
- 字符表的随机排列会添加无语义文本,以平衡字符和长度分布并覆盖稀有字符。
- News Crawl 报纸语料提供真实句子级文本,从中提取不同长度的短语和句子。
-
关键处理细节
- 作者采用并改造了 UnionST 合成引擎。
- 使用 PP-OCRv5 MLT 和标准脚本定义为每种目标脚本构建字符词汇表。
- 该字符集用于过滤和采样扩展。
- 布局模板包括水平文本、垂直文本、多方向旋转文本和弯曲文本。
- 文本层在被叠加到背景之前会施加阴影、扭曲和透视等效果。
- 脚本特定调整包括:
- 中文、日文和韩文使用 20% 的垂直文本合成。
- 其他脚本使用 5% 的垂直文本合成。
- 阿拉伯文按从右到左渲染,并以逻辑顺序保存。
-
数据集使用方式
- TextMuSS-10M 作为后续脚本均衡、高精度场景文本识别模型的基础。
- 该部分未具体说明训练集划分、混合比例、裁剪策略或元数据构建细节。
方法
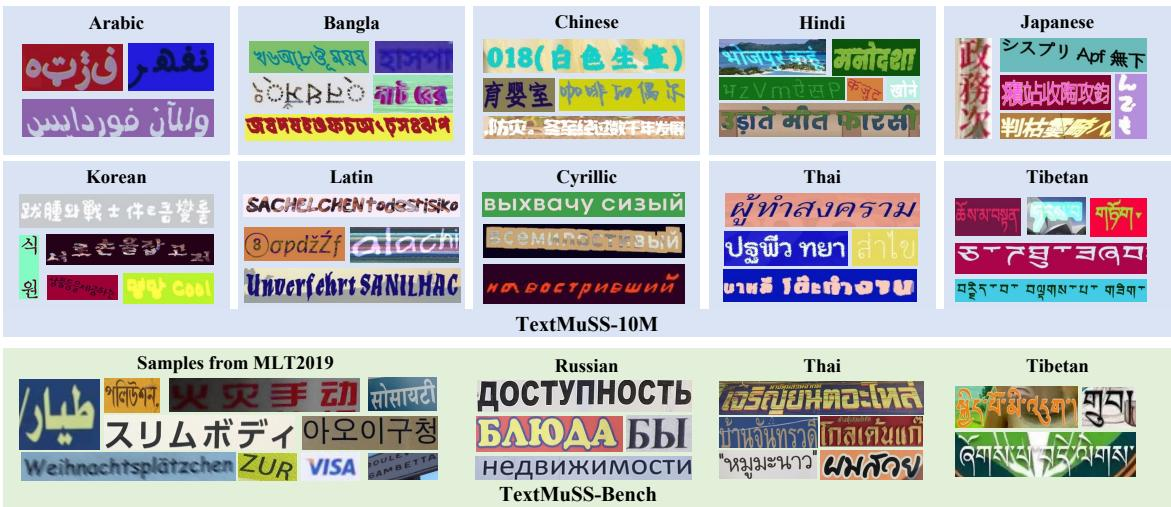
作者认为长尾脚本的数据稀缺是构建高精度多语言场景文本识别器的主要障碍。为解决这一问题,他们构建了 TextMuSS-10M,一个均衡的多语言合成数据集。他们通过为每种目标脚本收集特定字符词汇表和多样化语料来改造 UnionST 合成引擎。语料收集包括词级文本、用于模拟更长文本的拼接短语、用于稀有字符的随机排列,以及从报纸语料中提取的句子以模拟真实语义。还会应用语言特定调整,例如 CJK 脚本使用更高比例的垂直文本,阿拉伯文使用从右到左渲染。具体合成流程包括选择无文本场景图像作为背景,使用预设布局模板,包括水平、垂直、旋转和弯曲格式,渲染文本,施加阴影和扭曲等效果,并将文本层叠加到背景上。生成的合成示例如下所示。
为克服单个稠密解码器的容量限制,作者提出了 ScriptMoE,利用单图像少脚本先验。完整流程请参见框架图。
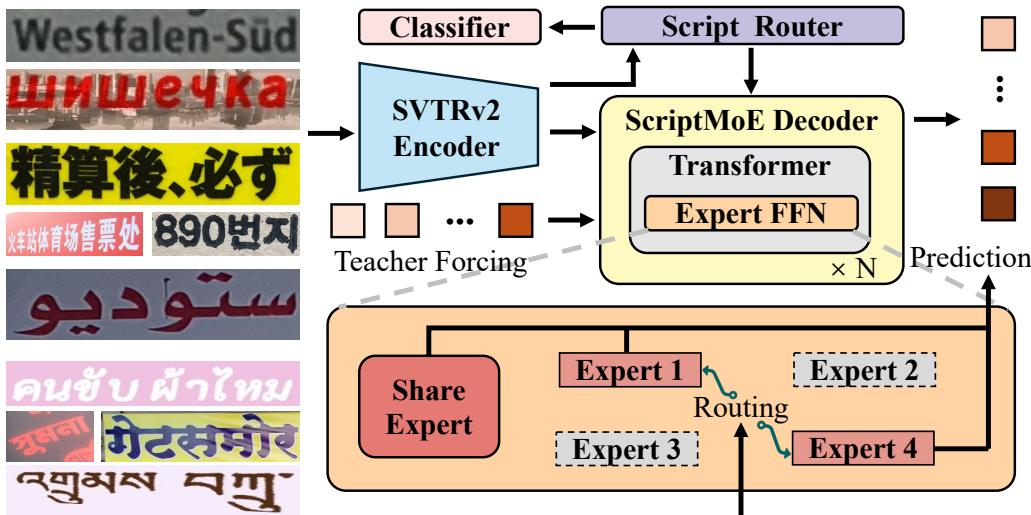
该架构首先使用分层视觉编码器(SVTRv2)将输入图像 x∈RH×W×3 映射为视觉 token 序列 F∈RL×d。这些 token 被输入脚本感知的 Transformer 解码器,其中标准前馈网络(FFN)被 Mixture-of-Experts(MoE)块替代。其余组件与普通 Transformer 解码器相同,以自回归方式生成输出。令 ht∈Rd 为第 t 步的解码器隐藏状态。MoE 层按如下公式计算输出:
MoE(ht)=αtFFNshare(ht)+(1−αt)i=1∑ngiFFNi(ht)其中门控权重 gi 由下式确定:
gi=∑jpj⋅I{j∈TopK(p)}pi⋅I{i∈TopK(p)}路由概率 p 通过下式计算:
p=softmax(Wg(Fˉ⊙(1+σ⋅ϵ)))其中,Fˉ∈Rd 是通过对视觉 token F 进行平均池化得到的图像级路由器输入。ϵ∼N(0,I) 是训练时施加的乘性路由器抖动,Wg 是路由器投影,TopK 选择得分最高的专家(Top-2)。可学习的逐 token 门控 αt=sigmoid(ws⊤ht) 用于平衡共享分支和路由分支。
关键的是,路由器输入按每张图像形成一次,而不是按每个 token 形成,这意味着同一张图像的所有输出 token 都由相同的路由专家处理。这种设计降低了路由成本,避免了 token 级不稳定,并使每个专家都能充当脚本专家。作者根据字符形态将十种目标脚本分为四类:字母类(拉丁文、西里尔文)、CJK(中文、日文、韩文)、阿拉伯文系和其他(印地文、孟加拉文、藏文、泰文)。
无论路由决策如何,共享专家 FFNshare 始终被激活。它吸收数字、标点和几何变形等脚本无关特征,保持跨脚本迁移,并防止公共知识碎片化。
为确保路由器与真实脚本对齐,而不是发现任意分组,作者引入了脚本分类信号。将辅助四分类头 hscls:Rd→R4 连接到相同的池化路由器输入 Fˉ。该头使用交叉熵损失针对脚本组标签 yx 训练,yx 通过将真值转录字符的 Unicode 范围映射到四个脚本组之一自动得到:
Lscls=−∣B∣1x∈B∑logsoftmax(hscls(Fˉx))yx其中 B 为 mini-batch。该分类器共享路由器输入但不共享路由器权重,提供脚本感知的学习信号,同时允许路由器形成有用的脚本内子群体。
整个 ScriptMoE 模型通过最小化以下组合目标进行端到端训练:
L=Lar+λsclsLscls其中 Lar 是标准自回归交叉熵损失。辅助项 Lscls 以 λscls=0.1 加权,使专家朝向脚本方向,同时不过度限制路由器灵活性。
实验
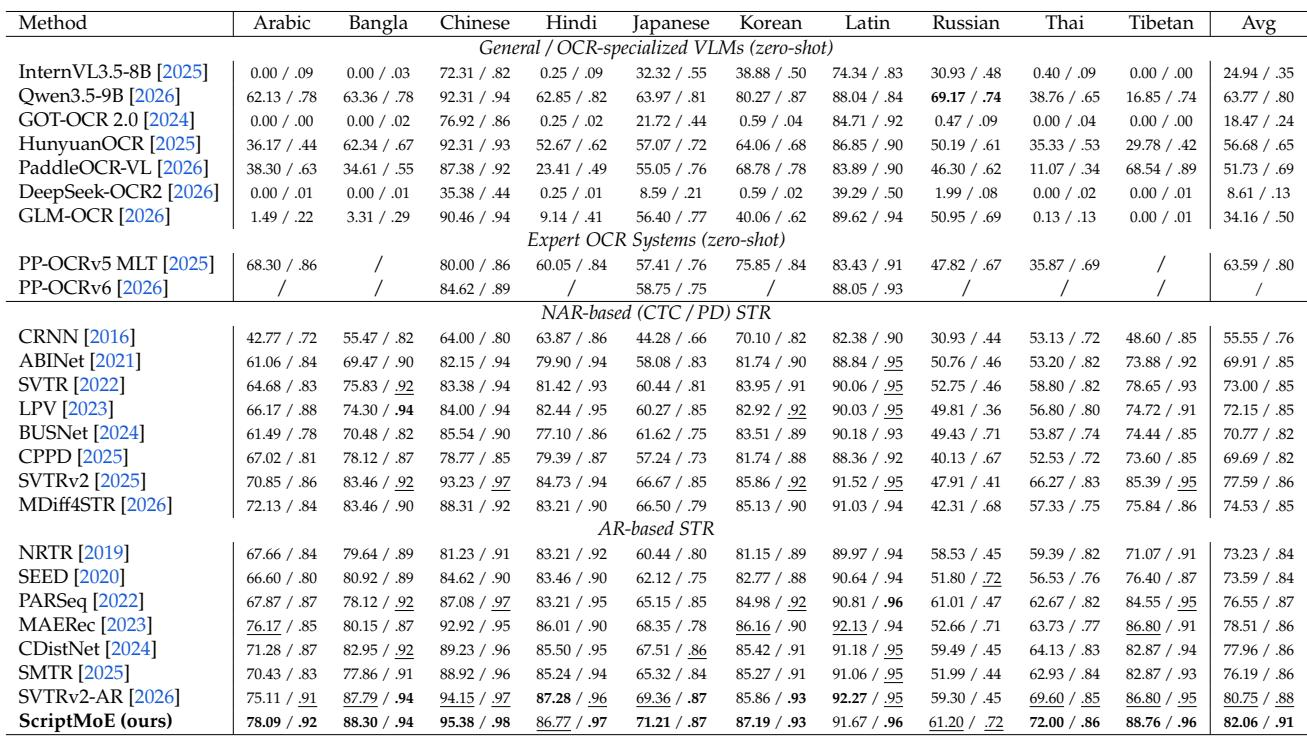
ScriptMoE 在覆盖十种脚本的 TextMuSS-Bench STR 基准以及使用 CC-OCR 的端到端多语言 OCR 上进行评估,采用固定检测器并在相同数据上训练基线以进行公平比较。主要结果表明,ScriptMoE 尤其改善了低资源脚本的识别,其路由器学到了脚本特定的专家专业化,而宽泛的通用 OCR 系统并不能保证多语言准确率。消融实验证实,合成数据对未见的低资源脚本至关重要,适度稀疏的 Mixture-of-Experts 解码器比稠密或过度专用变体更有效,脚本感知组件为低资源脚本带来最大收益。
基准包含 10,899 张图像,覆盖十种主要脚本。拉丁文是主导脚本组,贡献了超过一半的图像,其余脚本的表示则小得多且不均衡。在非拉丁脚本中,俄文和泰文拥有最大的评估集,中文和藏文属于最小的评估集。拉丁文贡献了基准中的大多数图像。非拉丁脚本表示不均衡,俄文和泰文大于中文和藏文。包括阿拉伯文、孟加拉文、印地文和藏文在内的若干脚本评估集相对较小。

ScriptMoE 在 TextMuSS-Bench 上的 STR 类模型中取得了最高的平均文本识别准确率,并超过了最强基线,在阿拉伯文、泰文和藏文等低资源脚本上增益最大。通用和 OCR 专用视觉语言系统明显落后,其中若干系统在阿拉伯文、孟加拉文和藏文上几乎完全失败。ScriptMoE 在实现这一结果的同时,每张图像激活的参数量远少于基于 VLM 的替代方案。ScriptMoE 达到 82.06% 的平均单词准确率,比最强 STR 基线高 1.31 个百分点。增益集中在低资源脚本上,阿拉伯文、泰文和藏文的提升尤为明显。通用视觉语言 OCR 系统平均落后 18 到 70 个点,部分系统在阿拉伯文、孟加拉文和藏文上崩溃。ScriptMoE 每张图像激活的参数量远少于基于 VLM 的系统。
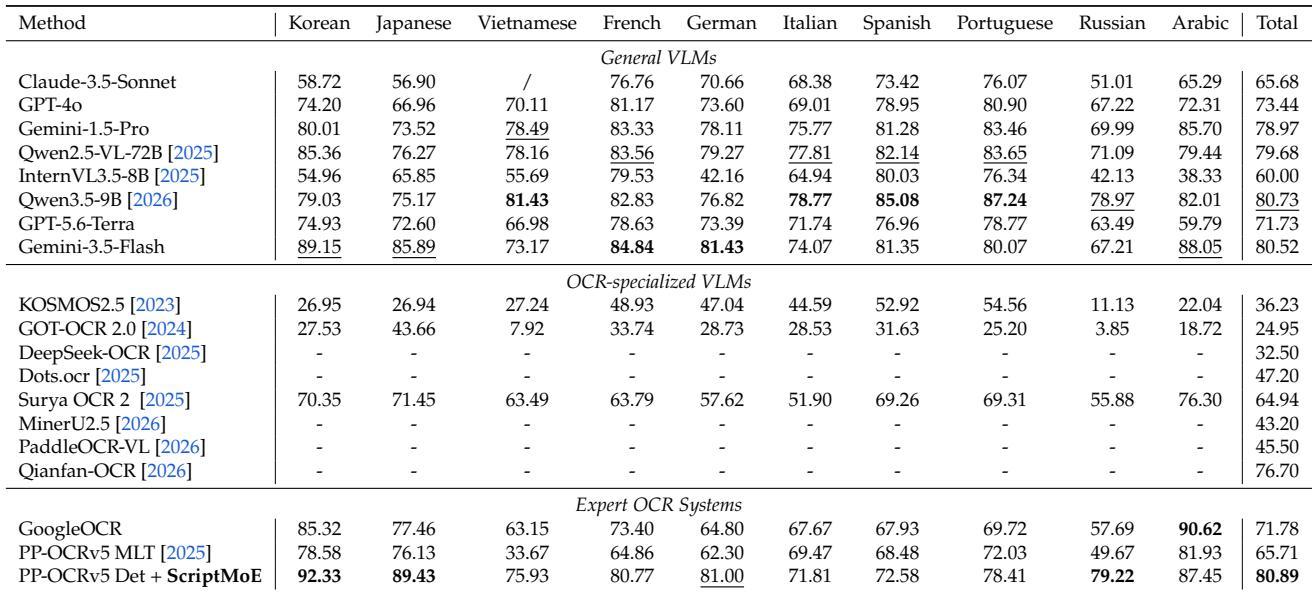
在多语言端到端 OCR 基准上,通用视觉语言模型表现差异很大,Qwen3.5-9B 领先,InternVL3.5-8B 明显落后。将 PP-OCRv5 MLT 识别器替换为 ScriptMoE 后,整体 F1 从约 66 提升到约 81,略高于最强的通用和专用基线。由于检测器固定,这一增益归因于更强的脚本感知识别。在通用 VLM 中,Qwen3.5-9B 取得最高的总 F1,紧随其后的是 Gemini-1.5-Pro 和 Qwen2.5-VL-72B;InternVL3.5-8B 明显落后,尤其是在阿拉伯文、俄文和德文上。基于 ScriptMoE 的 OCR 在使用固定检测器的情况下,超过了最强的零样本通用 VLM、最佳的 OCR 专用 VLM 以及专家 OCR 基线,表明识别质量推动了改进。西班牙文、葡萄牙文、法文和意大利文等拉丁文语言的得分在各系统间往往更高,而韩文、日文和阿拉伯文的表现更不稳定。
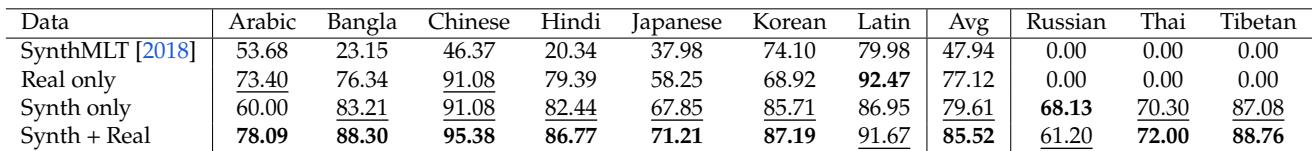
仅真实数据训练在它看到的七种脚本上表现良好,但在俄文、泰文和藏文上失败。仅合成数据训练覆盖全部十种脚本,并且在七种脚本平均准确率上已经超过仅真实数据训练,而组合设置取得了最高的整体准确率。主要权衡是拉丁文和俄文出现小幅下降,这归因于拉丁文和西里尔文之间的视觉混淆。仅真实数据训练在俄文、泰文和藏文上崩溃,而仅合成数据训练将这些脚本从零提升到相当高的准确率,并在七种脚本平均准确率上已经超过仅真实数据训练。组合真实和合成数据产生了最佳整体准确率,但添加合成数据会略微降低拉丁文,添加真实数据会略微降低俄文,这表明存在拉丁文与西里尔文之间的跨脚本混淆。
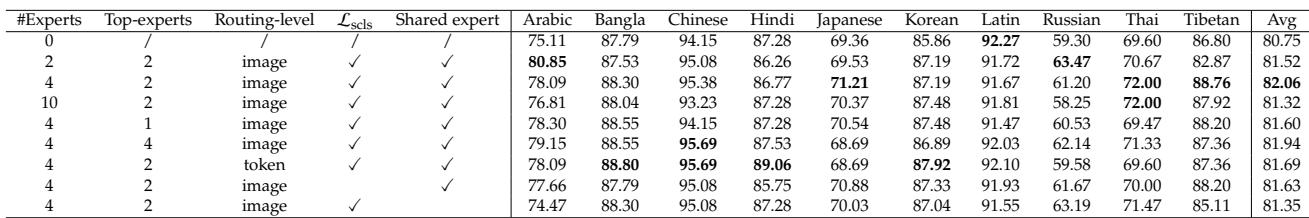
MoE 解码器对多脚本识别至关重要:不含专家的纯 AR 基线除拉丁文外均落后于 MoE 配置。四个专家配合 top-2 路由取得了最佳平均准确率,而扩展到每个脚本一个专家或对每个样本激活更多专家并不能改善整体性能。脚本感知组件带来进一步收益,共享专家对低资源脚本尤其重要。无 MoE 基线平均而言不如 MoE 变体,仅在数据最丰富的拉丁文上仍具有竞争力。四个专家配合 top-2 路由产生了最佳平均准确率,与基线相比在泰文和中文上有明显增益。使用十个专家,每个脚本一个,相对于四个专家会降低准确率,因为每个专家看到的样本太少而无法专业化。Top-1 路由优于无 MoE 基线,但在泰文和中文上弱于 top-2;top-4 路由增加了成本而没有明显的平均收益,并损害日文和韩文。Token 级路由整体表现与图像级路由相似,存在较小的逐脚本权衡,但路由器成本更高。移除共享专家比移除脚本分类信号造成更大的平均下降,且下降集中在阿拉伯文和藏文等低资源脚本上。
实验在十种脚本基准上评估多语言场景文本识别,该基准中拉丁文占主导,非拉丁脚本表示不均衡;同时还在固定检测器下测试端到端 OCR。ScriptMoE 超过强 STR 基线和通用或 OCR 专用视觉语言模型,在低资源脚本上增益最大,并将端到端 OCR F1 从约 66 提升到约 81,表明识别质量推动了改进。数据消融显示,仅真实数据训练在未见的脚本上失败,合成数据对覆盖范围至关重要,组合训练效果最好,仅存在轻微的拉丁文/西里尔文混淆。MoE 消融确认专家解码器是必要的,四个专家配合 top-2 路由最有效,共享专家尤其有利于低资源脚本。