Command Palette
Search for a command to run...
OmniEcho:面向全模态具身智能体的音视频空间理解
OmniEcho:面向全模态具身智能体的音视频空间理解
摘要
人类能够毫不费力地定位声源方向,并将其与视觉线索结合进行推理,然而这对具身智能体而言仍具挑战性。特别是,如何在具身场景中有效评估和建模空间音频理解仍不清楚。为弥补这一空白,我们提出了 OmniEchoBench,一个面向空间音视频感知和音频-视觉-语言导航的统一基准。OmniEchoBench 包含 6 个任务,涵盖 197 个真实世界空间音视频场景、2,972 个问答对和 900 个导航样本,并包含从 30 个真实环境采集的一阶 Ambisonics(FOA)音频。为实现可扩展的训练监督,我们开发了一个可控的空间音频渲染管线。该管线保持了声源、视觉观测和智能体轨迹之间的几何一致性。在此基础上,我们提出了 OmniEcho,一个具有空间感知能力的全模态模型。它在预训练语义音频通路之外,引入了一个 FOA 空间编码器。大量实验表明,OmniEcho 在空间音视频感知上取得了当前最优性能。在声音引导的导航任务中,OmniEcho 的性能接近传统视觉-语言导航。这些结果表明,空间音频可以作为具身场景推理和导航的重要信号,同时也凸显了细粒度空间定位和距离估计作为重要的开放挑战。我们的代码和数据将发布于 https://github.com/PKU-VaLuE-Lab/OmniEcho/tree/main。
一句话总结
北京大学、阿里巴巴集团和清华大学的研究人员提出了 OmniEchoBench,一个涵盖 197 个真实世界空间音视频场景、2,972 个问答对和 900 个一阶 Ambisonics 导航样本的六任务基准,同时提出了 OmniEcho,一个具备空间感知的全模态模型,在预训练语义音频通路中加入 FOA 空间编码器,在空间音视频感知和声音引导导航方面达到领先水平,性能接近传统视觉语言导航。
核心贡献
- 提出 OmniEchoBench,一个面向空间音视频感知和声音引导导航的统一基准,包含 6 个任务,覆盖 197 个真实世界场景、2,972 个问答对,以及来自 30 个环境、使用一阶 Ambisonics 音频的 900 个导航样本。
- 提供可控制的空间音频渲染流程,保持声源、视觉观测和 agent 轨迹之间的几何一致性,从而实现可扩展的监督。
- 提出 OmniEcho,一个将 FOA 空间编码器与预训练语义音频通路相结合的全模态模型;实验表明其空间音视频感知和声音引导导航性能达到领先水平,接近传统视觉语言导航,但细粒度定位和距离估计仍然是开放挑战。
引言
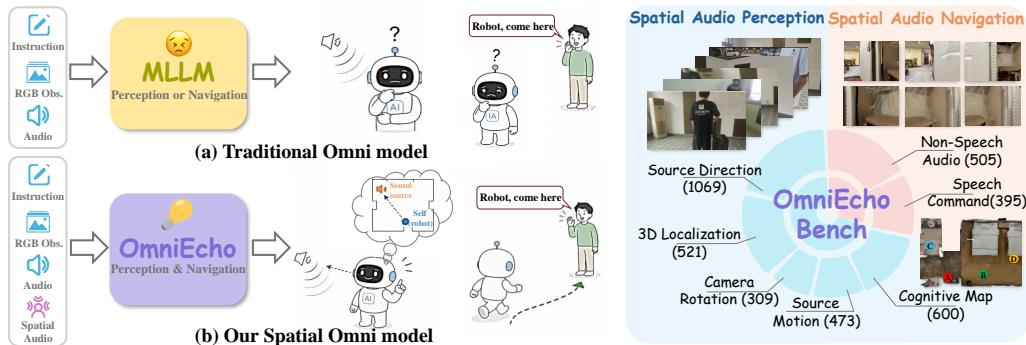
具身 agent 需要丰富的多模态信号,但空间音频在很大程度上仍未得到充分探索,尽管它有助于人类定位被遮挡或视野外的目标。现有的视觉语言导航模型主要以视觉和文本为驱动,音视频导航基准通常依赖渲染声学结果而非真实世界录音,而采集真实空间音频数据成本高昂,因为信号取决于声源和听者姿态、场景几何、反射和混响。作者提出了 OmniEchoBench,一个统一空间音视频感知和声音引导导航的真实世界基准,同时提出一个可控制的空间音频渲染流程,用于生成可扩展的训练数据。他们还提出了 OmniEcho,一个基于 Qwen3-Omni 构建的空间感知全模态模型,加入 FOA 编码器和三阶段训练流程,以将语义音频理解、空间音频理解与视觉和语言输入整合。
数据集
数据集描述
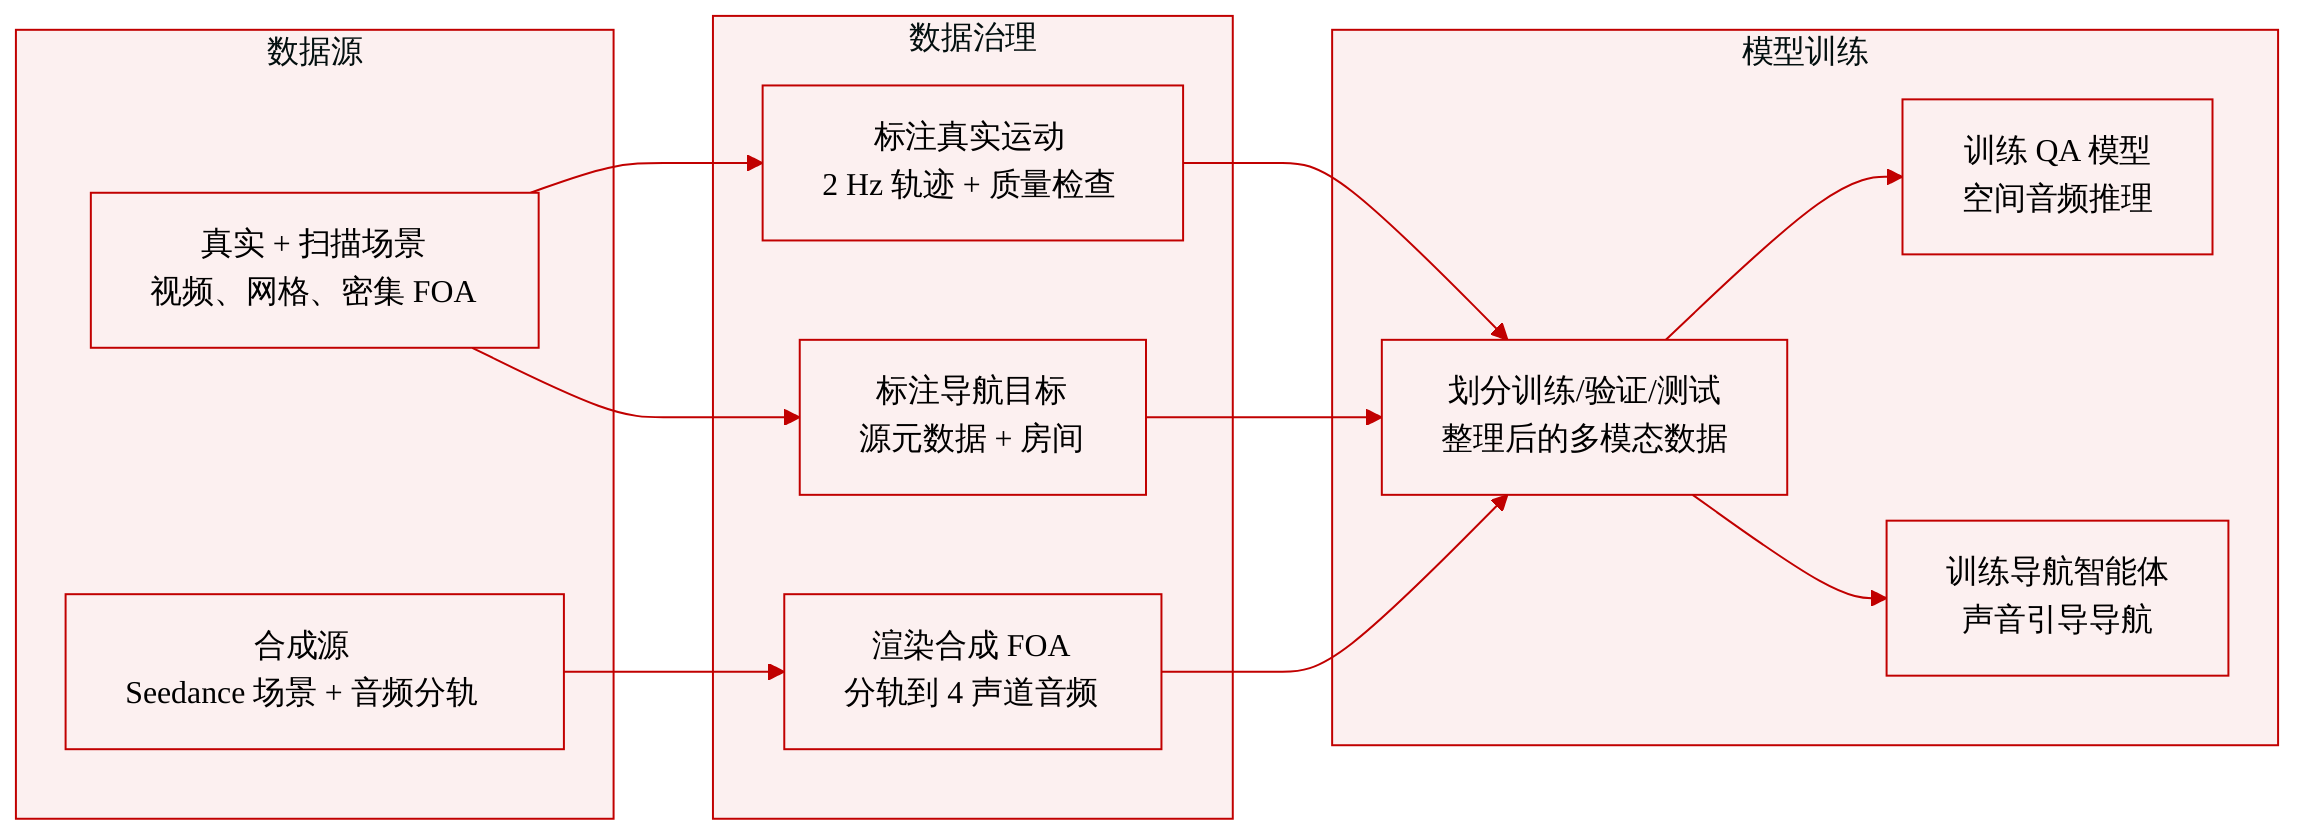
作者提出了两个真实世界基准数据集:OmniEchoBench-QA 和 OmniEchoBench-Nav,以及基于统一的一阶 Ambisonics(FOA)空间音频渲染框架构建的合成训练数据流水线。
1. OmniEchoBench-QA
- 来源与组成: 采集自按照编写脚本进行的真实人类表演。每条记录包含第一人称主视角视频、360 度全景视频,以及 ACN/SN3D 格式的 4 通道 FOA 音频。
- 规模: 共 2,972 个问答对。
- 子集:
- 细粒度时序空间推理:2,372 个问答对,覆盖声源方向(1,069)、3D 定位(521)、声源运动(473)和相机旋转(309)。
- 鸟瞰音频驱动定位:600 个问答对,使用以自我为中心的俯视地图和来自导航场景的 FOA 片段。模型从标记为 A、B、C、D 的四个候选位置中选择一个。
- 筛选与标注: 脚本特意强调画外和跨边界声源,使仅凭视觉输入不足。全景视频仅在标注阶段使用;测试时模型接收单视角视频或静态图像加上 FOA 音频。标注者以 2 Hz 标记每个活动声源,生成密集的时空轨迹,随后基于规则的采样创建类型化问题和真值答案。
2. OmniEchoBench-Nav
- 来源与组成: 来自 30 个真实扫描室内环境的真实世界室内导航数据。其中包括 10 个单房间场景和 20 个多房间或跨房间布局,跨越 2 到 4 个相连房间。每个环境以带纹理网格形式提供,格式为 .glb,并附带俯视平面渲染图。
- 规模: 每个环境 30 个导航样本,共 900 个样本。该基准包含 12,900 条 FOA 录音,每条为 4 通道、48 kHz,在密集接收器网格上采集。
- 声源类别: 505 个样本使用非语音环境事件,如机械声、警报声、门铃、动物声和脚步声;395 个样本使用语音指令,如求助请求和呼叫。
- 元数据与模式: 每个声源都标注了声源设备、房间、语义描述和自然语言导航目标描述。
- 使用方式: 测试时,agent 从最接近其当前位置的接收器位置接收空间音频,并根据朝向进行方向重映射。agent 必须推断声源位置并朝向其导航。
3. 合成训练数据
- 作者使用统一的 FOA 渲染框架。每个发声声源用随时间变化的 3D 轨迹表示,听者与相机同位置。声源干声通过实球谐函数编码为 4 通道 FOA 音频,声源方向变换到听者坐标系,并可选择距离衰减或房间效应。
- 空间音视频问答数据: 动态场景由 Seedance 生成,并与基于轨迹的声事件结合。随后从这些场景合成 FOA 音频和问答对。
- 纯音频数据: 合成额外的纯音频训练数据,以支持 FOA 编码器预训练和问答。
- 导航数据: 对现有 VLN 轨迹进行目的地条件声事件增强,并沿采样的轨迹渲染 FOA 观测。
- 产生的监督: 数据集为感知和导航任务提供同步的视觉观测、空间音频以及基于几何的监督。
- 裁剪与划分细节: 本节未描述单独的裁剪流程。主视图限制是全景视频仅用于标注,而主视角视频或静态图像在测试时使用。所提供章节未说明明确的训练划分比例或混合比例。
方法
作者使用统一的一阶 Ambisonics 空间音频渲染框架构建基准和训练数据。在该设置中,每个发声声源由随时间变化的 3D 轨迹定义,而听者与相机在右手坐标系中同位置。给定声源轨迹和听者姿态,每个单声道声源干声通过实球谐函数编码为 FOA:
a(t)=i∑ri(t)giY(θi(t),ϕi(t))si(t)其中 si(t)、ri(t) 和 gi 分别表示声源干声、声源到听者的距离和声源增益。声源方向被变换到当前听者坐标系,以保持与视觉观测的空间对齐。
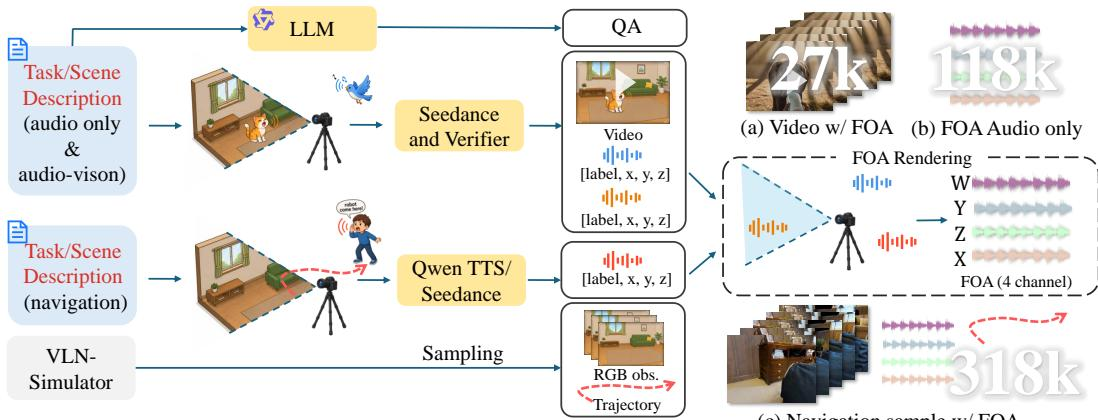
这一统一公式支持两条主要训练数据流水线。对于空间音视频问答,作者生成动态场景,并将视觉内容与基于轨迹的声事件结合,以合成 FOA 音频和问答对。他们还合成纯音频训练数据以支持 FOA 编码器预训练。对于声音引导导航,现有视觉语言导航轨迹通过目的地条件声事件进行增强,并沿采样轨迹渲染相应的 FOA 观测。
为在单一具身 agent 框架中统一空间音视频感知和导航,模型被设计为处理不同的任务形式。对于感知任务,模型输入 FOA 音频 A、视频序列 V 或单张图像 I,以及问题 q,预测答案 a。对于导航任务,在每个决策步,模型接收语言指令 L、前置摄像头采集的 T 帧,以及当前时间窗口内的 FOA 空间音频 At,预测接下来 K=8 个时间步的轨迹。
该方法的核心在于空间音频编码过程,该过程分三个阶段执行。第一阶段,作者预训练一个轻量 FOA 编码器 fθ,将 FOA 片段映射为 384 维 tokens 的时间序列。每个片段转换为 5 通道输入图,包括全向通道的对数梅尔频谱、三个活跃强度分量和扩散度。编码器使用 SigLIP 目标与冻结的 CLIP 文本编码器对齐表示,建立开放词汇声音语义空间。第二阶段,这个经过语义对齐的编码器针对查询条件下的声源定位进行微调。
在最后阶段,冻结的 FOA 编码器 fθ⋆ 被集成到 Qwen3-Omni 主干中。
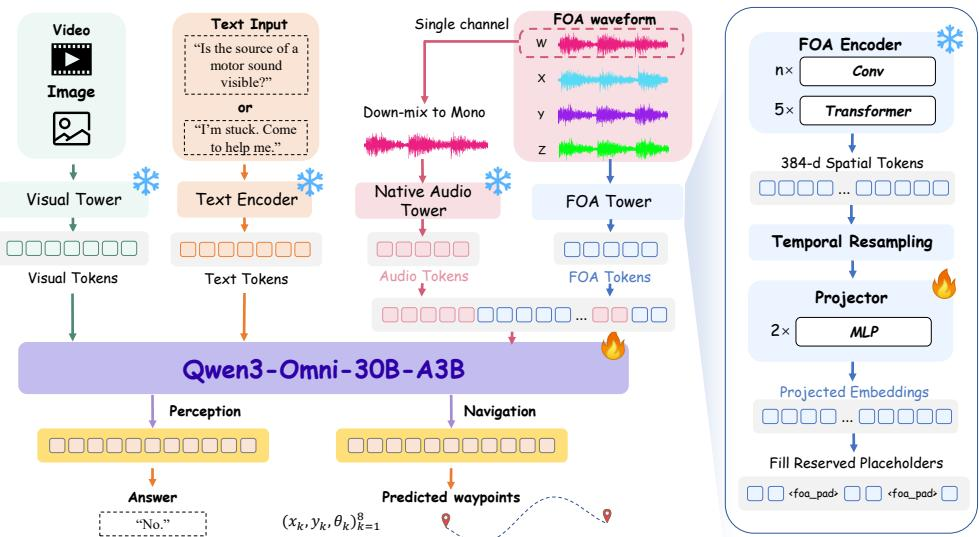
每个 FOA 片段沿两条互补路径处理。首先,其全向通道下混为单声道,并馈入原始的冻结音频塔,以保留原生语义 audio tokens。其次,同一片段经过 FOA 编码器以获得空间 tokens。这些空间 tokens 在时间上重采样到 7 Hz audio token 网格,并由可训练投影器映射到语言嵌入空间。投影后的空间 tokens 占据保留的占位嵌入行,并按时间顺序紧接在相应 audio tokens 之后插入。在此集成过程中,仅更新大语言模型参数和投影器,而 FOA 编码器、音频塔和视觉塔保持冻结。
实验
实验在训练于合成的 FOA 渲染音视频数据和导航数据之后,评估了一个全模态空间音视频模型在两个新提出的基准上的表现:用于空间音频问答的 OmniEchoBench-QA 和用于声音引导导航的 OmniEchoBench-Nav。结果表明,所提出的 FOA 编码器相比原生音频主干改善了空间推理,声源方向、定位和运动任务主要从空间音频求解,而相机旋转更多依赖视觉线索。导航实验表明,声音引导导航在真实世界场景中可以接近早期的文本引导基线,但可靠停止和高效导航仍然具有挑战性,消融实验确认专用 FOA 预训练和特征表示对于稳健性能至关重要。
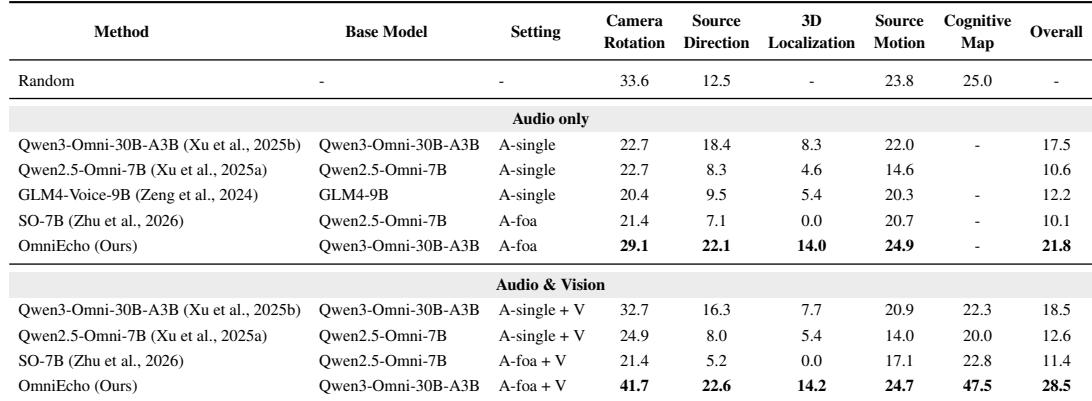
使用 4 通道 FOA 音频的 OmniEcho 在已报告的纯音频模型中取得最高总体准确率,并在空间推理任务上始终超过单通道 Qwen3-Omni 主干。提升最明显的是以声源为中心的能力,如方向、定位和运动,而相机旋转仍然困难,更依赖视觉证据。对于 SO-7B 等缺乏互补视觉监督的模型,真实世界空间音频理解仍然是一个局限。OmniEcho 在总体准确率和所报告的空间任务上均优于所有比较的纯音频模型。相比单通道音频,使用 FOA 音频在声源方向、定位和运动上改善了 Qwen3-Omni 主干的表现。相机旋转相对于随机概率是最薄弱区域,在缺乏视觉输入时性能大幅下降。
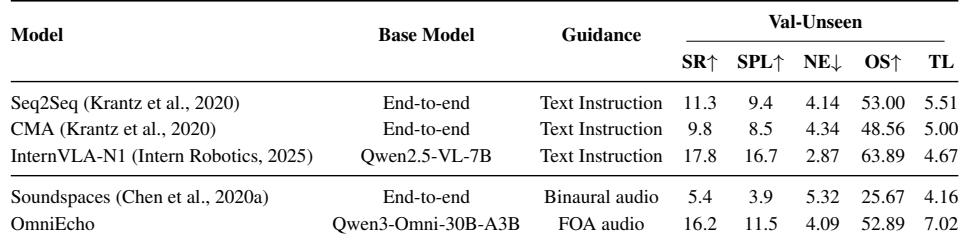
在 OmniEchoBench-Nav 基准上,使用 FOA 音频引导的模型在成功率和路径效率上接近早期的文本引导 VLN 基线,优于 Seq2Seq 和 CMA,但落后于 InternVLA-N1。双耳音频基线在所有指标上明显更差,表明模拟音频模型在这一真实空间音频环境中表现困难。尽管成功率具有竞争力,音频引导导航在停止和效率方面仍弱于最强的文本引导模型。FOA 音频模型在成功率和 SPL 上超过传统文本引导的 Seq2Seq 和 CMA 基线,但仍低于 InternVLA-N1。双耳音频基线在所报告模型中取得最低成功率和 SPL,而 FOA 音频模型轨迹长度最长,表明高效导航和可靠停止仍然具有挑战性。
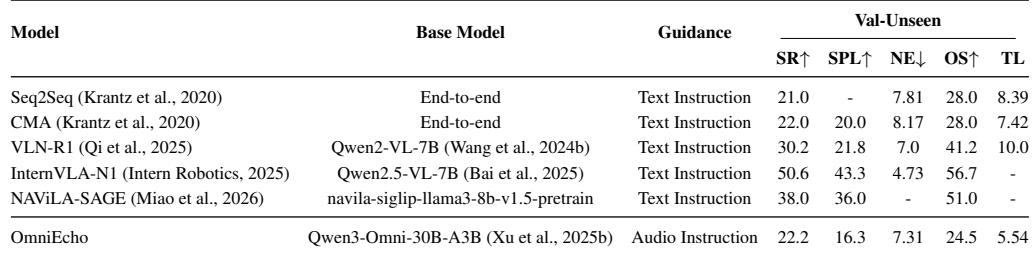
在模拟 VLN-CE R2R 验证上,带音频指令的 OmniEcho 在成功率上略高于早期文本引导基线,并改善了导航误差,但路径效率仍低于 CMA。它在成功率和路径效率上仍明显落后于更强的文本引导系统。总体而言,空间音频引导与早期文本引导导航模型具有竞争力,但与最先进文本引导方法之间仍存在明显差距。在 agent 停止条件下,OmniEcho 的成功率略高于 Seq2Seq 和 CMA,表明音频引导在任务完成方面可以匹配早期文本引导 VLN 基线。其导航误差低于 Seq2Seq 和 CMA,其轨迹长度在报告路径长度的模型中最短。OmniEcho 在成功率和 SPL 上仍大幅落后于 InternVLA-N1、NAViLA-SAGE 和 VLN-R1,表明相对于更强的文本引导系统存在明显效率差距。
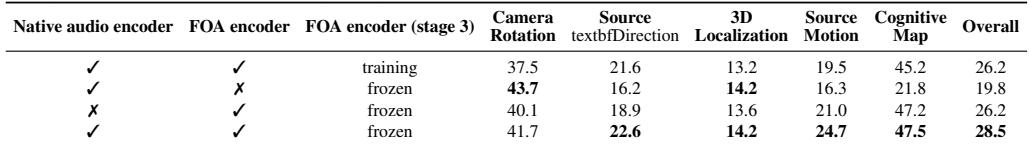
最强配置将原生音频编码器与冻结的 FOA 编码器结合,并在第三阶段保持 FOA 编码器冻结,取得最佳总体分数。相对于仅原生音频基线,加入冻结的 FOA 编码器改善了大多数空间任务,而去掉原生音频编码器或允许 FOA 编码器在第三阶段更新都会降低总体性能。这些结果表明,原生语义音频与专用空间编码是互补的,冻结有助于保持空间表示。在比较的所有配置中,将原生音频与冻结的 FOA 编码器结合取得最高总体性能。在仅原生音频设置中加入冻结的 FOA 编码器改善了总体和大多数子任务,仅相机旋转略有下降。在第三阶段训练 FOA 编码器而非冻结它,会使每个子任务和总体性能都下降。
跨基准来看,使用 4 通道 FOA 音频的 OmniEcho 在空间推理上始终优于单通道和其他纯音频模型,尤其在方向、定位和运动方面,而相机旋转在缺乏视觉输入时仍然困难。在导航中,FOA 音频引导在 OmniEchoBench-Nav 和模拟 VLN-CE R2R 上与早期文本引导 VLN 基线具有竞争力,但双耳音频表现差得多,且模型在成功率和路径效率上仍落后于更强的文本引导系统。消融实验表明,将原生音频编码器与冻结的 FOA 编码器结合取得最佳结果,说明语义音频与专用空间编码是互补的,冻结有助于保持空间表示。