Command Palette
Search for a command to run...
OmniEdu:面向学习与教学的开放基础模型
OmniEdu:面向学习与教学的开放基础模型
Hao Liang Qihan Lin Meiyi Qiang Linzhuang Sun Hengyi Feng Mingrui Chen Sizhe Qiu Wentao Zhang
摘要
教育基础模型不仅要给出正确答案,还必须理解问题在课程体系中的位置、诊断学习者遇到困难的原因,并选择合适的教学回应。现有教育语言模型通常只专注于学科解题或辅导中的一项,而且其训练混合语料往往按来源或任务组织,并未明确平衡这些能力。我们提出 OmniEdu,一个面向 K–12 学习与教学的开放基础模型家族,并采用面向能力的指令微调语料进行训练。该语料融合了 100 多个教育资源和通用指令来源,并围绕四种互补能力组织监督:学科能力、课程定位、诊断推理以及教学行动与支架。多阶段流水线执行确定性清洗、语义审核与重写、特定任务质量评分、受 token 预算约束的多样性筛选以及教学指令分配,最终得到 69,999 个样本和 15.96M 个监督响应 token,其中包含 60,951 个教育特定样本。我们对 4B、9B 和 27B 模型进行微调,并在课程定位、K–12 解题和教学辅导基准上评估,同时辅以通用能力测试。在不同模型规模上,面向教育的调优一致地提升了全部三组教育能力。特别是,OmniEdu-27B 在 K12-Bench 上达到 63.12% EM / 76.69% F1,在 MathFish 上达到 85.89%,在 EDUMATH 上达到 86.95%,在 MathTutorBench 的 Scafold 设置上达到 78.74%,并在 LongTutor 上取得所评估模型中最高的 Teaching 平均值 3.02。这些结果表明,经过精心筛选、能力均衡的监督可以将通用语言模型转变为更强的教育系统:它不仅能解题,还能理解课程结构并支持有效的教学互动。
一句话总结
来自北京大学、中国科学院大学和中关村学院的研究人员提出了 OmniEdu,这是一个开放的 K-12 基础模型系列,使用面向能力的指令微调语料进行训练,明确平衡学科能力、课程关联、诊断推理和教学行动,而不是像此前的教育语言模型那样专注于问题求解或辅导中的单一方向;OmniEdu-27B 在全部三个教育能力组上均取得基准提升,包括在 K12-Bench 上达到 63.12% EM 和 76.69% F1,在 MathFish 上达到 85.89%,在 EDUMATH 上达到 86.95%,在 MathTutorBench 的 Scafold 设置上达到 78.74%,并在 LongTutor 上取得最佳 Teaching 平均值 3.02。
核心贡献
- OmniEdu 被提出为一个开放的 K-12 教育基础模型系列,使用面向能力的指令微调语料进行训练,平衡学科能力、课程关联、诊断推理以及教学行动和脚手架。
- 训练语料结合了 100 多个教育资源和通用指令来源,多阶段流程生成了 69,999 个样本和 15.96M 个有监督响应 token,其中包括通过确定性清洗、语义审核与重写、任务特定质量评分、token 预算多样性选择以及教学指令分配得到的 60,951 个教育特定样本。
- 在 4B、9B 和 27B 模型上对课程关联、K-12 问题求解和教学辅导基准的评估显示,在全部三个教育能力组上均有持续提升。OmniEdu-27B 在 K12-Bench 上达到 63.12% EM / 76.69% F1,在 MathFish 上达到 85.89%,在 EDUMATH 上达到 86.95%,在 MathTutorBench 的 Scaffold 设置上达到 78.74%,并在 LongTutor 上取得评估模型中的最佳 Teaching 平均值 3.02。
引言
大语言模型越来越多地用于教育领域,但仅看答案准确性无法覆盖辅导中的协调性要求:有效的模型必须将问题与课程结构联系起来,诊断误解,并选择能够保留学习者推理过程的教学脚手架。此前的教育模型往往按任务或学科将这些能力分离,而训练数据异构,可能掩盖预期的教学行为。作者提出 OmniEdu,这是一个开放的 K-12 基础模型系列,围绕四种能力组织:学科能力、课程关联、诊断推理以及教学行动和脚手架。作者开发了一个可复现的、面向能力的数据流程,策划出一个紧凑的 69,999 样本训练混合集,并带有明确的教学指令。评估显示,在 4B、9B 和 27B 规模上,课程关联、K-12 问题求解和教学辅导方面均有持续提升,其中 OmniEdu-27B 取得了较强的开放权重结果,并在若干问题求解基准上保持与更大规模专有系统的竞争力。
数据集
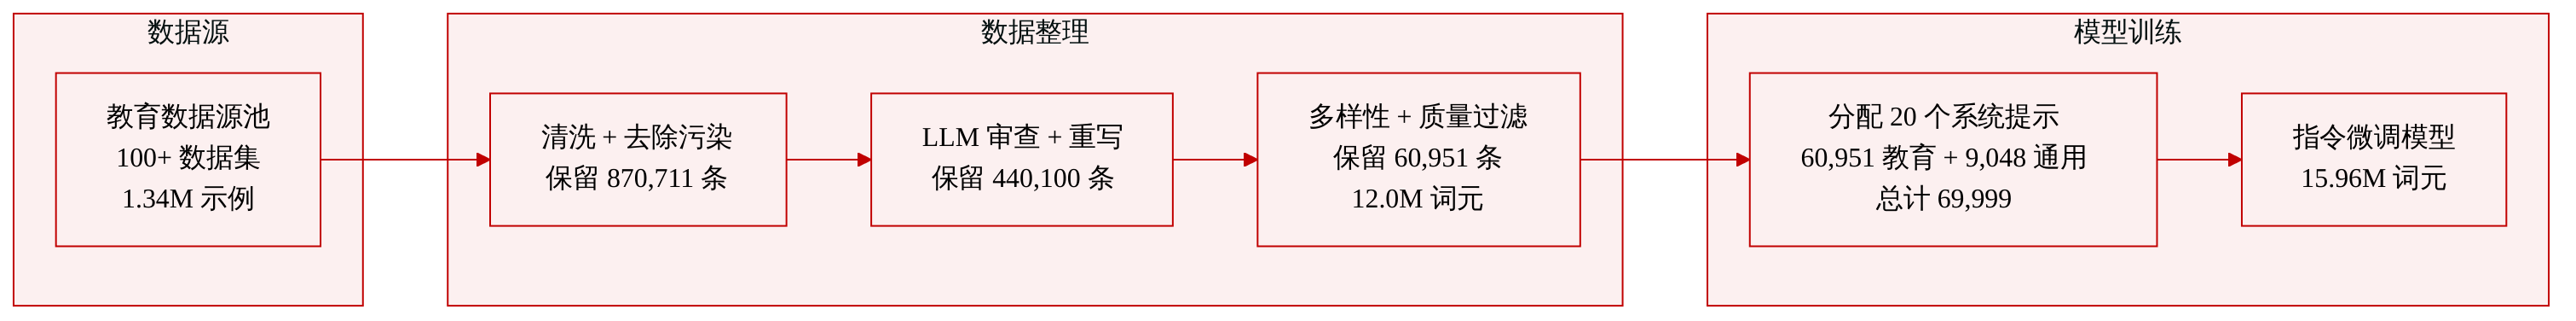
作者从 100 多个数据集和教育资源中构建了用于 K-12 教育的指令微调语料。在筛选之前,教育特定池约包含 1.34M 个样本。样本级来源、许可证、来源到类别的映射以及审核元数据在整个流程中均被保留。
数据集构成与能力分类
- 通用部分: 9,048 个样本,来自 DataFlow-Instruct-10K(7,431)、Tulu-3-SFT-mixture(1,495)和 MathV360K(122)。该部分保留了通用指令遵循、多语言覆盖、拒绝行为以及基于图表的推理。
- 教育特定部分: 语料的主要重点。筛选后包含 60,951 个样本,约 12.0M 个有监督响应 token。
- 能力类别: 每个教育特定样本被分配到一个主要能力:
- 学科能力
- 课程关联
- 诊断推理
- 教学行动和脚手架
- 样本进一步按任务形式、模态和监督类型划分为细粒度任务桶。
- 最终语料规模: 69,999 个样本和 15.96M 个有监督响应 token。
处理流程
-
确定性清洗与评估去重:
- 将来源标准化为统一表示。
- 去除完全重复和格式错误的样本。
- 在可能的情况下验证答案一致性。
- 仅保留混合领域来源中的 K-12 相关内容。
- 确认多模态样本的图像可访问性和对齐。
- 去除使用条件不明确以及与评估集存在重叠的样本。
- 结果:870,711 个教育特定样本。
-
LLM 辅助语义审核与重写:
- 使用 Qwen3.5-122B-A10B-FP8 对样本进行 0 到 100 的评分。
- 得分为 85 到 100 的样本保留,50 到 84 的重写,低于 50 的移除。
- 重写后的样本再次审核,仅在被归类为保留时保留。
- 结果:440,100 个教育特定样本。
-
初步多样性选择与细粒度质量过滤:
- 在 BGE-M3 嵌入上应用 k 中心贪心选择,以减少过度表示的来源。
- 示例包括:
- RACE:60,180 到 5,000
- AquilaEdu:23,226 到 2,000
- CJEval:17,178 到 2,000
- 使用 GPT-5.6-Terra 以 1 到 5 的尺度进行细粒度评分。
- 仅当所有适用维度得分至少为 3 时保留样本,且任务关键维度如正确性、有效性和关联性得分至少为 4。
- 结果:121,318 个教育特定样本。
-
token 预算多样性选择:
- 在细粒度任务桶内,在 BGE-M3 嵌入上执行 k 中心贪心选择。
- 为每个桶分配有监督响应 token 预算,而不是样本数预算。
- 结果:60,951 个教育特定样本和约 12.0M 个有监督响应 token。
-
教学指令分配与最终组装:
- 为每个样本分配 20 个任务特定系统指令模板之一。
- 模板涵盖推理式问题求解、阅读理解、诊断与纠正、苏格拉底式提问和辅导对话等行为。
- 原始用户和助手内容保持不变。
- 将样本转换为统一的消息格式。
- 具体化图像并将其与占位符对齐。
- 对消息结构、媒体可用性、重复标识符和跨类别重复进行最终检查。
数据使用方式
最终语料被用作教育语言模型的指令微调混合集。9,048 个通用样本维持广泛的指令遵循能力,而 60,951 个教育特定样本提供 K-12 学科知识、课程关联、诊断推理和教学监督。分配给每个样本的系统指令使预期的教学行为在训练期间得到明确表达。
方法
作者设计了一个六阶段数据准备流程,用于构建 K-12 指令微调语料。该流程从能力分类和来源收集开始,然后逐步将异构来源筛选为最终训练混合集,同时保留样本级来源和审核元数据。
第一阶段定义能力分类并收集教育特定来源,在过滤前得到约 1.34M 个样本的初始池。第二阶段将所有异构来源标准化为统一表示,去除完全重复的样本,并丢弃必填字段缺失或格式错误的样本。对于可以确定性验证答案的样本,流程检查所提供答案与对应参考或结构化标注之间的一致性。对于混合领域来源,仅保留 K-12 相关样本,与金融或一般百科知识等无关内容则被过滤掉。多模态样本会验证图像可访问性以及与文本输入的正确对齐。来源和许可证信息被保留,使用条件不明确的数据被排除,任何与最终评估集重叠的样本被移除以防止污染。该阶段将教育特定池缩减至 870,711 个样本。
第三阶段应用 LLM 辅助语义审核与重写。作者使用 Qwen3.5-122B-A10B-FP8 执行确定性规则无法处理的语义质量控制。每个样本使用任务特定的审核提示进行评估,并被赋予一个 0-100 的可用性分数以及三种操作之一:保留、重写或移除。得分为 85-100 的样本保留,得分为 50-84 的样本送去修复,低于 50 的样本丢弃。审核标准根据监督目标进行调整。学科能力样本检查答案正确性、答案与解释的一致性以及与给定问题或文本的关联。课程样本检查课程关系的有效性以及知识点对齐的足够具体性。诊断样本检查识别出的错误是否得到学生作业的支持,以及诊断解释和纠正响应是否与该错误一致。教学样本还会额外评估教学相关性、连贯性、脚手架质量以及最终答案的过早泄露。对于标记为需要重写的样本,原始输入保持不变,仅修复有缺陷的监督内容。重写后的样本使用相同标准再次审核,仅在被归类为保留时保留。该阶段留下 440,100 个教育特定样本。
第四阶段将初步多样性选择与细粒度质量过滤相结合。在应用更昂贵的质量评分器之前,作者针对少数高度过度表示的来源进行了缩减,这些来源的候选规模明显超出其在最终混合集中的预期贡献。对于这些来源,在 BGE-M3 嵌入上使用 k 中心贪心选择来选择语义多样的子集,而不是随机子采样。然后 GPT-5.6-Terra 使用从第三阶段标准细化而来的任务特定评分细则进行细粒度评分。每个适用维度按 1-5 分制评分。例如,问题求解数据会分别评估问题有效性、答案正确性、推理正确性、完整性、相关性和清晰度。仅当每个适用维度得分至少为 3 时,样本才会被保留,对于正确性、有效性和关联性等任务关键维度则有更严格的 4 分阈值。该阶段将候选池缩减至 121,318 个样本。
第五阶段在细粒度任务桶内应用 token 预算多样性选择。由于不同任务的响应长度差异显著,每个桶按有监督响应 token 分配预算。在每个桶内,再次使用 BGE-M3 嵌入上的 k 中心贪心选择来最大化语义覆盖,并贪心选择样本直至达到对应的有监督 token 预算。该阶段将教育特定池缩减至 60,951 个样本,约包含 12.0M 个有监督响应 token。
最后阶段分配教学指令并组装语料。作者为每个选定样本关联一个由其预定义任务桶确定的任务特定系统指令。使用 20 个系统指令模板,涵盖推理式问题求解、阅读理解、诊断与纠正、苏格拉底式提问和辅导对话等行为。这种设计使单个模型能够学习多种教学行为,同时在输入中明确表达所需行为。每个样本恰好接收一个系统指令,而原始用户和助手内容保持不变。最后,所有样本被转换为统一的消息格式,引用的图像被具体化并与对应的图像占位符对齐,并对消息结构、媒体可用性、重复标识符和跨类别重复执行最终完整性检查。
实验
论文首先标准化并过滤异构 K-12 来源,去除重复和评估重叠,保留 870,711 个样本用于语义审核。主要实验在该语料上微调三个不同规模的基础模型,并在课程关联、K-12 问题求解、教学辅导和通用基准上评估它们,与开放教育 LLM 和专有系统进行比较。面向教育的调优在所有规模上持续改善课程理解、考试式问题求解和辅导质量,其中在脚手架教学和学生学习历史使用方面提升尤为显著。这些专业化收益没有以牺牲通用指令遵循、推理或多模态理解为代价。
面向教育的调优在所有模型规模上改善了课程关联,其中 OmniEdu-27B 在评估模型中取得最强整体表现。在 K12-Bench、MathFish 和 EDUMATH 上提升一致,覆盖知识关联和结构性课程推理。OmniEdu-27B 在评估模型中的 K12-Bench 和 MathFish 上排名第一,在 EDUMATH 上仅次于 Kimi-K3。4B 和 9B 调优模型相对其基础版本也表现出显著且一致的提升,尤其是在 EDUMATH 上。
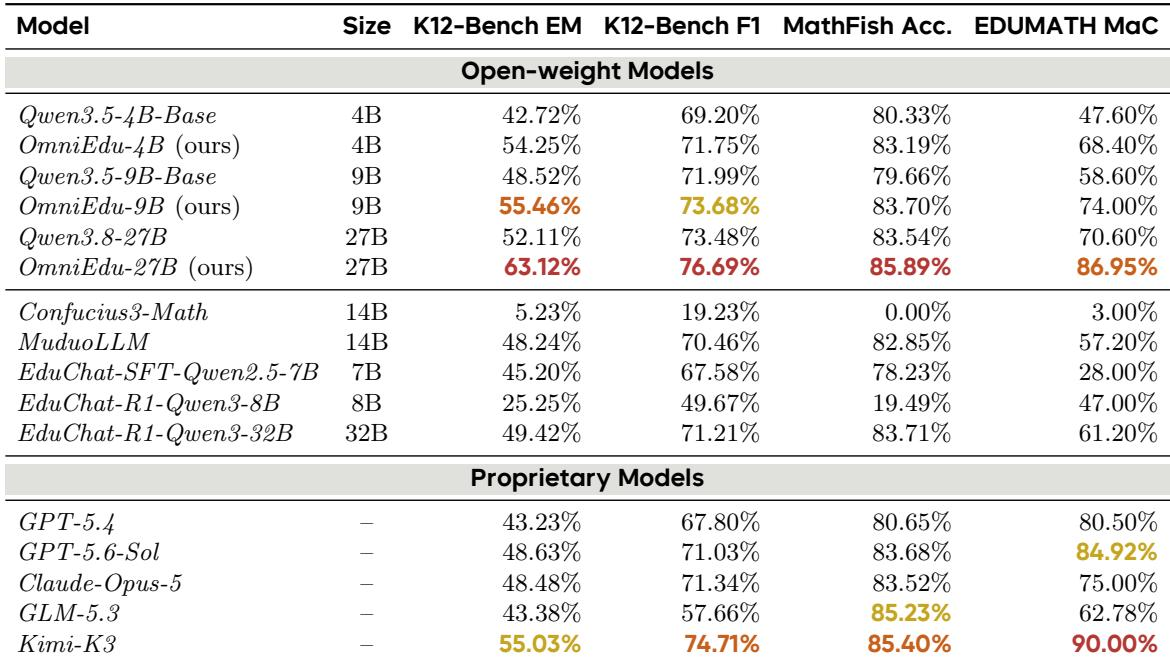
面向教育的调优在所有评估模型规模上改善了 K-12 问题求解。每个 OmniEdu 模型在 GAOKAO-Bench、EXAMS-V 和 MDK12-Bench 的整体指标上均优于其对应的基础模型,其中 OmniEdu-4B 在 EXAMS-V 上以及 OmniEdu-27B 在 MDK12-Bench 上的提升尤为显著。OmniEdu-27B 领先于开放权重教育基线,并在规模更小的情况下仍保持与前沿专有模型的竞争力。OmniEdu-27B 将 GAOKAO-Bench 满分率从 91.55% 提高到 94.87%,将 MDK12-Bench 总分从 46.04% 提高到 57.76%。OmniEdu-4B 显示出最大的 EXAMS-V 提升,整体准确率从 44.69% 上升到 57.62%。每个 OmniEdu 模型在整体 K-12 基准指标上均优于其对应的基础模型。OmniEdu-27B 在全部三个基准上均进入前三名,并领先于评估的开放权重教育基线。
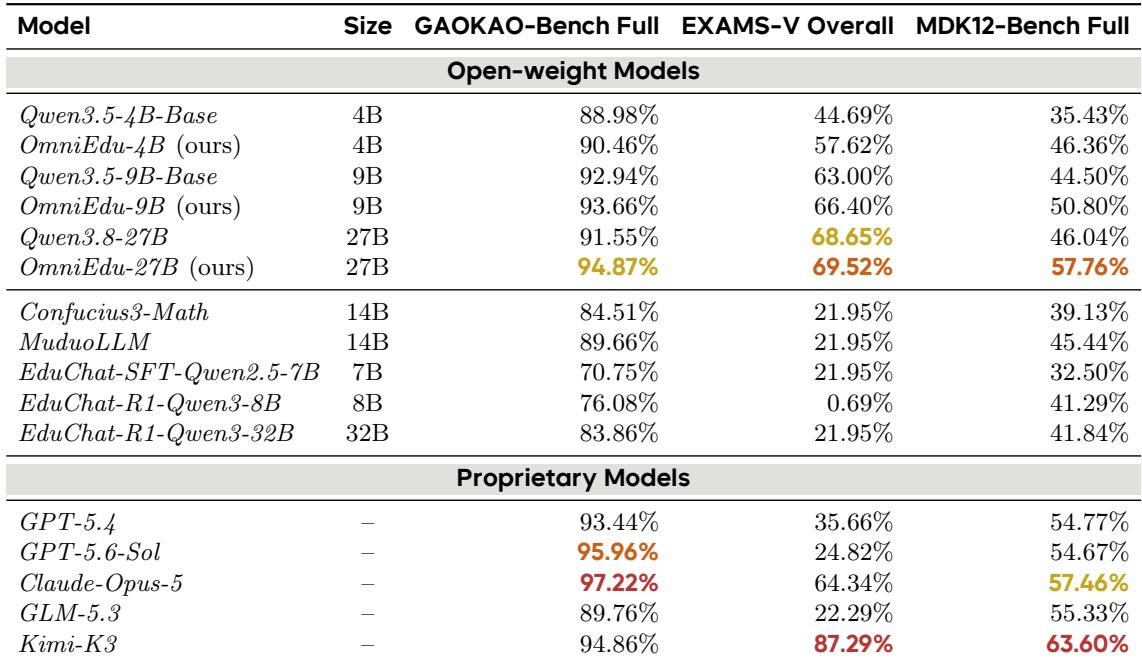
面向教育的调优在所有评估模型规模上改善了教学辅导表现。增益在脚手架数学辅导和利用纵向学生证据方面最大,调优模型显著优于其基础版本。最大的调优模型在列出的开放模型中取得了最强的整体辅导和教学分数,而知识状态诊断仍然相对困难。调优后,每种模型规模的脚手架和脚手架困难胜率均显著提高,其中较小调优模型的相对增益尤其大。调优后纵向学生证据的使用大幅上升,9B 模型从非常低的基础水平提升到与调优后的 4B 模型相当。27B 调优模型在整体辅导基准分数和教学平均值上领先于列出的模型,尽管知识状态诊断准确性仍然相对较低。
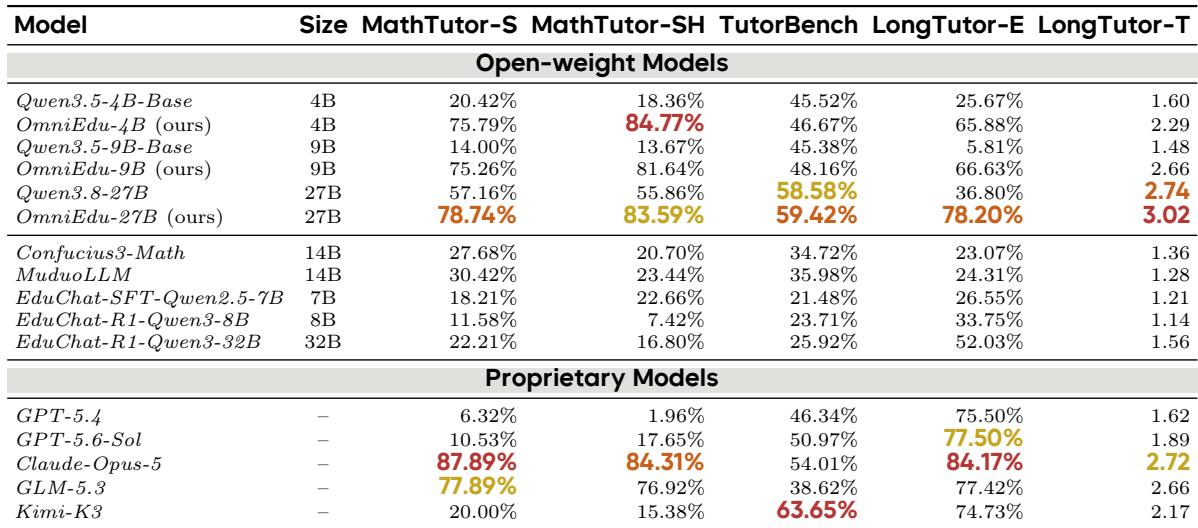
实验在面向教育的调优后,评估了 4B、9B 和 27B 规模的 OmniEdu 模型在课程关联、K-12 问题求解和教学辅导基准上的表现。在全部三个领域中,调优模型持续优于其基础版本,其中 OmniEdu-27B 在开放权重教育模型中取得最强整体结果,并保持与前沿专有系统的竞争力。最大增益出现在结构性课程推理、考试式问题求解、脚手架辅导和纵向学生证据使用方面,而知识状态诊断仍然相对困难。