Command Palette
Search for a command to run...
将 VLM 的智能迁移到机器人控制
将 VLM 的智能迁移到机器人控制
Meng-Hao Guo Zhe-Han Mo Jia-Jun Wang Yi Zhang Kejin Wang Yi-Xuan Deng Jia-Peng Zhang Yongming Rao Shi-Min Hu
摘要
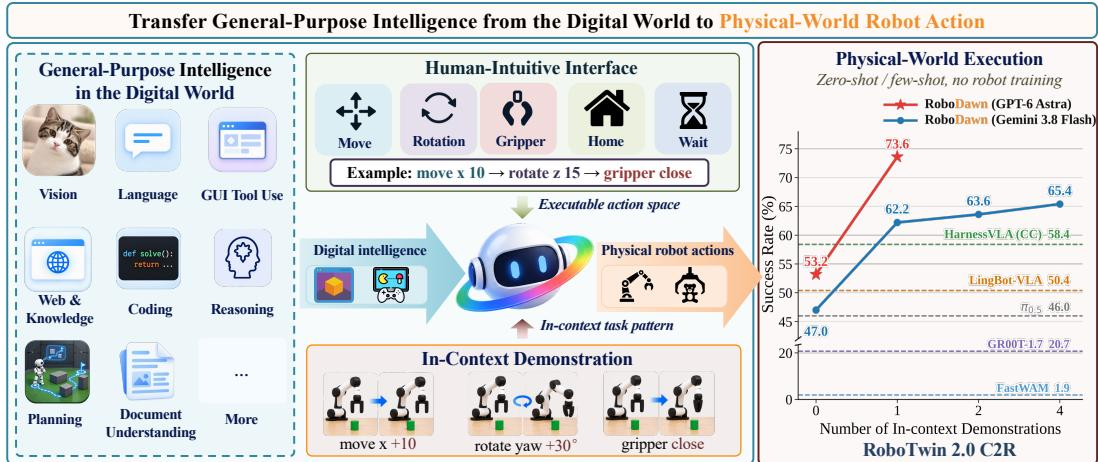
人类能够无缝地适应物理世界和数字世界,这表明尽管在具身、环境与任务方面存在数字到真实的差距,人类智能本身也可能跨越这一差距。这自然引出一个根本性问题:视觉语言模型(VLM)的智能是否也能类似地从数字世界泛化到物理世界,以用于机器人控制?我们通过 RoboDawn 来研究这一问题;RoboDawn 是一个符合人类直觉的接口,它通过一组紧凑的离散平移、旋转和夹爪指令,将机器人控制呈现给智能体式 VLM。利用该接口,VLM 以闭环方式控制机器人:它观察当前视觉状态,推理下一步动作,执行该动作,并根据结果状态调整后续决策。此外,我们引入了一种上下文学习(ICL)方案,该方案利用少量演示让 VLM 在接口使用和任务解决策略两方面得到有效引导。在 RoboTwin 2.0 C2R 和 RoboDojo 上的实验表明,RoboDawn 在无需针对特定任务的机器人训练的情况下取得了很强的性能。在零样本设置下,RoboDawn 优于多个在基准特定机器人数据上训练的强大策略;而单个上下文演示进一步带来显著的性能提升,并取得了最先进(SOTA)结果。在 RoboTwin 2.0 C2R 上,成功率从零样本的 53.2% 提升到单样本的 73.6%,超过了稳健基线 π0.5(46.0%)。在 RoboDojo 上也观察到类似的提升,成功率从零样本的 35.67% 提高到单样本的 47.17%。同一框架还能迁移到真实世界机器人上,在 Franka 上执行积木入篮和积木堆叠任务。
一句话总结
清华大学和腾讯混元的研究人员提出 RoboDawn,一种让 agentic VLM 通过离散平移、旋转和夹爪指令以及上下文学习方案执行闭环机器人控制的接口;在 RoboTwin 2.0 C2R 和 RoboDojo 上,它超越基线,从 zero-shot 的 53.2% 提升到 one-shot 的 73.6%,超过 π0.5(46.0%),并迁移到真实 Franka 机器人。
核心贡献
- RoboDawn 引入了一种符合人类直觉的接口,将 agentic VLM 暴露给一组紧凑的离散平移、旋转和夹爪指令,用于闭环机器人控制,无需针对具体任务的机器人训练。
- 一种上下文学习方案使用少量演示使 VLM 在接口用法和任务解决策略上建立基础,在无需参数更新的情况下提高操作性能。
- 在 RoboTwin 2.0 C2R 和 RoboDojo 上,zero-shot RoboDawn 超过若干较强的针对基准训练的机器人策略。一次演示将 RoboTwin 2.0 C2R 的成功率从 53.2% 提高到 73.6%,将 RoboDojo 的成功率从 35.67% 提高到 47.17%,并且该框架还迁移到真实 Franka 机器人上的方块入篮和方块堆叠任务。
引言
作者研究预训练视觉语言模型是否能将其数字世界中的推理和感知能力直接迁移到物理机器人控制,而无需进行机器人专项训练。此前的方法如视觉语言动作模型和世界动作模型需要大规模机器人动作数据集,这些数据集成本高、本体相关,并可能通过过拟合损害模型的通用推理能力。为解决这一问题,作者引入 RoboDawn,一种轻量接口,将离散运动原语暴露给冻结的 agentic VLM,并通过少量上下文演示支持闭环操作。实验表明,这种 zero-shot 方法可以超越经过机器人训练的策略,而且即使一个演示也能在仿真和真实任务中显著提高成功率。
数据集
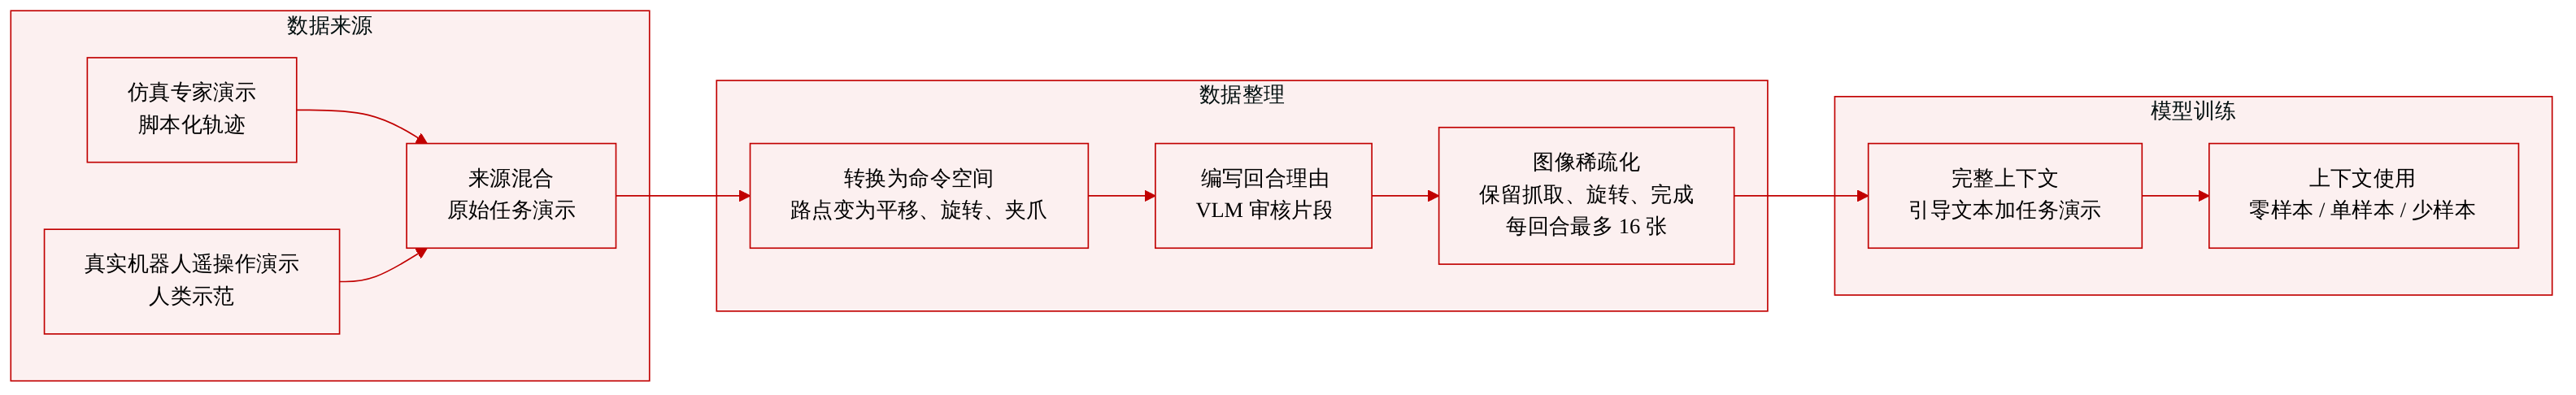
作者从两个层面构建上下文演示数据集:
- 共享指令入门:向模型说明所有基本指令效果。
- 任务级演示:从与评估不重叠的场景中收集,在仿真中使用脚本化专家轨迹,在真实机器人上使用人类遥操作。在仿真中,这些轨迹与用于训练对比机器人策略的轨迹相同。
- 演示格式:每个任务演示有 Nm 轮交互。每轮记录视觉观测、机器人状态、发出指令、这些指令的物理效果以及简短理由。物理效果由连续状态推导,即 GIP 位姿和夹爪开度的变化。
- 原始轨迹处理:原始专家轨迹被转换为语义指令空间。轨迹首先被简化为末端执行器路径点和夹爪状态,然后每个路径点被表示为平移、旋转和夹爪指令的短序列。理由随后由一个 VLM 生成,该 VLM 以任务无关提示回顾记录的片段。
- 过滤与图像稀疏化:某些轮次中视觉观测可能为空,同时完整文本轨迹被保留。对于长时程 RoboDojo 轨迹,上下文图像预算设为每轮 16 个观测。超出时,仅保留语义上有信息的轮次(如抓取、旋转和任务完成)的图像,省略视觉冗余的过渡轮次。
- 模型中的使用:完整上下文为 D=Dprim⊕Dtask。任务级演示通过 ND=0、ND=1 和 ND>1 支持 zero-shot、one-shot 和 few-shot 设置。入门展示原语指令效果,任务演示展示原语如何组合成完整行为。
方法
作者提出 RoboDawn,一种利用预训练视觉语言模型(VLM)进行闭环机器人操作的框架,无需特定任务的参数更新。系统通过符合人类直觉的语义动作接口和上下文演示来条件化 VLM,以连接多模态推理和物理机器人控制。
如下图所示:
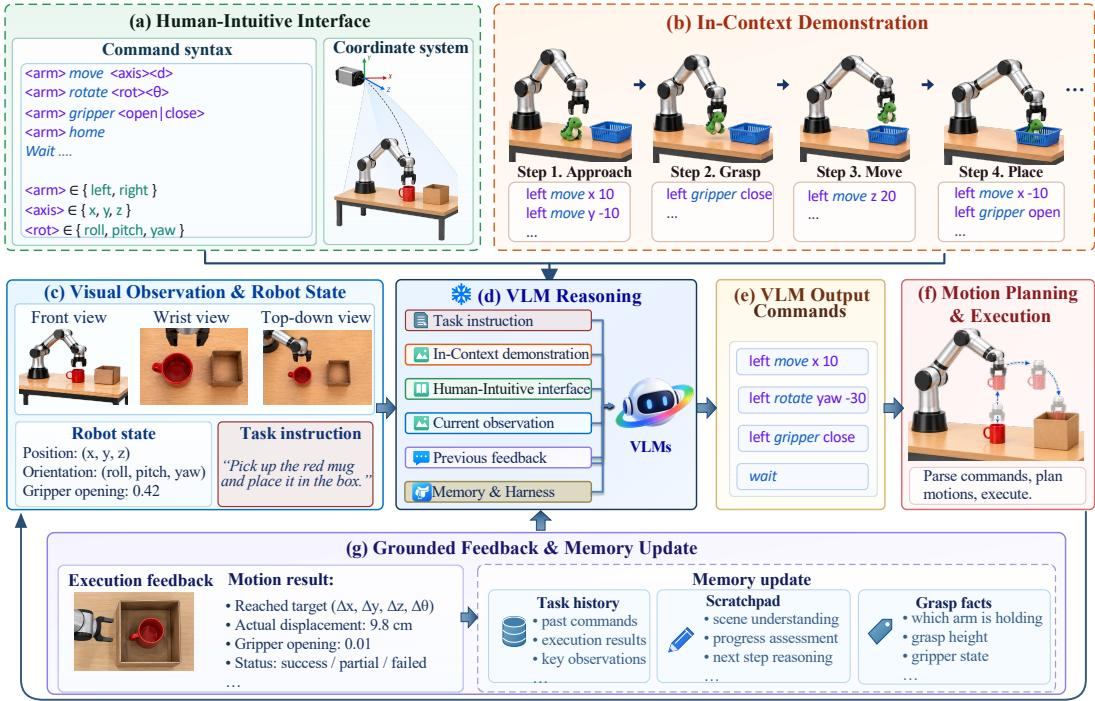
在每个决策轮次 t,VLM 接收带标注的视觉观测 It、测量到的机器人状态 xt、来自前一轮的执行反馈 Ft−1 以及交互记忆 Mt。模型还在整个 episode 中额外以两种固定上下文为条件:机器人-环境配置文件 E 和上下文演示集 D。配置文件 E 描述接口约定,如工作空间约束和夹爪属性,而 D 提供如何与环境交互的示例。闭环交互形式化为:
(yt,at)(st+1,Ft)(It+1,xt+1)Mt+1=πθ(L,E,D;It,xt,Ft−1,Mt),=EP(st,at),=OP(st+1),=U(Mt,at,yt,Ft,xt+1).这里,πθ 表示参数冻结的预训练 VLM。它输出语义动作指令序列 at 以及结构化响应 yt,其中包含任务进度估计、当前计划和紧凑的临时记录。执行算子 EP 解析这些指令,将其映射为机器人运动,并将物理结果转换为反馈 Ft。观测算子 OP 构造下一个视觉和本体感知观测,U 更新交互记忆。环境状态 st 形式化物理转移,但不直接暴露给 VLM,确保在线控制不依赖特权物体位姿。
为了促进这种交互,作者设计了一个以夹爪交互点(GIP)为中心的符合人类直觉的接口,GIP 定义为两个指尖之间的中点。该 GIP 在视觉标注、状态报告和运动指令中一致使用。VLM 并不预测关节级动作或高频连续控制,而是通过一组紧凑的参数化语义指令进行交互:
A={<arm> move <axis> <d>,<arm> rotate <rot> <\theta>,<arm> point <pose>,<arm> gripper <g>,<arm> home, wait, done}.在该语法中,平移和旋转轴均指世界坐标系,所有空间指令指定 GIP 位姿的增量变化。每条指令的平移幅度被裁剪为最大 20 cm,旋转幅度最大 90 度。每条语义运动指令被转化为到达目标 GIP 位姿的完整规划运动,并执行到机器人达到静止状态,从而抽象掉底层轨迹生成。
为了进一步消除动作语义和粒度上的歧义,作者实现了上下文学习设计。演示上下文被分解为 D=Dprim⊕Dtask,其中 Dprim 是共享指令入门,说明基本指令效果,Dtask 包含任务级演示。该形式通过改变任务示例数量支持 zero-shot、one-shot 和 few-shot 设置。原始专家轨迹被转换为语义指令空间,先简化为末端执行器路径点,再生成相应的平移、旋转和夹爪指令。每个完整演示由 Nm 轮交互组成:
D(m)={(Ij(m),xj(m),rj(m),aj(m),fj(m))}j=1Nm其中 Ij(m) 是视觉观测,xj(m) 是机器人状态,aj(m) 是发出的指令,fj(m) 是由连续状态推导的物理效果,rj(m) 是由 VLM 生成的简短理由。为管理上下文图像预算,视觉冗余的过渡轮次被省略,仅保留语义上有信息步骤(如抓取或任务完成)的图像。
实验
RoboDawn 在 RoboTwin 2.0 和 RoboDojo 仿真基准以及真实机器人上接受评估,以测试在无任务特定参数更新情况下的 zero-shot 和 few-shot 操作。在仿真中,它达到或超过经过机器人训练的基线和 agentic 基线;消融实验表明,推理、空间锚定、更强的视觉语言模型和更多演示会提升性能,而额外的测试时指令进一步提高成功率。真实世界部署可迁移到积木操作任务,但在布料折叠上因精确朝向要求而表现困难;失败分析突出显示细粒度控制有限、与 IK 相关的执行错误以及错误的成功判定。
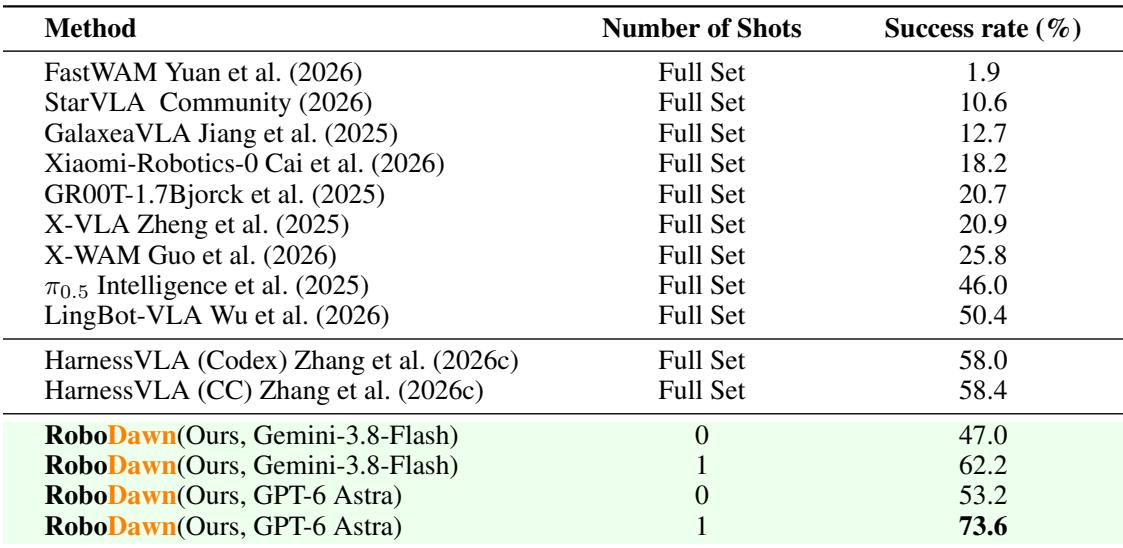
在 RoboTwin 2.0 C2R 上,许多在完整演示集上后训练的机器人基线在域随机化下仅取得中等成功率,而 RoboDawn 在无任务特定参数更新情况下执行控制。在 zero-shot 模式下,RoboDawn 超过若干强机器人策略,而单次上下文演示可大幅提高成功率,超过 agentic VLA 基线。这表明预训练视觉语言模型可以通过轻量动作接口将通用推理迁移到双臂操作中。与上下文 VLM 控制相比,完整集后训练的机器人策略通常在从干净到随机化的泛化上表现有限。即便没有任务特定训练,zero-shot 模式的 RoboDawn 已超过 π0.5 和 LingBot-VLA 等强机器人策略。单次上下文演示带来了显著成功增益,并使 RoboDawn 明显高于对比的 agentic VLA 方法。结果表明,预训练推理在搭配轻量动作接口时可以替代任务特定演示训练。
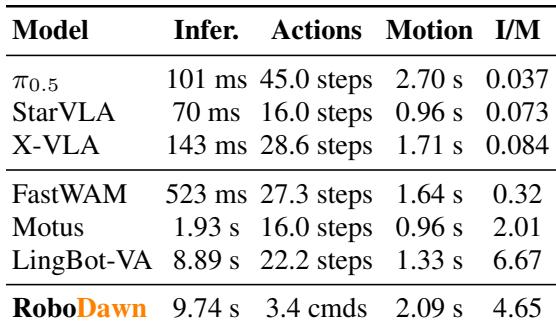
RoboDawn 在对比中推理延迟最高,但每个 episode 发出的动作远少于 VLA 基线,同时运动执行时间保持可比。π0.5、StarVLA、X-VLA 和 FastWAM 等策略保持低于 0.5 的推理运动比,表明推理与运动有可能重叠。RoboDawn 和 LingBot-VA 的该比值远高于阈值,反映不同的效率权衡。RoboDawn 的推理延迟长于所有对比策略,但每个 episode 只产生少量高层指令,而不是大量低层步骤。其运动执行时间与若干基线相似,因此额外延迟主要来自模型推理而非物理执行。若干被评估策略的推理运动比低于 0.5,表明其推理可以与机器人运动重叠以实现流式执行。RoboDawn 和 LingBot-VA 远超 0.5 的推理运动阈值,表明推理与运动重叠有限。
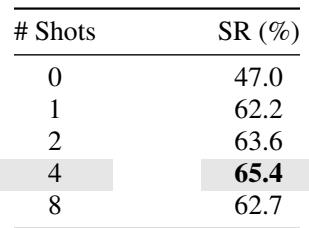
RoboDawn 在 RoboTwin 2.0 上的消融实验显示,提供少量上下文演示可提高任务成功率,其中从 zero-shot 到 one-shot 的提升最大。超过一个演示后的进一步增加收益递减,而在八个演示时性能略有下降,表明较长的上下文可能产生干扰。VLM 的选择对成功率也有很强影响。使用 Gemini-3.8-Flash 模型时,成功率从 zero-shot 的 47.0% 上升到 one-shot 的 62.2%,然后在四个演示时达到 65.4%,随后在八个演示时下降到 62.7%。在 one-shot 设置下,成功率因 VLM 强弱而有很大差异,从较弱 VLM 的 14.4% 提升到较强 VLM 的 43.2%。
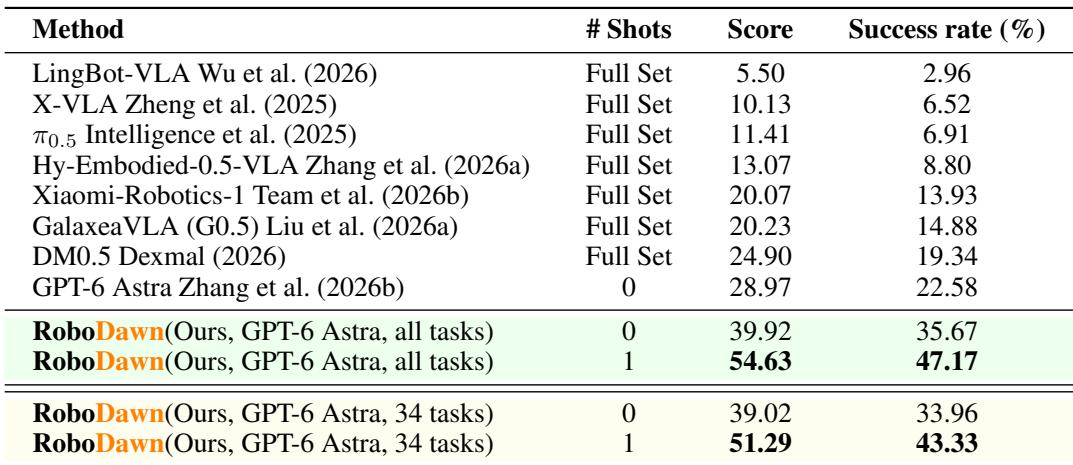
在 RoboDojo 上,RoboDawn 在无任务特定后训练的情况下取得比完整集后训练基线更高的任务成功率。其成功率在 zero-shot 下达到 35.67%,在单次演示下达到 47.17%,而所列最佳的完整集方法为 19.34%。RoboDawn 还表现出持续的测试时扩展性,随着指令预算增加而提升。RoboDawn 的 zero-shot 和 one-shot 成功率超过所有已报告的完整集后训练基线。单次演示相比 RoboDawn 的 zero-shot 性能带来大幅提升。增加测试时指令预算可提高 RoboDawn 在 zero-shot 和 one-shot 设置下的成功率。
使用 Gemini 3.8 Flash 的 RoboDawn 在真实机器人上对三项操作任务进行了 zero-shot 评估。它在方块入篮任务上表现最佳,在方块堆叠上表现中等,在布料折叠上未成功。论文将方块堆叠性能较低归因于精度和空间对齐要求,将布料折叠的困难归因于大量末端执行器旋转和朝向调整。方块入篮取得最高的真实世界成功率,其次为方块堆叠。布料折叠没有成功试验,且由于频繁的末端执行器旋转和朝向调整被认为难度大得多。

论文在 RoboTwin 2.0 C2R 和 RoboDojo 仿真以及真实机器人上对 RoboDawn 进行评估。结果表明,zero-shot 和 one-shot 的 VLM 控制可以在无任务特定参数更新的情况下超过完整集后训练机器人策略,单次上下文演示带来最大增益,而更多示例收益递减。效率测试表明,与 VLA 基线相比,其推理延迟更长,但每个 episode 的高层动作少得多,推理与运动重叠有限。真实机器人结果在方块入篮上最强,在方块堆叠上中等,在布料折叠上因精度和朝向要求而未成功。