Command Palette
Search for a command to run...
REWARDVERSE:面向视频奖励建模的评分准则引导策略优化
REWARDVERSE:面向视频奖励建模的评分准则引导策略优化
Zhenchen Tang Yang Li Songlin Yang Bo Peng Xiaotong Zhao Shuai Li Haotian Fan Alan Zhao Jing Dong
摘要
强化学习(RL)对于优化视频生成模型至关重要,而稳健的奖励模型(RM)是其中的基石。然而,现有的视频奖励模型往往会生成不稳定的标量分数,因为它们在没有明确评估准则的情况下,将复杂且主观的视频质量直接映射为单一分数。这会导致标量漂移,即评分尺度在不同提示词之间塌缩或偏移,从而使奖励对 RL 而言不可靠。受专业人工标注工程的启发,我们提出了 RewardVerse 来解决该问题。RewardVerse 是一个基于评分准则的视频奖励框架,它在评估查询与评分器之间引入动态评分准则作为中间表示。RewardVerse 不再进行无约束的直接评分,而是先生成明确的评估准则,再进行评分准则引导的评分,从而提供稳定的语义锚点以缓解标量漂移。为了高效地优化这一协作流程,我们提出了一种两阶段训练算法——评分准则引导策略优化(RGPO)。RGPO 首先利用自演化的种子评分准则对评分器进行预热,然后联合优化评分准则生成器,使其生成查询自适应的评估准则,同时持续将评分器与人类评分对齐。在 16 维 EvalVerse 基准和外部数据集上的大量实验表明,RewardVerse 缓解了标量漂移,在逐点评估和成对评估上均取得了当前最优性能,并为视频生成中的 RL 提供了稳健且可解释的奖励信号。
一句话总结
来自中国科学院、香港科技大学和腾讯的研究人员提出了 RewardVerse,一个评分量规引导的视频奖励框架。该框架在评分前生成动态的查询自适应评分量规,并采用两阶段的 Rubric-Guided Policy Optimization (RGPO) 来缓解标量漂移,在视频生成强化学习中取得了最先进的逐点评估和成对评估结果。
核心贡献
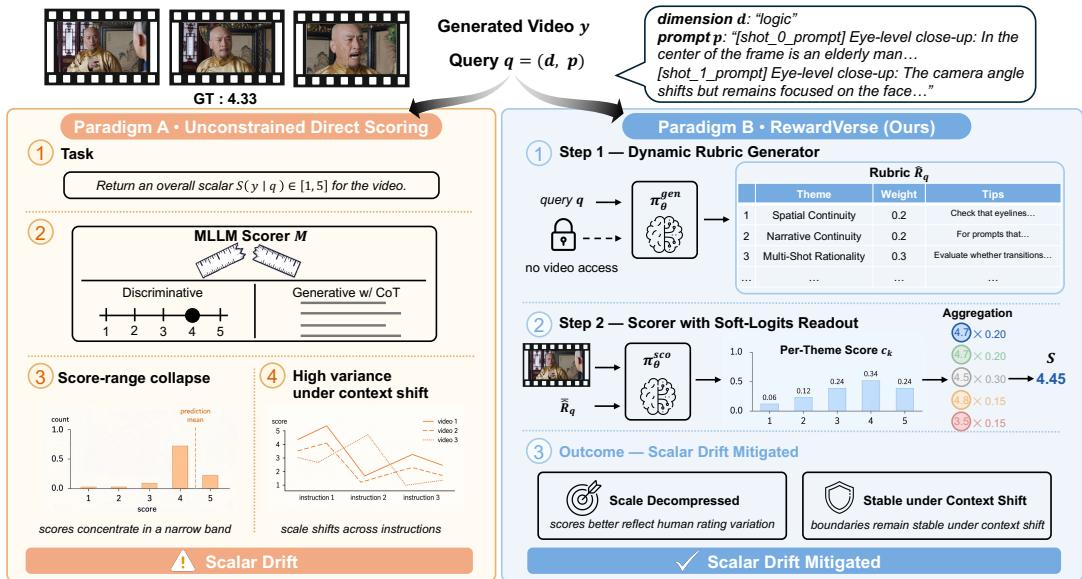
- RewardVerse 是一个基于评分量规的视频奖励框架,将动态评分量规作为评估查询和评分器之间的中间表示。它首先生成明确的评估准则,然后进行评分量规引导评分,从而提供稳定的语义锚点以缓解标量漂移。
- Rubric-Guided Policy Optimization (RGPO) 是一种两阶段训练算法。它首先利用自我演化的种子评分量规预热评分器,然后联合优化评分量规生成器,使其生成查询自适应准则,同时持续将评分器与人类评分对齐。
- 在 16 维 EvalVerse 基准和外部数据集上的实验表明,RewardVerse 能缓解标量漂移,并取得最先进的逐点和成对评估性能。RewardVerse 在 EvalVerse 上获得高逐点相关性,在 VGRB 上获得强成对一致性,并改善下游视频生成,同时对 reward hacking 更加稳健。
引言
生成式视频模型在强化学习过程中依赖奖励模型将输出与人类偏好对齐,但现有视频奖励模型通常直接将视频映射为单一标量分数。由于视频质量具有主观性和多维性,这种无约束评分往往产生标量漂移,即分数坍缩到较窄范围或在不同提示和上下文中发生偏移。先前方法在评分前缺少明确的评估准则,导致其奖励信号对下游 RL 不稳定。作者提出 RewardVerse,这是一个视频评估框架,将动态评分量规作为中间表示插入,解耦准则生成和评分,从而稳定逐点和成对奖励。作者还引入 Rubric-Guided Policy Optimization,一种两阶段训练算法,联合学习查询自适应评分量规并仅使用每个维度 30 个偏好对来对齐评分器,无需监督微调。
方法
作者将评分量规重新定义为可学习的中间表示,而不是固定的提示脚手架。目标是生成查询自适应的评估准则,同时保持评分器与人类评分对齐。RewardVerse 通过一个双角色策略模型 πθ 实现这一点,该模型同时充当动态评分量规生成器和评分器。训练过程 Rubric-Guided Policy Optimization (RGPO) 包括两个阶段:使用自我演化的种子评分量规进行评分器预热,随后对生成器和评分器进行联合优化。
评估查询定义为 q=(d,p),其中 d∈D 是目标评估维度,p 是用于合成候选视频的提示。每个视频在训练和推理期间独立评分。
动态评分量规生成器从查询中采样结构化评分量规:
R^q∼πθgen(⋅∣q),R^q={(tk,wk,Tk)}k=1K,其中 tk 是主题,wk∈(0,1) 是归一化权重,Tk 是一组执行建议。重要的是,生成器只看到查询而不会观察到候选视频。这种候选无关的设计可防止生成器产生有偏的评分量规,从而避免对弱视频过于宽松或对强视频过于严格。
评分器使用软 logits 读取方式,而不是解析离散数字。对于每个主题,模型读取五个评分 token 的 logits,并计算期望评分:
ck(y∣R)=v=1∑5v⋅Pθ(v∣y,tk,Tk),其中
Pθ(v∣y,tk,Tk)=∑v′=15exp(lv′)exp(lv).逐点奖励按评分量规权重聚合主题分数:
S(y∣R)=k=1∑Kwk⋅ck(y∣R).生成器和评分器共享同一个骨干网络,并通过角色特定的提示进行区分。
在阶段 1 中,作者使用种子评分量规预热评分器。对于每个维度 d,前沿 MLLM 通过离线自我演化循环构建初始种子评分量规 Rd⋆。给定偏好三元组,MLLM 提出一个评分量规来解释为什么 yw≻yl,验证该评分量规在用于评分时是否能恢复该偏好,并在失败时修改评分量规。经过验证的评分量规被汇总,使用两级 Jaccard 过滤器去重,并通过 MCR2 采样器缩减为五个代表性评分量规。
在每个种子评分量规下,评分器为偏好视频和非偏好视频采样 G 个补全对。偏好奖励为:
rpref(aw,g,al,g)=σ(Sg(yw∣Rd⋆)−Sg(yl∣Rd⋆)).完整预热奖励添加了格式奖励,用于检查补全是否遵循请求的评分格式。联合奖励在组内进行标准化以产生轨迹级优势,评分器使用裁剪后的 GRPO 目标加上相对于冻结参考策略的 KL 惩罚进行优化。
由于仅靠偏好奖励无法控制分数差异的大小,作者添加了与人类对齐的边际校准损失:
Lcal(θ∣R)=Smax−Smin1(S(yw∣R)−S(yl∣R))−Δs^w,l.该损失根据人类标注的边际来校准预测分数差距。阶段 1 目标将 GRPO 损失与该校准项结合:
Lstage1(θ)=LGRPO(1)(θ)+λcalLcal(θ∣Rd⋆).在阶段 2 中,生成器学习为每个查询生成定制的动态评分量规。对于每个偏好三元组,它从 πθoldgen(⋅∣q) 中采样 G 个评分量规 {R^g}g=1G。每个评分量规根据其诱导的逐点分数区分偏好视频和非偏好视频的程度来评分:
rpref(R^g)=σ(Sg(yw∣R^g)−Sg(yl∣R^g)).阶段 2 奖励还包含格式奖励和对齐奖励:
R2(R^g)=rpref(R^g)+βrfmt(R^g)+λralign(R^g).对齐奖励衡量生成主题和种子主题的 BGE-M3 嵌入之间的余弦相似度。复合奖励在组内标准化,并广播到生成的评分量规中的所有 token。然后使用裁剪后的 GRPO 目标更新生成器。
两个角色的优化信号是不对称的。生成器从 R2 获得评分量规级策略梯度,而评分器不会从该奖励获得直接的策略梯度更新。相反,评分器仅通过边际校准损失进行优化,将每个生成的评分量规视为固定文本上下文:
Lscorer(θ)=G1g=1∑GLcal(θ∣R^g).阶段 2 的完整目标为:
Lstage2(θ)=LGRPO(2)(θ)+α(t)Lscorer(θ),其中 α(t) 是调度系数,在生成器初始预热后激活评分器校准。这种联合形式使生成器能够生成具有不同权重和针对提示的执行建议的查询自适应评分量规,同时评分器保持与人类评分边际的校准。
实验
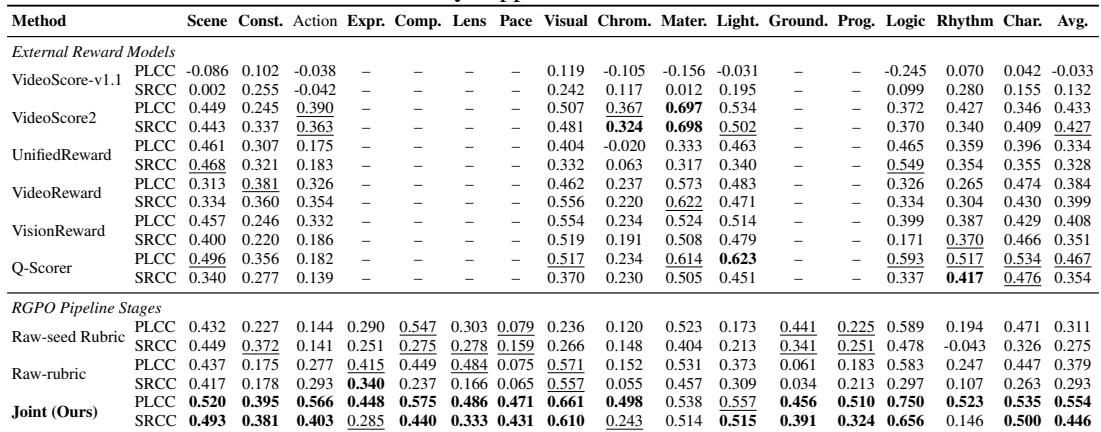
分析研究表明,无约束的 MLLM 视频评分会因分数坍缩和上下文敏感性而出现标量漂移,而评分量规引导能够锚定评分尺度,软 logits 解码进一步缓解分数压缩,但仅靠静态评分量规仍不足。在 EvalVerse 和 VGRB 上的评估验证,联合优化评分量规生成和评分可提高逐点人类相关性,并能迁移到成对排序,包括未见维度。消融实验证实了在低数据预算下评分量规中介训练、评分器预热和动态评分量规自适应的重要性;下游 RL 实验表明,RewardVerse 改善了目标视觉质量,同时保留其他视频能力。
RewardVerse (Joint) 在 EvalVerse 各维度上的逐点评估中领先,在 16 个维度中的 14 个上取得了最高的 PLCC,并在 Logic 和 Action 等具有挑战性的认知与时间轴上最明显地优于先前的奖励模型。外部视频评分器在这些细粒度维度上通常校准较差,包括在 Logic 上出现负对齐。Q-Scorer 在一些非质量维度上仍具有竞争力,表明这些维度与低层视觉质量存在部分重叠。RewardVerse (Joint) 取得了最强的整体性能,在 16 个 EvalVerse 维度中的 14 个上获得了最高的 PLCC。与次优模型相比,它在 Logic 和 Action 等认知与时间任务上显示出特别大的提升。外部视频评分器在细粒度维度上可能校准不佳,VideoScore-v1.1 在 Logic 上表现出负对齐。Q-Scorer 在 Lighting 和 Logic 等非质量维度上仍具有竞争力,表明这些轴与低层视觉质量部分相关。
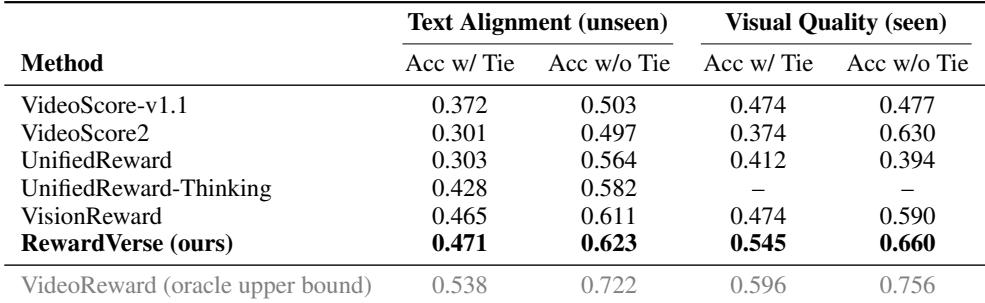
RewardVerse 在未见的文本对齐和已见的视觉质量两个划分上,均在非 oracle 方法中取得了最高的成对一致性。它在使用有限训练预算的情况下,以较大幅度超过视觉质量上最强的非 oracle 基线。结果表明,减少逐点评分中的标量漂移也有助于改善成对偏好对齐,包括在未见评估维度上。RewardVerse 在未见的文本对齐和已见的视觉质量划分上均位居非 oracle 方法首位。尽管训练偏好对有限,RewardVerse 仍优于最强的非 oracle 基线,并大幅缩小了与 oracle 上限的差距。在未见的文本对齐划分上,RewardVerse 展现出比所有非 oracle 基线更强的零样本泛化能力。
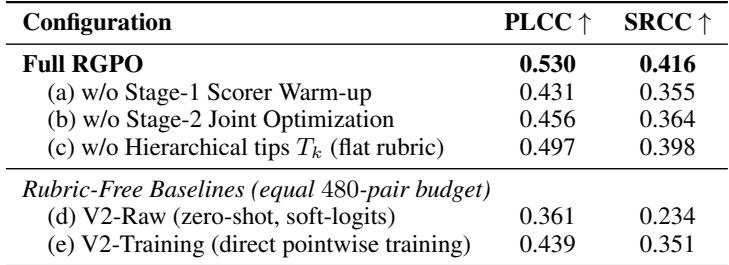
在 EvalVerse 上,完整 RGPO 配置在所有测试设置中取得了最高的宏平均 PLCC 和 SRCC。省略阶段 1 评分器预热会在模型消融中造成最大的性能下降,而跳过阶段 2 联合优化或使用扁平评分量规也会降低对齐度。无评分量规训练仅比零样本略有提升,仍低于评分量规引导的完整模型;在下游,RewardVerse 改善目标视觉质量,同时比 VideoReward 更好地保留文本和质量能力。完整 RGPO 配置在 PLCC 和 SRCC 上均优于所有消融模型和无评分量规基线。移除阶段 1 评分器预热会在消融实验中造成最大的相关性下降,突出其在分数校准中的作用。跳过阶段 2 联合优化或将分层执行建议替换为扁平评分量规,会降低相对完整模型的对齐度。直接无评分量规训练仅比零样本略有提升,仍远低于完整评分量规引导模型。RewardVerse 改善下游生成中的视觉质量,同时比 VideoReward 更好地保留文本和质量能力。
RewardVerse (Joint) 在细粒度 EvalVerse 维度、成对偏好对齐和消融设置上进行了评估,并始终在非 oracle 模型中提供最强的逐点和成对一致性。实验表明,其优势在具有挑战性的认知和时间维度上尤为明显,而外部评分器可能校准不佳,且一些非质量轴与低层视觉质量部分重叠。消融实验证实,评分器预热、联合优化和分层评分量规均有助于对齐,而无评分量规训练仍较弱;此外,RewardVerse 改善下游视觉质量,同时比先前的奖励模型更好地保留文本和质量能力。