Command Palette
Search for a command to run...
CodeMidas:从代码本身扩展智能体编程强化学习环境
CodeMidas:从代码本身扩展智能体编程强化学习环境
摘要
通过强化学习(RL)训练有能力的编程智能体,需要多样化的任务和可靠的验证器。开源代码库为这类任务提供了丰富的来源,但现有方法通常依赖 issue 和 commit 等开发产物,限制了可提取任务的范围。为了更好地扩展 RL 环境,我们提出了 CodeMidas,这是一个智能体流水线,仅以源代码作为任务特定输入,将现有代码库中已实现的功能转化为可执行的 RL 环境。CodeMidas 在环境构建的每个阶段都投入智能体计算:智能体探索已实现的功能以形成行为规范,基于原始代码的执行来构建测试,并通过执行检查和重复求解 rollout 来验证和筛选候选任务。最终得到的数据集包含 5,545 个训练任务,来自 3,185 个开源代码库,涵盖 23 种编程语言和 15 个技术领域。在这些任务上使用 GRPO 训练 MiMo-V2.5,在全部五个多样化基准上均提升了性能,涵盖 issue 修复(DeepSWE +11.7%)、整程序构建(ProgramBench +17%)和终端工作(Terminal-Bench v2.1 +8.5%)。消融实验表明,增加高质量训练任务的数量能够提升性能。轨迹分析显示,经 RL 训练的智能体表现出更好的行为,例如增加了对代码库的探索,并进行了更多样化的自我验证。这些结果表明,源代码可以作为构建 RL 环境的一个可扩展基础,从而在不同软件任务上改进编程智能体。
一句话总结
CodeMidas,由来自 LLM Core、小米、北京大学等机构的研究人员提出,是一种 agentic 流水线,它仅以源代码作为任务特定输入,将现有代码库中已实现的功能转化为可执行的强化学习环境,并将 agentic 计算分配给行为规范制定、基于执行的测试构建以及通过执行检查和重复解题展开进行的验证;在由 3,185 个开源代码库、覆盖 23 种编程语言和 15 个技术领域的 5,545 个任务上使用 GRPO 训练 MiMo-V2.5 后,其在所有五个多样化基准上的表现均得到提升,包括 issue 修复(DeepSWE +11.7%)、整程序构建(ProgramBench +17%)和终端工作(Terminal-Bench v2.1 +8.5%);消融实验表明,增加高质量训练任务数量可提升性能,轨迹分析显示代码库探索增多、自我验证更加多样。
核心贡献
- CodeMidas 是一种 agentic 流水线,它仅以源代码作为任务特定输入,将现有代码库中已实现的功能转化为可执行的强化学习环境。它将 agentic 计算分配给探索已实现功能、制定行为规范、构建基于执行的测试,以及通过执行检查和重复解题展开来过滤候选任务。
- 得到的数据集包含 5,545 个训练任务,来自 3,185 个开源代码库,覆盖 23 种编程语言和 15 个技术领域。
- 在这些任务上使用 GRPO 训练 MiMo-V2.5,可提升所有五个多样化基准上的表现,覆盖 issue 修复(DeepSWE +11.7%)、整程序构建(ProgramBench +17%)和终端工作(Terminal-Bench v2.1 +8.5%)。消融实验显示,增加高质量训练任务可提升性能,轨迹分析显示代码库探索增多、自我验证更加多样。
引言
大语言模型越来越具备 agentic 编码能力,但面向软件工程的强化学习依赖多样化任务和可靠的、基于执行的奖励。早期流水线从 issue、pull request、提交、现有测试或文档构建环境,这使得训练覆盖范围受限于这些开发产物,并限制了可扩展性。作者提出了 CodeMidas,一种 agentic 流水线,它仅以源代码作为任务特定输入:它识别已实现的功能,制定行为任务说明,将代码库适配为开发起始点,并基于原始代码执行合成测试,同时进行一致性检查和展开后过滤。利用 CodeMidas,作者从 3,185 个开源代码库中构建了 5,545 个可验证任务,覆盖 23 种语言和 15 个领域。在这些任务上训练 MiMo-V2.5,可提升外部基准表现,包括将 DeepSWE 通过率从 10.0% 提高到 21.7%,将 Terminal-Bench v2.1 通过率从 63.7% 提高到 72.2%,表明已实现的功能可以转化为跨多种软件任务的有效 RL 训练信号。
数据集
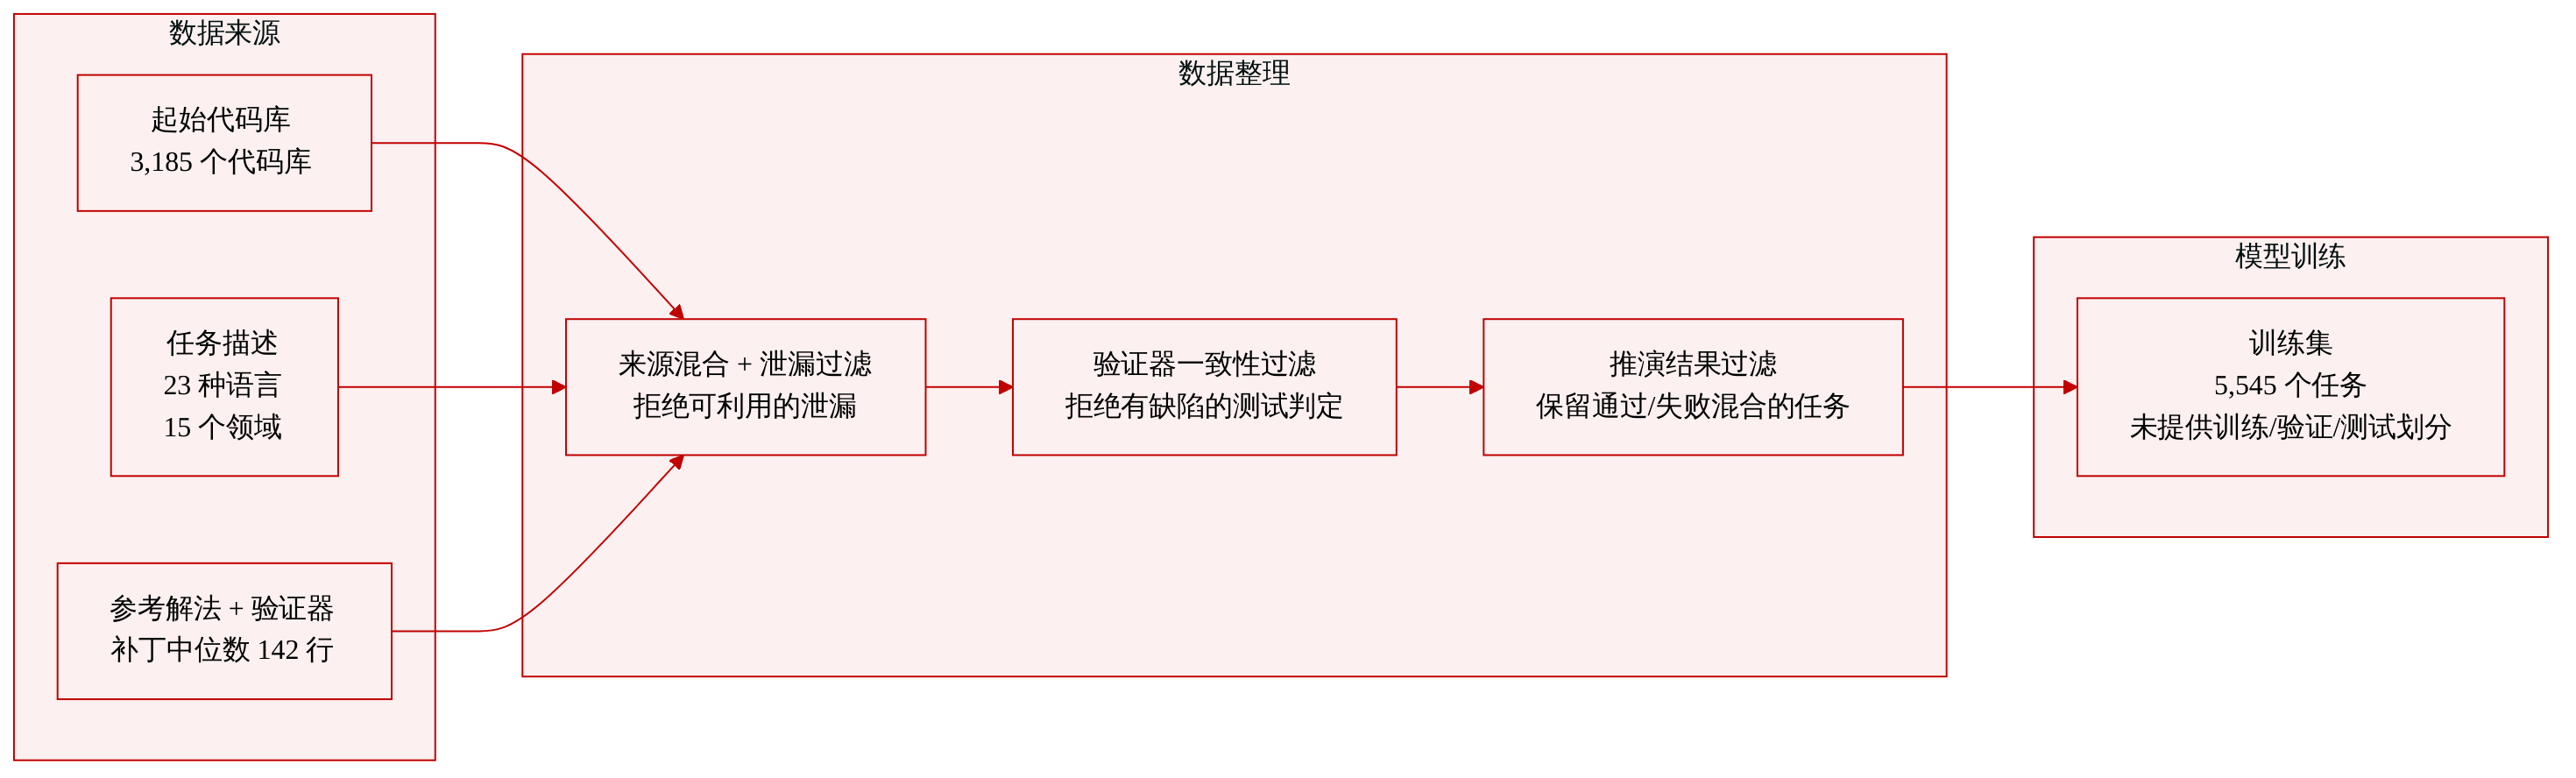
数据集构成与规模
- 作者围绕求解器可见的环境组织任务,这些环境包括起始代码库、任务说明、参考解和验证器。
- 经过过滤后,最终数据集包含 5,545 个任务,来自 3,185 个代码库,覆盖 23 种编程语言和 15 个技术领域。
- 占比最高的语言为 Python(21.4%)、TypeScript(18.3%)、Go(16.2%)、C++(12.5%)和 JavaScript(11.3%)。
- 最大的技术领域是系统软件(17.4%)、网络技术(14.6%)和开发者工具(13.6%),三者合计占任务的 45.6%。
- 参考解的规模按新增或删除的源代码行衡量,包括注释和空行。中位数为 142 行,四分位距为 66 到 305 行。
- 在 65.9% 的任务中,参考补丁涉及至少两个源文件。
展开后过滤细节
- 泄露过滤:一个对抗式 agent 搜索求解器可见的完整环境,包括编译产物、缓存、构建 agent 留下的文件以及目标项目的已安装副本。它记录命令和输出。另有一个审查环节会拒绝那些泄露材料能够绕过预期实现工作的任务。
- 验证器一致性过滤:一个编码 agent 对每个任务尝试四次。审查 agent 检查展开轨迹、提交的代码、测试输出、任务说明、验证器和参考解。它会标记假阳性(错误实现通过测试)和假阴性(正确实现未通过测试)。存在验证器缺陷的任务会被拒绝。
- 展开结果过滤:一个前沿模型对每个任务进行多次尝试,并由验证器评分。作者只保留在该模型和预算下同时存在成功尝试和失败尝试的任务。全部通过或全部失败的任务被排除。
数据如何使用
- 过滤在 RL 训练之前进行,因此保留的 5,545 个任务构成训练集。
- 验证器、参考解、任务说明和起始代码库用于环境构建、过滤和 agent 尝试评分。
- 所提供的文本报告了完整训练集上的语言、领域和参考解统计信息。
- 所提供的章节未指定训练集划分比例、混合比例或裁剪策略。
方法
作者利用源代码作为唯一的任务特定输入,来构建和过滤编码强化学习环境。如下图所示,整体框架概述了一个多阶段流水线,包括任务设计、测试构建、执行一致性检查和展开后过滤。
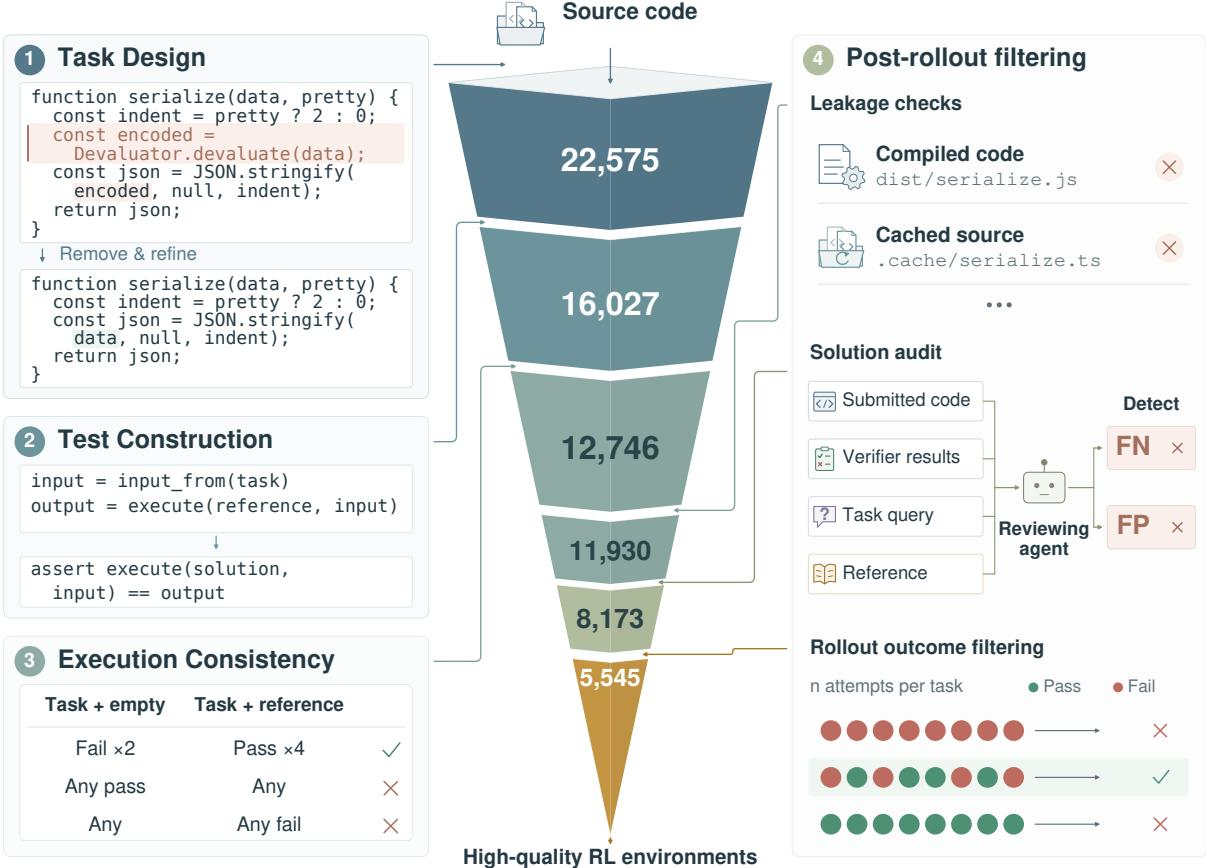
任务设计与代码库适配
该过程首先由一个 agent 检查代码库结构和构建元数据,以识别具有公共入口点和可观察结果的功能。作者优先选择需要跨代码库推理的任务,支持命令行工具、纯库函数和有状态库 API 等接口。对于每个候选项,agent 追踪公共入口点和共享依赖,以确定任务范围。随后移除选定的核心实现,并调整其余代码以形成连贯的起始点。任务说明和代码边界会一起修订,同时保留共享组件;原始实现则单独保留为参考解。
基于执行的测试构建
为了评估实现,agent 将任务说明中的行为要求映射到测试输入和边界情况。它在代码库的参考副本中调用公共入口点并记录结果。测试根据接口类型定制:对 CLI 工具使用命令执行,对纯函数使用输入输出用例,对有状态 API 使用调用序列。对于固定输出,基于参考执行建立断言;对于未指定的方面,只依据已说明的约束进行检查。随后,审查 agent 会审计每个断言,去除无依据的限制,并替换为行为检查。依赖私有符号且没有行为替代方案的任务会被拒绝。
环境准备与执行一致性
从统一的基础容器镜像开始,agent 安装依赖并准备构建和运行时资源。清理流程会移除可能暴露已删除实现的产物,例如编译输出和缓存副本。为确保执行一致性,每个任务在六个全新容器中进行评估:两个使用起始代码库,四个使用参考解。流水线要求两个起始状态运行均失败、四个参考运行均通过,以验证预期的从失败到通过的转变,并筛查不稳定的执行结果。
展开后环境过滤
在 RL 训练之前,作者利用 agent 展开进行进一步过滤,以识别可利用的泄露、验证器不一致以及全部通过或全部失败的任务。
泄露过滤涉及一个对抗式 agent,在求解器可见的环境中搜索残留泄露,例如编译产物或缓存文件,以在不执行预期开发工作的情况下恢复解法。确认存在绕过实现的泄露材料的任务会被拒绝。
为验证 agent 解法的一致性,编码 agent 会多次尝试每个任务。审查 agent 会检查展开轨迹、提交的代码和测试输出,并结合任务说明和参考解来检测不匹配。它标记错误实现通过测试的假阳性,以及正确实现未通过测试的假阴性,拒绝存在验证器缺陷的任务。
展开结果过滤使用前沿模型对每个任务进行多次尝试。作者只保留在该模型下同时出现成功和失败尝试的任务,丢弃全部通过或全部失败的任务,因为其可能表明测试较弱或需求缺失。
实验
评估使用 GRPO 在 5,545 个 CodeMidas 任务上训练 MiMo-V2.5,并在五个外部基准以及一个留存的 CodeMidas 验证集上测试性能。强化学习在所有外部基准上都改善了结果,支持将源自代码的功能任务用于多样化的软件工作。消融实验显示,更大的精选数据池能改善结果,且高质量的 5k 集合优于更大的未过滤 8k 样本,凸显了环境可靠性和过滤的价值。行为分析发现,训练增加了代码库探索、代码草拟和自我验证;自我验证与更高通过率相关,且这些行为变化在不同基准间具有泛化性。
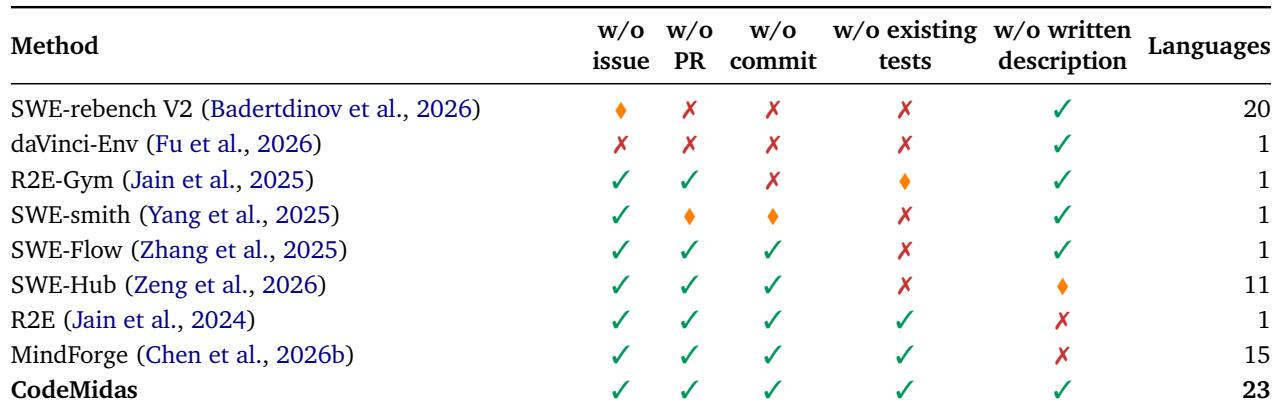
代表性编码环境流水线的主要差异在于对现有测试和开发历史的依赖。大多数流水线要求现有测试,而较新的方法更可能放宽 issue 和 pull request 要求,书面描述通常为可选。语言支持不均衡,大多数流水线只处理一种语言,只有少数处理多种语言。几乎所有列出的流水线都要求现有测试;只有一个被显示为完全无测试,另一个为部分无测试。只有一部分流水线要求 issue 和 pull request 输入,若干较新的流水线可以在没有它们的情况下工作。提交历史仍然是常见的输入要求,但也有少数流水线可以避免。对大多数流水线而言,书面描述是可选的,其作为约束不如测试或开发历史常见。语言覆盖较为集中:大多数流水线支持单一语言,而广泛的多语言覆盖仅限于少数系统。CodeMidas 被描述为仅使用源代码作为任务特定输入,从开发记录、文档和现有测试覆盖范围之外推导行为说明和基于执行的测试。
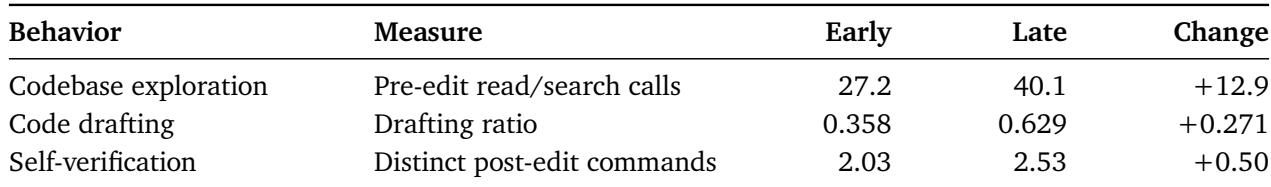
强化学习带来了明显的行为变化:agent 在编辑前更多地探索代码库,提高了编辑代码中已在先前推理中出现的比例,并发出更多样的自我验证命令。草拟的相对增益最大,而验证多样性的增加较为温和。这些变化表明探索更加审慎,推理与代码编辑之间的一致性更强。首次编辑前的代码库探索从训练早期到后期有所增加,反映出更多的编辑前调查。草拟比例大幅提高,表明所编写代码更常出现在先前的推理中。编辑后不同的自我验证命令有所增加,显示编辑后的验证行为更加广泛。带自我验证的展开平均通过率高于不带自我验证的展开,而探索和草拟分组的通过率差异较小且更不确定。
从早期检查点到后期检查点,所有被评估的留存基准上的代码库探索都有所增加。在可测量的地方,代码草拟比例上升,自我验证多样性增加,但随基准不同而变化。交互长度在 issue 修复和终端任务中增加,但在整程序构建中缩短;后者的更大探索伴随着更短的交互。代码库探索在 SWE-bench Pro、ProgramBench 和 Terminal-Bench v2.1 上均增加。代码草拟比例在 SWE-bench Pro 和 ProgramBench 上增加;Terminal-Bench v2.1 未报告该比例。自我验证多样性在各基准上均上升,幅度因评估而异。交互长度在 SWE-bench Pro 和 Terminal-Bench v2.1 上增加,但在 ProgramBench 上减少。
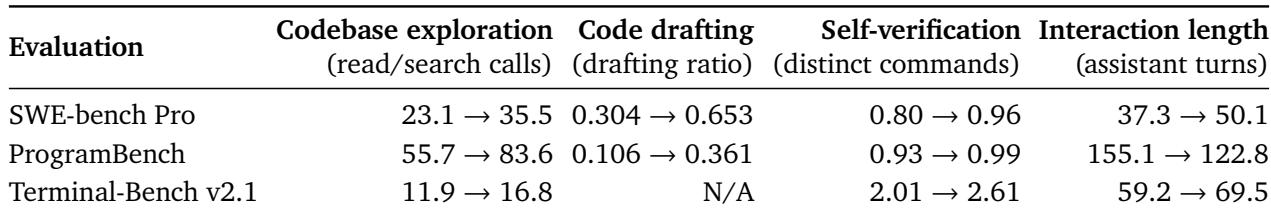
实验比较了代表性编码环境流水线,并考察强化学习如何改变 agent 行为。流水线分析表明,大多数系统仍依赖现有测试和开发历史,而较新的方法放宽了 issue 和 pull request 要求;书面描述通常为可选,多语言支持有限,而 CodeMidas 仅使用源代码推导行为说明和基于执行的测试。强化学习带来了更审慎的代码库探索、更强的推理与编辑一致性以及更多样的自我验证命令,且自我验证与更高通过率相关。在留存基准上,这些行为变化从早期检查点持续到后期检查点,不过交互长度在 issue 修复和终端任务中增加,但在整程序构建中减少。