Command Palette
Search for a command to run...
RECREATIONWORLD:面向混合计算机使用智能体的可扩展、可验证环境
RECREATIONWORLD:面向混合计算机使用智能体的可扩展、可验证环境
摘要
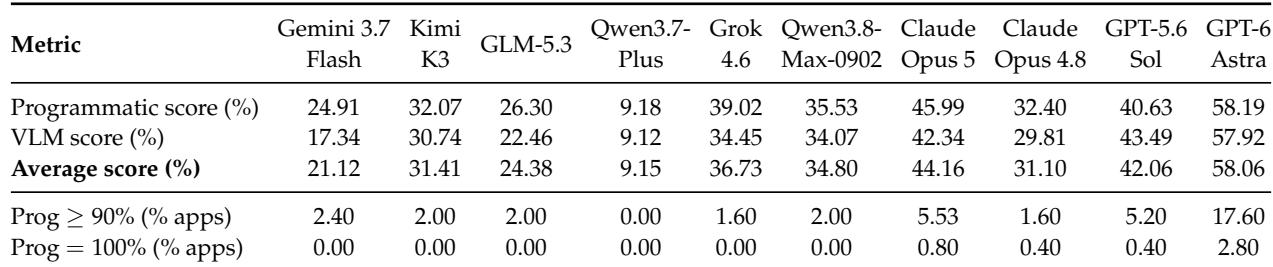
计算机使用智能体(CUA)沿着两条大体相互独立的路线发展——通过图形界面操作应用程序,以及通过代码和命令行构建软件——但彼此都看不到对方最擅长的事情:GUI 智能体无法构建界面背后的软件,而终端智能体无法看到自身操作所产生的界面。真实的数字工作需要同时具备这两种能力,并且需要交错执行,而不是端到端地顺序堆叠。我们研究将两者融合的混合 CUA:能够自主决定何时探索界面、何时实现、以及何时运行并可视化验证自身制品的智能体。构建这种能力需要既能在受控条件下对其进行评估、又能大规模生成经过验证经验的环境。我们提出了 RECREATION-WORLD,一个围绕“再创造”构建的五平台框架:给定一个正在运行的参考实现,智能体必须在没有规定工作流的情况下发现其行为,并构建一个忠实的实现。在该框架中,再创造以最纯粹的形式实例化了混合循环,并提供了客观的、以实际执行为依据的奖励,因为运行中的参考实现充当了一个预言机,可以从中导出隐藏的行为测试。为了在多个平台上执行这一循环,RECREATIONWORLD 提供了 Ubuntu、macOS、Windows、Android 和 Web 上的可复现环境,以及一个具备原生 GUI 控制和编码工具的统一执行框架。我们进一步利用高质量的开源应用程序扩大规模,用它们生成用于训练的长程再创造轨迹。在这些轨迹上训练的模型在五个分布外基准上取得提升,这些基准涵盖编码和混合计算机使用;它们还更频繁地验证自己渲染的输出——这表明再创造构建的混合智能体能力能够迁移到再创造之外,并支持自我改进。为了进行留出评估,我们提出了 RECREATIONBENCH,它包含 250 个覆盖不同领域和平台的多样化任务。在评估层面,基于参考实现的测试生成将可执行行为转换为与具体实现无关的监督信号;程序化和视觉断言覆盖多个交互深度下以动作为条件的结果,并且每条断言都在参考实现上及由人工评审者验证后,测试套件才被冻结用于自动评分。在 RECREATIONBENCH 上,GPT-6 Astra 以 58.1% 的总体得分领先,但仅在 2.8% 的任务上通过全部程序化测试。我们的分析表明,智能体复现静态界面结构比复现交互和计算输出更可靠,而生成的应用程序在规模上仍远小于参考实现,并且更加单体化。我们发布了基准、环境和测试套件。
一句话总结
来自阿里巴巴 Token Hub、阿里巴巴集团的研究人员提出了 RECREATIONWORLD,一个面向混合计算机使用 agent 的五平台框架,通过构建运行中参考应用的忠实实现,并在 Ubuntu、macOS、Windows、Android 和 Web 上提供基于执行的奖励,使 GUI 探索、编程和视觉验证交替进行;在其 RECREATIONBENCH 上,GPT-6 Astra 总体达到 58.1%。
核心贡献
- 论文提出 RECREATION-WORLD,一个面向混合计算机使用 agent 的五平台框架,在没有预设工作流的情况下重建运行中的参考应用,同时交错进行 GUI 探索、实现、执行和验证。它提供 Ubuntu、macOS、Windows、Android 和 Web 上的可复现环境,以及用于原生 GUI 控制和编程工具的统一测试框架。
- 论文贡献了 RECREATIONBENCH,一个跨这些平台的 250 个任务的留出基准,具有基于参考的程序化和视觉断言,将可执行行为转换为与实现无关的监督。测试套件在冻结用于自动评分之前,经过参考验证和人工审核,并发布了基准、环境和测试套件。
- 实验表明,基于从开源应用生成的长期重建轨迹进行训练,可将五个分布外编程和混合计算机使用基准的性能提升最多 17.9 个百分点,并提高对渲染输出的自我验证。在 RECREATIONBENCH 上,GPT-6 Astra 总体达到 58.1%,但仅在 2.8% 的任务中通过所有程序化测试,静态界面结构比交互和计算结果被更可靠地复现。
引言
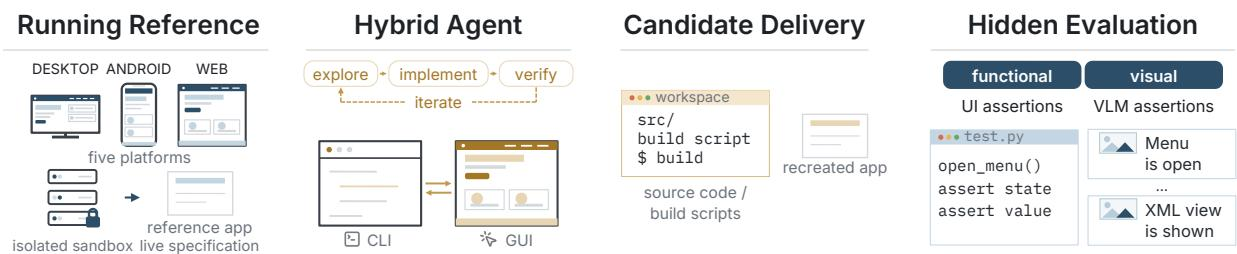
通用计算机使用 agent 大体上分为仅 GUI 的 agent(感知屏幕并发出点击)和基于终端的 agent(编写代码并调用工具)。每种方法都缺少另一种的优势,但许多软件密集型任务需要反复交错进行界面探索、实现、执行和视觉验证。现有基准往往强调一种交互模式,因此低估了 agent 协调这种混合循环的长期能力。作者提出了 RECREATIONWORLD 和 RECREATIONBENCH,这是一个多平台框架,其中 agent 必须发现运行参考应用的行为并构建忠实实现。基于参考的程序化和视觉测试提供基于执行的评分,选定的重建轨迹用于训练,并报告了在分布外编程和混合计算机使用基准上的迁移提升。
数据集
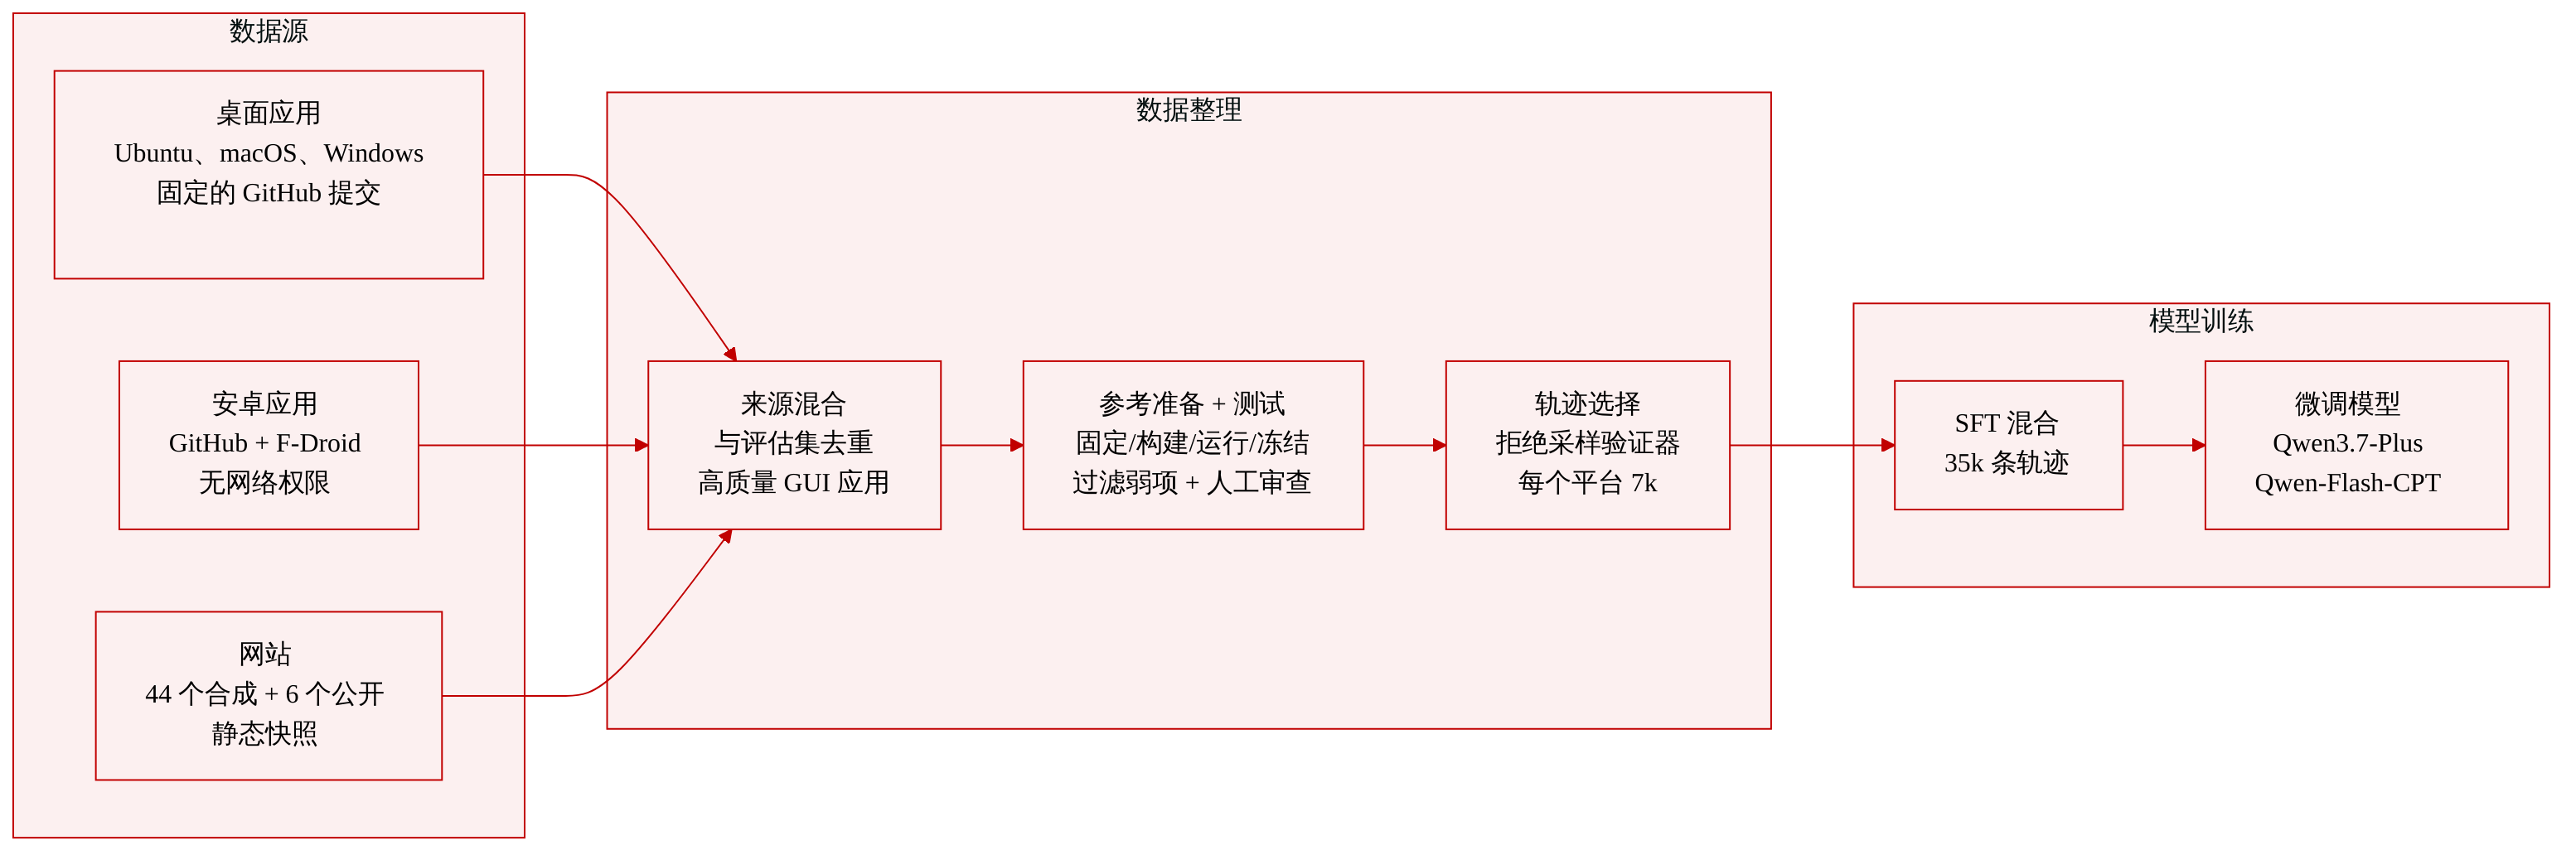
作者使用两种数据资源:用于评估的 RECREATIONBENCH,以及用于监督微调的 35,000 条轨迹重建混合数据集。
来源与组成
- RECREATIONBENCH 包含 250 个任务,五个平台各有 50 个应用或网站:Ubuntu、macOS、Windows、Android 和 Web。
- 候选来自开源桌面仓库、GitHub 或 F-Droid 上的 Android 项目,以及开放许可或由基准作者编写的网站。
- Web 包含 44 个合成网站和 6 个源自公开网站的网站。
- 桌面和 Android 是源码盲的:agent 只能看到可执行参考应用,而实现被隐藏。Web 无法完全源码盲,因为提供的客户端代码可见;受保护材料是采集的真值和生成的测试套件。
- 桌面名单记录上游仓库和版本。应用选择在领域、框架、源码规模、功能复杂性和上游活跃度之间取得平衡。Ubuntu 混合使用 Qt、GTK 和 web 封装应用;macOS 以 AppKit 和 SwiftUI 为主;Windows 偏向 .NET 和 JVM 技术栈,并含有一部分 Qt 应用;Android 混合使用 Kotlin/Java 应用和 XML/Compose 界面,中位数为 15.0k LOC。
训练数据构建
- 训练任务来自 GitHub 上跨同样五个平台系列的高质量开源 GUI 应用,并已与评估集去重。
- Qwen3.8-Max 通过 RECREATION-WORLD 框架生成重建轨迹:agent 探索运行中的参考应用,实现一个候选版本,并利用执行反馈构建、运行、检查和优化它。
- rollout 在隔离的工作节点上并发运行,并记录其交互历史。
- 使用任务特定行为验证器进行拒绝采样,选择高分轨迹。
- 最终混合数据集从每个平台选取 7,000 条选定轨迹,形成一个平衡的 35,000 条轨迹 SFT 混合数据集。平衡按轨迹数量计算;各平台的轨迹长度和 token 贡献可能不同。
参考冻结与筛选
- 桌面参考被固定到上游提交,经过构建并在图形会话中运行。
- Android 参考在模拟器中构建并安装,移除偶然的首次运行干扰。
- Web 参考以静态快照形式冻结,在固定评分页面集之前发现并审核页面。
- 作者排除了库、框架、宿主程序扩展以及核心功能依赖登录或远程服务的应用。Android 还选择没有 Internet 权限的应用。
- 无法启动、渲染不完整或缺乏有意义交互的参考会被剔除。
测试套件与元数据
- 行为测试基于源码或页面分析,并结合运行参考应用的探索来构建。每个用例指定任何夹具或初始状态、交互序列,以及程序化断言、视觉断言或两者。
- 提议的用例会在干净参考上重放;无效或不稳定的检查会被丢弃,然后在冻结前进行人工审核。
- 在冻结的测试套件中,81 个任务在夹具树中打包了 393 个文件。Web 快照单独存储,没有显式的测试用例夹具包。
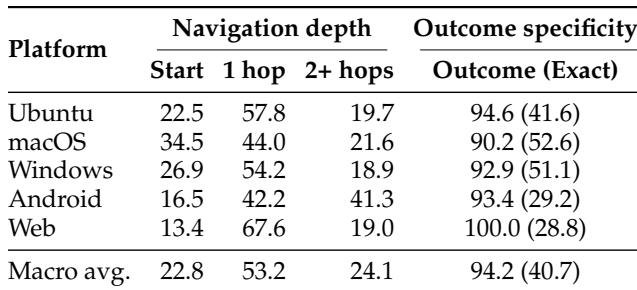
- 对冻结套件进行了导航和结果具体性审计。按平台等权平均,约 77% 的用例离开起始界面,24% 遍历两个或更多界面,94.2% 检查交互结果,40.7% 要求精确的预期结果。
在模型中的使用
- 35,000 条轨迹混合数据集用于两个模型初始化的监督微调:Qwen3.7-Plus 和 Qwen-Flash-CPT。
- RECREATIONBENCH 是评估资源。在 Web 评估期间,交付页面不得在评估时加载参考,桌面和移动视口均会评分,多页面任务保留基于路径的原始 URL,而不是 hash 路由。
方法
作者将应用重建定义为一个任务:agent 从可执行参考构建可运行的应用。agent 会收到高层提示、参考应用的交互访问权限,以及包含 GUI 控制和软件开发工具的预置环境。交互遵循反复的“探索-实现-验证”循环:agent 观察参考应用以更新部分行为规范,编写代码实现候选版本,并对照参考应用对运行中的候选做视觉或行为检查。这个过程逆转了编程任务的通常方向,要求 agent 通过对隐藏行为提出假设来恢复规范。
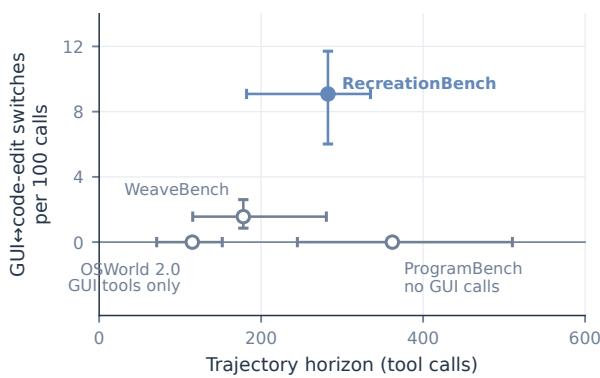
这种反馈循环自然带来长期交互。如上图所示,RECREATIONBENCH 轨迹表现出较高的顶层调用中位数,以及 GUI 操作和代码编辑之间的频繁切换,显著超过 WeaveBench 等基准的切换率。为支持这些长时间 rollout,作者设计了可扩展的执行基础设施。每个 rollout 获得一个版本化、任务隔离的工作节点,固定其图形运行时和构建工具链。这些工作节点在可水平扩展的虚拟机池中调度,在多个循环之间保留工作区和状态,每个 rollout 的墙钟超时时间为 20 小时。
框架还包括一个系统化流水线,用于构建基于参考的任务和隐藏行为测试套件。
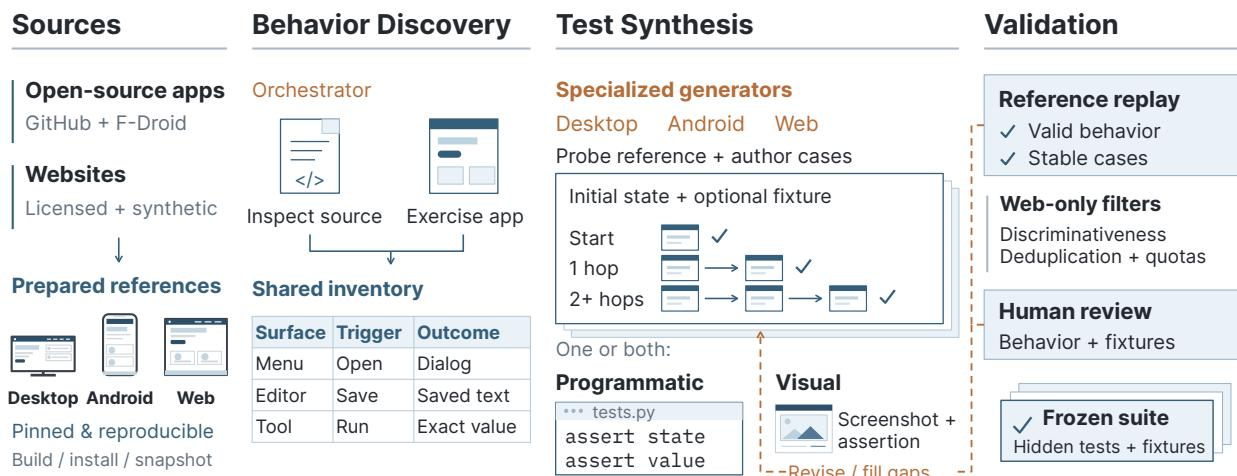
如框架图所示,构建过程始于开源桌面仓库、Android 项目和网站等来源。这些来源被准备为可复现参考。随后,编排器通过检查源码并运行参考应用来进行行为发现,建立功能、可达界面和可观察响应的共享清单。面向 Desktop、Android 和 Web 平台的专业生成器利用该清单编写测试用例。每个用例指定初始状态、可选夹具、交互序列和断言。这些断言可以是程序化的,通过自动化接口检查精确值,也可以是视觉的,依靠截图比较。提议的用例通过参考重放进行验证,以丢弃不稳定检查,随后经过平台特定筛选和人工审核,最终冻结套件用于评估。
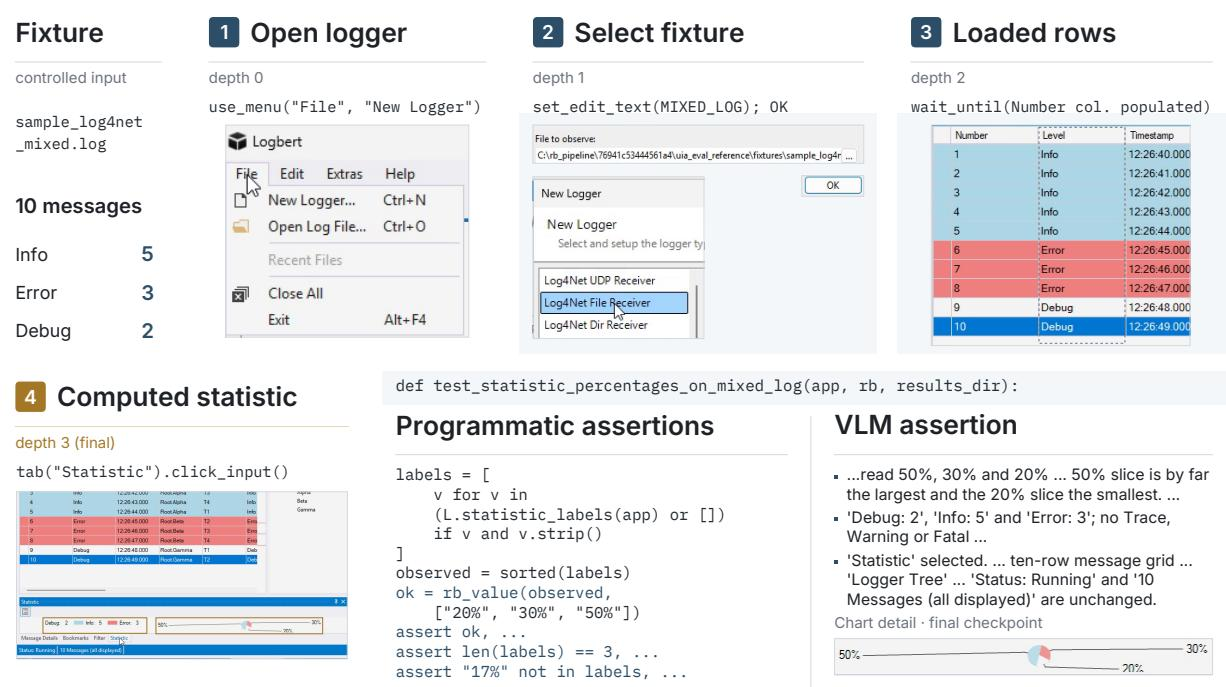
上图详细展示了一个为 Logbert 应用生成的 Windows 测试用例。它演示了从加载固定日志夹具、选择接收器到计算统计信息的流程。评估契约包括程序化断言(验证精确的 UI Automation 值和状态)和 VLM 断言(根据自然语言描述检查渲染的视觉输出)。
在训练设置中,作者从五个平台系列的高质量开源 GUI 应用获取任务。他们使用 Qwen3.8-Max 通过 agentic 框架生成重建轨迹,其中 agent 探索参考应用、实现候选版本,并利用执行反馈进行优化。框架在隔离工作节点上并发运行这些 rollout。作者使用任务特定行为验证器进行拒绝采样,以选择高分轨迹。他们从每个平台收集 7,000 条选定轨迹,形成平衡的 35,000 条轨迹 SFT 混合数据集。最后,他们在该混合数据集上微调两个模型初始化:Qwen3.7-Plus 和持续预训练的 Qwen-Flash 检查点。
实验
实验在 RECREATIONBENCH(一个涵盖五个平台的 250 个任务套件)和五个外部编程与计算机使用基准上评估经过重建训练的编程 agent,采用隔离的净室评估,并分别进行程序化和视觉评分。重建监督可迁移到分布外基准,并使 agent 行为转向更多验证、GUI 观察和交互,同时 GPT-6 Astra 总体领先,但完整的程序化重建仍然很少见。分析表明,更广泛的参考探索和更高的 GUI 调用占比与更强结果相关,但 agent 复现静态界面结构的能力优于复现依赖动作的行为,产物更小且更集中,工具包替换频繁,并且经常跳过最终的“编辑-重新启动-检查”循环。可编程交互运行时进一步减少工具调用、上下文、墙钟时间和估计成本,而未实质改变观察到的任务质量。
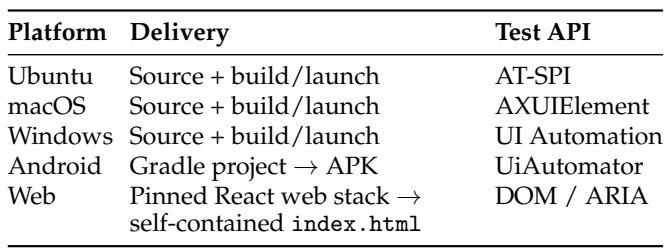
五个平台应用统一的观察-构建-评估契约,并使用原生交付和测试接口。桌面和 Android 使用源码盲设置,而 Web 暴露其提供的客户端实现。每个平台上,视觉断言补充平台特定的程序化 API。桌面交付使用源码加构建/启动,测试 API 面向可访问性:Ubuntu 上为 AT-SPI,macOS 上为 AXUIElement,Windows 上为 UI Automation。Android 将 Gradle 项目交付为 APK,并通过 UiAutomator 测试;Web 使用固定的 React web 技术栈,交付到包含 DOM/ARIA 的自包含 index.html。
冻结测试套件以单跳导航用例为主,而起始用例和两跳及以上用例平均较少。Android 差异最大,两跳及以上用例几乎与单跳用例一样常见。结果具体性整体较高,但精确结果率较为温和且因平台而异,macOS 和 Windows 领先。单跳导航是所有平台上最常见的用例类型,在 Web 上占比最高。Android 在单跳和两跳及以上导航之间几乎平分,起始用例相对较少。在五个平台中,macOS 的起始用例占比最高。各平台的结果具体性始终较高,Web 达到最高观测率。精确结果规定更不均衡,macOS 和 Windows 高于 Android 和 Web。
GPT-6 Astra 总体性能领先,其次是 Claude Opus 5 和 GPT-5.6 Sol。完整的程序化套件通过情况仍然罕见,聚合程序化分数掩盖了有限的高阈值覆盖。重建在复现静态界面结构和内容方面,比复现依赖动作的状态变化或计算结果更强。GPT-6 Astra 记录了最高的平均分、程序化分数和 VLM 分数,并且是唯一在多个平台上完整通过套件的模型。在大多数模型-平台比较中,静态结构和内容通过率超过交互、计算和按钮行为,原生平台上的差距最高达 34.4 个百分点,Web 上最高达 36.7 个百分点。
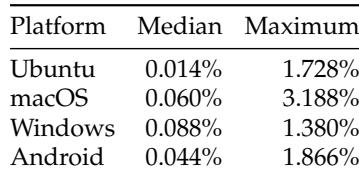
在全部四个平台上,重建实现与参考源码之间经噪声过滤的精确行重合始终很低。中位重合度从 Ubuntu 的 0.014% 到 Windows 的 0.088%,每个平台的最大值都低于 3.2%。这些结果表明,交付源码与参考在文本上绝大多数不同,而不是大段逐字复制。四个平台中,Windows 的中位重合度最高,Ubuntu 最低。所有平台最大值均低于 3.2%,其中 macOS 达到最大重合度。
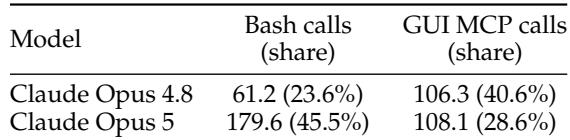
按平台加权平均来看,与 Claude Opus 4.8 相比,Claude Opus 5 的工具使用更多转向 Bash。它进行了大量更多的 Bash 调用,并将更大比例的工具调用用于 Bash,而专用 GUI 工具调用的占比更低。用例级证据表明,shell 调用可以捆绑许多 GUI 探索和验证动作,因此专用 GUI 调用计数可能低估 GUI 工作。Claude Opus 5 平均 Bash 调用次数几乎是 Claude Opus 4.8 的三倍,而其 GUI MCP 调用占比下降。两个模型的平均 GUI MCP 调用次数相对接近,但 Claude Opus 5 将几乎两倍的工具调用比例分配给 Bash。在 Ubuntu TeXworks 用例中,Claude Opus 5 批量捕获菜单并复用 shell 脚本进行验证,而 Claude Opus 4.8 更多依赖单独的桌面控制调用。
实验在五个平台上评估多模态 agent,采用共享的观察-构建-评估契约、原生交付和测试接口以及视觉断言,覆盖桌面、Android 和 Web 设置。结果表明,单跳导航和高结果具体性在基准中占主导,完整的程序化套件通过情况仍然罕见,模型对静态界面结构和内容的复现比依赖动作的状态变化或计算结果更可靠。源码重合分析表明,重建实现在文本上与参考代码不同,而非复制;工具使用比较表明,较新的模型越来越依赖打包的 shell 命令进行 GUI 探索和验证。