Command Palette
Search for a command to run...
OmniVChat:面向原生音视频对话的合成、基准构建与训练
OmniVChat:面向原生音视频对话的合成、基准构建与训练
摘要
本文将 OmniVChat(Omni Video Chat)定义为用户与 omni 模型之间的原生音视频对话任务。在 OmniVChat 中,omni 模型直接、同步地接收来自用户的音频和视频,并返回文本。用户查询蕴含在音频和视频中,无需单独的文本问题、外部字幕或语音识别。直接音视频输入降低了外部延迟和计算开销,同时保留了感知线索。然而,OmniVChat 的研究面临两个制约:数据可用性和评测。人们使用自有设备录制的音视频数据非常稀缺。此外,一个良好的回复往往需要考虑用户周围环境、面部表情和附近物体,而这类回复可以有多种不同表达方式,这使得关键词匹配在评估回复质量时不可靠。智能体系统与视频生成方面的近期进展使面向理解的生成成为可行,这意味着可以利用合成对话进行训练和评测。因此,我们提出了 OmniVChat-Studio,一个用于合成单轮和多轮音视频对话的多智能体数据引擎。我们利用合成对话构建了 OmniVChat-Bench,这是一个评测基准,用于在五个能力类别上评估 omni 模型的基础对话能力。我们还提出了 OmniVChat-RL,一种强化学习奖励设计,它同时针对 OmniVChat 中回复的正确性、效率和风格。在合成对话上使用 OmniVChat-RL 训练 Qwen3-Omni-Instruct,可提升其在 OmniVChat-Bench 和真人录制的 OmniVChat-Bench-Human 上的表现。这些提升验证了奖励设计的有效性,并展现出训练与评测向真实世界对话的迁移能力。
一句话总结
来自香港中文大学、阿里巴巴集团、上海交通大学等机构的研究者提出了 OmniVChat-Studio,一个用于合成音视频对话的多 agent 数据引擎,同时提出用于评估五类能力的 OmniVChat-Bench,以及一种强化学习奖励设计 OmniVChat-RL,该设计联合优化回复正确性、效率和风格;在合成对话上使用 OmniVChat-RL 训练 Qwen3-Omni-Instruct,能提升其在 OmniVChat-Bench 和人工录制的 OmniVChat-Bench-Human 上的表现。
核心贡献
- 论文提出 OmniVChat-Studio,一个多 agent 数据引擎,利用子类别配置和文本语料大规模合成单轮和多轮原生音视频对话,为 OmniVChat 训练和评估生成数据。
- 论文提出 OmniVChat-Bench,一个覆盖五类能力和 17 个子类别的评估基准,采用分层评分标准和大语言模型评分,评估回复是否使用用户语言并满足逐级提高的标准。
- 论文提出 OmniVChat-RL,一种强化学习奖励设计,将基于评分标准的回复正确性与效率和风格项结合;在 5,600 条合成对话上微调 Qwen3-Omni-Instruct,使 OmniVChat-Bench 得分从 0.465 提升到 0.652,人工录制的 OmniVChat-Bench-Human 得分从 0.402 提升到 0.632,同时将平均回复长度从 79 词降至 36 词。
引言
作者提出 OmniVChat 任务,在该任务中 omni 模型直接接收用户的同时音频和视频并返回文本,无需单独的文本查询、ASR 或字幕流水线。直接音视频输入之所以重要,是因为其降低外部延迟和计算量,同时保留声学和视觉线索,例如韵律、情绪和面部表情。先前工作受限于稀缺的开源设备录制数据以及评估困难,因为关键词匹配和基于规则的方法无法可靠地评分丰富的多模态回复。因此,许多系统依赖 ASR 级联,这会增加延迟、引入转录错误并丢弃细微的语音情感。为解决这些不足,作者提出 OmniVChat-Studio,一个可控的多 agent 数据引擎,用于合成原生音视频对话;OmniVChat-Bench,一个基于评分标准的评估基准;以及 OmniVChat-RL,一种强化学习奖励设计,联合优化回复正确性、效率和风格。在合成对话上使用该奖励微调 Qwen3-Omni-Instruct,可提升合成基准和人工录制基准上的表现。
数据集
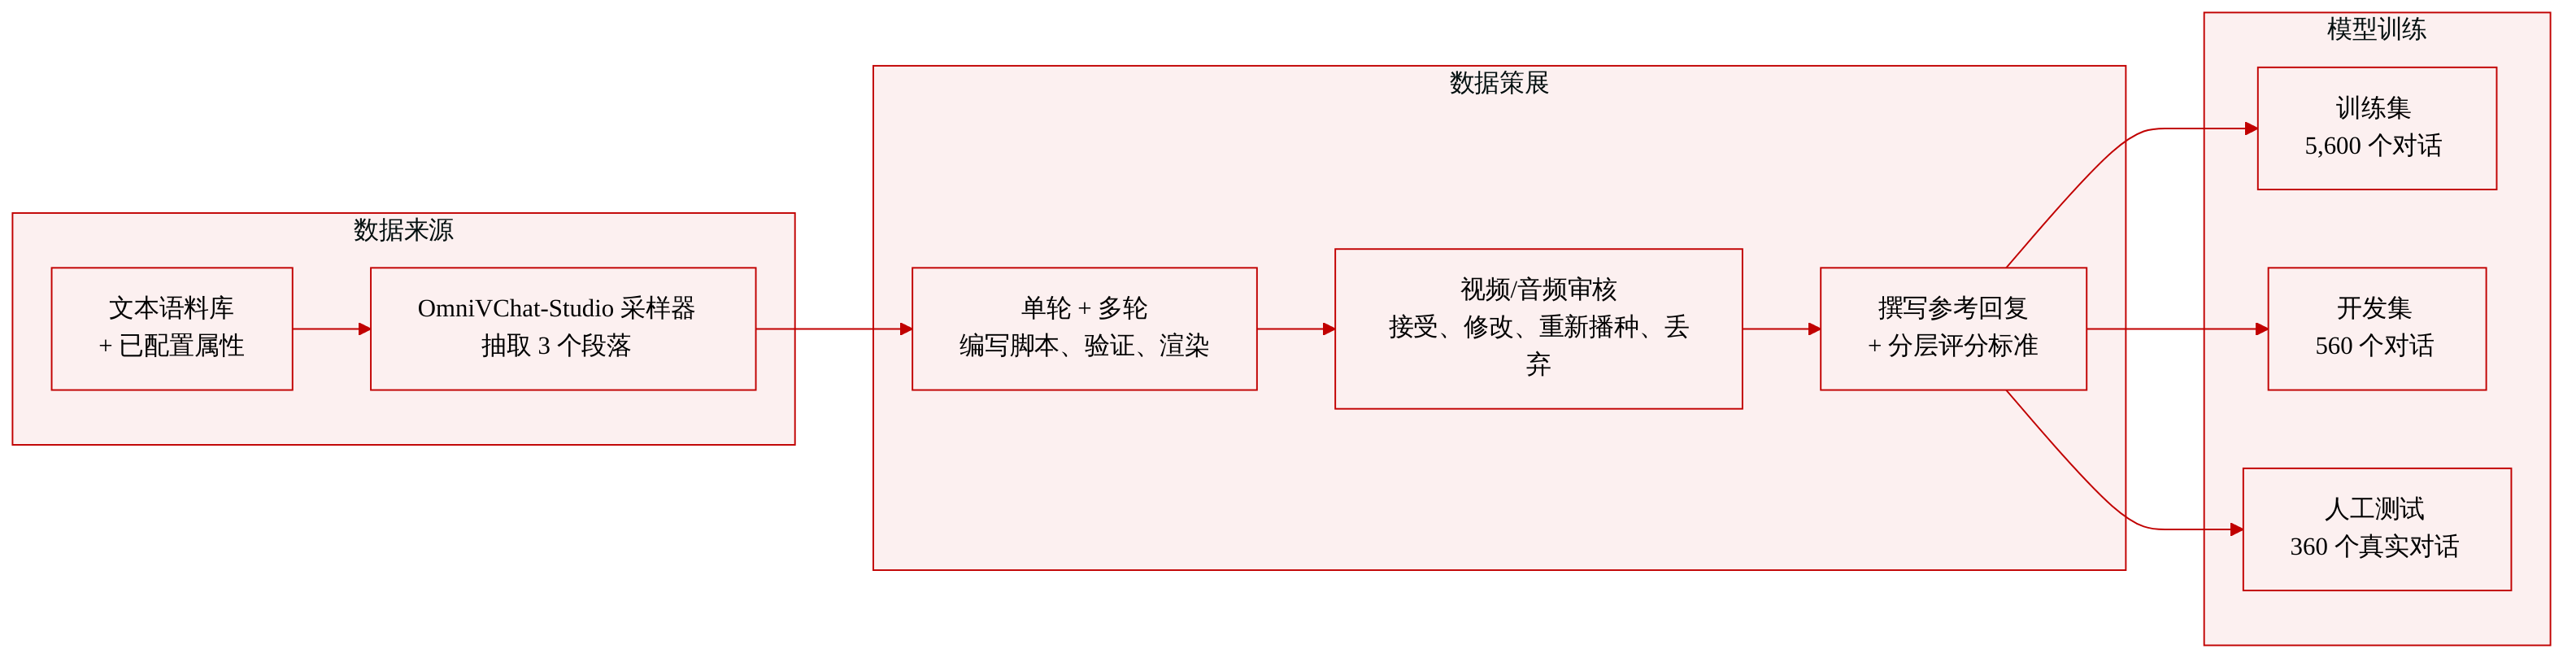
作者使用 OmniVChat-Studio,一个多 agent 数据引擎,从文本语料合成音视频对话数据。
-
来源与输出模式:
- 输入:大型文本语料加配置的属性值;采样器默认抽取三个段落。
- 输出:渲染的音视频片段、参考回复以及用于评分的分层评分标准。
- 完成的单轮实例为 1080P 片段,音频为 44.1 kHz 立体声。
-
基准构成:
- OmniVChat-Bench 包含 2,800 条合成实例:2,550 条单轮和 250 条多轮。
- 覆盖 17 个子类别、22 个场景领域和五类能力。
- 语言分布:1,766 条英语对话(63.1%)和 1,034 条中文对话(36.9%)。
-
数据子集:
- OmniVChat-Bench-Train:5,600 条合成训练对话加 560 条开发对话;开发集得分用于选择检查点。
- OmniVChat-Bench-Human:360 条人工录制的单轮对话,仅保留用于真实场景迁移评估。
-
构建与过滤:
- agent 角色包括 Director、Renderer、Reviewer 和确定性 Validator;Flexible 模块按子类别定制,而 Fixed 模块在所有类别中保持不变。
- 单轮流水线抽取段落、编写并验证脚本、渲染片段、审查视频,并编写有依据的参考回复和评分标准。
- 验证检查脚本格式、时间安排和规则违规。
- Video Review 使用字幕、七部分质量报告和聚焦问答证据,将渲染内容与已接受脚本进行比对。运行结果可被接受、修改、重新播种或丢弃。
- 音频检查识别咔嗒声和突断结尾以进行修复;人工检查员按既定流程确认片段展示了预期对话。
- 多轮构建将先前片段、音频或最终帧作为媒体占位符进行链接,并加入联合规划、规划审查、逐轮提示生成和提示审查。
-
能力类别与评分标准评分:
- 五个评估类别为对话状态与链接感知、多模态实体对齐、模型自我意识、抗幻觉和情绪识别。
- 每个实例包含一条参考回复和分层评分标准。第 0 层检查语言但不计分。仅当所有先前层均完成时,后续层才获得分数。
- OmniVChat-Bench 报告子类别平均分,先对 17 个子类别各自取平均,再跨子类别取平均。
- 在多轮评估中,所有模型接收相同的先前片段和参考回复,仅对最终回复评分。
方法
作者提出 OmniVChat-Studio,一个多 agent 数据引擎,从文本语料合成原生音视频对话数据。系统生成渲染的音视频片段、对应的参考回复和评分标准。其包含两个主要子系统:单轮子系统与多轮子系统。
如下图所示:
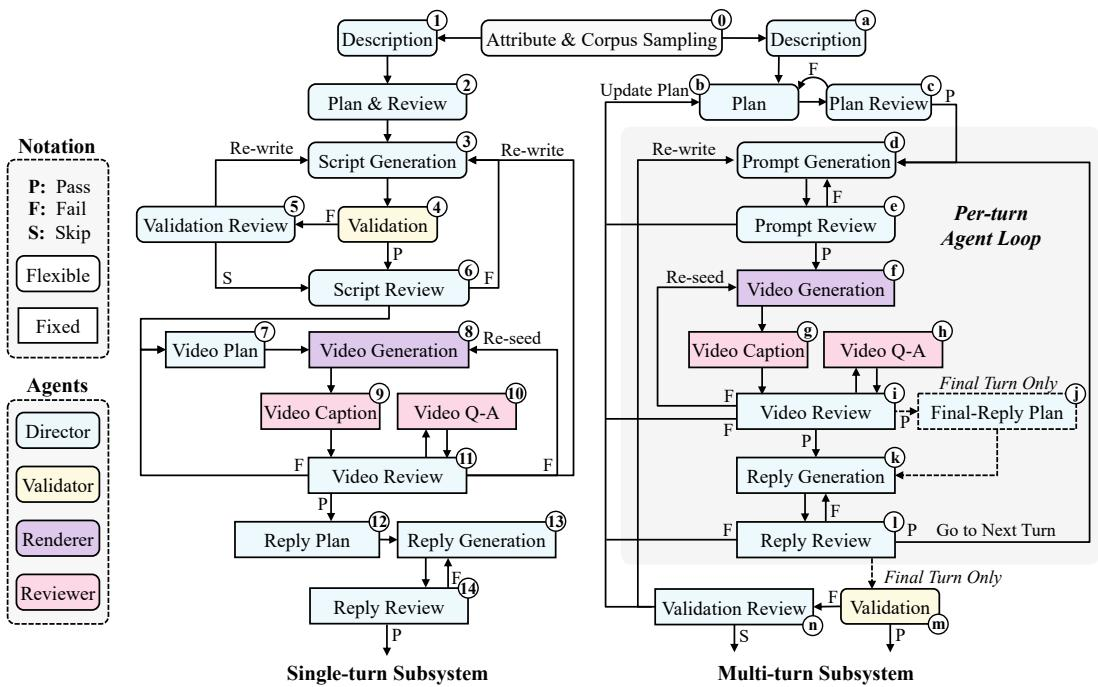
框架依赖四个不同的 agent 来执行合成流水线。Director 处理所有基于文本的输入输出任务。Renderer 将已接受的提示和媒体引用转换为同步的音视频片段。Reviewer 检查渲染内容,生成字幕和质量报告,并在需要额外证据时回答聚焦问题。确定性 Validator 根据配置规则检查结构化脚本或对话记录,返回通过或违规列表。架构区分 Flexible 模块和 Fixed 模块,前者使用子类别特定提示定制,后者在所有类别中保持不变。
单轮子系统通过顺序流水线合成单轮对话数据。它从属性和语料采样开始,选择属性值和文本段落。然后 Director 构建粗略故事情节并细化关键音视频场景细节。脚本生成创建结构化、带时间标记的脚本,由 Validator 评估。若出现违规,验证审查决定必要的修正。脚本被接受后,视频规划准备渲染提示,Renderer 执行视频生成以产生片段。Reviewer 生成视频字幕和质量报告。视频审查将渲染内容与脚本比对,可选择触发视频问答以获取聚焦证据。最后,回复规划和回复生成产生参考回复和分层评分标准,由回复审查最终确定。
多轮子系统管理跨顺序轮次的依赖。与单轮流程不同,它将规划阶段分为规划和规划审查,将故事情节展开为联合计划,指定每一轮并选择先前的媒体引用。它不采用单一脚本生成步骤,而是采用逐轮 agent 循环。提示生成使用媒体标识符作为占位符为每一轮编写渲染提示,随后由提示审查检查媒体链接。该循环对每一轮迭代执行视频生成、字幕生成和审查。仅在最后一轮,系统才执行最终回复规划、验证和验证审查以完成序列。
为优化模型的对话能力,作者提出 OmniVChat-RL,一个针对回复正确性、效率和风格的强化学习框架。基础模型是 Qwen3-Omni-30B-A3B-Instruct 的 Thinker 组件,使用分组序列策略优化(GSPO)训练。对于每个输入 x,采样策略抽取 N 条回复。优势 Ai 通过从每条回复的总奖励中减去组平均奖励来计算。目标函数最大化:
J(θ)=E[N1i=1∑Nmin(qi(θ)Ai,clip(qi(θ),1−εlo,1+εhi)Ai)]完整回复概率比 qi(θ) 按回复 token 数归一化,以减少长度依赖性。总奖励 R(y) 结合四个组成部分:
R(y)=r(y)+λfmtf(y)+λeffe(y)+λstys(y)其中 r(y) 是基于评分标准的正确性奖励。f(y) 是二元格式项,确保回复结构有效且不含思考标签。效率奖励 e(y) 鼓励简洁措辞。其由原始效率分数导出:
ρ(y)=max{w(y),1}r(y)其中 w(y) 是统计的回复长度。最终效率奖励在采样组内对 ρ(y) 进行归一化,最低值赋予 0,最高值赋予 1。风格奖励 s(y) 是二元分数,确认符合自然语音和语法标准。权重设置为 λfmt=0.5、λeff=0.1 和 λsty=0.5,正确性权重为 1。
实验
作者提出 OmniVChat-Bench,一个包含 2,800 条单轮和多轮对话的合成基准,通过分层评分标准评估五种基本对话能力;OmniVChat-RL 在结合评分标准正确性、风格、效率和格式的奖励上进行训练。训练提升了留出的合成和录制对话得分,同时产生更短、更高效且更符合风格要求的回复。与已发布系统和消融实验相比,OmniVChat-RL 在效率和风格上领先,同时保持较强的正确性;移除效率或风格奖励会揭示正确性、回复长度和风格之间的权衡。
报告的闭源模型在整体评分标准得分、录制人类对话得分、效率和风格上表现出不同领先者。Gemini-3.5-Flash 在平均评分标准表现上领先,Gemini-3.7-Flash 在录制人类和效率上领先,Gemini-3.1-Pro 在风格上领先,表明合成分数排名并不决定录制人类排名。Doubao Seed 2.0 Lite 在整体和录制人类平均分上落后,但在多轮对话上仍具竞争力。Gemini-3.5-Flash 在闭源模型中具有最高的整体平均评分标准得分,而 Gemini-3.7-Flash 在录制人类对话得分和每千词得分上领先。Gemini-3.1-Pro 达到最高风格通过率,但 MSA 得分明显较低,表明风格与类别能力可能分化。Doubao Seed 2.0 Lite 在闭源组中录得最低的整体平均分和录制人类得分,但其多轮得分与排名更高的系统相当。闭源模型之间的效率差异很大,领先者每千词获得的评分标准分数显著高于低效系统。Qwen3.5-Omni-Plus 在整体平均分和录制人类得分上通常低于 Gemini 模型,但仍获得较高的风格通过率。
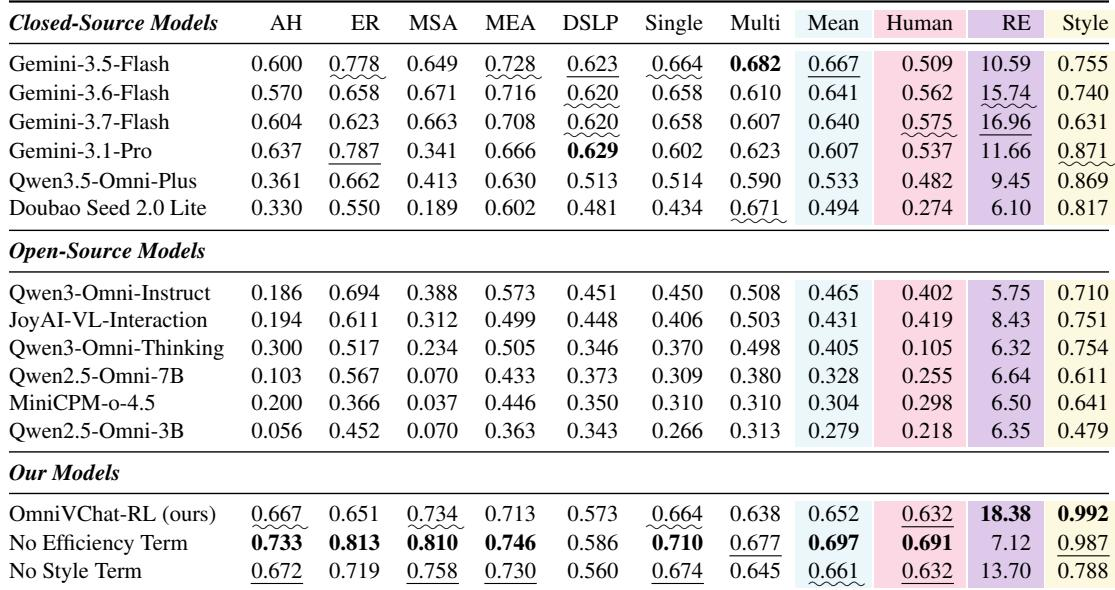
评估在基于评分标准的得分、录制人类对话质量、效率和风格方面比较闭源模型。没有单一模型在所有维度上领先:Gemini-3.5-Flash 在整体评分标准得分上表现最佳,Gemini-3.7-Flash 在录制人类得分和效率上领先,Gemini-3.1-Pro 在风格上领先但 MSA 得分较低,表明风格与类别能力可能分化。Doubao Seed 2.0 Lite 在整体和录制人类平均分上落后,但在多轮对话上仍具竞争力,而 Qwen3.5-Omni-Plus 尽管整体得分较低,却达到较高的风格通过率。