Command Palette
Search for a command to run...
IntBMoE:将块级条件化融入专家组合以实现全参与混合专家模型
IntBMoE:将块级条件化融入专家组合以实现全参与混合专家模型
Ran Cheng Longfei Xu Zheng Liu Kaikui Liu Xiangxiang Chu
摘要
混合专家(MoE)能够扩展模型容量,但现有设计无法独立设定三个量。对于单个 token,参与量指有多少个专家为其输出贡献知识,执行量指实际计算了多少个专家(计算成本),物化量指必须构建并存储多少个专家规模的参数集(内存成本)。稀疏路由保持较低的执行量和物化量,但会降低参与量:对于每个 token,只有少数专家贡献。稠密输出混合可恢复全参与,但其执行量随专家数量增长。参数合并将执行量保持在一个专家,但其物化量随路由决策数量增长。我们提出 IntBMoE,一种块条件化 MoE,通过将稠密专家组合与稀疏块执行配对来解耦这三个量。其块来自一个小型可学习码本,每个条目对应一个块。在每个内部层中,轻量超网络将该层池中的所有专家基合并为一个组合专家。由于每个组合专家都会利用整个池,因此参与量是完整的。执行保持稀疏,因为路由器将每个 token 只发送到少数几个块。物化量是有界的,因为块的数量由码本而非输入决定。双路径残差门控(DPRG)进一步通过乘法门控耦合两条独立组合的路径。图像分类实验表明,相比代表性稀疏和稠密 MoE 基线,该方法持续取得提升。语言建模和序列推荐上的额外实验验证了其在视觉之外的泛化能力。IntBMoE 已全面部署于 AMap 的生成式推荐系统中,在 60 ms 延迟预算下服务数亿用户,并在在线 A/B 测试中取得 2.4% 的相对 UVCTR 提升。我们的代码见 https://github.com/AMAP-ML/DreamX-Rec/。
一句话总结
来自 DreamX 和阿里巴巴集团的研究者提出 IntBMoE,这是一种块条件化混合专家架构。它通过学习到的码本和双路径残差门控(Dual-Path Residual Gating, DPRG)将稠密专家组合与稀疏块执行配对,从而将专家参与、执行和物化解耦。该架构在图像分类、语言建模和序列推荐上取得提升,并在 60 ms 延迟预算下,在高德部署的生成式推荐系统中实现 2.4% 的相对 UVCTR 提升。
核心贡献
- IntBMoE 是一种块条件化混合专家架构,通过将稠密专家组合与稀疏块执行配对,将专家参与、执行和物化解耦。其块来自一个小型学习码本,因此参与是完整的,执行保持稀疏,物化由码本大小限定。
- 在每个块内,双路径残差门控(DPRG)通过残差乘性门控耦合两条独立组合的路径,将分离的值路径和门控路径结合。
- 在 ImageNet-1K 上,IntBMoE 相比代表性的稀疏和稠密 MoE 基线持续取得提升;MiniPile 和 IntTravel 上的额外实验验证了其泛化到语言建模和序列推荐任务的能力。该架构已在高德生成式推荐系统中部署,在 60 ms 延迟预算下服务数亿用户,并在在线 A/B 测试中实现 2.4% 的相对 UVCTR 提升。
引言
混合专家(MoE)架构广泛用于语言、视觉、多模态和推荐模型,因为它们能够扩展模型容量,同时控制计算量。然而,此前的 MoE 设计将专家参与、执行和物化耦合在一起:稀疏路由只激活少量专家,但将每个 token 限制在所选专家上;稠密输出混合让所有专家参与,但需要计算每个专家;参数合并实现完整参与,但在运行时创建大量专家规模的参数集。作者提出 IntBMoE,这是一种块条件化 MoE,将可复用块的构建与 token 级执行分离。有限码本和共享超网络从完整专家池组合出有界的可复用块集合,而路由器对每个 token 仅执行少量块,从而同时实现池级专家参与、稀疏执行和有界参数物化。
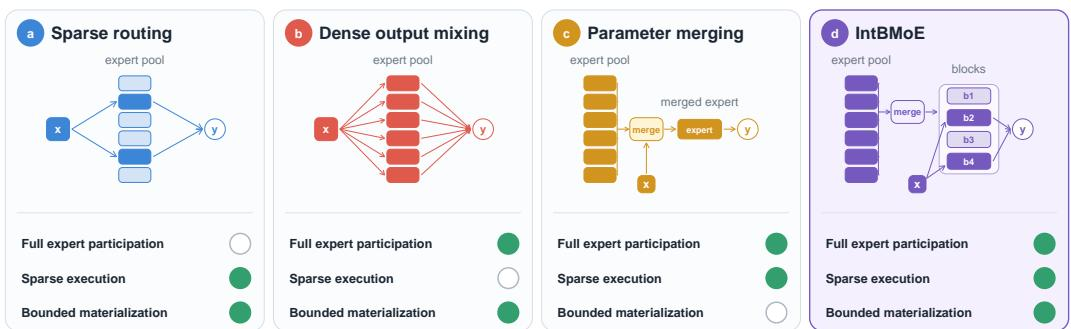
方法
作者引入 IntBMoE,它通过替换传统的前馈网络子层集成到标准 Transformer 主干中。该架构不使用标准的稠密或 token 级专家路由,而是从共享专家池组合出可复用的多层块,并将每个 token 稀疏路由到少数选定块。
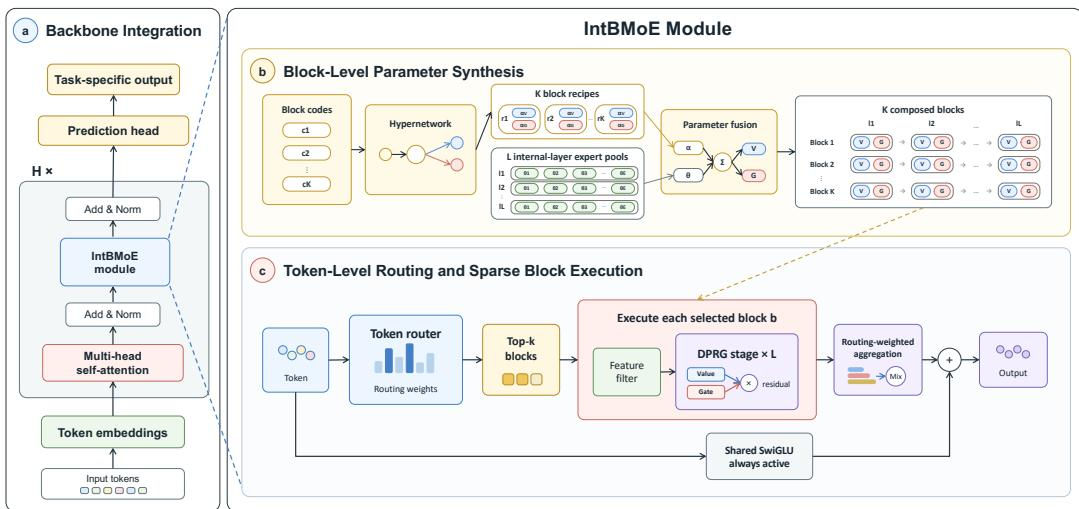
如下图所示,该设计在两个不同层级上运作:块级参数合成和 token 级路由。
在块级,模块维护一个包含 K 个学习嵌入的码本,每个嵌入 cb∈Rdc 标识一个候选的 L 层块。共享超网络 hϕ 通过线性-LayerNorm-ReLU 主干处理每个嵌入,生成隐藏表示 qb。随后,两个线性输出头将该表示映射为值组合系数和门控组合系数 αbv 和 αbg。
对于每个内部层 ℓ,模块维护一个层特定的包含 E 个专家基底的池。超网络系数对这些专家基底进行线性组合,以合成 K 个块的参数。为了在池规模增大时保持参数尺度稳定,组合时应用 1/E 的方差保持因子:
Wb,p(ℓ)=E1e=1∑Eαb,epWe(ℓ),bb,p(ℓ)=E1e=1∑Eαb,epbe(ℓ)其中 p∈{v,g}。由于该合成仅依赖于学习到的块嵌入,而不依赖于 token 表示,因此 K 个组合块是 token 无关的,可以预先计算。
在 token 级,路由器根据每个 token t 的表示 xt 独立选择 Top-k 个块。路由器实现为两层 ReLU MLP,输出得分向量 rt,所选块的路由权重 πt,b 通过 softmax 计算。在进入选定块 b 之前,token 表示会经历块条件化特征过滤。token xt 与块码本嵌入 cb 拼接,并通过共享特征过滤层生成软特征维度掩码 mt,b。过滤后的表示 zt,b(0)=xt⊙mt,b 为不同块提供同一 token 的不同视图。
在每个块内,作者采用双路径残差门控,在独立组合的值路径和门控路径之间引入非线性交互。对于输入为 zt,b(ℓ−1) 的内部层 ℓ,值和门控变换计算如下:
vt,b(ℓ)=Wb,v(ℓ)zt,b(ℓ−1)+bb,v(ℓ) gt,b(ℓ)=RMSNorm(Wb,g(ℓ)zt,b(ℓ−1)+bb,g(ℓ))这些路径通过残差乘性调制耦合:
zt,b(ℓ)=vt,b(ℓ)⊙(1+λSiLU(gt,b(ℓ)))其中 λ 是跨内部层共享的可学习残差缩放系数。在相邻层之间应用 LayerNorm,块的最终输出表示为 Fb(xt)。
选定块的输出使用各自的路由概率进行聚合,形成路由输出 ytroute。为捕获不需要 token 相关选择的公共信息,该架构添加了一个始终激活的共享 SwiGLU 专家 S。最终输出为路由块输出与共享专家输出之和:
yt=ytroute+S(xt)在计算复杂度方面,从 E 个基底组合全部 K 个块的成本为 O(KED),而对 T 个 token 执行 k 个选定块的成本为 O(TkD)。推理时,由于块组合仅依赖固定的模型参数,组合块参数可以一次性构建并缓存。这从请求时计算中去除了 O(KED) 的组合项,确保主要的路由块成本保持为 O(TkD),且与专家池大小 E 无关。
实验
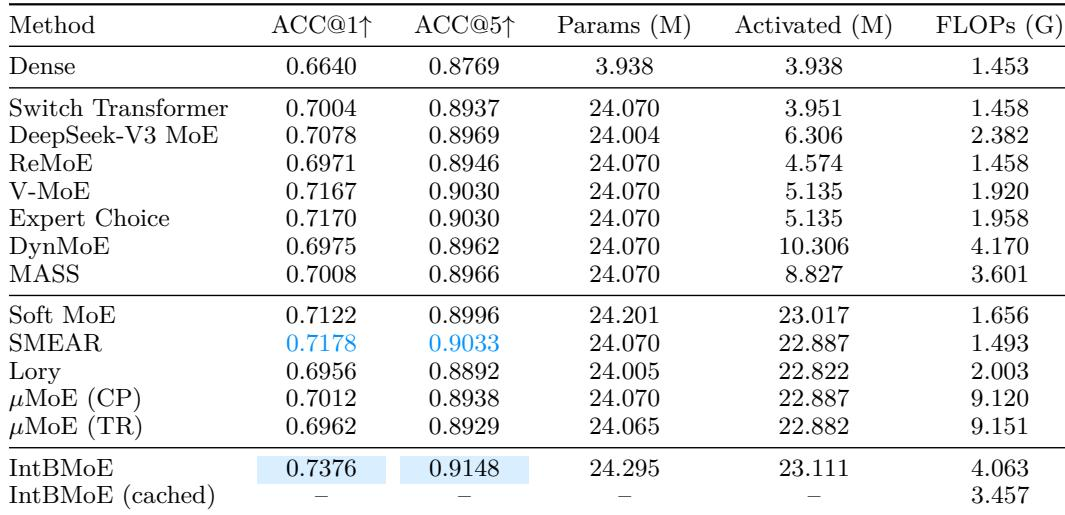
作者在 ImageNet-1K 上使用 DeiT-Tiny 风格主干评估 IntBMoE,并将其与稠密、稀疏路由和稠密参与 MoE 基线比较。IntBMoE 优于所有基线,消融实验表明,组合门控路径、两层块结构、共享专家和特征过滤均有贡献,其中门控路径最重要。分析进一步表明,该方法实现了有效的全池专家参与、类别和深度相关的块路由,以及在更深层中越来越块特异化的专家组合方式。缓存推理使请求时的内存和计算量与专家池大小无关,并且该方法可泛化到语言建模和序列推荐,包括在生产 POI 推荐中部署后在延迟约束下提升 UVCTR。
IntBMoE 在 ImageNet-1K 上达到 73.76% Top-1 和 91.48% Top-5 精度,相比其稠密主干分别提升 7.36 和 3.79 个百分点。在总参数量接近 24M 的可比预算下,它也超过了所有比较的稀疏路由和稠密参与 MoE 基线,包括最强竞争对手。无缓存时每张图像推理成本为 4.063 GFLOPs,有缓存时为 3.457 GFLOPs。IntBMoE 在 Top-1 上超过稠密主干超过 7 个百分点,在 Top-5 上接近 4 个百分点。在可比参数预算下,它比最强 MoE 基线高出接近 2 个 Top-1 点。缓存将每张图像推理成本从约 4.1 GFLOPs 降至约 3.5 GFLOPs,同时保持选择性块执行。
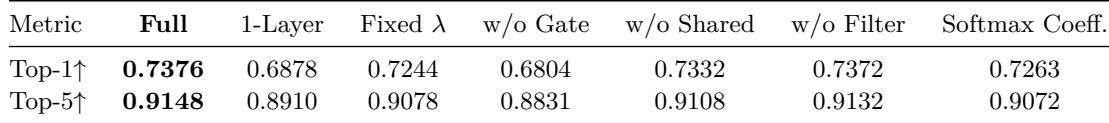
在消融变体中,完整模型达到最高的 Top-1 和 Top-5 精度。移除组合门控路径导致最大的性能下降,其次是将两层块压缩为参数匹配的单层设计。共享专家和特征过滤提供较小但持续的提升,而固定和 softmax 归一化的系数形式不如完整形式。组合门控路径是最关键的组件,其移除在所有消融中造成最大的 Top-1 和 Top-5 下降。共享专家和特征过滤带来较小但持续的精度提升,学习或不受约束的系数形式优于固定或 softmax 归一化的替代方案。
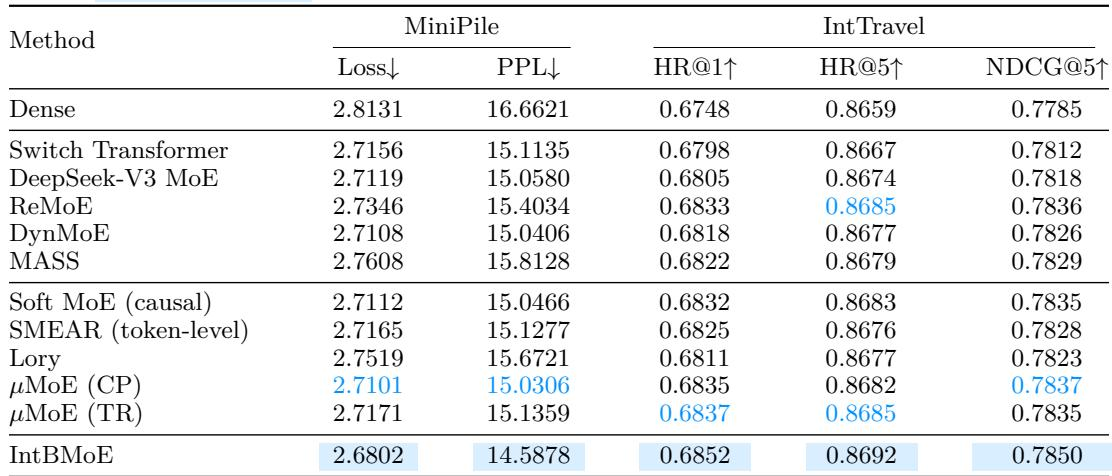
IntBMoE 可泛化到自回归语言建模和序列推荐任务。在 MiniPile 上,它取得比稠密主干和所有报告的稀疏或稠密参与基线更低的困惑度。在 IntTravel 上,它在评估方法中达到最佳排序指标。在 MiniPile 上,IntBMoE 相比稠密主干以明显幅度降低困惑度,相比最强基线的幅度较小。在 IntTravel 上,IntBMoE 在比较方法中达到最高的 HR@1、HR@5 和 NDCG@5。稠密主干在 MiniPile 语言建模指标上最弱,而若干稀疏基线改善了损失和困惑度。
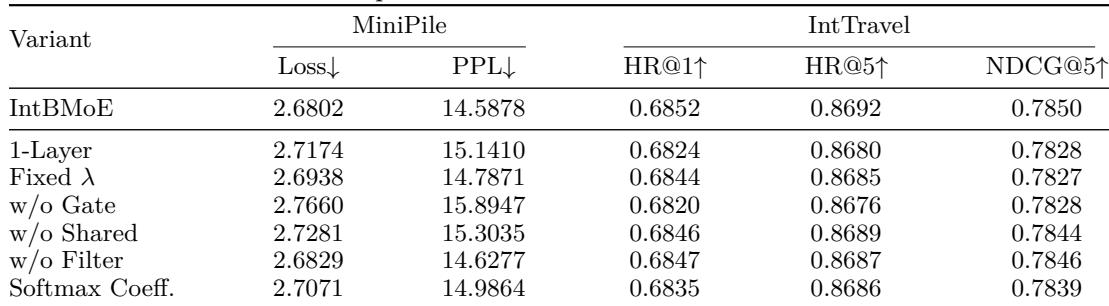
完整模型在 MiniPile 和 IntTravel 的所有报告指标上均取得最佳结果。消融表明,门控路径是 MiniPile 上影响最大的组件,也是 IntTravel 的主要贡献因素,而两层结构带来的收益超出了匹配专家参数数量所能解释的范围。共享专家、可学习 lambda、特征过滤和不受约束组合在两个自回归任务上均带来持续提升。移除门控路径导致 MiniPile 损失和困惑度最大幅度上升,并降低 IntTravel 命中率。参数匹配的 1 层变体不如完整模型,说明两层块结构在专家参数数量之外带来额外收益。使用共享专家在两项任务上带来较小但持续的改进。固定 lambda 或移除特征过滤会损害两项任务,而不受约束的方差缩放系数优于 softmax 归一化组合。
IntBMoE 在 ImageNet-1K 分类、MiniPile 自回归语言建模和 IntTravel 序列推荐上进行了评估,并进行了额外消融研究。在可比参数预算下,它持续优于其稠密主干和比较的稀疏或稠密参与 MoE 基线,同时缓存将每张图像推理成本从约 4.1 GFLOPs 降至 3.5 GFLOPs。消融表明,组合门控路径和两层块结构最重要,而共享专家、特征过滤和不受约束的系数组合在各项任务上带来较小但持续的提升。