Command Palette
Search for a command to run...
编码智能体 Harness 设计的实证研究
编码智能体 Harness 设计的实证研究
Run-Ze Fan Zihao Zhang Simin Ma Yebowen Hu Shouju Wang Kaiqiang Song Fei Liu Hamed Zamani Xiaoyang Wang
摘要
编码 Harness 决定了自主编码智能体如何将模型能力转化为长程软件工程性能,但现有工作通常将 Harness 作为整体系统进行评估,导致单个组件的有效性尚不清晰。为了支持组件级比较,我们使用一个轻量级编码 Harness 研究该问题:固定其执行循环,同时改变三个组件,即规划、动作空间和上下文管理。在 SWE-Bench Verified 和 Terminal-Bench 2.1 上对四个模型进行评测,我们评估了 176 个匹配设置,涵盖五种上下文管理策略、四种上下文窗口预算,以及针对规划和动作空间的定向消融。我们发现:(1)随着上下文窗口预算收紧,上下文管理的价值越来越大,其主要收益来自防止上下文溢出失败。(2)在上下文管理策略中,先执行基于规则的省略、再执行基于 LLM 的摘要,可获得最强的总体效率;而使被省略内容可恢复则增加了模型很少使用的机制,且未带来准确性提升。(3)规划的作用从较弱模型的准确性支架转变为较强模型的成本节省手段,对准确性影响很小。(4)预定义工具能提升 bash 熟练度较弱模型的性能,而具备 bash 能力的模型仅通过 bash-only 接口即可有效工作,并实现显著更低的成本,尤其是在命令行中心型任务上。轨迹级分析解释了这些效应:上下文管理延长了执行轨迹,但未实质性改变智能体行为;规划改变了轨迹停止的位置;动作空间改变了代码编写的粒度。这些发现为面向模型与预算的 Harness 设计提供了依据,并为评估未来 Harness 组件提供了模块化框架。
一句话总结
在一项对四个模型在 SWE-Bench Verified 和 Terminal-Bench 2.1 上评估的 176 个匹配 harness 配置的实证研究中,UMass Amherst 等人发现:上下文管理主要防止紧张预算下的溢出失败;在 LLM 摘要之前进行基于规则的省略最有效率;规划从准确率支架转变为成本节省手段;预定义工具可帮助 bash 能力较弱的模型,而具备 bash 能力的模型偏向成本更低的 bash-only 操作。
核心贡献
- 一个模块化 harness 评估框架固定了执行循环,并改变规划、动作空间和上下文管理,应用于 176 个匹配设置,涵盖五种上下文管理策略、四种上下文窗口预算以及在 SWE-Bench Verified 和 Terminal-Bench 2.1 上针对四个模型的定向消融。
- 随着上下文窗口预算收紧,上下文管理变得最有价值,其大部分收益来自防止上下文溢出失败。策略 T4 通过先进行基于规则的省略,再进行选择性 LLM 摘要,在总体成功率相近的情况下实现了最低总成本;而使被省略内容可恢复所增加的机制很少被模型使用,也没有带来准确率提升。
- 规划从较弱模型的准确率支架转变为较强模型的成本节省手段,准确率变化很小。预定义工具可提高 bash 熟练度较弱模型的性能,而具备 bash 能力的模型可以在 bash-only 接口下以显著更低的成本有效运行,尤其是在以命令行为中心的任务上;轨迹级分析将这些效果与不同的行为变化联系起来。
引言
大型语言模型正越来越多地被用于自主解决真实软件工程任务,例如关闭 GitHub issue 以及完成端到端终端工作。这些结果在很大程度上取决于编码 harness,即软件层,其规划、动作接口和上下文管理选择即使在底层模型保持不变时也可能改变性能。然而,许多早期研究将 harness 作为完整系统进行比较,混叠了多种机制,难以判断性能差异来自规划、工具、上下文管理还是它们与模型的交互。作者通过构建一个具有固定执行循环且仅改变规划、动作空间和上下文管理的模块化 harness 来解决这一问题。他们在 SWE-Bench Verified 和 Terminal-Bench 2.1 上评估了三种 Nemotron-3 模型规模以及 Mistral-Medium-3.5-128B,在 32k 到 128k token 预算之间扫描五种上下文管理策略,并对规划和动作空间进行消融,以刻画每个组件的有用性如何取决于模型能力、任务类型和资源预算。
方法
作者利用一个模块化且轻量的 harness,旨在隔离并评估各个组件在不同模型和计算预算下的贡献。总体框架遵循 ReAct 循环,每一轮由推理步骤、动作和观察组成。这种模块化设计允许组件被独立配置和组合,以进行受控的组件级分析。
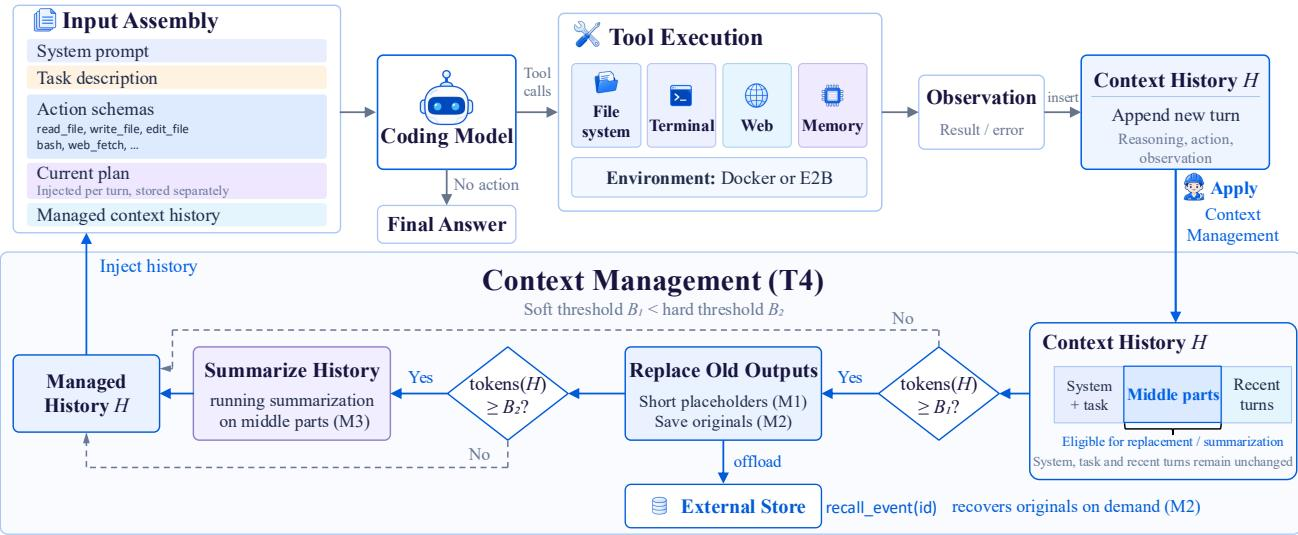
该 harness 改变三个主要组件:规划、动作空间和上下文管理,同时保持其他支持组件不变。
规划提供由模型维护的显式且持久化的任务进展表示。启用时,系统指令定义协议,第一轮提醒要求在执行任何动作之前生成初始计划。模型通过专用工具维护该计划。在后续轮次中,计划被追加到模型输入中,而不存储在对话历史中。此设置评估的是持久化规划支架的效果,而不是作为通用推理策略的规划。
动作空间定义 agent 如何与环境交互。在预定义工具设置中,harness 提供一组用于文件操作、文本搜索、网页获取和 bash 执行的工具。每个工具具有类型化的参数 schema,以及描述其协议、错误和副作用的说明。网页搜索被明确排除,以避免暴露 ground-truth 补丁。在 bash-only 设置中,预定义的文件、搜索和网页工具被移除,留下 bash 用于一般环境交互。这种干预还改变了工作区修改的跟踪和验证方式,强制执行先读后写检查并触发自动诊断。
上下文管理决定不断增长的交互历史如何在有界上下文窗口内表示。作者通过三种可组合机制借鉴了有损和无损方法。省略将过期工具观察的主体替换为短占位符。召回将省略的观察存储在文件系统中,并暴露一个工具以便按需读回,使省略可逆。摘要把较早的消息折叠到运行中的自然语言摘要中,该摘要由对同一模型的独立无工具调用生成。
这些机制在两个 token 阈值下组合:软阈值 B1 和硬阈值 B2。固定前导部分和至少两轮 token 预算内的最近窗口保持逐字保留。一旦历史超过 B1,harness 会省略中间区域中庞大的工具观察,将原始内容存储在外部,并在原处留下占位符。如果历史仍然超过 B2,harness 会把最旧的中间事件总结到运行摘要中。这种完整的三机制配置确保省略以低成本回收 token,召回在需要时恢复细节,摘要压缩过于陈旧而无法逐字保留的历史。
除了这三个可变组件外,harness 还包括若干固定支持组件以确保稳健执行。安全层通过路径解析、先读后写检查和权限层对动作进行分类,强制执行工作区访问控制。工具错误会作为观察返回给模型,而不是抛出异常,从而防止循环崩溃。编辑后诊断对编辑过的 Python 文件运行快速的只读检查,以立即暴露语法错误和未定义名称。最后,卡住检测机制监控工具日志中连续相同的调用,注入提醒或提前结束运行,防止 agent 在重复失败上耗尽步骤预算。
实验
实验在 SWE-Bench Verified 和 Terminal-Bench 2.1 上评估了 30B、120B 和 550B 的 Nemotron-3 模型以及 Mistral-Medium-3.5-128B,变化上下文管理层级、上下文窗口预算、规划和工具空间配置。上下文管理在紧张窗口下尤其有价值,因为它防止截断失败;T4 给出了最佳的准确率与成本权衡,而召回很少被使用且几乎不增加收益。规划延长较弱模型的轨迹,使其足以尝试编辑;而对较强模型来说,规划主要削减编辑后验证并降低成本。完整工具集为较弱模型提供支架,但 bash-only 可以通过启用更大的代码编写动作和更少的交互来帮助较强模型,尤其是在以 shell 为中心的任务上。
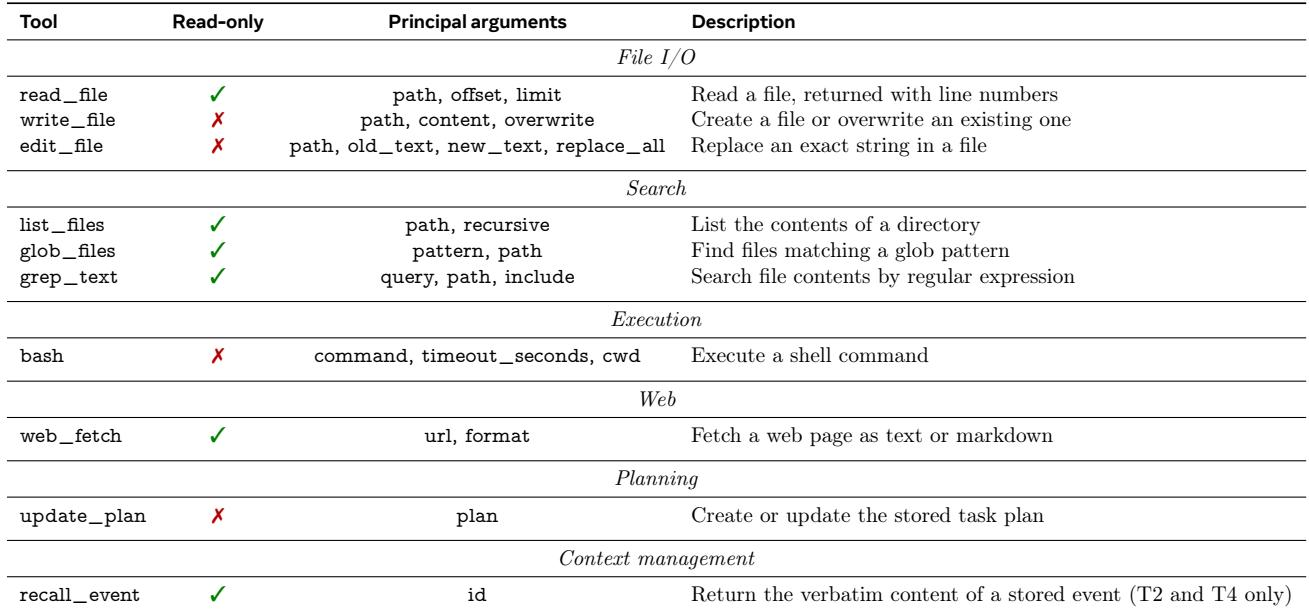
harness 暴露预定义的文件、搜索、网页和 bash 工具,这些工具具有类型化 schema,并表现出只读或修改状态的行为。只读工具可以在一个模型轮次内并发执行;bash-only 条件移除预定义的工作区工具,同时保留 bash 以及 update_plan 和 recall_event 等辅助工具。实验表明,规划主要减少冗余的编辑后验证,而 bash-only 鼓励更少但更大的代码编写和文件替换动作。用于文件读取、列出和 glob 的只读工具不会修改工作区或 harness 状态,可以在一个模型轮次内并发执行。bash-only 移除预定义的工作区工具,但保留 bash 和辅助工具,导致模型将操作打包为更少、更大的代码编写或创建或替换动作。
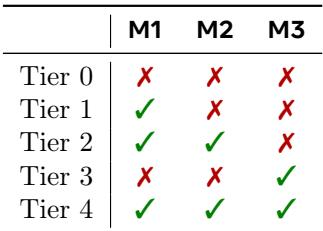
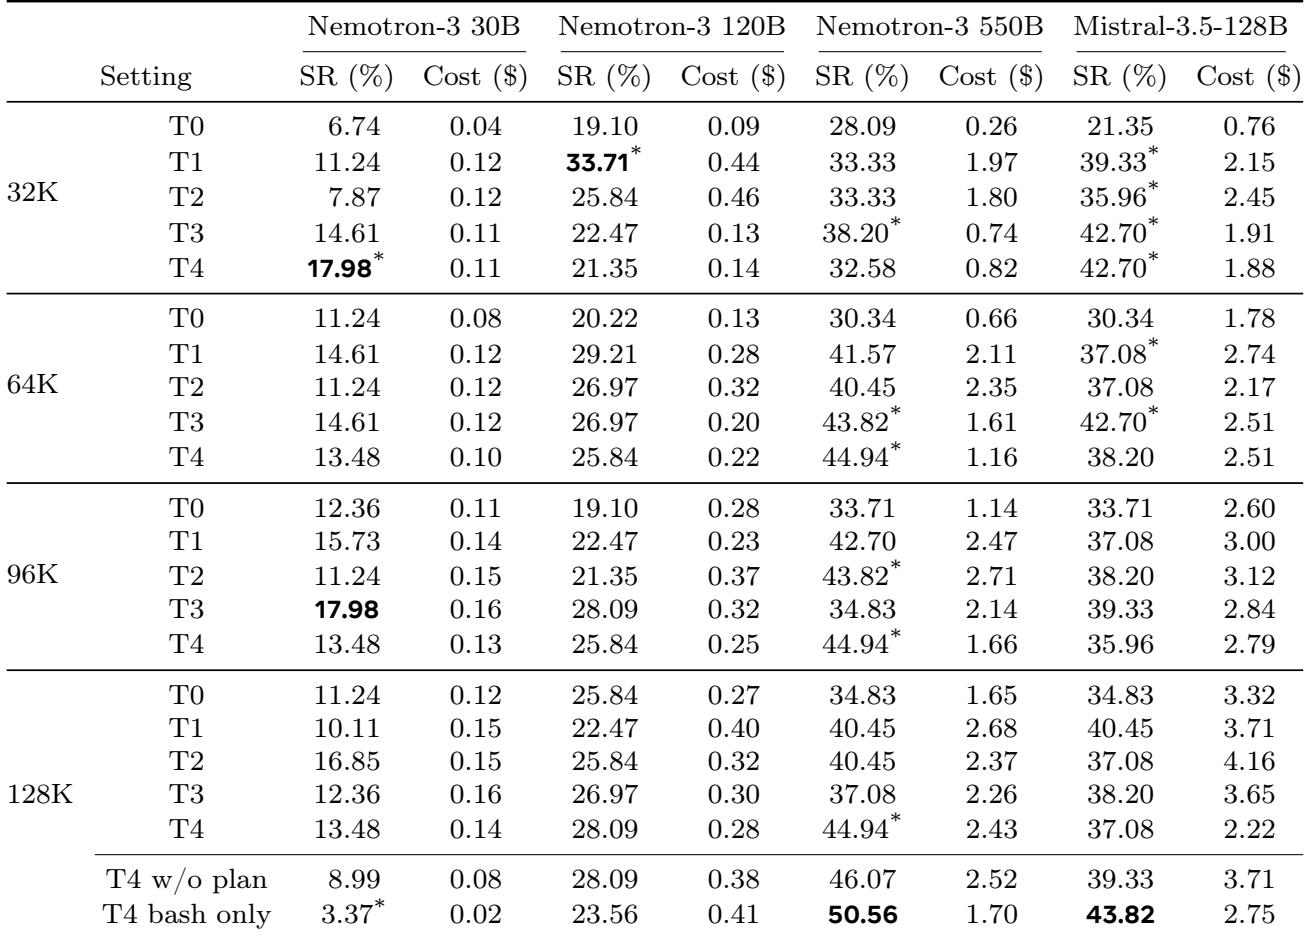
配置的层级范围从无上下文管理到使用省略、召回和摘要的组合方法。中间层级分别隔离省略、带召回的省略以及仅摘要。完整配置在软阈值处应用省略,在硬阈值处应用摘要,而中间的单动作层级在硬阈值处运行。Tier 4 是唯一启用全部三种机制(省略、召回和摘要)的层级。召回建立在省略之上,将省略的观察存储在外部,使省略可逆。Tier 1 和 Tier 3 分别隔离省略和摘要,而 Tier 0 完全禁用上下文管理。
在 SWE-Bench Verified 上,上下文管理在最紧的上下文窗口预算下相对无管理实现了最大的成功率提升,并且这种优势随着窗口增大而收窄。在受管理层级中,结合省略、召回和摘要的层级提供了与其他受管策略相当的准确率,同时实现每任务最低平均成本。这一成本优势来自将峰值上下文保持在名义预算以下,并减少对 LLM 摘要的依赖。受管理层级与无管理之间的成功率差距在最小上下文预算下最大,并随着上下文窗口增大而稳步缩小。结合省略、召回和摘要的策略在大多数设置下与其他受管理层级具有相当的成功率,同时每任务平均成本最低。该组合层级将峰值上下文使用量保持在远低于名义窗口的水平,并且比仅摘要管理更少调用 LLM 摘要。
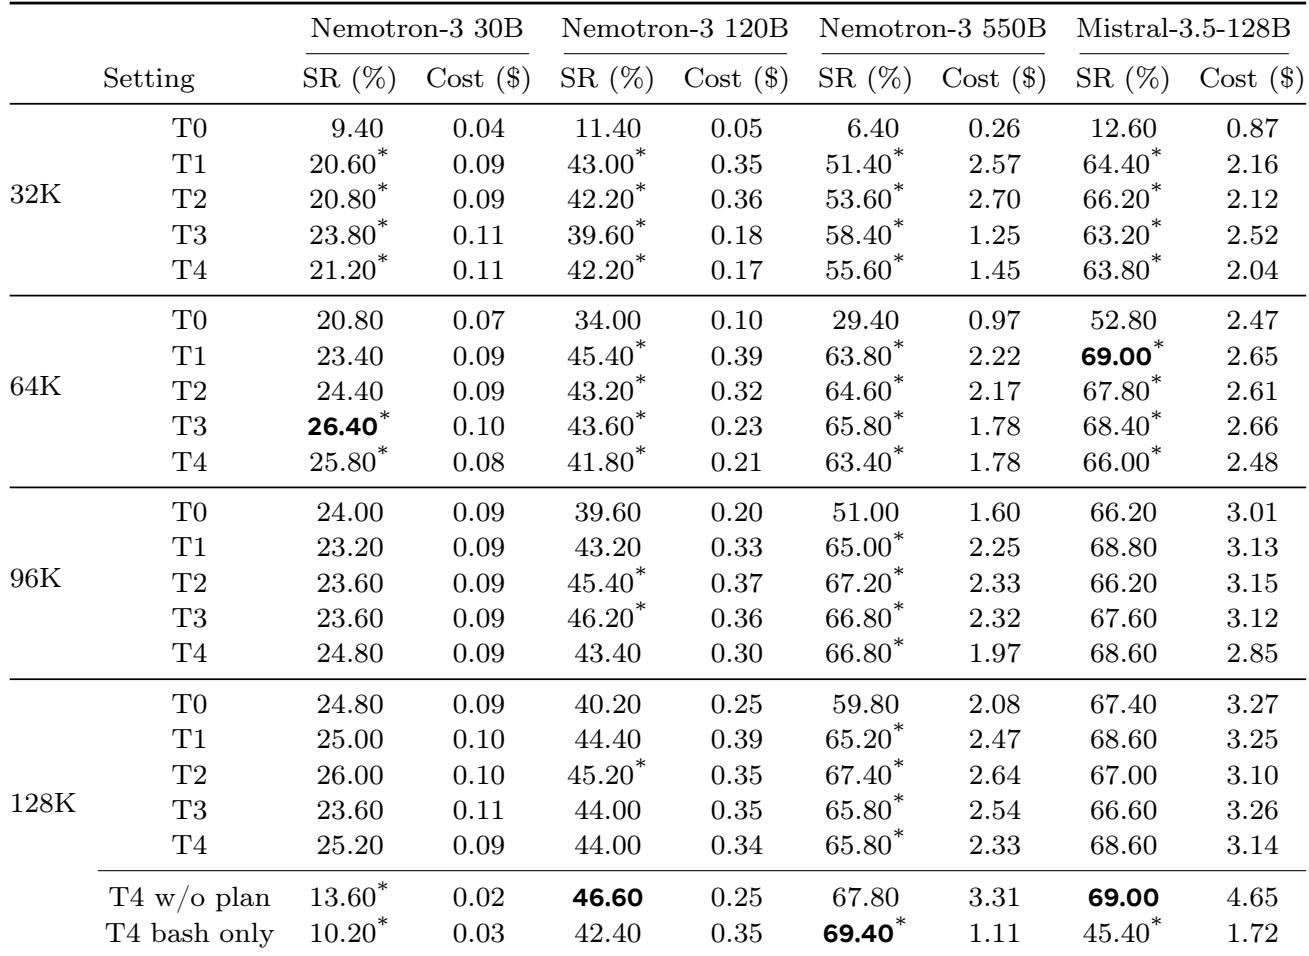
在 Terminal-Bench 上,上下文管理相对无管理提高了成功率,尤其在紧张上下文预算下收益最大。T4 在受管理层级中提供了最佳的准确率与成本权衡,而对于较大模型,T3 和 T4 的成本低于 T1 和 T2。受管理层级完全避免了窗口溢出失败,而未受管运行对上下文窗口容量更敏感。在 32k 预算下,每个受管理层级对全部四个模型都提高了相对 T0 的成功率,其中 Mistral-3.5-128B 的收益尤其大。对于较大模型,T3 和 T4 比 T1 和 T2 显著更便宜,并且 T4 在四个模型中的两个上取得了最佳或并列最佳的成功率。
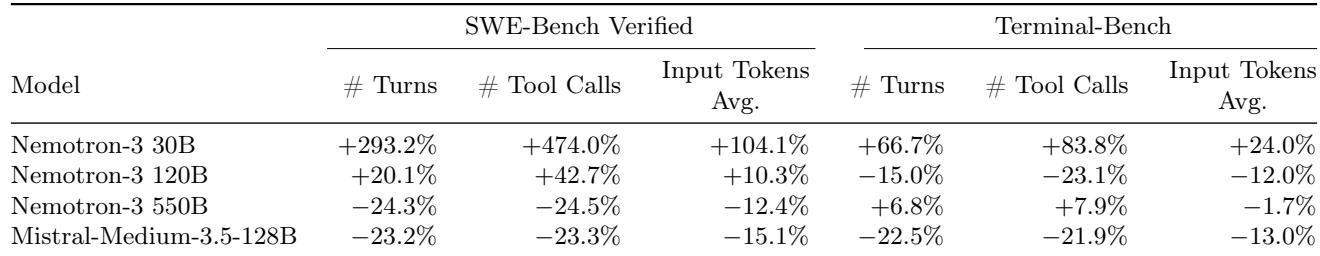
在 128k 上下文预算和完整工具集下,规划对轨迹成本的影响依赖模型。Nemotron-3 30B 在两个基准上都显示出轮次、工具调用和平均输入 token 增加,而 Nemotron-3 550B 和 Mistral-Medium-3.5-128B 在 SWE-Bench 上显示减少。Nemotron-3 120B 呈现混合模式,在 SWE-Bench 上增加,但在 Terminal-Bench 上减少。Nemotron-3 30B 显示出规划驱动的 SWE-Bench 轨迹成本最大增幅,轮次、工具调用和输入 token 均大幅上升。对于 Nemotron-3 550B 和 Mistral-Medium-3.5-128B,规划降低了 SWE-Bench 的轮次、工具调用和平均输入 token。在 Terminal-Bench 上,规划减少了 Nemotron-3 120B 和 Mistral-Medium-3.5-128B 的轮次和工具调用,而 Nemotron-3 30B 经历增加。
实验在 SWE-Bench Verified 和 Terminal-Bench 上评估工具配置、规划和上下文管理。结果显示,规划主要减少冗余的编辑后验证,而 bash-only 设置鼓励更少但更大的代码编写或文件替换动作。在两个基准上,上下文管理在紧上下文窗口下对成功率的提升最大,结合省略、召回和摘要的层级提供相当的准确率和最低成本,同时避免溢出失败。规划对轨迹成本的影响依赖模型,一些模型减少了轮次和工具调用,另一些则有所增加。