Command Palette
Search for a command to run...
JEPA-Anything:学习跨越不同世界的预测模型
JEPA-Anything:学习跨越不同世界的预测模型
摘要
世界建模使智能能够预见后果、指导干预并从交互中学习。然而,预测模型仍局限于特定领域:一种通用学习原则能否支持在截然不同的系统上进行世界建模?我们提出了 JEPA-Anything,一个基于正交预测分解(OPF)的领域无关框架。OPF 扩展了联合嵌入预测架构,将潜在目标分解为互补因子,通过专用通路学习它们,并在共享预测设计中将其重新组合。我们在 7 个领域上评估了 JEPA-Anything:视觉、生物学、临床轨迹、控制、分子动力学、物理场和天气。实验涵盖表示学习、干预预测、分布外泛化和长时程动力学,包括 10 个匹配的动力学任务、对 1,000 多个临床事件的预测,以及在 4 个系统上的 100 步分子推演。与匹配的 JEPA 基线相比,JEPA-Anything 在所有 10 个动力学任务上均提升了所报告的指标,并将 Interventional Pong 上的单次干预预测误差降低了 34.8%。在所有 4 个系统中,它的单步和 100 步分子误差在对比方法中均为最低。除预测之外,一种由因子提名的生物干预在细胞共培养、患者来源类器官、肿瘤片段和小鼠中获得了实验支持;潜在轨道模式恢复了开普勒标度指数,拟合斜率为 −1.4991。这些结果支持跨异构世界的通用分解预测原则,将世界建模与干预及有实验依据的科学发现联系起来。
一句话总结
来自 PhAI Labs、香港中文大学、复旦大学等机构的研究人员提出 JEPA-Anything,这是一个基于正交预测分解(OPF)的领域无关框架,它将潜在目标分解为互补因子,通过专门通路学习这些因子,并在共享预测设计中重新组合,在全部 10 个动力学任务上优于匹配的 JEPA 基线,将 Interventional Pong 的单干预预测误差降低 34.8%,并在四个系统中所有比较方法中取得最低的一步和 100 步分子误差。
核心贡献
- 提出了 JEPA-Anything,一个基于正交预测分解(OPF)的领域无关框架,将潜在目标分解为互补因子,通过专门通路学习这些因子,并在共享预测设计中重新组合。
- 在七个领域中评估时,JEPA-Anything 在所有 10 个匹配的动力学任务上改善所报告的指标,将 Interventional Pong 的单干预预测误差降低 34.8%,并在所有四个系统中取得所比较方法中最低的一步和 100 步分子预测误差。
- 结果将因子化预测与基于实验的发现联系起来:由因子提名的生物干预在细胞共培养、患者来源类器官、肿瘤片段和小鼠中获得支持,潜在轨道模式恢复了开普勒标度指数,拟合斜率为 -1.4991。
引言
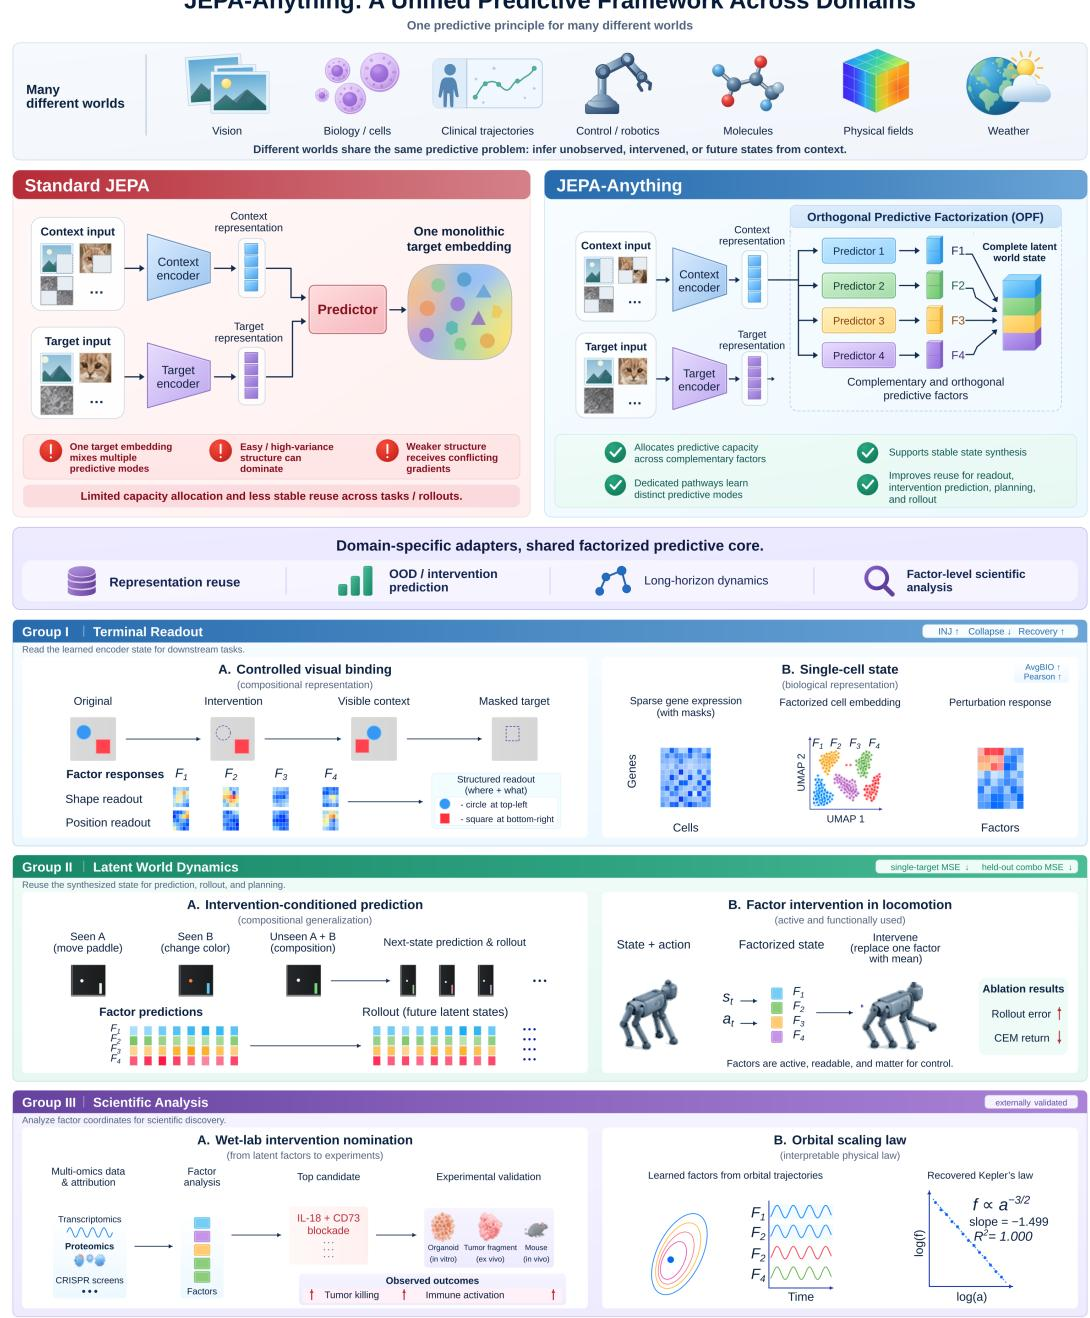
潜在世界模型学习预测状态,使 agent 和科学模型能够在许多领域中预测未来或隐藏状态,从视觉场景和患者病史到分子轨迹和物理场。联合嵌入预测架构通过在潜在空间中预测来支持这一点,但通常的表述将每个目标表示为一个具有单一预测通路的整体嵌入。这种设计可能让高方差或易于预测的结构主导优化,而较弱或互补的预测结构收到冲突梯度,使潜在状态设计变成容量分配问题。作者用 JEPA-Anything 解决这一问题,该框架基于正交预测分解,将每个目标状态分解为多个学习到的因子,并使用专用预测器,采用因子内和因子间正交性以及活动正则化。同一接口应用于视觉、单细胞、纵向健康、控制、分子动力学、物理场、天气和临床系统。
方法
作者利用统一的潜在世界状态接口来标准化跨不同领域的预测学习。领域适配器将原始观测映射为内容 tokens 和结构描述符,而视图采样器选择上下文和目标索引。这建立了一个公共接口,其中适配器和采样器的语义是领域特定的,但随后的预测算法保持相同。
如下图所示:
在线编码器处理上下文 tokens 以生成上下文表示,而目标编码器生成潜在目标表示。目标编码器参数作为在线编码器参数的指数移动平均更新,并且不接收梯度。
为了克服预测整体目标嵌入的局限,作者引入正交预测分解(OPF)。该框架不使用单一预测器,而是使用 K 个学习到的投影器 Pk∈Rd×r,并满足 Kr=d。停止梯度目标表示被分解为 K 个互补子空间:
z~t=sg(zt),zt(k)=Pk⊤z~t,k=1,…,K每个因子分配一个专用预测器 qk,将共享上下文表示和目标描述符映射到 r 维空间:
z^t(k)=qk(zc,st)各因子预测被拼接为单个向量 u^t,并使用分析映射的 Moore-Penrose 伪逆合成为完整潜在状态:
z^t=(P⊤)†u^t其中 P=[P1,…,PK]。当投影器完全正交时,该合成简化为投影因子的简单求和。
训练目标将标准基础损失与 OPF 损失结合。预测损失直接将每个预测因子回归到其目标:
Lpred=K∣T∣r1t∈T∑k=1∑K∥z^t(k)−zt(k)∥22为确保学习到的子空间相互正交并避免退化基,应用正交性损失:
Lorth=k=1∑K∥Pk⊤Pk−Ir∥F2+1≤i<j≤K∑∥Pi⊤Pj∥F2此外,为防止表示坍缩并保持因子活动性,作者引入活动正则化项。这些项惩罚投影目标坐标和在线上下文表示中较低的经验标准差。完整训练损失是领域特定基础损失与加权 OPF 分量之和:
Ltrain(δ)=Lbase(δ)+Lpred+λorthLorth+λfacLfac+λencLenc优化循环迭代地适配观测、采样上下文和目标、计算表示、预测正交因子并更新网络参数。对于下游应用,该框架支持两种不同模式。在表示模式中,保留在线编码器以提取用于任务特定读出的可复用特征,并丢弃预测头。在运行世界模型模式中,保留学习到的投影器和预测器以合成未来潜在状态,从而实现自回归模拟、规划和干预预测。
实验
评估将相同的 JEPA-Anything 核心应用于视觉、生物、临床、控制、分子、物理场和天气系统,并组织为终端读出、递归潜在动力学与规划、以及科学因子分析。终端读出实验在受控视觉绑定、单细胞聚类和扰动预测以及临床事件预测中显示出增益。动力学和 rollout 实验表明干预组合、分布外预测和长时程稳定性得到改善,而连续控制规划在 Walker2d 和 HalfCheetah 上有所改善,但在 Hopper 上没有改善。因子层面分析确认了活跃且可干预的潜在通道,外部湿实验和轨道标度结果支持将学习到的坐标复用于科学验证。
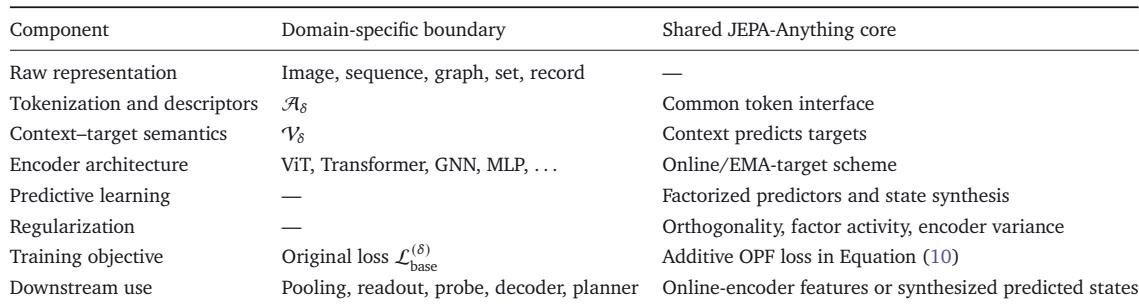
JEPA-Anything 将领域特定的预测状态构建与共享预测核心分离。领域适配器和视图采样器处理原始表示、token 化、上下文-目标语义、编码器架构和原始损失,而核心提供公共 token 接口、带状态合成的因子化预测器以及正交正则化。对生物和轨道领域的分析表明,学习到的因子坐标可以支持外部科学验证。原始表示和编码器架构在图像、序列、图、集合和记录之间有所不同,而预测核心和正则化器保持共享。学习到的因子坐标支持了癌症模型中的湿实验提名干预,并从无标签轨迹数据中恢复了开普勒轨道标度关系。
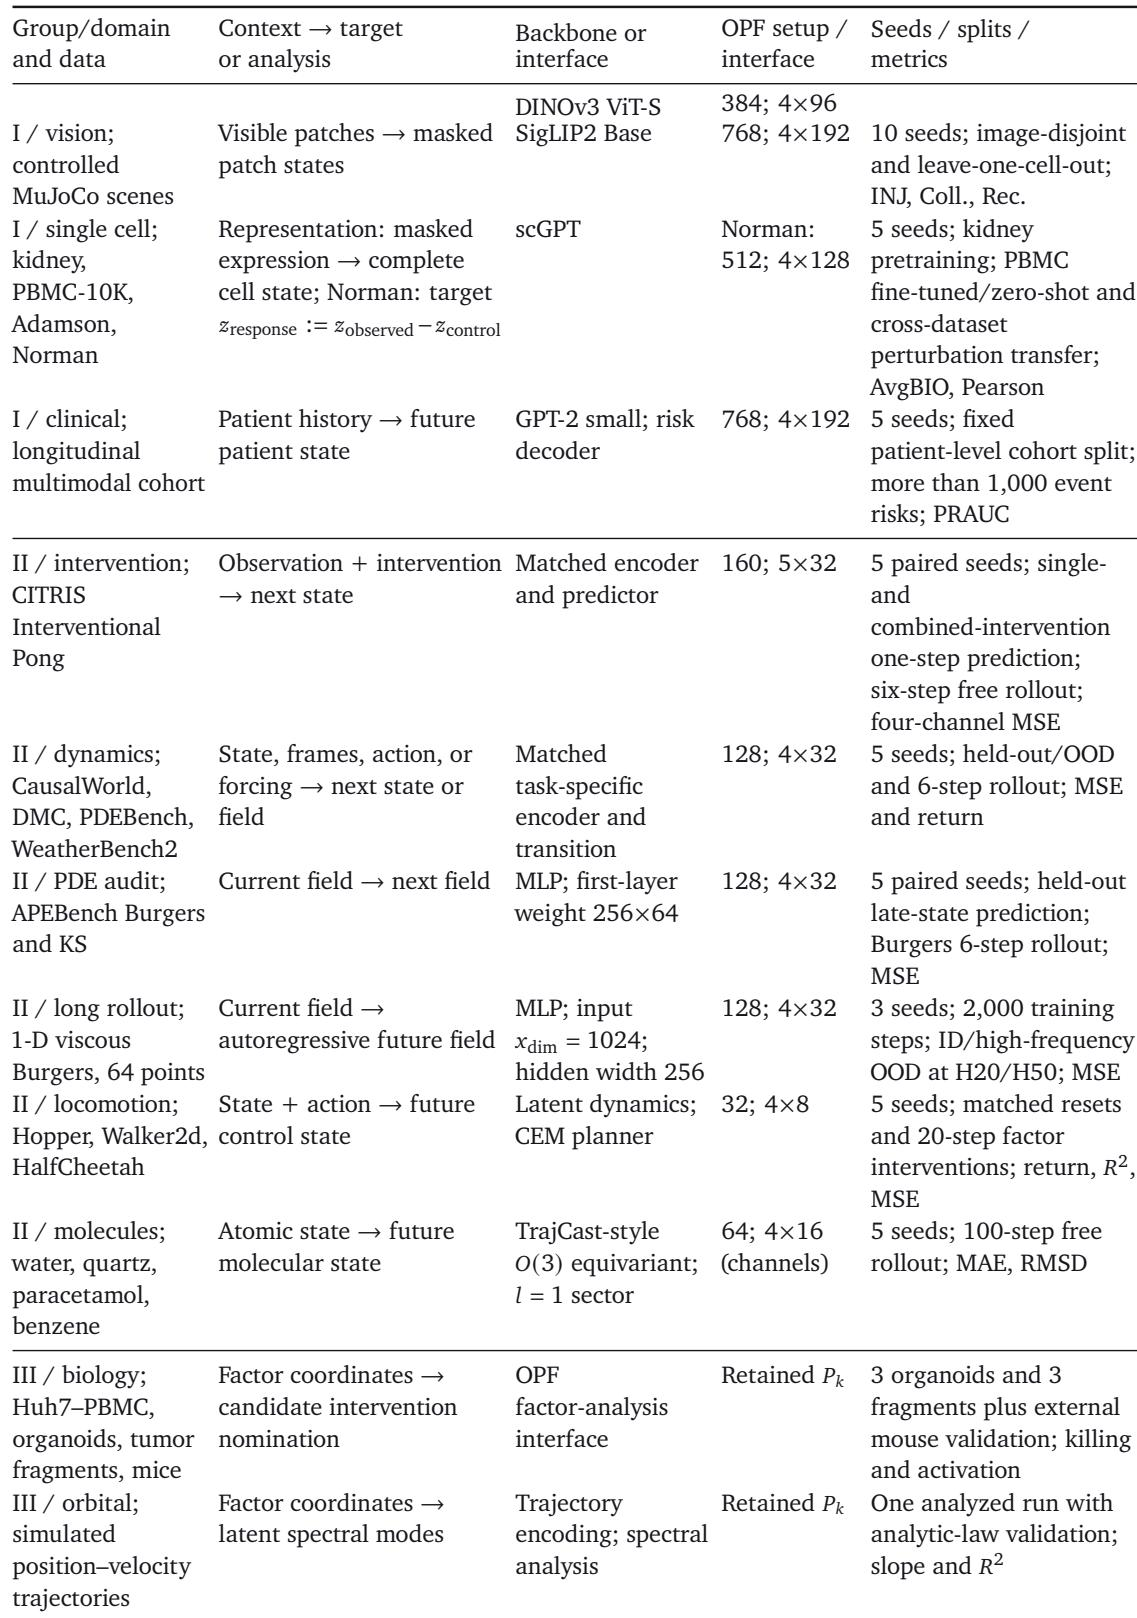
实验在视觉、单细胞、临床、干预、动力学、PDE 和长 rollout 设置中评估共享的正交预测分解接口。定量比较在固定核心建模选择的情况下,与领域及整体 JEPA 基线进行对比,使用领域特定指标,并在多次种子和留出或分布外划分上进行评估。因子层面分析将学习到的坐标与外部生物学和物理验证联系起来。终端读出实验报告了基于 OPF 公式更强的视觉、细胞和疾病状态指标。干预和动力学基准支持组合干预预测、分布外预测和重复多步 rollout。学习到的因子坐标不重叠且条件数接近单位值,并具有接近精确的合成。因子层面分析提名了 IL-18 加 NT5E/CD73 阻断干预,湿实验研究支持该干预,并从模拟轨迹中恢复了开普勒轨道标度关系。
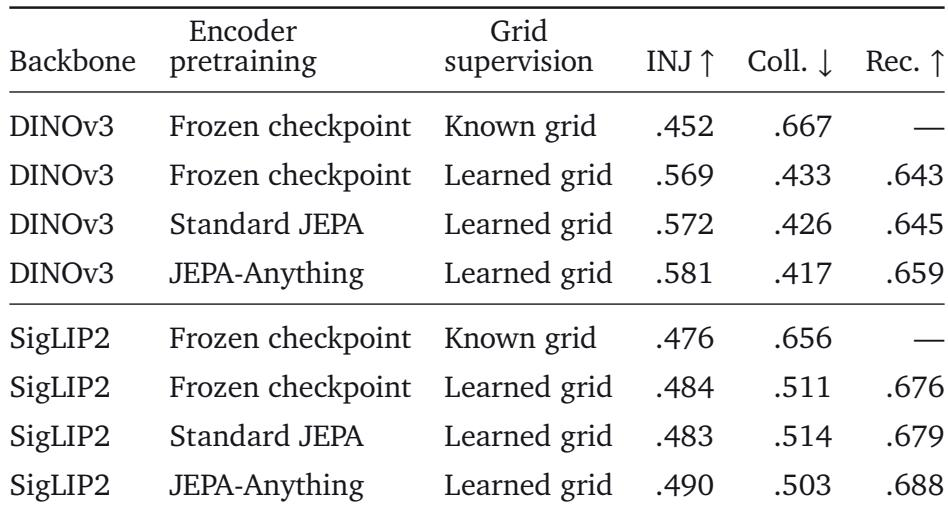
在受控 MuJoCo 视觉绑定中,使用学习到的网格读出可改善两个冻结编码器主干的干预和碰撞指标,同时支持重建。DINOv3 进一步受益于 JEPA 风格编码器预训练,其中 JEPA-Anything 获得了所报告的最佳干预和碰撞结果。SigLIP2 的冻结检查点增益较小,其标准 JEPA 变体与学习网格冻结设置表现相似。对于冻结的 DINOv3 和 SigLIP2 主干,学习网格监督相比已知网格监督改善了碰撞指标。DINOv3 搭配 JEPA-Anything 和学习网格在所报告比较中实现了最强的组合干预和碰撞性能。对于 SigLIP2,标准 JEPA 预训练与冻结的学习网格读出相当,而没有带来较大的额外增益。
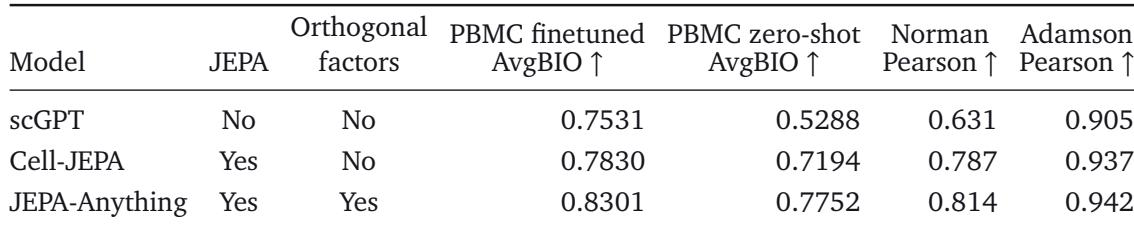
评估比较了 scGPT、Cell-JEPA 和 JEPA-Anything 在 PBMC 细胞类型聚类和扰动响应预测上的表现。Cell-JEPA 在所有报告指标上均优于 scGPT,其中零样本 PBMC 聚类和 Norman 扰动预测的提升尤其大。JEPA-Anything 加入正交分解,并在两个聚类指标和两个扰动数据集上均取得最高分数。JEPA-Anything 在 PBMC 微调聚类、PBMC 零样本聚类、Norman 扰动预测和 Adamson 扰动预测上均达到最高值。Cell-JEPA 在每个报告指标上均优于 scGPT,其中零样本 PBMC 聚类和 Norman 扰动预测增益最大。向 Cell-JEPA 添加正交因子进一步改善了聚类质量和扰动响应预测。
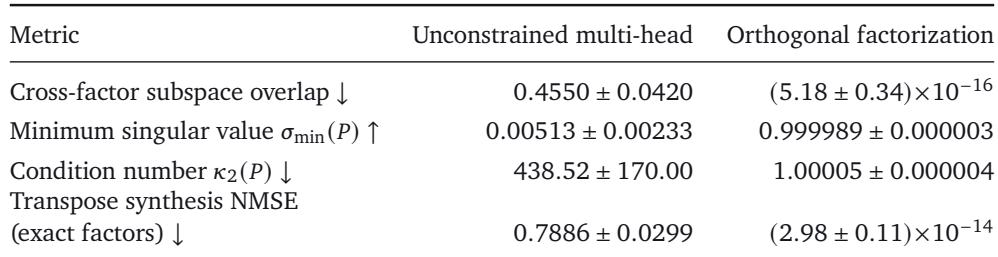
对 CITRIS Interventional Pong 上因子接口的审计表明,正交分解产生的因子子空间具有可忽略的重叠、接近单位的最小奇异值和接近单位的条件数,而未约束的多头因子则大量重叠且条件较差。正交分解还将转置合成 NMSE 降低多个数量级,表明从精确因子进行接近精确的重建。正交分解将跨因子子空间重叠降至接近机器精度,而未约束多头因子仍保持大量重叠。在正交分解下,投影矩阵条件良好,最小奇异值和条件数接近一;未约束多头则条件较差,最小奇异值低得多。从精确因子进行的转置合成在正交分解下接近精确,而未约束多头则出现高重建误差。
实验在视觉绑定、单细胞、临床、干预、动力学、PDE 和长 rollout 设置中评估共享的正交预测分解接口,并在留出和分布外评估下比较 JEPA-Anything 与领域特定及整体 JEPA 基线。视觉绑定结果显示,学习网格读出和 JEPA 风格预训练改善了干预和碰撞性能,其中 JEPA-Anything 获得了最强的组合结果。在生物和因子审计设置中,正交分解改善了聚类和扰动预测,同时产生不重叠、条件良好且接近精确的因子合成。因子层面分析将学习到的坐标与外部验证联系起来,包括获得湿实验支持的癌症干预以及从无标签轨迹中恢复的开普勒轨道标度关系。