Command Palette
Search for a command to run...
SoL-Pi:递归扩展自动研究循环以实现高效 Agent 执行框架
SoL-Pi:递归扩展自动研究循环以实现高效 Agent 执行框架
摘要
随着编码智能体从有监督的代码补全走向无人值守的全天候探索,其工作从孤立的预测扩展为推理、工具使用和反馈的长轨迹。因此,令牌效率对于扩展递归自我改进变得重要。我们采用一种受 RSI 启发的方法,在 Agent 执行框架层扩展自动研究循环,以在数量越来越多、种类越来越丰富的环境中进行执行框架 rollout。在此规模下,该过程会产生可复用的改进,这些改进可迁移到其开发环境之外,推动自动化执行框架发现走向生产级成果。四个机制经过选择保留下来并构成 SoL-Pi,涵盖动作执行、上下文压缩、观察处理和委托阅读。在 51 个任务的 EdgeBench 评估中,SoL-Pi 在 GPT-5.6 Sol 和 Opus 5 上取得了与 Pi 相当的性能,同时将记录的令牌流量减少 44.7%–49.0%,并将 API 成本降低约三分之一。换言之,相对于原生 Codex 和 Claude Code 执行框架,估计每小时可节省 8.75–13.50;相对于 Pi,可节省 4.36–5.71。
一句话总结
NVIDIA、NTU 和 MIT 提出 SoL-Pi,这是一个递归扩展的自动研究框架,提炼出四个经过筛选保留的机制,涵盖动作执行、上下文压缩、观测处理和委托读取,在 51 项 EdgeBench 评估中,在 GPT-5.6 Sol 和 Opus 5 上达到与 Pi 相当的性能,同时将记录的 token 流量降低 44.7% 至 49.0%,并将 API 成本降低约三分之一。
核心贡献
- 提出 SoL-Pi,这是一个自动化的框架层搜索系统,在保持底层模型固定的同时,发现跨动作执行、上下文压缩、观测处理和委托读取的可复用效率机制。
- 在 51 项 EdgeBench 评估中,SoL-Pi 在 GPT-5.6 Sol 和 Opus 5 上达到与 Pi 相当的性能,同时将记录的 token 流量降低 44.7% 至 49.0%,并将 API 成本降低约三分之一。
- 最佳候选机制将模型性能提高 5.3% 至 12.8%,将 token 效率提高 9.8% 至 18.2%;相对于原生 Codex 和 Claude Code 框架,预计每小时节省 8.75 至 13.50 美元;相对于 Pi,预计每小时节省 4.36 至 5.71 美元。
引言
基础模型现在支持越来越开放、长周期的 agent,用于自主研究、软件工程和早期递归自我改进,因此任务级 token 效率成为首要关注点。此前的效率工作主要通过基础设施、压缩或更便宜的模型来降低每个 token 的成本,而自动化的框架级优化仍然困难,因为工具使用、上下文管理、验证、委托、恢复和终止紧密耦合,并且演化出的框架可能对其搜索任务过拟合。作者提出 SoL-Pi,这是一个受 RSI 启发的自动研究系统,通过从宽到深的漏斗搜索框架改进,在留出验证之前冻结候选机制,并通过隔离谱系进行扩展。SoL-Pi 发现了四种可迁移到开发任务之外的机制,在 EdgeBench 上跨 GPT-5.6 Sol 和 Opus 5 保持性能,同时将记录的 token 流量降低 44.7% 至 49.0%,并将 API 成本降低约三分之一。
数据集
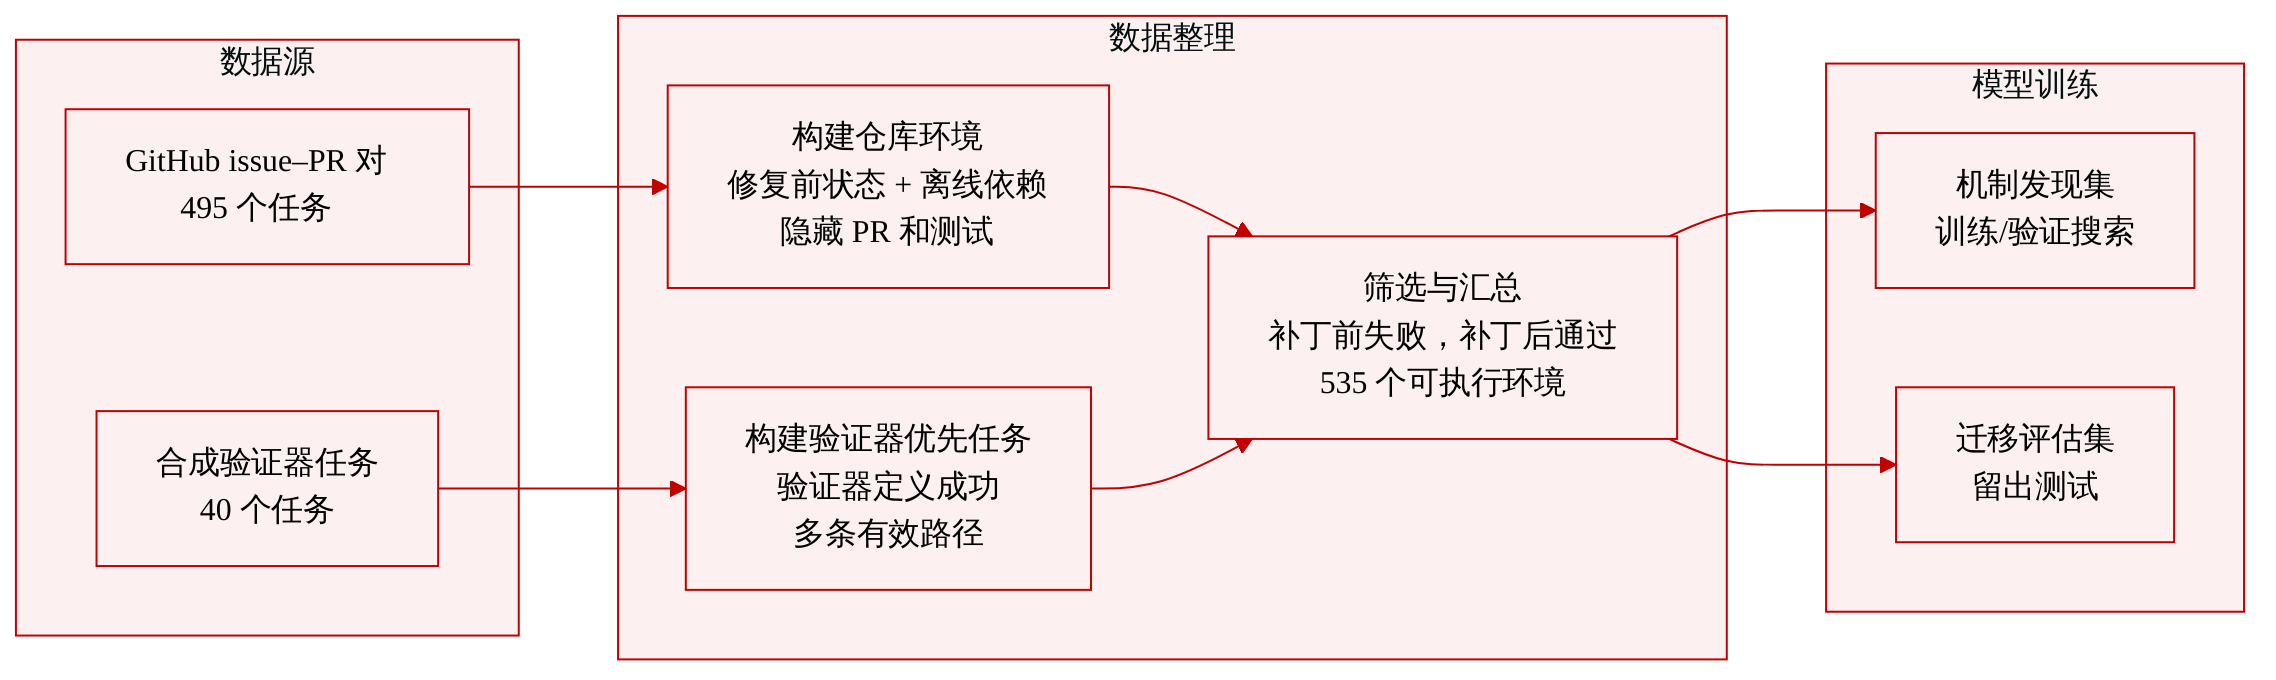
作者使用两类搜索环境,共 535 个可执行环境。
-
来源与构成:
- 仓库衍生任务:495 个环境,由 GitHub issue 和 pull request 对构建。
- 验证器驱动的合成任务:40 个环境,带有可执行的成功验证器,大多数使用 Terminal-Bench-2 风格接口。
-
仓库衍生处理:
- 每个环境将 GitHub issue 与修复前的仓库状态和离线依赖配对。
- 已接受的补丁和变更历史作为参考轨迹。
- pull request 和回归测试对 agent 隐藏。
- 仅保留补丁前测试失败、补丁后测试通过的环境。
-
验证器驱动处理:
- 先确定可执行验证器以定义成功,然后围绕它构建任务环境。
- 这支持多条有效求解路径,而无需参考轨迹。
-
用途:
- 搜索管线使用相互独立的环境进行机制发现和迁移评估。
- 这些环境支持基于软件变更和开放式问题求解的自动评估搜索。
- 构建路径以及机制搜索与留出评估之间的隔离边界在图 3 中总结。
方法
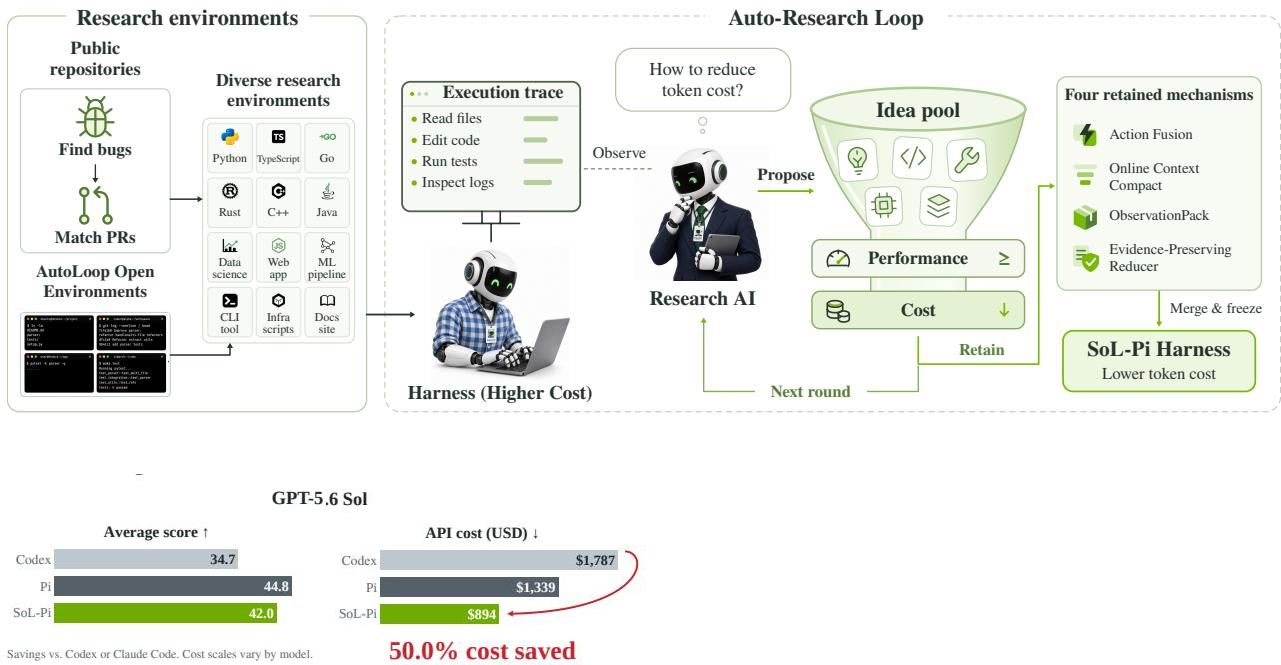
作者提出 SoL-Pi,这是一个旨在通过自动化、受递归自我改进启发的搜索过程,发现可迁移的框架改进以提高 token 效率的系统。该框架不依赖人工检查执行轨迹,而是使用一个研究 agent 分析来自基础框架的轨迹,识别反复出现的开销来源,并提出候选机制加以解决。
整体工作流按照从宽到深的漏斗方式运行。研究 agent 观察来自较高成本框架的执行轨迹,提出降低 token 成本的变更,并根据固定的能力指标和效率指标测试这些候选机制。候选机制必须提高效率,同时将能力指标保持在预先声明的容差范围内。系统严格将这些优化指标与 agent 的控制隔离开,以防止操纵接受标准。成功的机制会合并到最终的 SoL-Pi 框架中,然后在 EdgeBench 等留出数据集上进行评估,以确保泛化性。
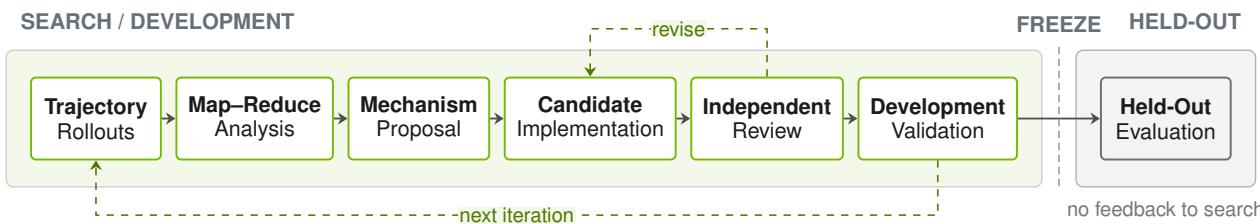
搜索管线分两个阶段分配工作:外层阶段探索广泛的假设池,内层阶段独立开发选定的假设。如工作流图所示,该过程从轨迹展开和 map-reduce 分析开始,以识别可避免的工作。这为机制提案和候选实现提供依据。迭代实现循环扩展了标准的自动研究周期;实现者根据明确的完成标准完善候选机制,然后进行独立评审。评审失败会触发修订。关键的是,开发反馈循环与留出评估严格分离。框架和接受规则在对任何留出数据进行评估之前就已冻结,确保留出结果不会反馈回搜索循环而导致过拟合。
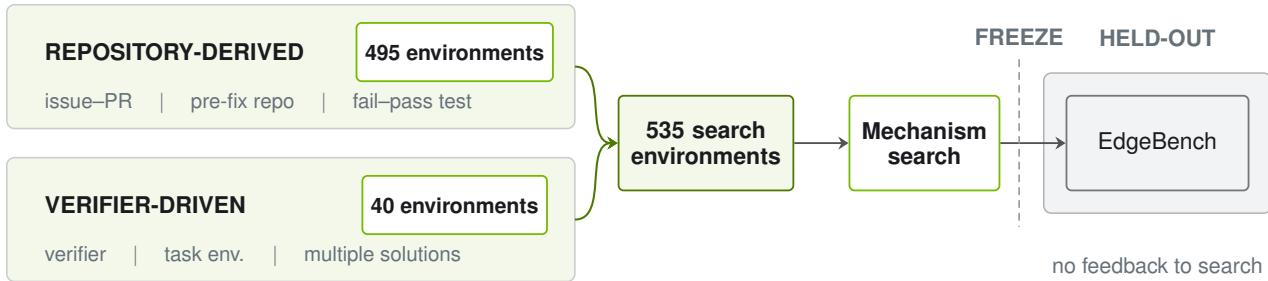
为支持这一搜索,作者使用了一组多样化的 535 个可执行环境,与留出的 EdgeBench 不同。这些搜索环境分为两类。仓库衍生环境将 GitHub issue 与修复前的仓库状态和隐藏回归测试配对,仅保留补丁前测试失败、补丁后测试通过的任务。验证器驱动环境使用可执行的成功验证器来定义任务,允许存在多条有效求解路径,而无需参考轨迹。这种设置使搜索建立在真实软件变更和开放式问题求解的基础上,同时为最终验证保持严格的隔离边界。
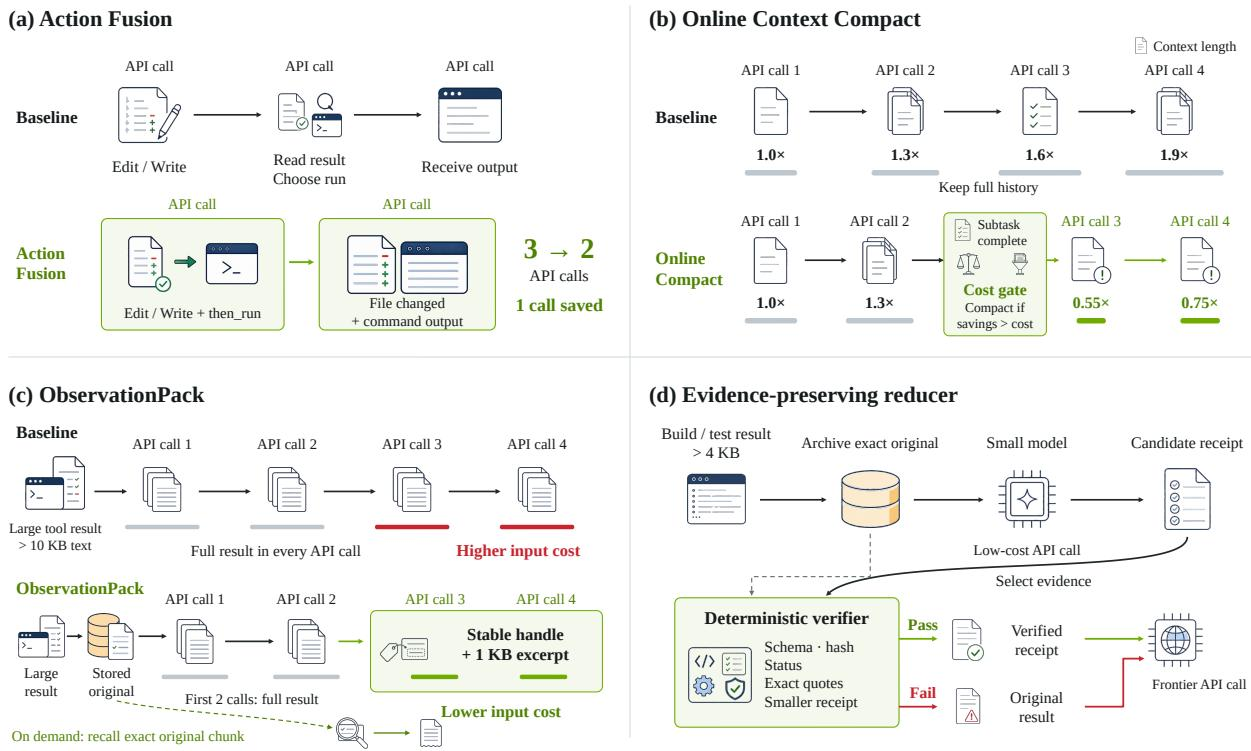
搜索过程产生了四种通过能力约束选择的、可复用的机制,每种机制作用于 agent 与环境循环的不同阶段,以减少冗余工作。Action Fusion 将文件修改与其后续命令合并到单次工具请求中,从而消除一次中间模型往返。Online Context Compact 利用计划步骤完成情况来重新考虑上下文压缩,仅在预计的输入节省超过重写提示缓存的估计成本时才调用它。ObservationPack 针对大型工具输出,在本地归档超过 10 KiB 的结果;前两次请求会完整发送这些结果,之后替换为稳定句柄和简短摘要,并允许按需取回。最后,Evidence-Preserving Reducer 使用成本较低的模型压缩构建和测试日志,将关键证据提取为紧凑的收据。确定性验证器检查收据的完整性;如果验证失败或收据未带来体积缩减,则回退到原始日志。这些机制互补地降低 token 流量,同时保留 agent 完成任务所需的信息。
实验
评估在 EdgeBench、Terminal-Bench 4、IMO 2026 和一个内核优化 swarm 上,将 SoL-Pi 与原生基线及 Pi 基线进行比较,使用 GPT-5.6 Sol,并测试向 Opus 5 的迁移。SoL-Pi 始终降低 token 流量、API 成本和每个已解决任务的成本,同时保持或提高整体任务性能,并且这些效率收益可迁移到未见过的后端,并泛化到原始基准之外。在多 agent 内核优化设置中,相同预算下 SoL-Pi worker 的结果也优于 Pi worker,这表明框架效率可以改善集体探索。消融和谱系分析表明,每种学习到的机制都能减少 token 使用量,机制之间互补地相互作用,并且自动研究循环可以稳定并保留诸如 Action Fusion 之类的机制。
在 EdgeBench 上列出的 GPT-5.6 Sol 框架中,Oh-My-Opencode 提供了最高平均得分,而 OpenSquilla 提供了最低 token 流量、最低 token 成本和最佳 token 效率。平均得分和 token 效率在各个框架之间并不一致:OpenCode 记录了最高的 token 成本和最弱的 token 效率,但平均得分处于中等水平。官方 GPT-5.5 检查点报告的平均得分为 31.2,但没有 token 流量或成本数据。Oh-My-Opencode 在列出的 GPT-5.6 Sol 框架中实现了最高平均得分(38.523),超过官方 GPT-5.5 检查点的 31.2 分。OpenSquilla 在列出的 GPT-5.6 Sol 行中具有最低的总 token 流量、最低的 token 成本和最佳的 token 效率,但平均得分也最低。
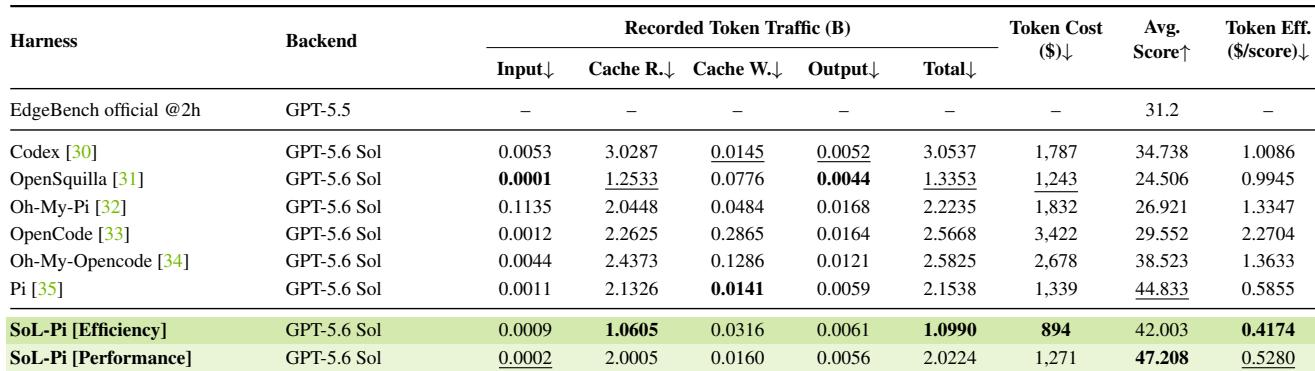
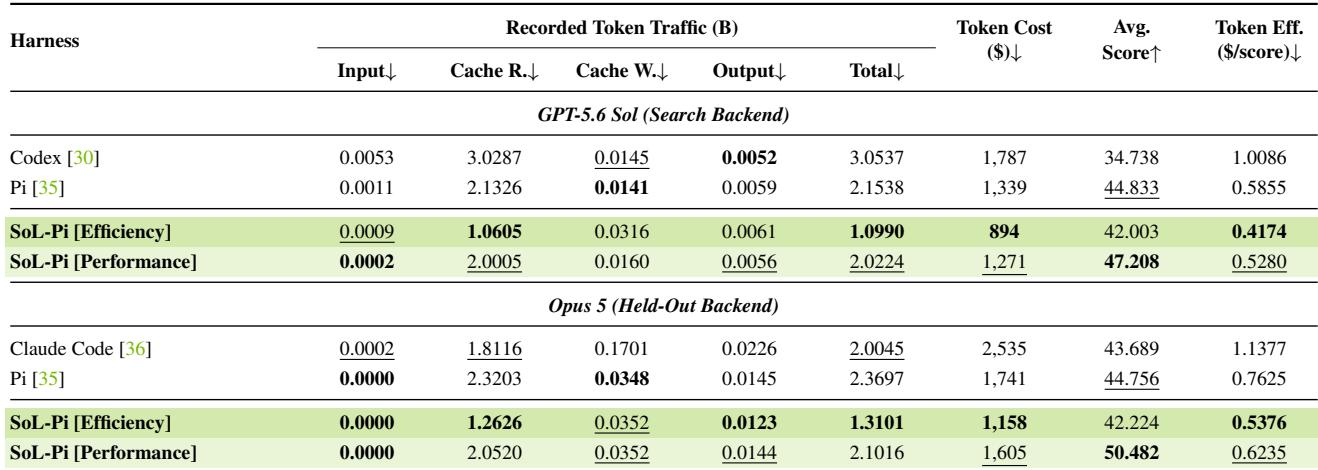
在公开 EdgeBench 任务上,以效率为导向的 SoL-Pi 配置相对于 Pi 大幅降低了总 token 流量和 token 成本,同时保留了 Pi 的大部分平均得分。以性能为导向的配置在 GPT-5.6 Sol 块中实现了最高平均得分,并且相对于 Pi 仍然降低了 token 流量和成本。该方法还能迁移到未见的 Opus 5 后端,无需进一步搜索或适配,在保留 Pi 大部分得分的同时大幅节省 token 和 API 成本。SoL-Pi Efficiency 相对于 Pi 将总 token 流量几乎减半,并大幅降低 token 成本,同时保留 Pi 平均得分的 93.7%。SoL-Pi Performance 在 GPT-5.6 Sol 配置中获得了最高平均得分,比 Pi 提高 5.3%,同时仍降低 token 流量和 token 成本。
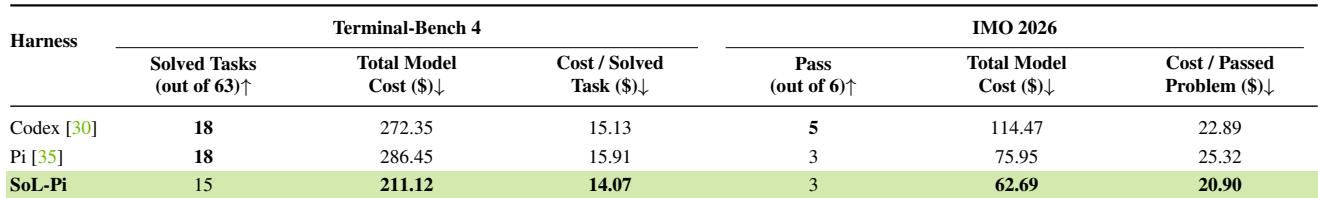
在 Terminal-Bench 4 和 IMO 2026 上,没有任何单一框架能在已解决任务数和成本两方面同时占优。Codex 和 Pi 解决了最多的 Terminal-Bench 4 任务,而 SoL-Pi 尽管解决的任务较少,但总成本和每任务成本最低。在 IMO 2026 上,Codex 通过的题目最多,而 SoL-Pi 与 Pi 的通过数量持平,且总成本和每道题成本最低。在 Terminal-Bench 4 上,相对于 Codex 和 Pi,SoL-Pi 降低了总模型成本和每个已解决任务的成本,同时少解决了三个任务。在 IMO 2026 上,SoL-Pi 和 Pi 均通过了三道题,但 SoL-Pi 实现了更低的总成本和更低的每通过题成本。Codex 在 IMO 2026 上通过题数最高,为五道,但在比较的框架中总模型成本也最高。
在 EdgeBench 上进行的逐项添加评估表明,将每种学习到的机制添加到 Pi 时,都会减少总 token 流量,尽管对得分的影响因机制而异。在 GPT-5.6 Sol 下,ObservationPack 在单机制变体中实现了最高平均得分,而完整组合实现了最低 token 数量和成本,同时保留了 Pi 的大部分得分。所有单机制配置相对于基线还降低了单位得分成本。添加任意单一机制都会减少总 token 流量,并且所有单机制配置相对于 Pi 基线都改善了单位得分成本。在 GPT-5.6 Sol 下,ObservationPack 在单机制变体中给出了最高平均得分,并被选为以性能为导向的配置。完整组合在各个后端上实现了最低的总 token 数量和成本,同时保留了 Pi 的大部分平均得分。完整组合以较低的缓存读取流量换取缓存写入流量的适度增加,但总模型成本仍然下降。
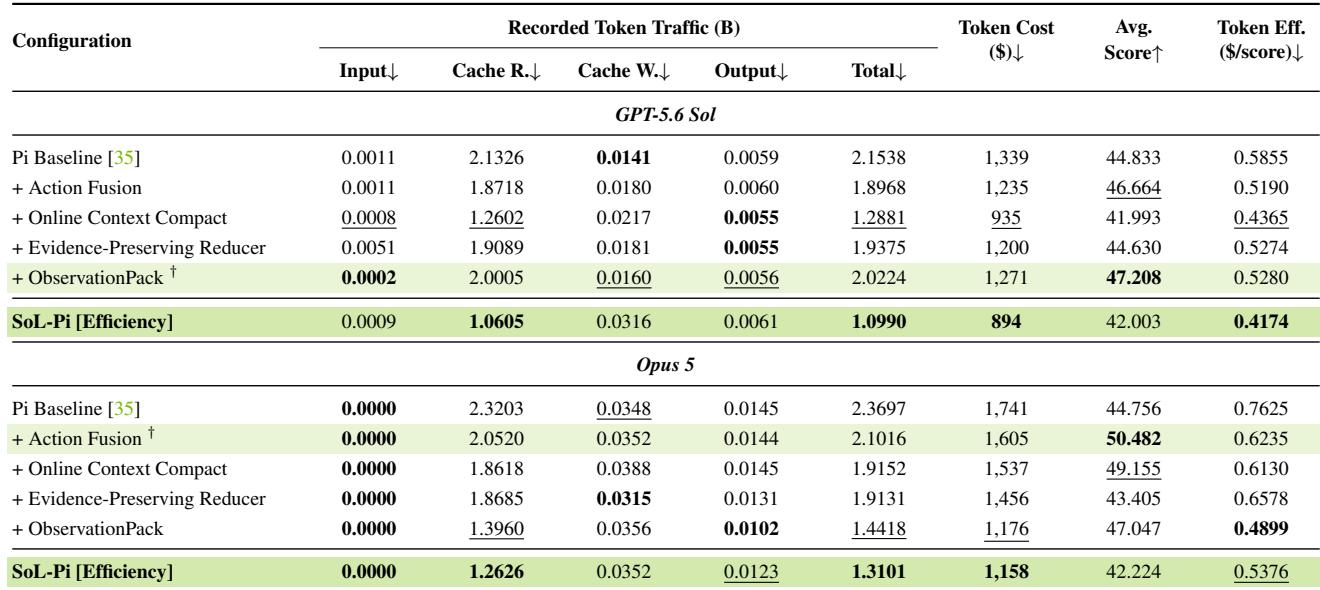
实验在 EdgeBench、Terminal-Bench 4 和 IMO 2026 上评估了各种框架变体,重点关注任务得分、token 流量和模型成本。在 EdgeBench 上,现有框架表明平均得分和 token 效率并不一致,而提出的 SoL-Pi 配置要么以大幅节省 token 和成本的方式获得接近 Pi 的得分,要么在成本仍降低的情况下获得最高得分,并且该方法可迁移到未见的 Opus 5 后端。在 Terminal-Bench 4 和 IMO 2026 上,没有任何单一框架能在已解决任务数和成本两方面同时占优,但 SoL-Pi 相对于 Codex 和 Pi,在求解数量相当或更少的情况下,始终降低总成本和每任务成本。消融实验表明,每种学习到的机制都能减少 token 流量并改善单位得分成本,其中 ObservationPack 在单机制得分方面最强,完整组合则将 token 数量和成本降至最低。