Command Palette
Search for a command to run...
当 EOS token 不一致时:理解同策略蒸馏中的长度膨胀
当 EOS token 不一致时:理解同策略蒸馏中的长度膨胀
Yuxiao Yang Tianrun Yu Shangzhe Li Kaixiang Zhao Xuchao Zhang Chetan Bansal Huaxiu Yao Taylor W. Killian Weitong Zhang
摘要
我们研究了同策略蒸馏(OPD)中的长度膨胀问题,即学生响应可能变得过长,甚至耗尽生成预算。我们发现,基础学生模型与后训练教师模型之间的终止 token 不匹配是这一行为的重要来源。在 Qwen3、Llama 和 Gemma 上,两个模型可能将停止概率放在不同的 EOS token 上,即使它们声明的停止集合完全相同。这种不匹配可能抑制学生模型偏好的终止动作,却无法可靠地迁移教师模型偏好的替代动作。我们表明,仅对齐解码停止集合是不够的;而将功能等价的 EOS token 视为一种共享的语义停止动作,能显著缓解所有三个模型家族中由不匹配引起的长度膨胀。为进一步理解终止行为在训练过程中如何演变,我们研究了跨不同 K2-Horizon 训练阶段的 OPD。这一分阶段分析表明,终止偏好会在训练期间发生显著变化,同时揭示了 OPD 运行后期出现的一种明显长度膨胀,该膨胀在终止对齐之后仍然存在。综上,这些结果表明终止不匹配是 OPD 长度动态的一个重要但并非唯一的来源。我们发布了包含所提出的终止处理修正的实现。
一句话总结
北卡罗来纳大学教堂山分校、杨百翰大学和微软的研究人员表明,基础学生模型与后训练教师模型之间的终止 token 不匹配会在 Qwen3、Llama 和 Gemma 的在线策略蒸馏中导致长度膨胀;他们提出将功能上等价的 EOS token 视为共享的语义停止动作,这显著缓解了这种由不匹配引起的膨胀,而按阶段进行的 K2-Horizon 分析揭示了额外的训练后期长度动态。
核心贡献
- 本文指出,基础学生模型与后训练教师模型之间的终止 token 不匹配是在线策略蒸馏中长度膨胀的一个关键来源,并在 Qwen3、Llama 和 Gemma 上表明,即使模型声明的停止集合相同,它们也可能偏好不同的 EOS token,这会抑制学生偏好的终止动作,却无法可靠迁移教师偏好的替代动作。
- 本文证明,仅对齐解码停止集合是不够的,而将功能上等价的 EOS token 视为共享的语义停止动作,能够在所有三个模型家族中显著缓解由不匹配引起的长度膨胀。
- 本文对 K2-Horizon 训练阶段中的在线策略蒸馏进行了分阶段分析,表明终止偏好可能在训练期间发生显著变化,并且一种独特的训练后期长度膨胀在终止对齐后仍然存在;本文还发布了包含所提议终止处理修正的实现。
引言
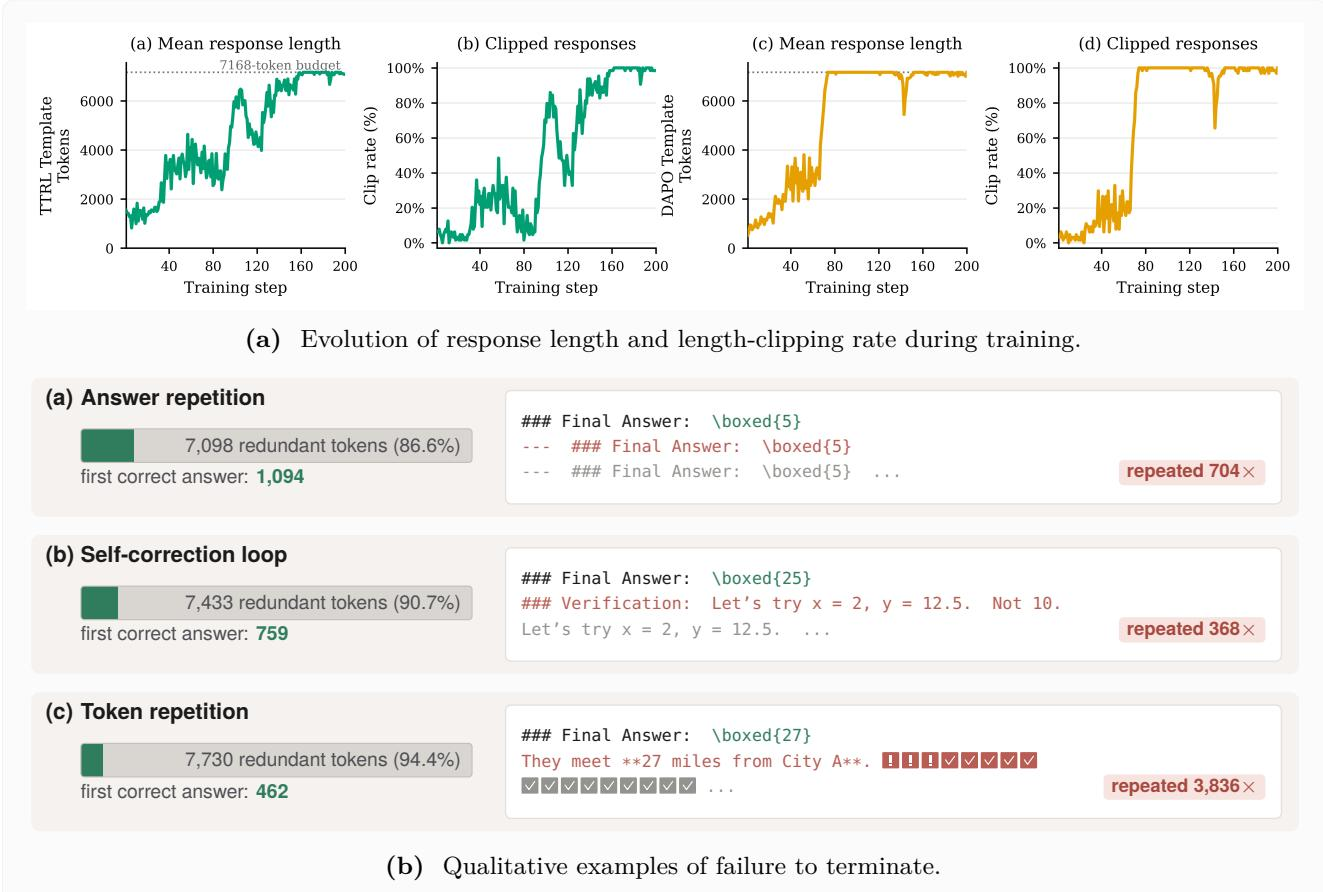
在线策略蒸馏(OPD)让学生在自身采样的 rollout 上训练,并使用来自后训练教师模型的密集 token 级监督,这为将强行为迁移到更小或能力较弱的模型提供了一种实用方式。然而,OPD 通常会产生越来越长的响应,并伴有截断或重复;先前工作将这种长度膨胀归因于目标层面的效应、rollout 退化或训练不稳定。作者将终止 token 不匹配识别为可直接诊断的原因:基础学生模型与后训练教师模型即使声明的停止集合相同,也可能用不同的 EOS token 编码相同的语义停止决策。由于教师只评估学生生成的 token,学生自身的终止动作可能被抑制。作者表明,仅对齐解码停止集合是不够的,而将功能上等价的 EOS token 视为共享的语义停止动作,能够在 Qwen3、Llama 和 Gemma 上显著缓解由不匹配引起的长度膨胀。
方法
作者指出,仅修改解码接口不足以解决蒸馏中的终止不匹配问题。不匹配必须在蒸馏信号内部得到修正,方法是协调教师模型与学生模型的终止概率。令 EEOS 表示 rollout 协议下的终止等价 token,并令 e⋆∈EEOS 为基础学生模型支持的规范 EOS token。为此,作者提出了三种概率层面的对齐修正。
第一项修正是教师侧 EOS 映射,它将教师分配给所有终止等价 token 的概率质量映射到规范的学生 EOS token。其公式为:
πE(e⋆∣st)=e∈EEOS∑πE(e∣st)实际实现中,为了数值稳定性,其他 EOS token 上会保留可忽略的概率,同时调整规范 token 的概率以保持总质量不变。学生分布保持不变,rollout 仅在 e⋆ 上终止。
第二项修正是语义 EOS 类,它将 EEOS 中的所有 token 视为单一语义动作 STOP 的实现,而不是选择一个规范的表层 token。对于任意策略 π∈{πθ,πE},聚合概率定义为:
πˉ(STOP∣st)=e∈EEOS∑π(e∣st)而对于非 EOS token,πˉ(a∣st)=π(a∣st)。如果采样得到的 token yt 是 EOS token,则将其替换为 yˉt=STOP。然后直接应用标准的采样 token OPD 更新:
At=logπˉE(yˉt∣st)−logπˉθ(yˉt∣st),gt=At∇θlogπˉθ(yˉt∣st)这确保 EOS 样本通过总终止概率被监督,而不改变非 EOS token。
第三项修正是规范单一 EOS 动作空间,它将教师的 EOS 概率质量映射到 e⋆,并从学生采样分布中移除 EEOS 中的所有其他 token,重新归一化剩余概率。这创建了一个具有单一规范终止动作的一致动作空间。
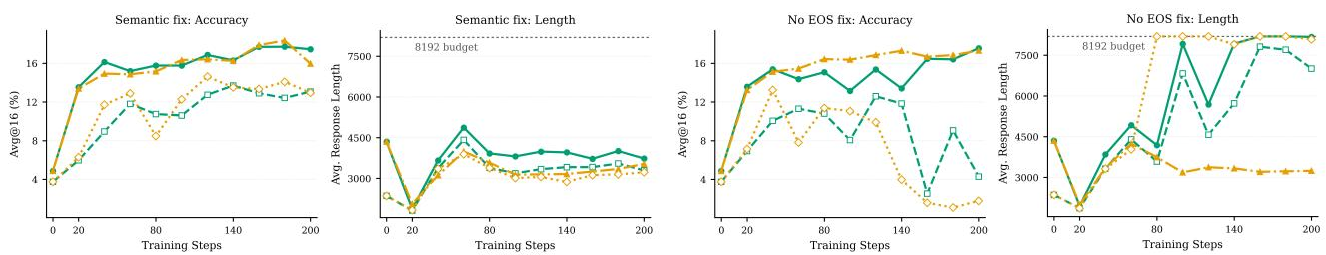
作者指出,这三种修正在经验上产生了类似的结果。教师侧 EOS 映射适用于显式的、已知的不匹配,因为它仅修改教师分布。然而,语义 EOS 聚合被用作跨模型家族实验的默认方法,因为它避免指定规范表层形式的要求,能够适应声明相同 EOS 集合但偏好不同 token 的模型。
共享的终止失败与其对测得任务性能的影响是不同的。跨模板评估可以缩短观测到的响应长度,并且尽管存在严重长度膨胀,OPD 带来的性能提升仍可能持续,尤其是在特定评估模板下。对准确率的表观影响还取决于评分器,因为某些评估风格对冗长冗余的续写更敏感。因此,长度膨胀并不一定意味着推理能力出现同等程度的损失。
如下图所示:
实验
实验在 Qwen3、Llama 3.2、Gemma 3 和 K2-Horizon 的基础学生模型与后训练或指令教师模型之间,评估单轮数学推理任务上的采样 token 在线策略蒸馏。结果表明,即使解码停止集合已对齐,当教师和学生在不同等价 EOS token 之间分配终止概率时,仍会出现长度膨胀和截断;而语义 EOS 聚合等概率层面的修正能够在多个模型家族中显著缓解这种不匹配。分阶段 K2-Horizon 运行表明,当学生已为教师偏好的终止 token 提供足够采样支持时,普通蒸馏可以迁移该 token,但即使经过修正,后续的再次膨胀和其他残余长度动态仍然存在。模板和评分器比较进一步表明,长度膨胀的严重程度取决于评估上下文,而部分下游性能提升仍可迁移。
所研究的模型家族在不同训练阶段声明的 EOS token 配置有所不同。Qwen 和 Llama 的基础检查点声明单个文本结束 token,而其后训练检查点还识别额外的对话终止 token。Gemma 和 K2-Horizon 展示了声明停止集合在各阶段间共享的情况,因此终止不匹配可能通过学到的偏好持续存在,而不仅仅是解码配置所致。后训练的 Qwen 和 Llama 检查点除了基础检查点使用的单个文本结束 token 外,还声明了额外的对话终止 token。Gemma 和 K2-Horizon 在比较的各阶段间保持声明的停止 token 一致,但学到的终止偏好仍可能发生分化。
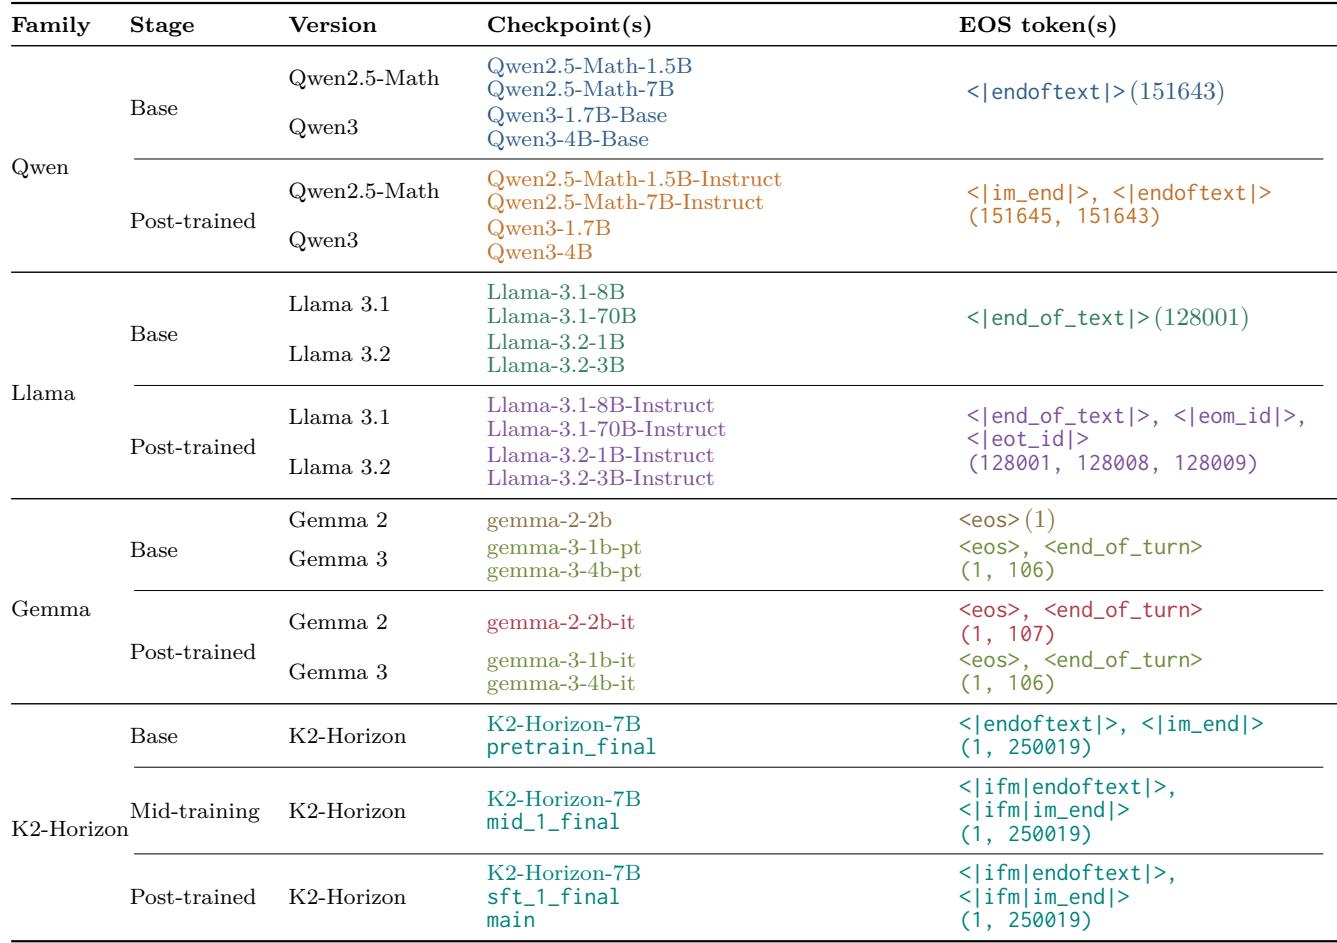
评估检查了 Qwen、Llama、Gemma 和 K2-Horizon 的基础及后训练检查点中声明的文本结束 token 配置。Qwen 和 Llama 基础模型声明单个文本结束 token,而后训练版本增加了对话终止 token,形成了配置层面的变化。Gemma 和 K2-Horizon 在各阶段间保持声明的停止 token 一致,但学到的终止偏好仍可能不同,这表明停止不匹配可能来自训练行为,而不仅仅是解码设置。