Command Palette
Search for a command to run...
ScienceIDE:将全球科学代码库转化为智能体可学习环境
ScienceIDE:将全球科学代码库转化为智能体可学习环境
摘要
科学代码库以可执行的模型、方法和工具形式编码了数十年来的人类知识。然而,碎片化的工具链、隐含的领域惯例以及专门化的正确性标准,使得这些知识难以转化为可靠的学习体验——我们将这一挑战称为科学体验瓶颈。我们提出 ScienceIDE,这是一种基础设施,旨在将全球科学代码转化为可供科学智能体使用的可编程环境。在专家定义的科学案例和验收标准的指导下,智能体将代码库转化为支持任务生成、执行和科学验证的可执行环境。这些环境为监督微调、强化学习和评估提供了共享基础。利用经过验证的交互轨迹,我们训练了 PhAI-IDE-72B、PhAI-IDE-9B 和 PhAI-IDE-4B。该模型系列在保留的科学代码修复任务以及选定的通用基准测试(涵盖代码、推理和知识)上均表现出性能提升,为科学经验向更广泛能力的正迁移提供了证据。ScienceIDE 为智能体学习和科学实践的集成工作区奠定了基础,将人类的科学软件作为发展科学智能的共享基础。
一句话总结
ScienceIDE 由 PhAI-Labs 和 Qwen 提出,将科学代码仓库转换为可编程、可被 agent 学习的环境,支持任务生成、执行和科学验证,并产出 PhAI-IDE-72B、PhAI-IDE-9B 和 PhAI-IDE-4B 模型。这些模型在留出的科学代码修复任务和部分通用基准测试上均取得提升,为科学经验向更广泛能力的正迁移提供了证据,并为共享科学智能奠定了基础。
核心贡献
- 提出 ScienceIDE,一种将专家定义的科学案例和验收标准转换为可执行的科学 agent 环境的基础设施,能够从现有科学代码仓库中实现任务生成、执行和验证。
- 在经验证的交互轨迹上训练 PhAI-IDE-72B、PhAI-IDE-9B 和 PhAI-IDE-4B,建立了用于监督微调、强化学习和评估的共享基础。
- 报告了在留出科学代码修复任务以及代码、推理和知识等部分通用基准上的增益,为科学经验向更广泛能力的正迁移提供了证据。
引言
语言模型随着可验证的经验而改进,但科学发现仍然困难,因为任务是开放式的,需要假设检验,并依赖难以复现的复杂工具链。先前的基准评测科学编码能力,但不提供将代码仓库转换为可训练环境所需的生产级基础设施,尤其是在加速器移植场景中,每次移植都需手工编写且绑定特定供应商的默认设置。作者提出了 ScienceIDE,将专家定义的检查和容差转换为可执行环境,使验证与任务编写解耦。这使得单一环境能够支持修复、实现和加速任务,并拥有超过 2800 个任务的注册表。作者通过让 agent 生成并验证任务来解决将科学代码转化为可复用学习经验的瓶颈问题,从而产生用于监督微调和强化学习的分级轨迹。
方法
作者提出了 ScienceIDE,一个将科学专业知识转化为可复用 agent 经验的框架,通过在可执行环境中定义科学职责和验收标准来实现。任务工厂从这些环境中生成挑战,agent 的交互则为评估和学习提供所需证据。
如下图所示:
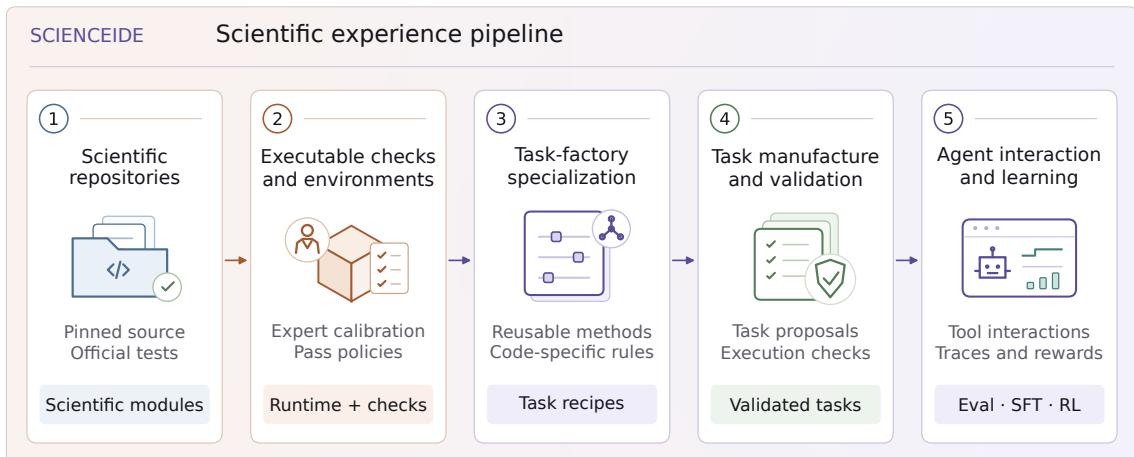
构建单元是版本化代码库中的科学模块。一个模块拥有明确的科学职责和可执行的覆盖范围,而不只是简单地对相关文件进行分组。环境将一个已批准的模块与其运行时和科学检查打包在一起。通过添加模块和代码库并在任务族之间复用其验收标准来实现扩展。
构建从生产级科学软件开始。agent 检查固定的上游修订版本、依赖关系和构建假设,然后构建源代码并运行官方测试和示例。这些运行暴露了输出格式、数值变异性和执行风险,为环境边界提供依据。agent 提出由科学职责和可执行覆盖范围定义的模块,识别输入、输出、算法阶段和支持性测试。领域专家审查分解方案和覆盖范围。随后 agent 实现特定于环境的实验适配器,并提交科学输出以供审查。已批准的模块与可编辑工作区、检查和私有验证器一起打包。
参见框架示意图:
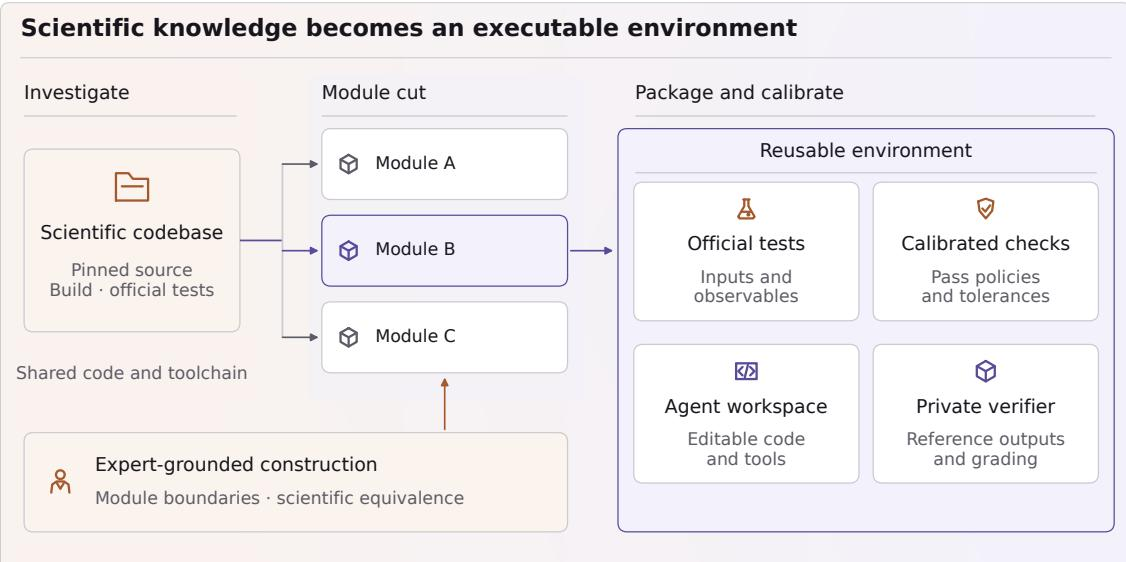
模块获批后,其上游单元测试、回归测试和随附示例问题会被统一调查。每个案例都会追溯到模块职责,并保留为检查、明确排除或标记为缺口。奖励的单位是检查,由固定输入和分级输出以及通过策略组成。通过策略有两种形式。逐点策略使用边界 ∣y−y^∣≤ϵ+ρ∣y∣ 比较每个分级值,其中完全相等是特殊情况 ϵ=ρ=0。该方式用于对物理可观测量进行分级,在比较前按输出中携带的身份对齐无序集合。不变量策略在逐点边界无法涵盖运行间变化时,比较矩、分布、守恒量或积分范数等量。名义和变体初始条件使这一选择可度量,其中变体扰动最小的充分活动输入集合以揭示数值敏感性。
工厂将可复用的编写流程与环境的科学上下文相结合以生成任务。共享流程处理可逆编辑、执行和工件组装,而局部规则识别活动路径和有意义的变换。agent 提出语义编辑位置和目标,而策展人与领域专家保留对观测量和验收标准的决策权。确定性流程将已批准的规则扩展为突变或切除候选。
如下图所示:
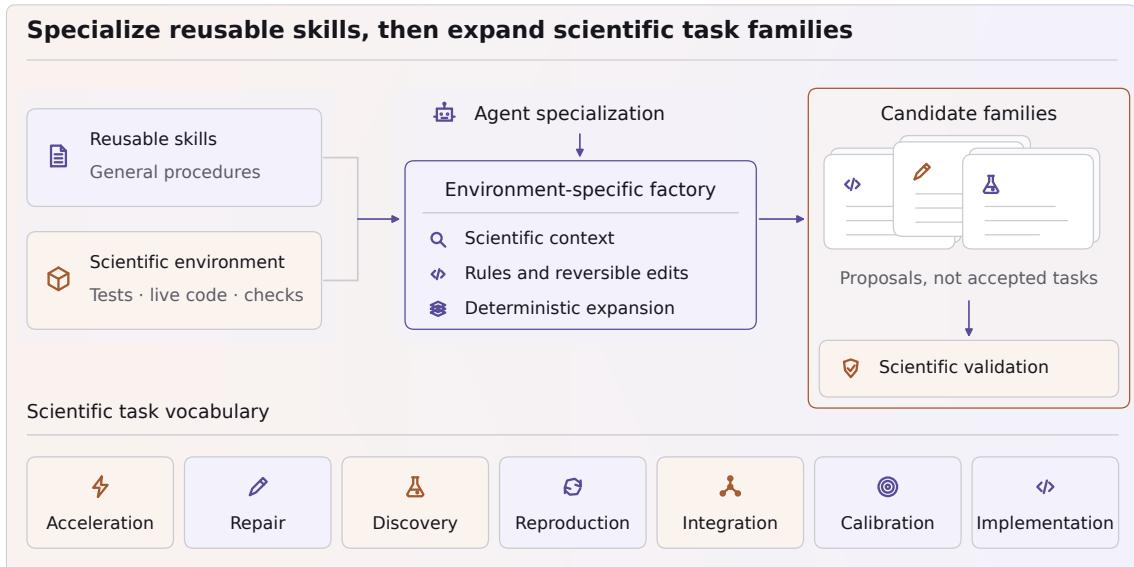
编写分类包括七个类别:加速、修复、发现、复现、集成、校准和实现。修复和实现通过可逆突变和切除暴露可自动化的候选扩展。其余类别为专家指定的目标、数据、流程或资源约束提供接口。
工厂提案只有在可执行证据表明其可观测、可求解且可信之后才成为任务。AI 作者可以提出修复、实现、加速、复现或其他变换,但提案本身并不构成有效性证据。工厂规则将 AI 提出的变换转化为候选。每个候选都在最终评分环境中进行测试。对于注入式修复,已知有效的见证必须通过,未修复的基线必须留有改进空间,且该变更必须产生可被参考修复消除的检查失败。
参见框架示意图:
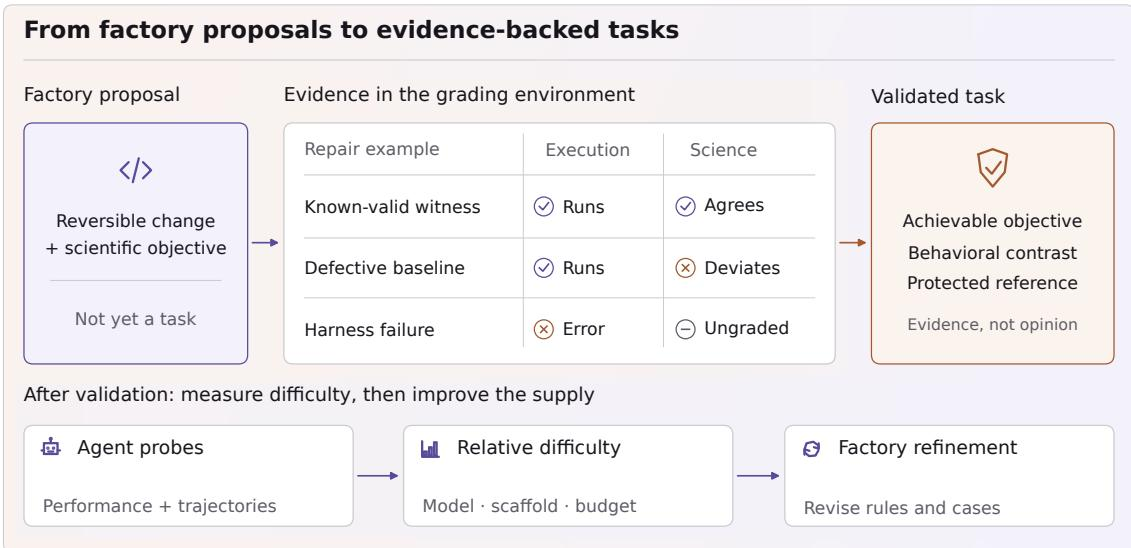
科学检查能够揭示部分完成程度。修复评分基于有缺陷起点进行归一化,公式如下:
rrepair=max(0,1−fr−f),0≤f<1其中 r 衡量科学一致性,f 是未修复构建的得分。打包过程还会筛除答案泄露,并记录执行完整性失败。
验证过的任务暴露统一的回合接口。agent 获得可编辑工作区,检查代码和科学输入,进行修改,运行实验,并将工件提交给私有验证器。测试平台记录动作、观测、检查奖励、执行状态和资源使用情况。
如下图所示:
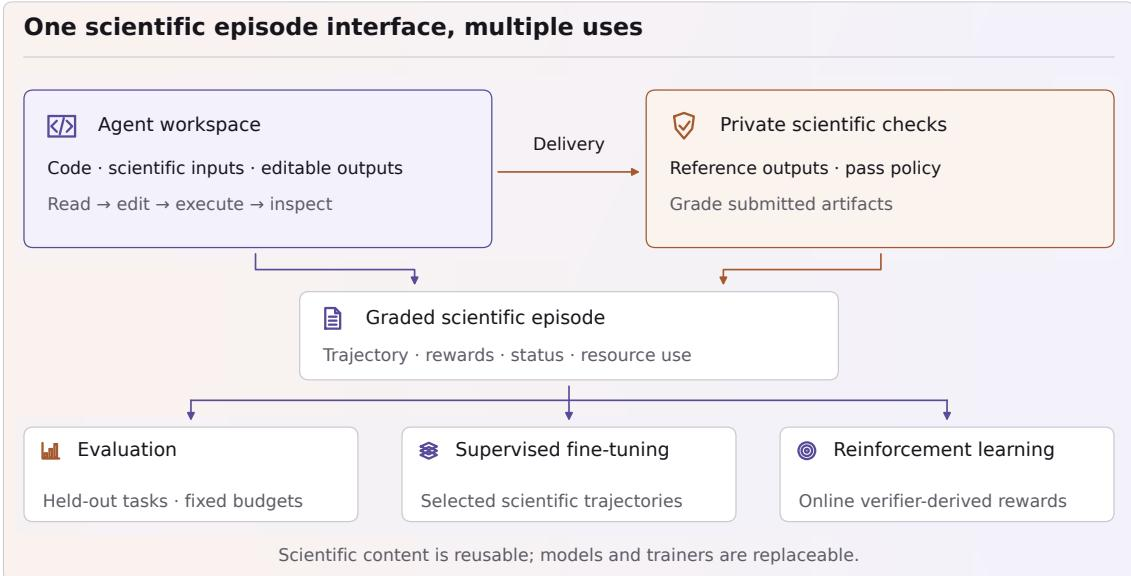
评估在保持科学任务和交互预算固定的情况下衡量成功率。监督微调消费者选择轨迹并对 agent 的动作进行监督,包括工具调用。强化学习消费者将策略控制的 rollout 连接到验证器奖励。任务可按环境、领域、任务族或测量难度进行选择,用于留出评估和训练课程。
对于强化学习,验证器通过编译修改后的代码并运行底层科学模拟来对 agent 的修复进行评分。该信号直接用作 RL 奖励。训练栈在分离的 GPU 上并发运行生成和优化。Rollout 与训练并发执行,使用 token 级截断重要性采样来修正由此产生的一步策略陈旧问题。
对于包含 G=8 条轨迹的提示组,奖励为 Ri,组相对优势计算如下:
A^i=Ri−G1j=1∑GRjToken 使用 PPO 风格的截断比率进行更新,其界限是非对称的(εlow=0.2,εhigh=0.3),使较少采样的修复动作保留获得概率质量的空间。损失按 token 均值聚合。
在长时程科学任务中,一个回合可能因修复完成、轮次上限耗尽或响应预算耗尽而结束。当预算截断的回合在组平均奖励为正的情况下获得零奖励时,优势变为负值,从而抑制其生成的 token。为防止策略学习简单缩短轨迹而非解决科学任务,作者将截断轨迹作为奖励观测的角色与其在策略优化中的角色分离。预算截断的轨迹保留在组基线中,但从损失中屏蔽。其奖励仍参与优势计算,确保完成的回合在奖励超过组均值时获得正优势。
实验
实验在 ScienceIDE 基准中评估科学任务执行能力,比较了 15 个 agent 在 85 个任务的困难子集上的表现,发现顶级模型的成功率约为 63-67%,大多数 agent 得分低于 40%,且时间和资源效率差异显著。基于科学演示轨迹的微调提高了留出代码库上的修复奖励,并正向迁移到公共代码、推理和知识基准。带验证器反馈的在线强化学习进一步将留出修复奖励提升 2.0-2.4 倍,但需要在策略损失中屏蔽预算截断轨迹,以避免导致性能崩溃的病理性缩短捷径。
带在线验证器反馈和截断屏蔽的微调在多个模型-环境对上提高了科学代码修复奖励,其中 PLUTO-Particles-Dust 和 PLUTO-RMHD/ResRMHD 获得显著提升。该方法防止策略因长时探索而受到惩罚,从而在留出任务中获得更高奖励并减少预算截断。最大的奖励增益来自 Qwen3.5-4B 在 PLUTO-Particles-Dust 上的表现,从 0.0 提升至 0.33。LAPS 在 PLUTO-RMHD/ResRMHD 上从 0.31 提升至 0.50,MITgcm-Biogeo 提升了 6.25 个百分点。将截断轨迹从策略损失中屏蔽但保留在组基线中,可防止奖励崩溃,并鼓励更长、更有效的修复尝试。使用截断屏蔽进行训练可获得更高的留出奖励和更少的预算截断,而不会缩短响应。
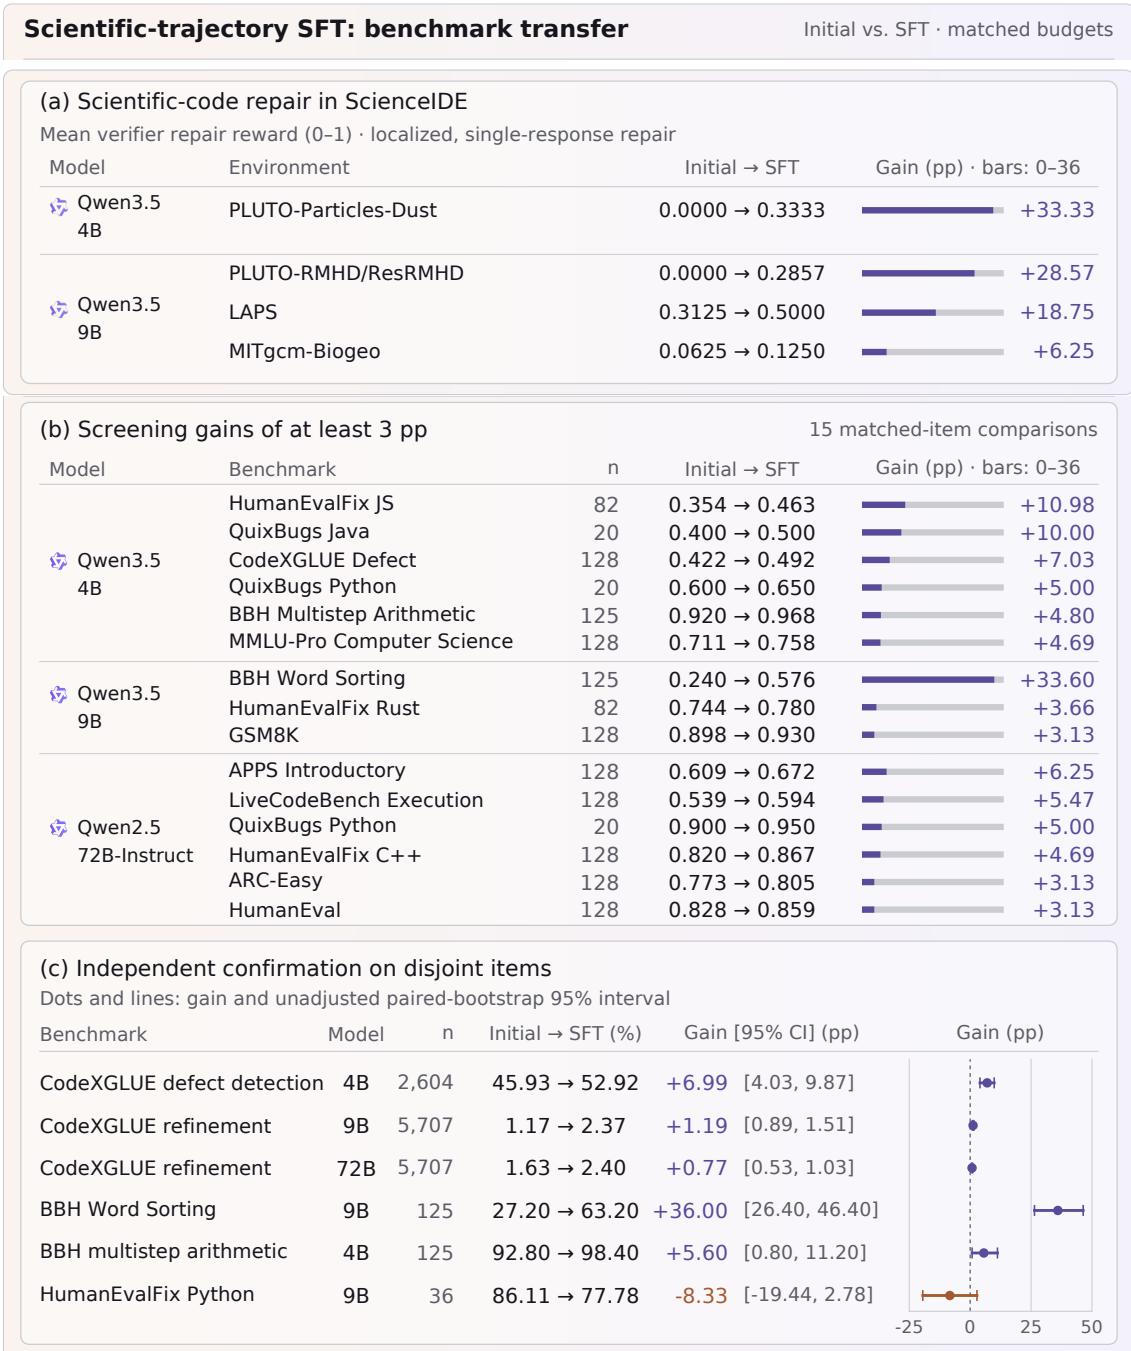
带在线验证器反馈和截断屏蔽的微调在多个模型-环境对上持续提高科学代码修复奖励,最大增益出现在 PLUTO-Particles-Dust(0.0 提升至 0.33),PLUTO-RMHD/ResRMHD 和 MITgcm-Biogeo 也有稳定提升。将截断轨迹从策略损失中屏蔽但保留在组基线中,可防止奖励崩溃,并鼓励更长、更有效的修复尝试,从而在不缩短响应的情况下获得更高的留出奖励和更少的预算截断。