Command Palette
Search for a command to run...
重新思考 PPO 中的评论家学习:理解并缓解价值扁平化
重新思考 PPO 中的评论家学习:理解并缓解价值扁平化
摘要
在大语言模型的强化学习中,近端策略优化(PPO)通常使用评论家来估计状态价值并降低策略更新的方差。然而,我们发现 PPO 评论家中存在一种系统性故障模式,我们称之为价值扁平化:由多个蒙特卡洛延续估计的状态价值在中间状态间剧烈变化,而评论家预测却相对平坦。我们进一步在受控的 FrozenLake 环境中观察到这一现象,并发现随着状态空间的增大,该现象变得更加显著。我们的理论与实证分析将价值扁平化与评论家损失中的隐式方差惩罚以及来自时间相关状态(梯度相似)的冗余更新联系起来。基于这些发现,我们提出了稀疏近端策略优化(SP3O),该方法仅对每个响应中的少数几个分离良好的状态应用价值损失,以缓解上述两种效应。在 Qwen3-Base 上的实验表明,每个响应仅监督三个状态的 SP3O 能够缓解价值扁平化,并在不同模型规模和评估套件中持续改进学习到的策略。综合来看,我们的结果将价值扁平化识别为标准 PPO 中评论家学习的一个重要却被忽视的故障模式,并表明简单的稀疏监督策略能够缓解该问题。
一句话总结
来自上海交通大学、上海人工智能实验室、西湖大学、南京大学、清华大学、香港中文大学和南洋理工大学的研究人员发现了价值扁平化(Value Flattening)现象,这是近端策略优化(PPO)中的一种系统性失败模式,即评论家(critic)的预测在不同状态下尽管蒙特卡洛价值变化剧烈,却仍保持平坦;他们据此提出稀疏近端策略优化(SP3O),该方法仅对每条响应的三个间隔良好的状态施加价值损失,从而缓解该问题,并在Qwen3-Base上持续提升策略性能。
核心贡献
- 识别并命名了价值扁平化(Value Flattening),这是PPO评论家在大语言模型推理中的一种失败模式,即评论家预测保持平坦,而基于多次蒙特卡洛续写的状态价值估计却发生剧烈变化;该现象在受控的FrozenLake环境中得到验证,并随着状态空间增大而更加明显。
- 将价值扁平化归因于两个原因:评论家均方误差损失中隐含的方差惩罚项会抑制不同token位置之间的价值差异,以及时间上高度相关的状态产生相似梯度并导致冗余更新;上述结论得到理论与实证分析的支持。
- 提出稀疏近端策略优化(SP3O),仅在每条响应的少数间隔良好的状态上监督评论家,以同时缓解上述两种效应;在Qwen3-4B-Base和Qwen3-8B-Base上的实验表明,SP3O能够缓解价值扁平化,并在数学与分布外推理基准上持续提升actor性能。
引言
强化学习(RL)被用于训练大语言模型(LLM)以完成需要长序列决策的复杂推理任务。该设置中的一个关键挑战是策略优化,它需要细粒度的信用分配:模型必须知道哪些中间步骤对最终结果有帮助或有害。近端策略优化(PPO)通过使用评论家网络估计每个状态的价值并生成token级优势来解决这一问题。为此,评论家必须准确反映响应中不同点上预期成功概率的变化。
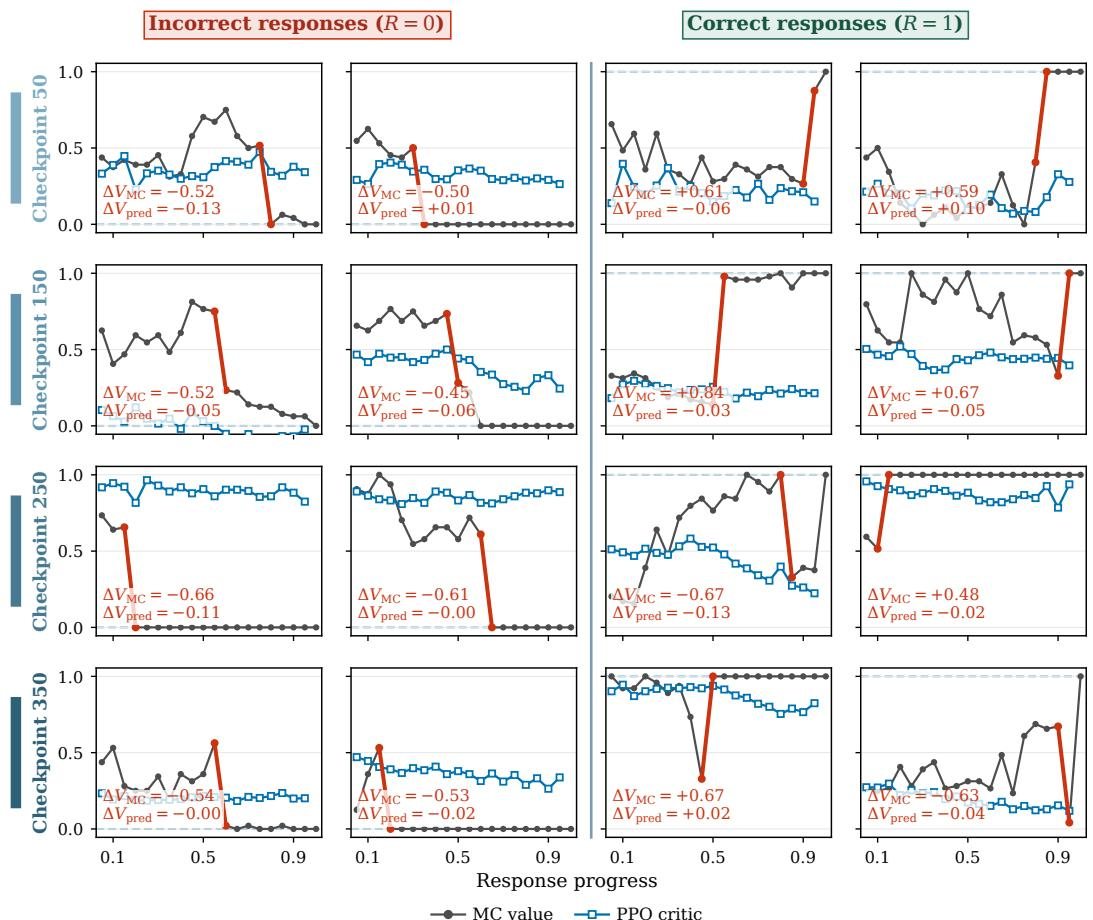
然而,作者发现PPO评论家在此任务上经常失败。他们观察到一种称为价值扁平化(Value Flattening)的现象:评论家预测的状态价值在一条响应内几乎保持恒定,即使真实的期望回报(使用多次续写的蒙特卡洛模拟估计)发生剧烈变化。该问题在训练检查点中持续存在,并同时出现在正确与错误的响应中,表明这是评论家学到的一种属性,而非特定轨迹的产物。在受控的FrozenLake实验中,扁平化程度随状态空间增大而加剧。
作者识别出两个促成因素。首先,在标准PPO且仅使用终端奖励的设置下,评论家的均方误差(MSE)损失应用于每个token位置,其中包含一个隐含的方差惩罚项,将预测推向平坦的价值轮廓。其次,由于相邻状态仅相差一个token,它们在时间上高度相关,导致梯度相似并进行冗余更新,进一步使预测价值同质化。
为解决这一问题,作者提出稀疏近端策略优化(SP3O),仅在少数且间隔较大的状态上施加评论家损失。这限制了方差惩罚并减少了冗余更新。在Qwen3-4B-Base和Qwen3-8B-Base上的实验表明,SP3O能够缓解价值扁平化,并在数学与分布外推理基准上持续提升策略性能。
方法
作者以近端策略优化(PPO)作为对齐大语言模型的基础框架。在该框架中,策略πθ根据提示x生成响应y=(y1,…,yT),形成轨迹τ。步骤t的状态定义为st=(x,y<t),动作定义为at=yt。框架采用评论家网络Vϕ(st)来估计策略条件下的状态价值。在终端奖励设置下,其中t<T时rt=0,rT=R(τ),广义优势估计目标得以简化,使得评论家回归目标Gt对所有t均等于终端回报R(τ)。标准评论家的训练方式是最小化其预测与所有token位置上这些目标之间的均方误差。
然而,作者识别出该标准方法中的一种关键失败模式,称为价值扁平化(Value Flattening)。尽管推理过程中状态价值的蒙特卡洛估计表现出剧烈的局部变化,但评论家的预测价值轮廓仍然相对平坦,无法捕捉这些变化的幅度和方向。
作者将价值扁平化归因于标准训练过程中固有的两个主要因素。首先,在共享终端目标的情况下,于每个token位置施加均方误差损失会引入隐含的方差惩罚,直接惩罚单条响应内评论家预测的变异性。其次,由于LLM轨迹中相邻状态仅相差一个token,它们在时间上高度相关。对所有位置进行监督会导致相邻状态产生对齐梯度并进行冗余更新,进一步抑制价值变化。
为缓解这些问题,作者提出稀疏近端策略优化(SP3O)。该方法保留标准actor目标和rollout流程,但从根本上改变评论家的监督策略。SP3O不再在每个token上施加价值损失,而是将评论家损失限制在每条轨迹中一个较小且良好分离的状态子集I(τ)上。稀疏评论家目标表述为:
LVSP3O(ϕ)=∑τ∈B∣I(τ)∣1τ∈B∑t∈I(τ)∑(Vϕ(st)−Gt)2通过选择更少的位置,每条响应的方差惩罚受到限制;通过使位置间隔开,来自高度相关相邻状态的对齐梯度累积得以减少。
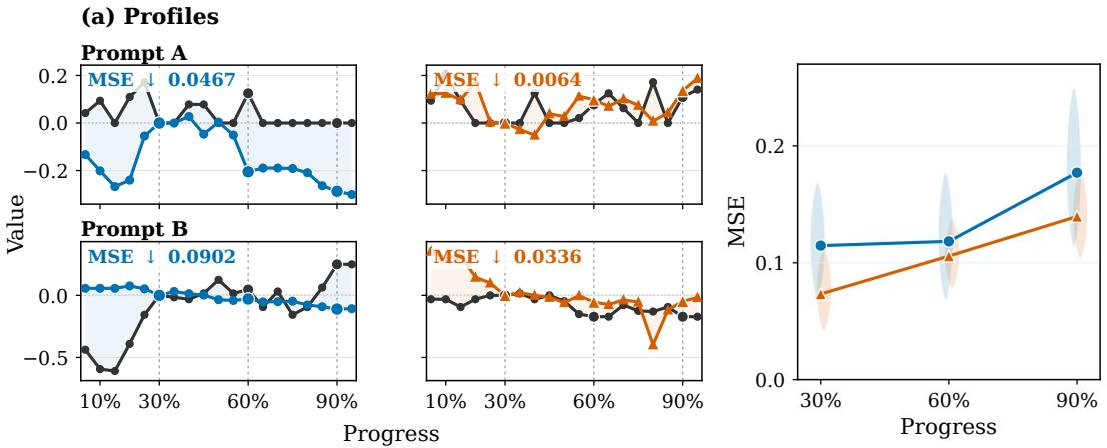
这种稀疏监督的影响在评论家预测和优化动态中均显而易见。与标准PPO相比,SP3O评论家更紧密地追踪蒙特卡洛价值局部变化的方向和幅度,显著降低了响应进程上的轮廓均方误差。
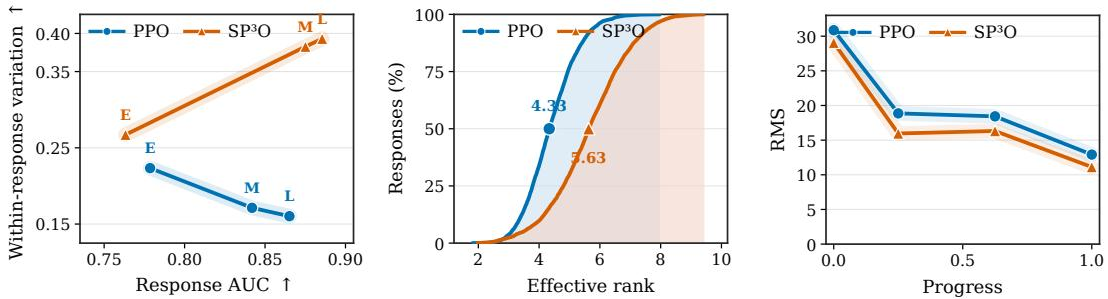
此外,稀疏监督保留了更丰富的隐藏表示并减少了冗余更新。SP3O评论家在保持响应级结果区分能力的同时,实现了更高的响应内变化,并将响应中心化隐藏状态的有效秩上移,表明维度多样性增强。此外,在终端回报目标与蒙特卡洛价值所诱导的价值头梯度之间,其RMS差异更低,从而在整段训练过程中带来更平滑的actor优化。
实验
SP3O采用稀疏评论家监督并显式覆盖尾部位置,在Qwen3-4B-Base和Qwen3-8B-Base上,其在域内和分布外推理基准上均持续优于标准PPO和GRPO。消融实验表明,少量且间隔良好的监督锚点(K=3至8)比更密集的监督产生更好的训练奖励,且固定位置放置优于随机放置。添加尾部锚点通过减少重复生成,显著提升了最终性能和生成稳定性,表明缓解评论家价值扁平化不仅改善了评论家诊断,还增强了策略学习。
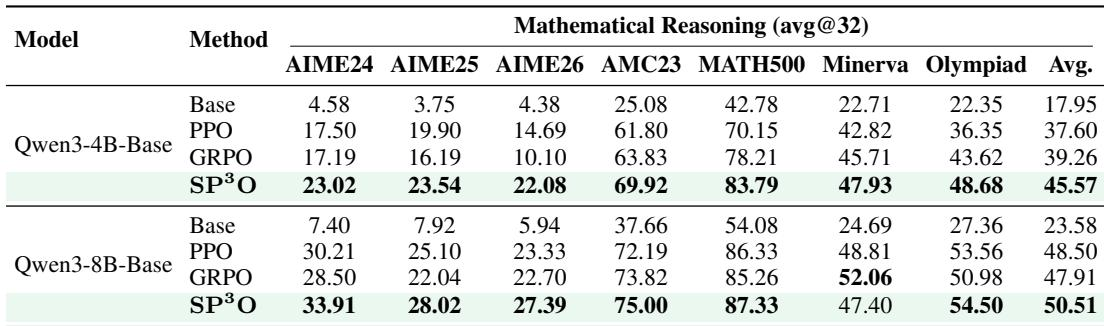
所提方法在两个模型规模上均持续提升域内数学推理准确率,优于PPO和GRPO基线,其中在Qwen3-4B模型上增益最大。该方法还带来更稳定的训练动态,表现为更小的actor更新和相比标准PPO更高的验证准确率。少量且位置良好的锚点的稀疏监督似乎比密集监督更有效,而添加尾部锚点显著提升性能并减少重复生成。在4B和8B模型上,该方法在七个数学推理任务的平均分上均优于PPO和GRPO。相较于PPO,域内平均性能提升接近8个百分点。使用该方法进行训练时,actor更新比PPO更小且波动更少,同时早期阶段之后验证准确率和rollout奖励也更高。少量锚点(K=3至8)的稀疏监督比更密集配置或标准token级评论家监督产生更好的训练奖励。添加最终尾部锚点相比省略该锚点,提高了平均分数并大幅减少生成重复。
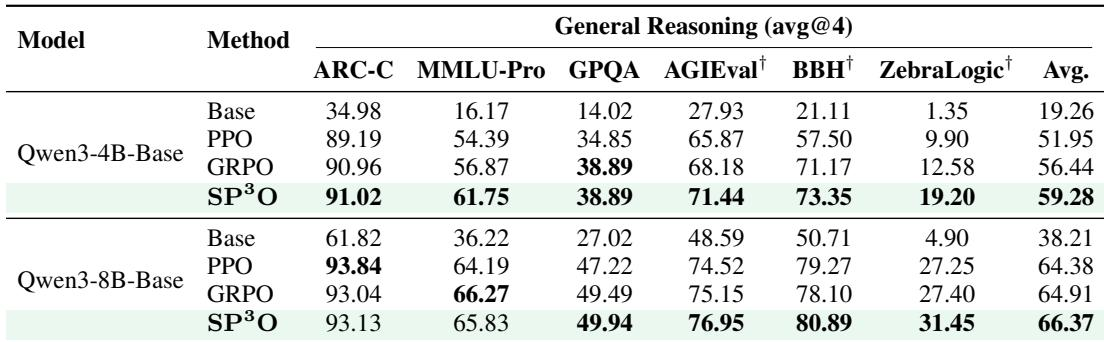
SP³O在两个模型规模上均持续优于PPO和GRPO的分布外推理任务,其中相比PPO的增益最大。该方法还带来更稳定的训练动态,表现为更小的actor更新和相比PPO更高的验证准确率。SP³O在Qwen3-4B-Base和Qwen3-8B-Base的所有六个分布外任务上均取得最高平均准确率。SP³O相比PPO的改进在ZebraLogic任务上尤为显著,而其他任务的增益相对温和。SP³O相比GRPO也表现出持续增益,尤其在MMLU-Pro和AGIEval等任务上。使用SP³O训练在后训练阶段表现出更稳定的策略更新,并保持比PPO更高的验证准确率。
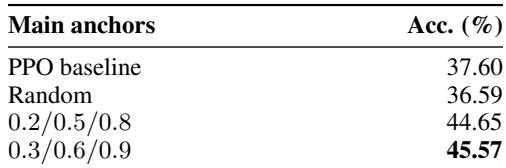
该消融研究比较了在Qwen3-4B-Base上使用K=3进行稀疏监督训练时的不同锚点放置策略。固定位置锚点放置在准确率上大幅优于随机放置,且包含较后锚点的固定方案取得最高性能,凸显了轨迹良好间隔覆盖的重要性。随机锚点放置所获准确率在各方案中最低,表现逊于两种固定位置放置。固定锚点放置在0.2/0.5/0.8处相比随机基线将准确率从约36.6%大幅提升至44.7%。将锚点移至更靠后(0.3/0.6/0.9)进一步将准确率提升至45.6%,在所有放置变体中表现最佳。
所提方法在4B和8B模型上均持续优于PPO和GRPO的域内及分布外数学推理任务,其中相比PPO的增益最大,同时通过更小的actor更新和更高的验证准确率带来更稳定的训练动态。少量且位置良好的锚点的稀疏监督比密集监督更有效,而添加最终尾部锚点显著提升准确率并减少生成重复。锚点放置的消融实验证实,固定位置方案优于随机放置,且较后的锚点带来最佳结果。