Command Palette
Search for a command to run...
RayOrch:面向基础模型数据准备的受血缘控制多粒度数据流编程与执行
RayOrch:面向基础模型数据准备的受血缘控制多粒度数据流编程与执行
摘要
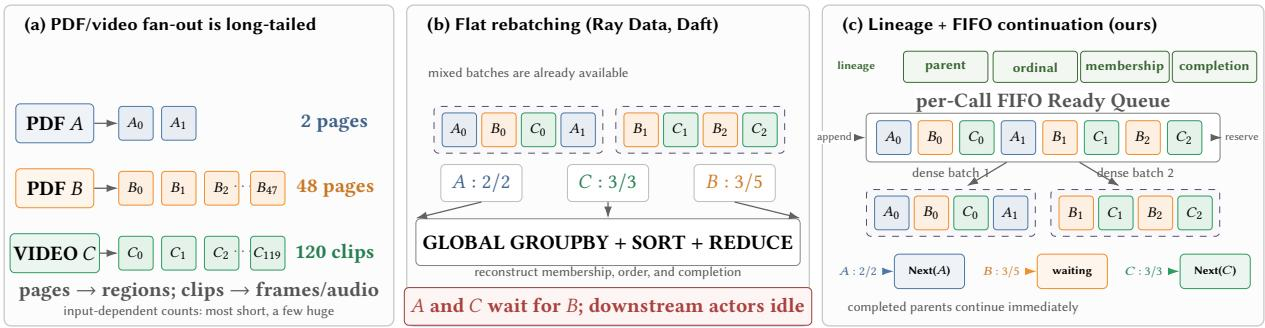
为基础模型准备高质量训练数据需要可扩展的流水线,将大规模异构文档或视频集合转换为结构化训练记录。这些流水线可能反复改变其处理单元。在每个扩展步骤中,一个输入项(即该图中的父节点)产生一个有序的、依赖输入的输出项序列(视为该数据血缘图中的子节点),且不同父节点的子节点数量分布呈长尾分布。另一方面,运行某一数据流水线阶段的 GPU 应将来自不同父节点的子节点批处理以最大化利用率,同时系统仍须将每个结果返回给其直接父节点、保持子节点顺序,并判断所有必需子结果何时已变为终止状态。现有数据流水线系统通常只能在两个不完美的方案之间选择。粗粒度函数将每个文档或视频作为一个不透明作业,隐藏了本可并行处理的页面、片段或帧。扁平记录函数单独暴露这些项,但迫使应用记住每个项的父节点和位置、跟踪所有项何时完成,并全局重新分组记录以重建原始结果。为应对这些挑战,我们提出 RayOrch,一个编程模型和分布式执行引擎,在整个执行过程中维护这些父子关系。程序声明一个有序的、基数可变的父到子扩展,以及一个匹配的子到父汇聚,用于重建每个父结果。编译器验证每个扩展-汇聚对。运行时,RayOrch 记录每次扩展的结构化血缘:其具体子节点集合、每个子节点的直接父节点与不可变序号,以及每个结果的终止状态。每次调用(Per-Call)的 FIFO 就绪队列跨父节点批量处理就绪子节点,而汇聚使用声明的成员关系和序号,而非批次边界或完成顺序。因此,当所有必需子结果都变为终止状态时,父节点即可最终确定其结果并进入下一阶段。当某个调用报告一个带类型的、限定于父节点范围的失败时,RayOrch 会在该调用中抑制该父节点尚未分派的兄弟节点,同时允许不相关的父节点继续执行。为验证 RayOrch 的设计,我们进行了全面评估。在 NVIDIA H20 GPU 上,将 MinerU 从 4 个 GPU 扩展到 64 个 GPU 时,RayOrch 实现了 15.14 倍的处理时间加速;将视频流水线从 8 个 GPU 扩展到 64 个 GPU 时实现了 7.82 倍加速。在 MinerU 上,与 Ray Data 相比,RayOrch 将端到端时间降低 13.1%,与 Daft 相比降低 29.0%;在 Docling 上,与 Ray Data 相比降低 16.0%。FIFO 调度将消融实验的墙钟时间从 634.1 秒降至 579.3 秒(8.6%)。在受控故障注入实验中,RayOrch 阻止了 23,514 个非触发兄弟计算中的 6,241 个进入 UDF,并在保留未受影响父节点所有预期输出的同时,相对于匹配的无故障运行平均将墙钟时间降低 14.93%。代码见 https://github.com/OpenDCAI/RayOrch。
一句话总结
北京大学及合作机构的研究人员提出了 RayOrch,这是一种面向基础模型数据准备的编程模型和分布式执行引擎,它通过有序可变基数的展开和匹配式汇聚保持父子血缘,支持按调用 FIFO 就绪队列、声明式成员关系与序数,以及父级作用域的失败抑制;在 NVIDIA H20 GPU 上实现了 15.14× 的 MinerU 扩展加速,同时性能优于 Ray Data 和 Daft。
核心贡献
- RayOrch 为有限的无环多粒度数据流引入了一种编程模型和基于 Ray 的执行引擎,具备编译器验证的有序可变基数父子展开、匹配式父级作用域汇聚,以及运行时持有的结构血缘跟踪。
- 按调用 FIFO 就绪队列跨父级批量调度就绪子项,而声明式成员关系和序数解析有序汇聚,使父级在所有必需子结果均为终态后即可完成。带类型的父级作用域失败抑制会抑制失败父级尚未分派的兄弟项,同时不相关的父级继续运行。
- 在 NVIDIA H20 GPU 上,RayOrch 将 MinerU 从 4 个 GPU 扩展到 64 个 GPU 时实现了 15.14× 的处理时间加速,将视频流水线从 8 个 GPU 扩展到 64 个 GPU 时实现了 7.82× 的加速。在 MinerU 上,相比 Ray Data 端到端时间减少 13.1%,相比 Daft 减少 29.0%;在 Docling 上相比 Ray Data 减少 16.0%;通过 FIFO 调度减少 8.6%。在故障注入中,它阻止了 23,514 个非触发兄弟计算中的 6,241 个进入 UDF,将墙钟时间减少 14.93%,并为未受影响父级保留全部预期输出。
引言
面向版式丰富的文档和长视频的基础模型数据准备流水线会反复改变处理单元,例如文档生成页面、区域和表格,或者视频生成片段、帧和音频段,因此执行引擎必须暴露细粒度并行性,同时保持每个父级的顺序和完成语义。Spark、Dask、Ray Data 和 Daft 等先前系统要么将父子结构隐含在粗粒度函数中,隐藏子级并行性和跨父级批量处理,要么将子项扁平化为集合,使父键和序数只是应用字段,把完成和失败语义留给应用处理,并且通常会增加 shuffle 或重组屏障。作者提出 RayOrch,这是一种编程模型和基于 Ray 的引擎,它声明有序可变基数的展开和父级作用域汇聚,在物理批次保持短暂的同时维护运行时结构血缘,并使用不可变序数、按代次防护的提交和带类型的父级作用域失败抑制,实现跨父级批量处理而不丢失按父级重建或隔离。
方法
RayOrch 通过两个互补视图呈现每条流水线:逻辑视图描述数据单元和结构变换,执行视图在可用工作节点上调度计算。即使批量、重试和工作节点放置发生变化,逻辑结构仍保持稳定。
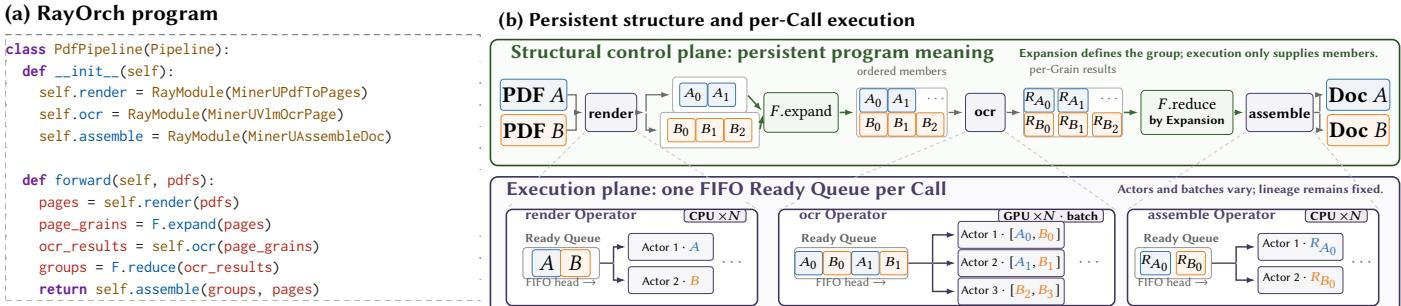
如上图所示,图 (a) 给出了简洁、类似 Torch 的用户接口,其中流水线定义为一个 Python 类。例如,PDF 流水线可以声明渲染、OCR 和组装阶段。图 (b) 展示了该结构如何执行。上平面是结构控制平面,F.expand 等操作改变计算单元(例如从 PDF 到 Pages),而 F.reduce 重建文档级项。下平面是执行平面,每个配置的 Call 成为一个 Operator,带有一个按 Call 的 FIFO Ready Queue 和一组工作节点。Ready Grain 可以被打包到短暂物理批次中,包括混合多个父级的批次,这是一种执行选择而非逻辑分组。
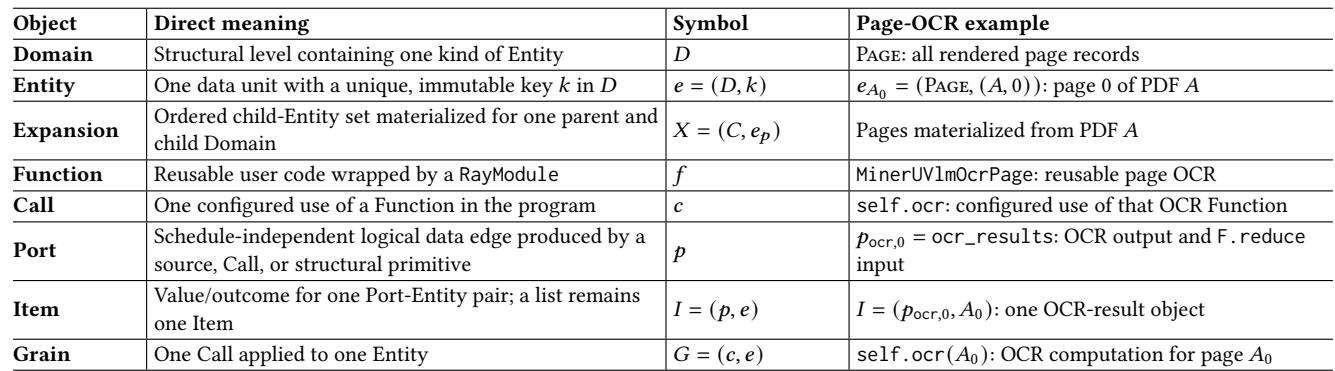
作者用层次化数据单元表示逻辑数据流。Domain 命名层次结构中的一个层级,例如 PDF 或 Pages,Entity 是该层级中的一个单元。Function 是可复用的用户代码,Call 是该函数的一次配置使用。将一个 Call 应用到一个 Entity 形成一个 Grain,即计算单元。声明的 Port 承载逻辑值;一个 Port 和一个 Entity 的值是一个 Item。展开关系由程序声明,决定哪些子 Entity 属于某个父级以及如何重建它们。这种编程模型称为多粒度数据流,允许用户表达页面级或帧级并行,而无需手动维护子项计数或分组状态。
运行时会先检查无环性和 Domain 兼容性,再将符号化 DSL 编译为不可变图。图中包含 Call、Port、Domain、消费者和预索引结构效果。对于每个子 Domain 和父 Entity ep,运行时创建一个 Expansion X=(C,ep),其中包含为该父级物化的有序子 Entity。每个逻辑对象恰好发布一个终态事实:
Entity: Published(e,ep), Item: Present(v)∣Dropped∣Failed∣Suppressed, Expansion: Succeeded(⟨e0,…,em−1⟩)∣Dropped∣Failed.输入传播遵循固定优先级:失败或被抑制的输入抑制输出;未解析的输入等待;必需输入被丢弃则丢弃输出;否则 Grain 变为 ready。Reduce 操作仅在其 Expansion、每个子成员结果和每个存活值都解析后,才发出一个父 Item。
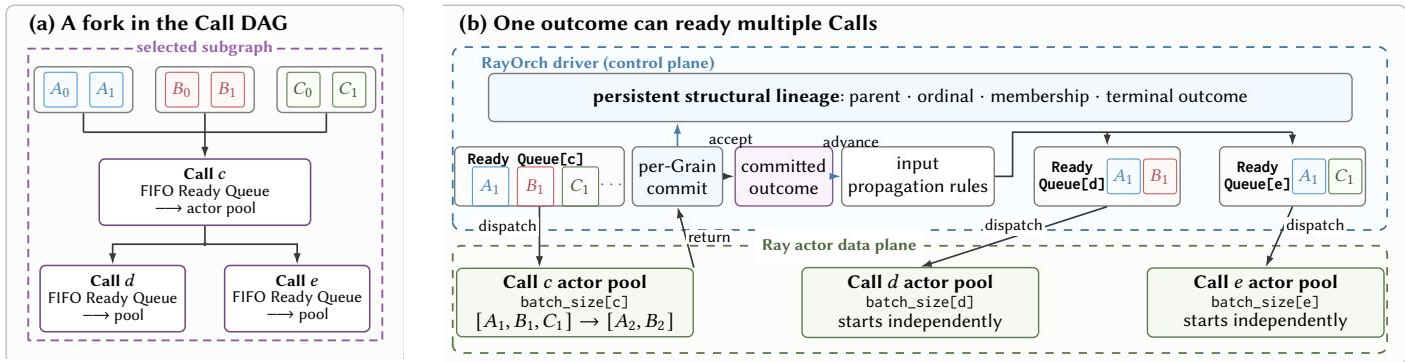
调度机制参见上方框架图。对于每个输入微批次,每个 Call 为 READY Grain 维护一个按 Call 的 FIFO Ready Queue。这是一个准入队列,不是分组操作。如图 (b) 所示,一个已提交结果可以激活多个下游 Call,它们的 Ready Queue 独立调度,而不是等待全阶段重组屏障。资源、副本和批量范围按 Call 配置。弹性预留最多从 Ready Queue 中取出 k 个条目,复杂度为 O(k),并且可以混合父级。父级绑定预留最多取第一个 ready 父级的 k 个兄弟项,同时保持其余队列条目的相对顺序。两种策略只改变物理批次;Grain 身份、成员关系和重建顺序保持不变。物理 Grain 生命周期如下:
WAITINGreadyREADYreserveIN-FLIGHTcommitSEALED, IN-FLIGHTretryREADY,WAITINGterminalSEALED.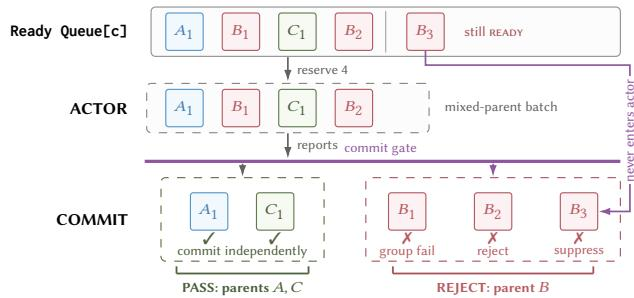
如上图所示,系统将逻辑提交与物理尝试分开。带类型的 RecordFailure 对单个 Grain 是终态。带类型的 GroupFailure 为一个 (Call, parent) 安装局部抑制屏障:排队兄弟项在分派前被抑制,进行中的兄弟项可以完成但不能提交,已经提交的兄弟项保持不变。不相关的父级和队列保持活跃。未类型化的 UDF 异常或基础设施故障属于物理尝试失败。运行时可以重试 Grain,或替换其 actor 并以更高代次重放 Grain;这些操作保持 Grain 身份,仅改变物理尝试。报告 r 仅在其 Grain 仍处于进行中且其代次(尝试编号)为当前值时提交:
Accept(r,G)⟺phase(G)=IN-FLIGHT∧r.grain=G∧r.generation=generation(G).被接受的报告会原子地封存 Grain 并发布终态事实;代次检查会拒绝过期或重复报告。
RayOrch 以 Ray 上的 Python 层实现。每个配置的 Call 由一个持久 Ray actor 池支撑,driver 保留编译后的计划、血缘元数据和待处理的 ObjectRef。载荷保留在 Ray 对象存储中;actor 句柄和引用是物理执行状态,不会进入 Grain 的逻辑身份。每个模型阶段是一个由 RayModule 包装的 Python 类,并实现形如 List[Object] → List[Object] 的批量 UDF。阶段生命周期遵循 Torch 模块模式:__init__ 加载模型和其他重型资源,而 run 执行批量计算。持久 actor 实例将初始化成本分摊到各个批次。
实验
评估在文档和视频工作负载上使用 NVIDIA H20 GPU,将 RayOrch 与 Ray Data、Daft、原生 MinerU 和 Docling Serve 进行基准对比,涵盖端到端性能、可扩展性、调度和失败抑制。RayOrch 通过将 OCR 与组装和上传重叠执行,避免基线系统的 OCR 后重组尾部,实现近线性扩展和更快的端到端性能。消融实验表明,FIFO 调度在重批量之外进一步降低墙钟时间。故障注入研究确认,运行时持有的血缘会在 UDF 执行前抑制注定失败的兄弟工作,同时保留所有预期健康输出。
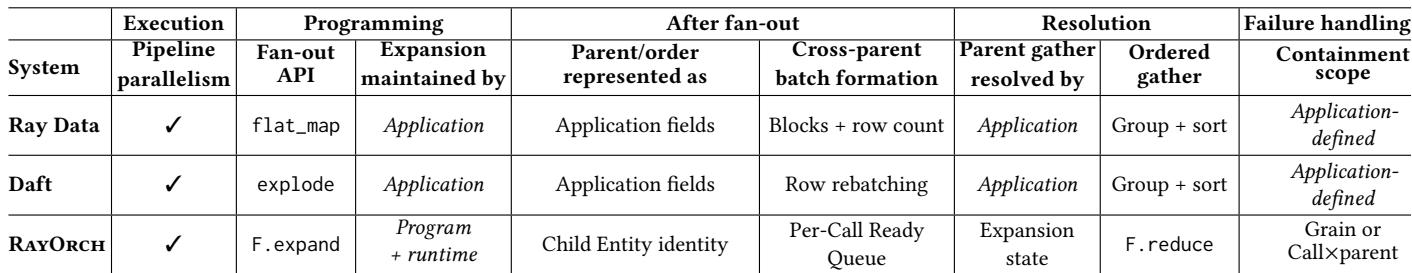
Ray Data 和 Daft 依赖应用维护的展开字段和分组排序操作来解析有序可变基数扇出,而 RayOrch 使用程序声明的、运行时维护的子身份和按调用就绪队列来保持父级顺序。这种运行时所有权使 RayOrch 能够通过 ready grain 处理跨父批次,并将抑制作用域限制为 grain 或按父级调用的级别,而其他系统使用应用定义字段和抑制范围。报告的实验与此对比一致:RayOrch 避免基线系统的 OCR 后重组尾部,通过 FIFO 调度降低墙钟时间,并在执行前抑制注定失败的兄弟工作。Ray Data 和 Daft 将展开和父级/顺序维护为应用字段,并通过分组排序解析有序汇聚,而 RayOrch 使用子实体身份和按调用就绪队列。RayOrch 是唯一具有程序声明、编译器验证、运行时维护的展开和抑制范围,且范围为 grain 或按父级调用级别,而非应用定义范围的对比系统。RayOrch 在本地完成父级,并将组装和上传与 OCR 重叠,避免 Ray Data 和 Daft 中出现的 OCR 后重组尾部。FIFO 调度在重批量之外进一步降低墙钟时间,血缘作用域抑制防止注定失败的兄弟项进入 UDF,同时保留健康输出。
RayOrch 将流水线表示为层次化数据单元上的逻辑数据流。Domain 定义结构层级,Entity 是一个键控单元,将 Call 应用到一个 Entity 形成一个 Grain;Port 承载逻辑值,Item 是一个 Port-Entity 对的值。在 PDF 到页面的 OCR 示例中,展开 PDF 暴露有序页面实体,页面级 OCR 调用生成项,归约按声明顺序重建文档级项。Domain、Entity、Function、Call、Port 和 Item 构成用于层次化数据处理的调度无关逻辑模型。展开为父级物化有序子实体,归约按声明顺序重建父级项,而不是从记录字段重新发现分组。
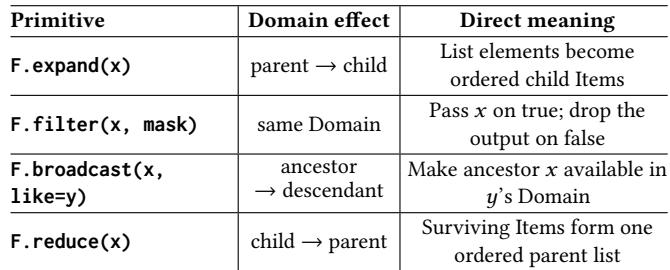
RayOrch 的声明式结构 DSL 定义了四个在 Domain 之间移动或过滤数据的基本操作:expand、filter、broadcast 和 reduce。对齐变体保持成员对齐,可选输入会影响传播而不添加结构节点。编译器在将计划降低为不可变图之前检查无环性和 Domain 兼容性,因此运行时消费声明的关系而不是推断血缘。F.expand 物化有序子集,而 F.reduce 将存活的子项收集为一个有序父列表。F.filter 在 Domain 内通过真时传递项、假时丢弃项来改变成员关系。F.broadcast 使祖先项在后代 Domain 中可用。这些基本操作共同表达层次化扇出,无需任意连接或重组,非法的跨 Domain 使用会在执行前失败。
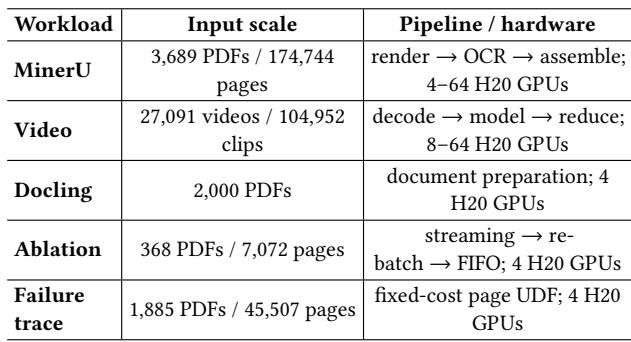
评估涵盖五类工作负载:大规模 PDF 处理、视频处理、文档准备、调度消融和故障追踪。PDF 和视频工作负载在扩展到最多 64 个 GPU 的 NVIDIA H20 GPU 集群上运行,而消融和故障研究在四个 GPU 上使用较小输入。配置使用固定软件版本和共享基线系统,如 Ray Data 和 Daft。MinerU 在 4 到 64 个 H20 GPU 上运行渲染-OCR-组装流水线,处理数千个 PDF 和页面。视频处理在 8 到 64 个 H20 GPU 上对数万个视频和片段使用解码-模型-归约流水线。Docling、消融和故障追踪实验使用较小工作负载和四个 H20 GPU,以隔离文档准备、调度和失败抑制行为。Ray Data 和 Daft 作为通用基线,原生 MinerU 和 Docling Serve 在适用时使用。
在 64 个 NVIDIA H20 GPU 的 MinerU 工作负载上,RayOrch 在对比系统中端到端时间最低、吞吐量最高。相比 Ray Data、Daft 和原生 MinerU,它将墙钟时间分别降低约 13%、29% 和 52%,吞吐量分别提高约 15%、41% 和 107%。这些收益归因于 OCR、组装和上传阶段的重叠执行,以及避免了 OCR 后重组尾部。RayOrch 取得最佳 64 GPU MinerU 结果,比 Ray Data、Daft 和原生 MinerU 更快完成,同时每秒处理页数最高。相比基线,RayOrch 将端到端时间降低约 13%、29% 和 52%,吞吐量提高约 15%、41% 和 107%。RayOrch 重叠执行 OCR、组装和上传工作,父级本地提交有助于避免 Ray Data 和 Daft 中出现的全局重组尾部。
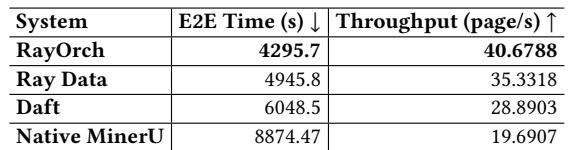
实验在 NVIDIA H20 集群上,跨大规模 PDF 和视频流水线、文档准备、调度消融和故障追踪,评估 RayOrch 与 Ray Data、Daft 和原生 MinerU 的对比。RayOrch 依赖声明式层次化原语和运行时维护的子身份以及按调用就绪队列,而基线系统通过应用定义字段和分组排序操作管理有序扇出。在 64 GPU MinerU 工作负载上,RayOrch 取得最低端到端时间和最高吞吐量,相比 Ray Data、Daft 和原生 MinerU 分别将墙钟时间降低约 13%、29% 和 52%,吞吐量提高约 15%、41% 和 107%。报告中的收益来自重叠执行 OCR、组装和上传工作,避免 OCR 后重组尾部,使用 FIFO 调度,并应用血缘作用域抑制,在执行前阻止注定失败的兄弟工作。