Command Palette
Search for a command to run...
MiniMax-H3 能否对物理世界进行推理?一项全模态生成模型评估
MiniMax-H3 能否对物理世界进行推理?一项全模态生成模型评估
摘要
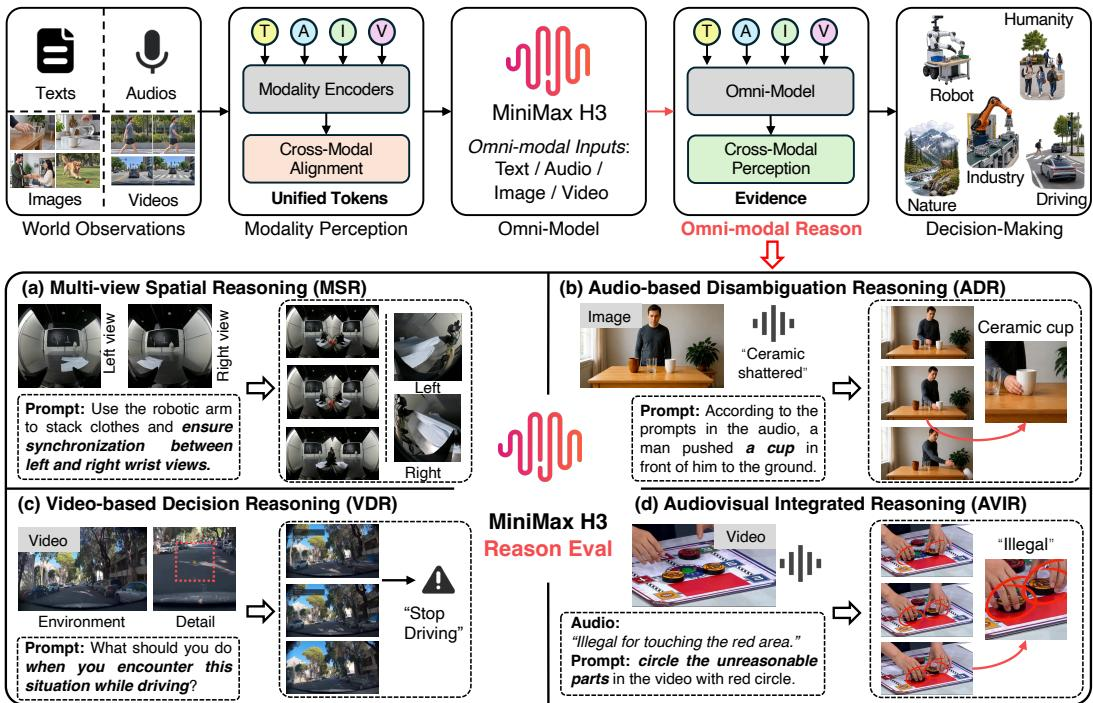
近年来,全模态生成模型(Omni-Models)推动了内容生成向文本、图像、视频和音频统一建模的方向发展。MiniMax-H3 是这一转变的典型代表:它在共享潜空间框架中结合了多模态上下文理解与联合音视频生成。其统一架构引出一个根本性问题:多模态对齐能否提升模型对世界的推理能力?全模态输入又能催生哪些新的评估范式?为探究该问题,本文提出一个围绕物理世界推理的四个互补维度展开的综合评估框架。与现有针对视频生成和世界模型的评估框架不同,后者通常受限于输入模态有限、且评估设置中提示与目标视频内容高度匹配;本评估专门设计用于利用 Omni-Model 的多模态输入。我们构建了一组多样化的新颖任务,要求模型整合跨模态的互补信息。具体而言,我们考察了四种场景:隐式提示与多帧图像配对、音频-图像、前缀视频(prefix-videos)以及音频-视频输入。每种单一模态仅能提供关于底层事件的部分证据,要求模型对互补语义线索进行联合推理,以推断潜在事件状态和未来动态。在 517 个评估实例中,MiniMax-H3 的总体成功率为 41.97%。其中,基于视频的决策推理(Video-based Decision Reasoning)成功率最高,为 56.00%;基于音频的消歧推理(Audio-based Disambiguation Reasoning)最弱,仅为 27.40%。这些结果表明,有效整合多模态信息仍然是充分发挥多样化输入模态优势的关键。项目地址为 https://github.com/gulucaptain/MiniMax-H3-Reason。
一句话总结
新加坡国立大学、复旦大学和腾讯的研究人员针对全模态生成模型 MiniMax-H3 提出了一种四维物理世界推理评估,该评估利用多模态输入,包括与多帧配对的隐式提示、音频-图像输入、前缀视频以及音频-视频输入;在 517 个评估实例上,MiniMax-H3 的总体成功率为 41.97%,其中基于视频的决策推理达到 56.00%,而基于音频的消歧推理仅为 27.40%,这表明有效的多模态整合仍然是充分利用多样化输入模态的关键。
核心贡献
- 该论文提出了一个面向全模态生成模型物理世界推理的综合评估框架,覆盖四种互补输入设置:多帧隐式提示、音频-图像对、前缀视频和音频-视频输入。
- 该工作贡献了一个包含 517 个评估实例的基准,其中每种模态仅提供部分证据,要求模型联合推理互补的语义线索,以推断潜在事件状态和未来动态。
- 在 MiniMax-H3 上的实验显示总体成功率为 41.97%,基于视频的决策推理为 56.00%,基于音频的消歧推理为 27.40%,表明有效的多模态整合仍然是一个关键局限。
引言
像 MiniMax-H3 这样的全模态生成模型可以同时基于文本、图像、音频和视频进行生成,这使得研究模型能否从互补但不完整的证据中推断物理事件成为可能。现有的视频和世界模型基准通常在提示中明确描述目标事件,因此额外模态往往是冗余的,评估主要衡量的是指令跟随而非跨模态推理。作者引入了一个隐式生成评估框架,其中关键事件语义从文本中省略,并分布到多个输入模态中,迫使模型在生成视频之前对齐部分观测并恢复预期事件。他们构建了一个经专家验证的 517 个实例集合,覆盖四种推理场景:多视图空间推理、基于音频的消歧、基于视频的决策推理和音视频综合推理。在该基准上评估 MiniMax-H3 得到 41.97% 的总体成功率,揭示了支持全模态输入与可靠地将其用于物理世界推理之间的显著差距。
数据集
作者构建了一个用于多模态物理世界推理的评估数据集,而非训练语料。
主要构成
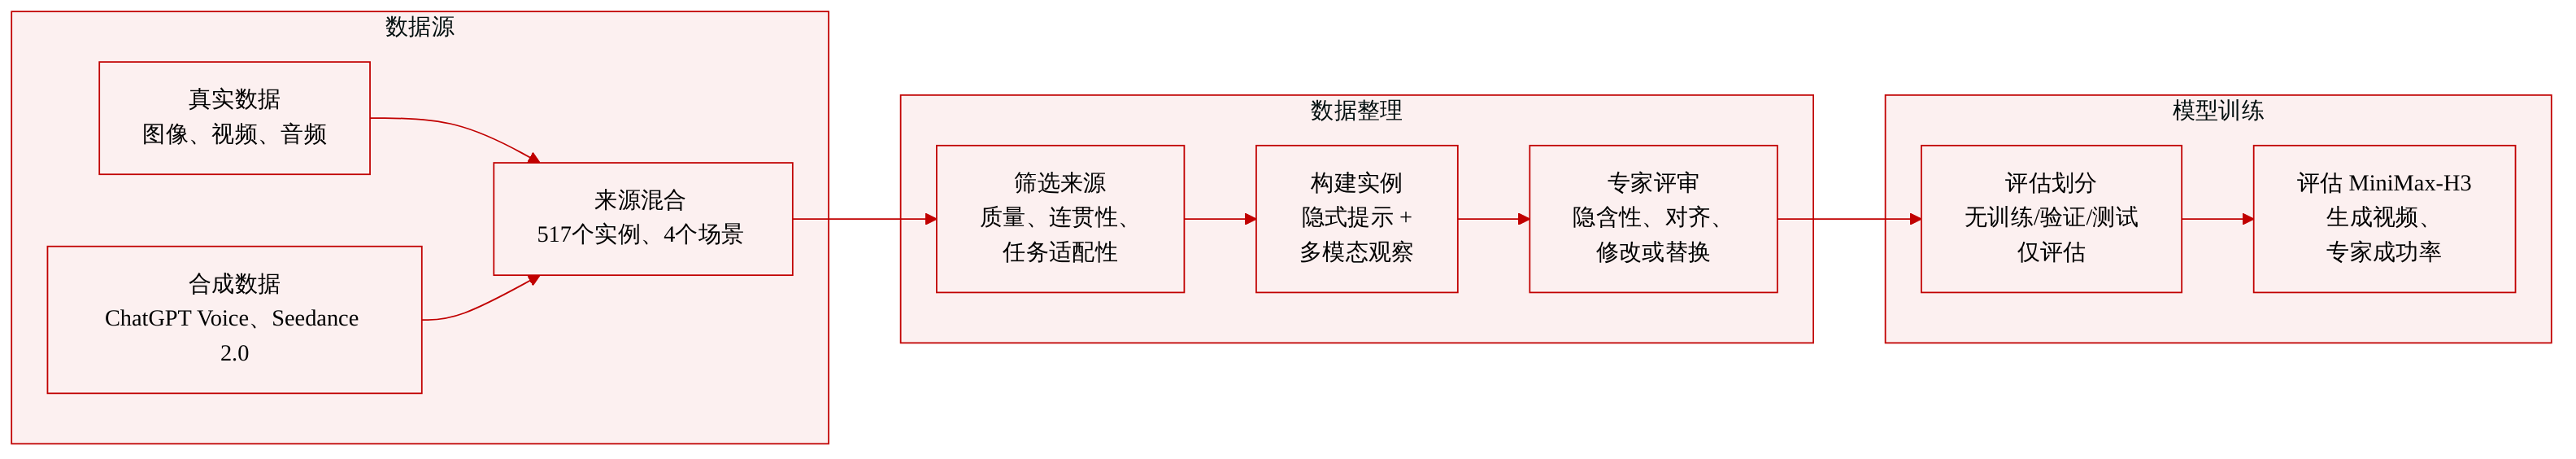
- 517 个实例,覆盖 4 个场景和 29 个子类。
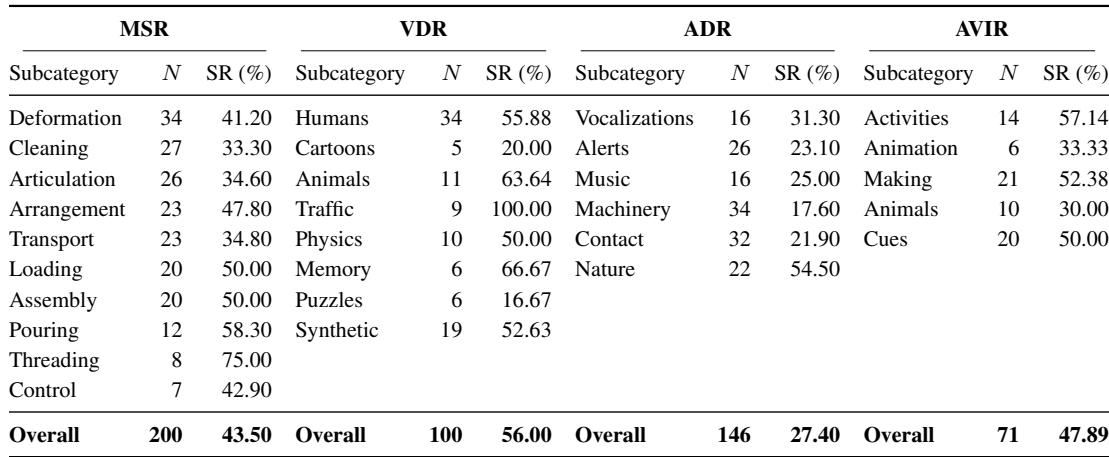
- 场景数量:MSR 200 个实例/10 个子类,ADR 146 个实例/6 个子类,VDR 100 个实例/8 个子类,AVIR 71 个实例/5 个子类。
- 每个实例存储为 (qi,xi,τi):隐式提示 qi、多模态观测 xi 和场景标签 τi。
数据来源
- 真实与合成的视觉和声学数据,包括图像、视频、音频录音和生成式剪辑。
- 合成来源包括用于音频的 ChatGPT Voice 和用于视频的 Seedance 2.0。
- 真实/源数据集包括用于多视图视觉的 HiFi-UMI-2K、VISTA-UMI 5K、HuMI-Unsheathe、Hy-Embodied-0.5-VLA-Data 和 10Kh-RealOmin-OpenData;用于视频的 LLaVA Video-178K;以及用于音频的 FSD50K 和 ESC-50。
- 来源经过感知质量、语义一致性和任务适配性筛选。存在视觉伪影或事件结构不清晰的来源被排除。
子集概况
- MSR:具有多视图观测、大视角变化和部分遮挡的家居操作。
- ADR:静态图像加音频,其中音频有助于在多个合理的物体-声音解释中识别发生的事件。
- VDR:在人类活动、动物运动、物理交互、场景变化和物体动态上的视频前缀续写。
- AVIR:带有环境音频或语音指令的视频,用于音频引导续写和视觉不一致性检测。
处理与元信息
- 观测形式因场景而异:多张图像、图像与音频配对、视频前缀,或视频前缀/完整视频加音频。
- 提示被设计为隐式:仅凭文本不应揭示目标,而观测应提供充分证据。
- ChatGPT 和 Qwen3 生成候选提示表述,随后由专家编辑和验证。
- 每个条件-提示对都经过迭代专家评审,评估场景复杂度、推理丰富度、条件一致性和提示隐式性。未通过评审的对会通过提示调整或输入替换进行修订。
- 所提供文本未描述裁剪策略、训练划分或训练混合比例。
在模型评估中的使用
- 该数据集用于评估 MiniMax-H3,而非用于训练。
- 被接受的条件-提示对通过 MiniMax-H3 的视频生成加以验证。
- 三位独立专家评估每个生成视频并交叉核对判断。成功取决于输出是否满足任务要求,而不是与单个参考视频匹配。
- 主要指标是成功率(SR),计算为每个类别及总体中被判定为成功的样本百分比。
方法
作者提出了一个针对全模态模型的系统评估流程,重点评估 MiniMax-H3 的物理世界理解与推理能力。与早期主要基于图像和文本进行条件生成的模型不同,MiniMax-H3 支持跨多个模态的组合输入。为了评估这一能力,作者通过多阶段过程构建了一个综合数据集,包括多模态来源收集、任务特定实例构建和迭代人工评审。
如下图所示:
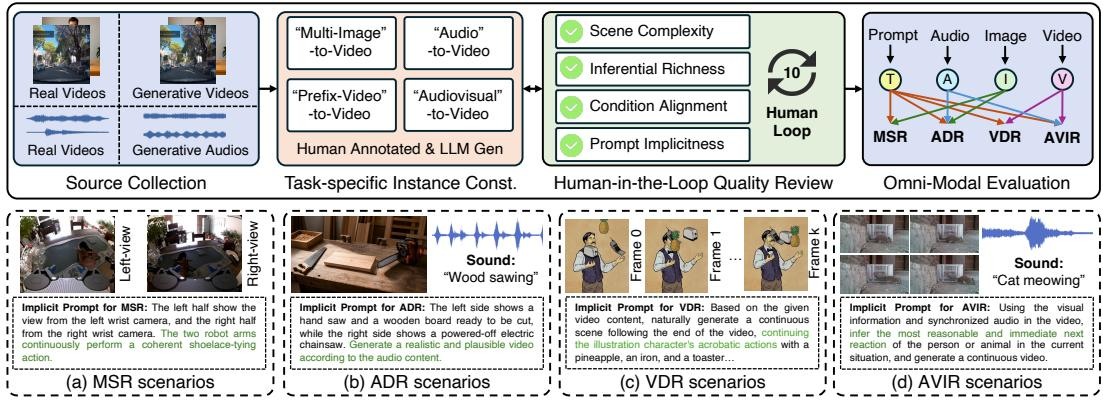
数据构建流程从来源收集开始,作者收集真实与合成的视觉和声学数据,包括图像、视频、音频录音以及生成模型产生的剪辑。这些来源经过感知质量、语义一致性和预期任务适配性筛选。带有视觉伪影或事件结构不清晰的来源被排除,以确保评估所需证据保持完整。
来源收集之后,作者构建任务特定实例。每个实例将多模态观测与一个隐式任务提示和一个标注的语义目标配对。输入被组织为四种推理场景:多视图空间推理(MSR)、音频消歧推理(ADR)、视频续写推理(VDR)和音视频推理(AVIR)。例如,在 MSR 中,场景的多个视图为空间关系提供互补证据。在 ADR 中,音频片段有助于区分静态图像的多个合理解释。
为确保模型必须依赖多模态推理而不是文本线索,作者使用大语言模型生成隐式提示。这些提示指定了所请求的生成操作,但隐藏了任务相关信息,该信息必须从观测中推断。提示构建遵循两条标准:仅凭文本不应披露目标解释,并且多模态输入必须提供充分证据以推断生成结果。
构建好的条件-提示对随后经过严格的 10 轮专家评审流程。评审者从四个维度评估每个对:场景复杂度、推理丰富度、条件一致性和提示隐式性。未通过评审的对通过调整提示或替换输入条件进行修订,然后重新评估。
经过数据收集、筛选和人工验证后,每个被接受的实例表示为 Ei=(qi,xi,τi),其中 qi 表示隐式任务提示,xi 包含输入观测,τi∈{MSR, ADR, VDR, AVIR} 标识推理场景。
如下图所示:
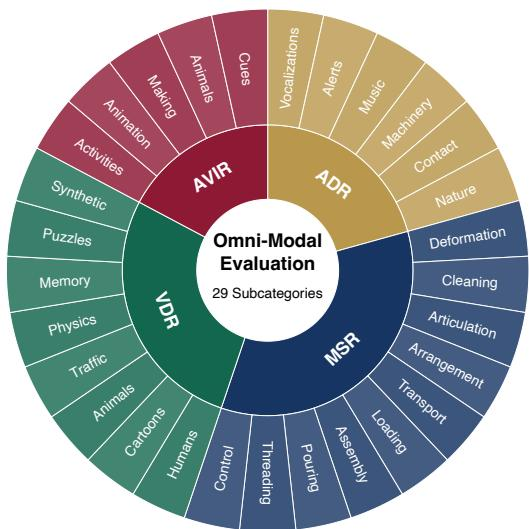
最终评估集覆盖 4 个领域和 29 个子领域,共包含 517 个条件-提示对。这一结构化数据集确保评估能够有效衡量模型整合互补跨模态证据以进行可靠物理世界推理的能力。
实验
该工作将 MiniMax-H3 作为代表性全模态生成模型,在 517 个经专家评审的实例上进行评估,这些实例涵盖四类物理世界推理任务:多视图空间推理、基于音频的消歧、基于视频的决策和音视频综合推理。该设置测试文本、图像、视频和音频输入能否被组合起来,使模型推断未说明的约束,并通过视频生成、续写或编辑来表达这些约束,由人工评分者判断任务满足情况,而不是与参考视频的相似性。定性来看,模型通常能生成视觉上合理的输出并跟随主要输入线索,但其可靠性仍然有限,在视频续写上表现最好,在基于音频的消歧上表现最差。反复出现的失败包括证据锚定错误、事件实现不完整、物理或配置违规以及时间不一致。
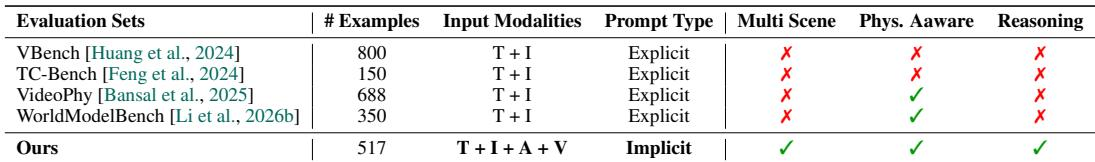
现有评估基准主要依赖显式文本和图像条件,并且没有一个能同时结合多场景理解、物理感知和多模态推理。所提出的评估则使用文本、图像、音频和视频输入与隐式提示,要求模型从分布式多模态证据中推断缺失的事件语义。这使得可以通过生成视频来评估多场景理解、物理感知和推理。大多数先前基准仅使用带显式提示的文本和图像输入,不测试多场景理解或多模态推理。一些先前基准包含物理感知,但仍依赖显式文本-图像条件,不要求跨音频和视频证据进行推理。所提出的基准接受文本、图像、音频和视频输入与隐式提示,并且是所列基准中唯一同时覆盖多场景理解、物理感知和推理的基准。由于提示是隐式的,生成视频可作为行为读出,判断模型是恢复了缺失的事件语义,还是只是遵循了显式指令。
在全部 517 个样本上,MiniMax-H3 的总体成功率为 41.97%。基于视频的续写是最可靠的场景,依赖于音频的推理最不可靠,两者之间存在较大差距。子类别结果不均衡,交通动态表现较强,而动画、谜题、机械和接触声的结果弱得多。基于视频的续写在四个场景中领先,而依赖于音频的推理排名最低。在基于视频的续写中,交通动态始终处理得较好,但动画和谜题的成功率低得多。操作任务差异显著,穿线和倾倒比清洁、关节类和运输更可靠。
所提出的基准使用文本、图像、音频和视频与隐式提示来评估多模态生成,要求模型推断缺失的事件语义,并通过生成视频展示多场景理解、物理感知和推理。这不同于主要依赖显式文本-图像条件的先前基准。实验中,MiniMax-H3 在基于视频的续写上最可靠,在依赖于音频的推理上最不可靠,子类别表现不均衡,例如交通动态较强,而动画、谜题、机械和接触声较弱。总体而言,结果表明隐式多模态推理仍然具有挑战性,尤其是当它依赖音频证据时。