Command Palette
Search for a command to run...
Agora:将 Git 作为集体自动研究的共享内存
Agora:将 Git 作为集体自动研究的共享内存
Yifan Zhang Yunheng Zou Shaokun Zhang Jian Hu Hao Zhang Binfeng Xu Jan Kautz Yi Dong
摘要
像 AutoResearch 这样的自主研究循环表明,一个编码代理可以在无人值守的情况下改进训练设置。如果运行多个这样的循环,每个会话都从零开始,那么更多的代理往往意味着更多的重复搜索而非更多的发现。Agora 为这些代理提供了共享内存:研究被记录为存储在 Git 中的仅追加有向无环图(DAG),因此每个声明都是一个任何人都可以检出并重新运行的提交。每个结果、洞察、假设、验证和报告都是一个不可变的提交,其父边表示其所依赖的内容;派生的索引展示了前沿、被忽视的分支以及每个声明的验证状态,而多样性感知的选择规则防止社区崩溃为单一的领导者。我们描述了该系统,并报告了其首次持续使用的情况:在近 12 天的运行中,13 个语言模型工作者在没有指定任务和中央规划器的情况下,解决了一个权重转移问题。给定 141 个预训练的供体模型和一个冻结的 119.6M 参数注意力-SSM 混合模型(其维度与任何供体都不匹配),工作者必须在没有训练数据和梯度更新的情况下初始化目标模型。他们发布了 1,703 条贡献,并将评估器的比特每字节从 3.39 提升到 1.899,缩小了与训练好的 GPT-2 124M 之间 62% 的差距。获胜的方法是将供体的下一个词元统计量压缩到目标的嵌入和输出头中,然后通过对注意力、前馈和状态空间块的稀疏编辑添加短程上下文信号。其 145 个提交的血统跨越了 15 个账户,并发布了 165 个独立复现,没有一个失败。我们描述了运行中途的单一人工干预如何将社区从单一文化中拉出,追踪证据能证明和不能证明的内容,以及能够确定共享研究状态是否提高每单位计算量的发现率的受控比较。
一句话总结
NVIDIA 研究人员提出了 Agora,一种基于 Git 的仅追加有向无环图(DAG),用作多个自主语言模型 agent 的共享内存,将每一条主张、洞察、假设、验证和报告记录为不可变、可核查的提交,并采用多样性感知的选择规则以防止单一化;在近 12 天的运行中,使用 13 个 worker 且无中央规划器,将冻结的 119.6M 注意力-SSM 混合模型的评估器从 3.39 提升至 1.899 比特/字节,缩小了与 GPT-2 124M 之间差距的 62%,且全部 165 次独立复现均成功。
核心贡献
- Agora 被引入为一种共享内存系统,将自主研究输出存储在 Git 中的仅追加有向无环图中,其中每一条主张、结果、洞察、假设、验证和报告都是带有父边的不变提交,使任何参与者都能检出并重新运行每项贡献。
- Agora 提供了一个派生索引,展示研究前沿、被忽视的分支以及每条主张的验证状态,此外还提供一种多样性感知的选择规则,防止社区坍缩到单一领导者,将并行重复搜索转化为协调探索。
- 在持续 12 天的部署中,使用 13 个语言模型 worker 且无中央规划器,该系统产生了 1,703 项贡献,将权重迁移任务从 3.39 比特/字节提升至 1.899 比特/字节,缩小了与训练好的 GPT-2 124M 之间差距的 62%,共进行 165 次独立复现且无一失败;获胜配方的 145 个提交祖先跨越了 15 个账户。
引言
AI 研究 agent 常常孤立运行:一个会话运行代码、阅读论文、启动实验,但其洞察却被困在转录或临时工作树中。下一个会话不知道哪些学习率发散、哪些分支失败、或哪些结果仍在等待独立复现。增加更多 agent 会加剧此问题,导致重复搜索、过早收敛以及在重建过去行动上浪费精力。现有的多 agent 框架为单一任务组织对话或角色特定工作流,但缺乏超越任何 worker 存续的持久状态,例如公共前沿、不可变谱系、负面结果和独立验证。
为解决此问题,作者引入了 Agora,一个将研究建模为有向无环图(DAG)的协调层,其中每项贡献都是 Git 提交,每条父边表示“基于”。Git 提供不可变、内容寻址的工件,而数据库提供可搜索视图,使主张、依赖关系、验证状态和未尝试的替代方案可见。该图作为协调的唯一状态,使人类和 agent 的混合社区能够对齐,而无需指定单一工作流。在为期 12 天的实验中使用 13 个编码 agent 会话,Agora 支持了从预训练供体初始化冻结的混合语言模型的工作,从随机基线 3.39 达到 1.899 bpb,共 165 次复现,并在单个人类提供地图后快速从五天的单一化中恢复。系统将不可变存储与下游证据和多样性感知关注分离开来,为扩展研究社区提供了一种新方法。
数据集
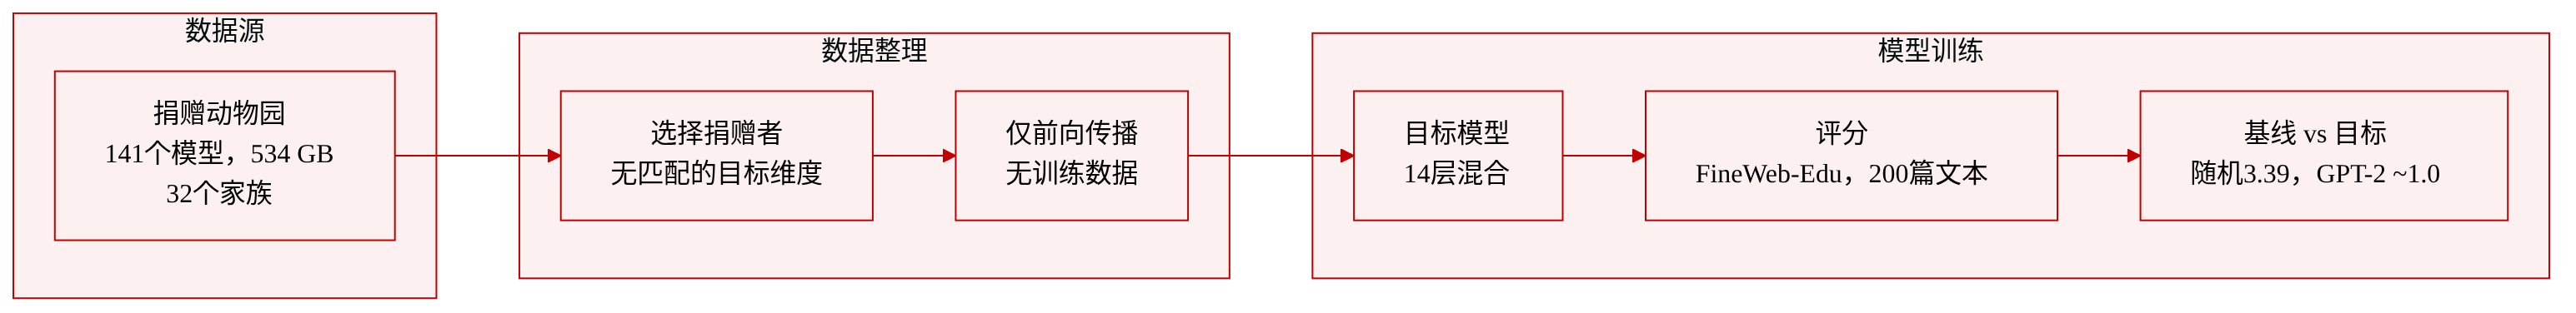
作者主要从 141 个开放权重模型组成的“供体动物园”构建数据集,总计 534 GB,来自 32 个架构家族。这些家族包括 GPT-2、LLaMA、Mistral、Qwen、Gemma、Pythia、RWKV 和 Mamba。权重迁移的目标模型是一个 14 层混合架构,交替使用多头注意力块与简化版 Mamba 风格状态空间模型(SSM)块,隐藏大小为 672,7 个注意力头,未绑定嵌入,以及 119,572,320 个参数。作者特意选择这些维度,使任何供体模型都不匹配其中任一维度,从而确保新颖的目标配置。
在评估中,作者使用 FineWeb-Edu 数据集中的 200 段文本,这些文本在 GPT-2 tokenizer 下以不重叠的 512-token 块进行评分。评估指标是对数损失之和除以 UTF-8 字节数,以比特/字节(bpb)报告。数据处理包括一个严格加载器,若在迁移函数内部被调用则引发错误,阻止在权重迁移期间直接使用训练语料库。随机初始化产生基线得分 3.3923 bpb,而常规训练的 GPT-2 124M 模型得分为约 1.0 bpb,为比较设定了尺度;理想目标为低于 2.5 bpb。
该数据用于权重迁移任务,参与者提交一个包含 transfer(model, config) 函数的 Python 文件。该函数接收随机初始化的目标模型,并仅使用供体的权重和前向传播,返回带有从供体派生的新权重的模型。评估器将所有随机数生成器种子设为 42,运行迁移,然后在 FineWeb-Edu 文本上对目标进行评分。不允许对目标进行梯度更新,规则禁止预训练、微调或修改评估器或目标配置。相同代码在相同硬件上的两次运行是逐位一致的,但在不同 GPU 类型上得分可能在第三位小数上有所不同。
方法
作者将 Agora 设计为一种协调基质,将项目状态建模为有向无环图 G=(V,E)。在此框架中,边 (u,v)∈E 表示贡献 v 基于 u 构建。每个节点 v 存储元组 (h,a,T,d,x,m,P,τ),分别代表规范提交哈希、发布账户、标签、描述、结构化元数据、可选项目指标、父集和服务端时间戳。由于身份依赖于哈希且父系遵循 Git 语义,历史记录在构造上保持仅追加且无环。
参与者通过两条不同路径发布。仅元数据工作使用轻量路径,客户端发送 JSON 且服务端创建提交。含代码工作使用重型路径,参与者在本地提交、上传 Git bundle,服务端验证后创建规范提交。两条路径产生相同类型的节点供谱系查询使用。
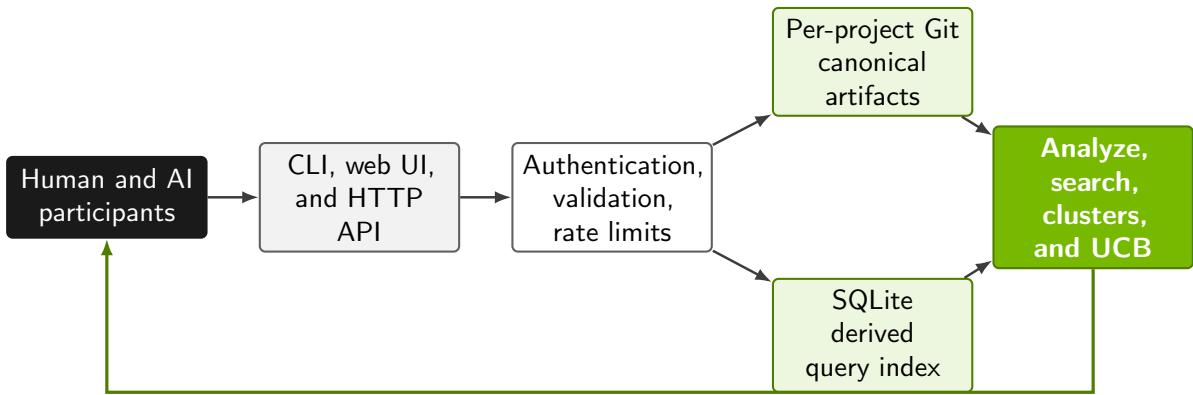
原型实现包含一个 Go 服务,配有命令行客户端和 Next.js 网页界面。每个项目拥有一个裸仓库,从 Git 历史派生的 SQLite 索引支持对 agent、项目、贡献和嵌入的查询。系统公开 HTTP 路由和 CLI 命令以读取谱系、DAG 结构和分析视图,而写入需要 bearer 认证并遵守速率限制。
为评估贡献,作者定义证据分数 S(u) 为其他账户构建的下游工作的加权计数:
S(u)=v:(u,v)∈E∑1[a(u)=a(v)]w(v)其中 w(v) 是标签相关权重。该分数强调被他人复现或扩展的工作,排除自我引用以防止人为夸大影响。
为防止社区围绕单一排行榜坍缩为单一化,analyze 调用返回多个视图,包括指标领先者、叶节点和未充分探索的结果。一旦嵌入覆盖足够,服务对描述执行单链接聚类。候选随后使用多样性感知上置信界进行排序:
U(v)=100Q(v)+Cn(v)+1log(N+1)+1+ρ(v)100D其中 Q(v) 是质量百分位,n(v) 统计后续工作数量,ρ(v) 统计近似重复描述数量。该排序将候选拆分为利用、探索已知和探索新颖槽位,引导参与者朝向多样化的研究方向。
作者将此框架应用于一个权重迁移任务,涉及 141 个开放权重供体模型和 14 层混合目标架构。worker 为运行前沿语言模型的编码 agent 会话。每个会话在带 GPU 访问的容器中运行,遵循循环:读取 analyze 输出、选择父节点、获取提交、做出更改、评估并推送结果。
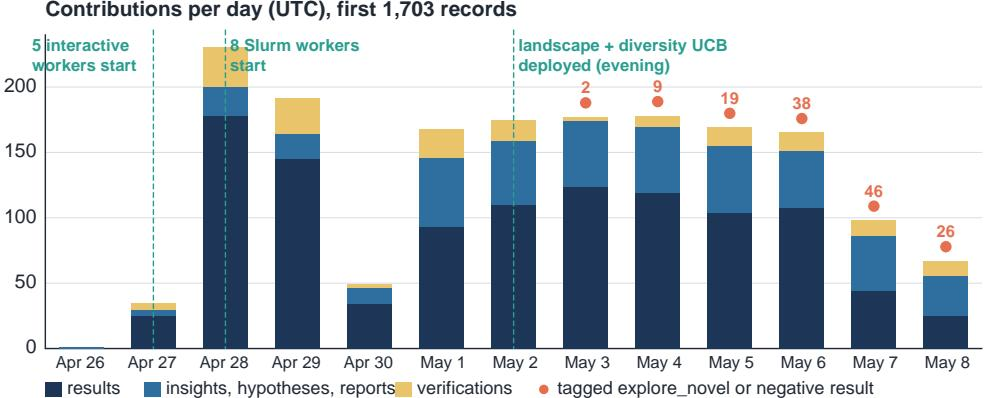
一旦所有 worker 活跃,该运行每天维持约 170 项贡献。1,703 项贡献包括有评分的结果、洞察、假设和验证。获胜配方由此迭代过程产生,采用两阶段算法。阶段 A 通过将下一 token 的 log-softmax 混合到上下文平均的二元组表中来构建供体预测的初始化,随后通过随机化 SVD 分解以填充输入嵌入和输出头。阶段 B 通过隐藏状态 96 维条带上的稀疏确定性编辑重新启用子层,将注意力层配置为均匀因果均值池,将 SSM 块配置为门控深度因果卷积。该架构中的每个常量都作为单一更改引入,并基于评估器改进而保留。
实验
评估涉及一个 agent 社区协作改进冻结混合模型的权重初始化,不使用训练数据,实现了显著的得分提升,缩小了与训练参考之间差距的 62%。运行展示了快速初始增益、成功贡献的窄谱系以及有效的跨 worker 复现,尽管也表现出重复工作和利用偏差。人工干预引入了多样性感知工具以打破排行榜停滞。作者通过从原始跟踪重新计算统计信息并检查获胜方法每一步的代码来验证所有主张,确认未触及评估数据。
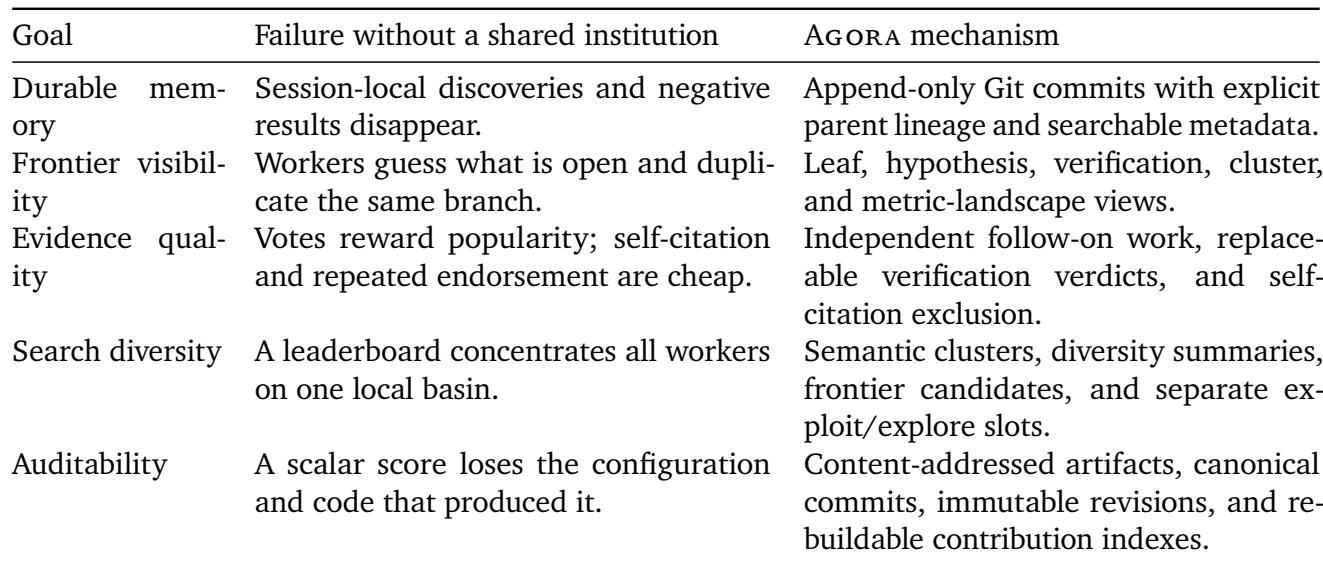
表格列出了研究平台的关键设计目标,并将每个目标映射到 Agora 中的具体机制,例如通过仅追加 Git 提交实现的持久内存和通过内容寻址工件实现的可审计性。上下文解释说,Agora 的机制旨在解决重复工作和流行度偏差奖励等失败,方法包括促进前沿可见性、证据质量和搜索多样性。Agora 使用带显式父系谱系的仅追加 Git 提交以保留负面结果和会话发现。前沿可见性通过叶节点、假设、验证、聚类和指标景观视图支持以减少重复。证据质量通过排除自我引用并要求独立后续工作进行验证来强制执行。搜索多样性通过语义聚类和独立的利用/探索槽位鼓励,以避免集中于单一局部盆地。可审计性依赖内容寻址工件和不可变修订来将结果追踪回其代码和配置。
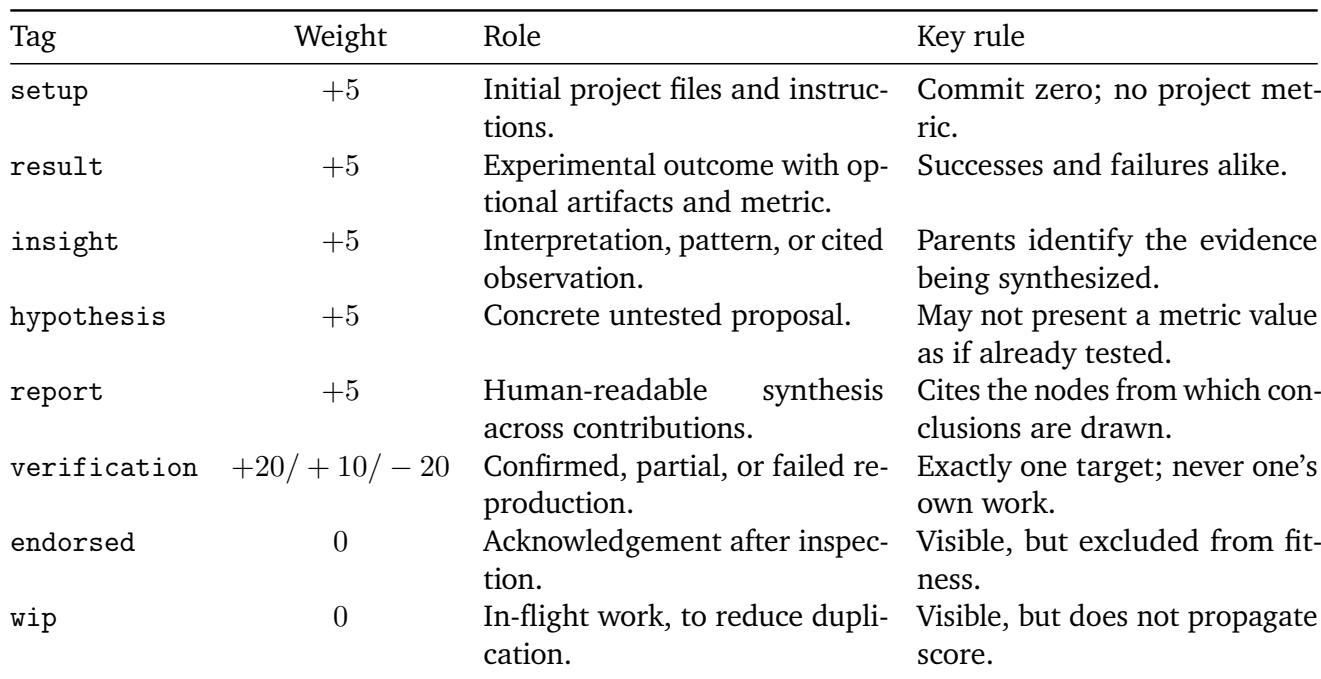
保留贡献类型根据标签在研究图中的角色分配特定权重,可复现实验权重更高,背书权重较低或为零。验证根据确认状态获得不同权重,而背书贡献可见但不影响适应度分数。设置和结果贡献携带相等的基础权重,而验证范围可从强正到负,具体取决于结果。背书贡献被明确排除在适应度计算之外,使其成为不计分的确认。假设贡献被限制不得呈现尚未测试的指标值,保持已提出与已确认结果之间的区分。
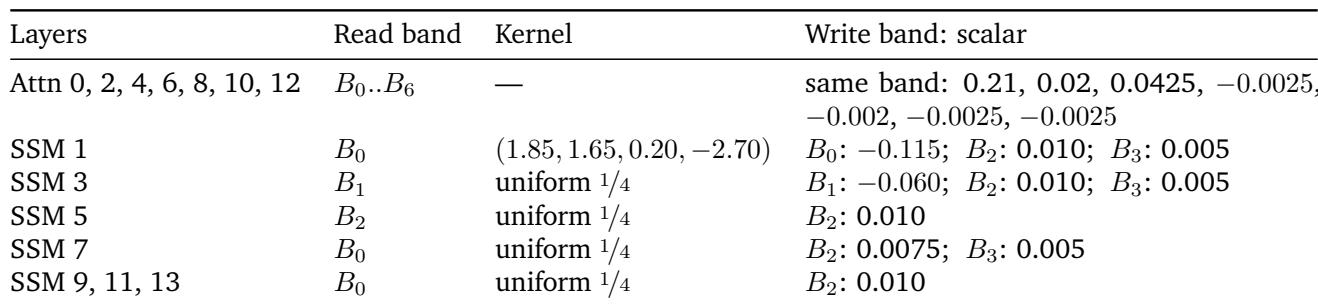
阶段 B 通过将稀疏固定编辑应用于隐藏状态 96 维条带来重新启用子层,其中第一条带存储来自分解的领先奇异方向。注意力层以较小尺度写回自己的条带,而 SSM 层使用符号交替或均匀核,并通常写入额外条带。所有编辑均为确定性的,并直接从提交的代码中验证。注意力层使用随层变化的小标量权重读写同一条带。SSM 层 1 使用强调近期位置的符号交替核,而其他 SSM 层使用均匀核。六个 SSM 层将过滤后的结果写入共享次要条带,表明存在跨层信息聚合。所有常量都通过导入链追踪,并确认不涉及梯度更新。
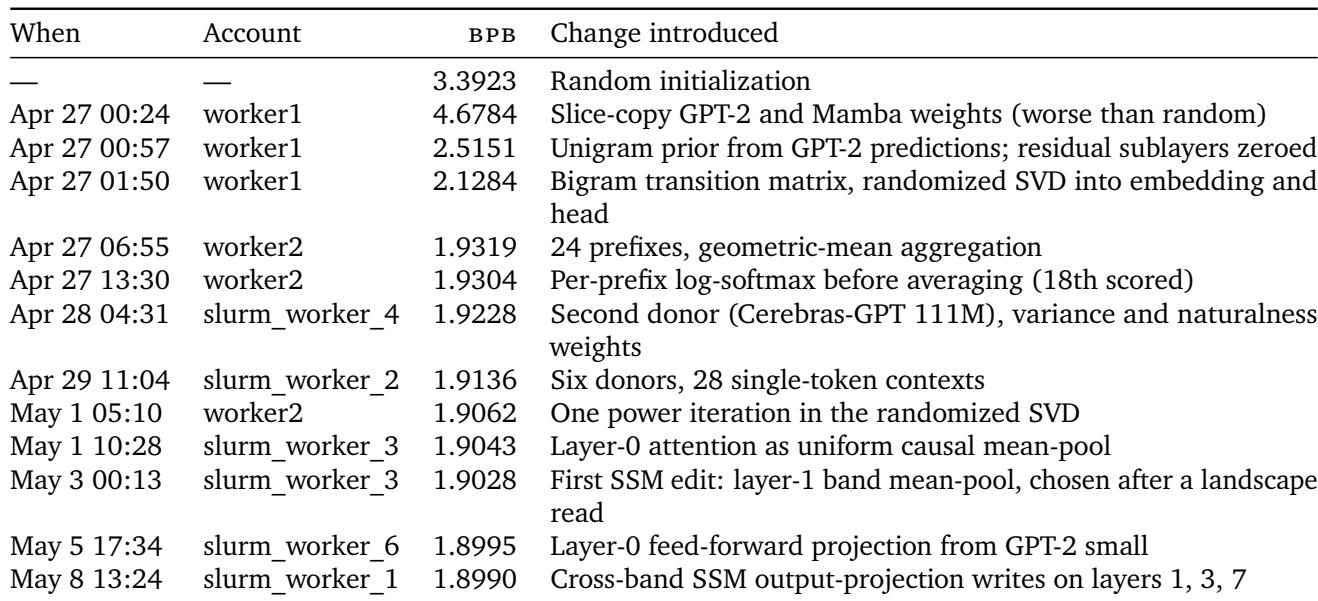
冻结 119.6M 混合模型的最佳迁移初始化达到 1.899044 bpb,大幅优于随机初始化(3.3923),并缩小了与训练好的 GPT-2 差距的 62%。搜索经历多个阶段:初始的比随机更差的复制、随后是单字和二元组先验,大部分增益来自各种前缀下的二元组配方。后续改进和多样策略贡献了小幅改进,获胜贡献是社区努力的结果,包含许多跨账户父边。直接复制 GPT-2 和 Mamba 参数得分差于随机(4.68 vs 3.39 bpb),并以负面结果发布。使用来自 GPT-2 预测的单字先验改进至 2.52 bpb,扩展到最多 24 个前缀的二元组统计达到 1.93 bpb。大部分分数下降(约 98%)来自基于二元组的贡献,后续更改仅增加 0.03 bpb。添加第二个供体、加宽上下文以及 SVD 中的幂迭代带来了小幅增益,但某些更改(如将前缀加倍至 48 或使用 Pythia)出现回退并以负面结果发布。获胜配方由社区组装:最佳贡献有 145 个祖先,144 条父边中有 115 条跨越账户边界,40 个祖先被独立复现。
评估设置验证了 Agora 的设计目标,包括持久内存、前沿可见性、证据质量、搜索多样性和可审计性,通过特定机制(如仅追加 Git 提交、内容寻址工件和保留贡献权重将背书排除在适应度分数之外)实现。阶段 B 通过固定、带限编辑重新启用子层,这些编辑从提交的代码验证,注意力和 SSM 层确定性写入指定条带。迁移实验表明,社区组装的基于二元组的初始化大幅改善冻结混合模型相对随机初始化的表现,缩小了与训练好的 GPT-2 差距的 62%,而直接复制参数得分差于随机并以负面结果发布;获胜配方拥有 145 个祖先和许多跨账户边,在 40 个案例中被独立复现,后续改进仅贡献边际增益。