Command Palette
Search for a command to run...
信心源于经验:从推理到智能体的经验性置信度估计
信心源于经验:从推理到智能体的经验性置信度估计
Caiqi Zhang Xiaochen Zhu Chengzu Li Yulong Chen Dharshan Kumaran Nigel Collier
摘要
可靠的置信度估计对于语言模型的可信部署日益关键:对输出正确概率的校准估计决定了哪些内容可以发布、哪些需要升级处理、哪些需要重试。然而,现有置信度估计器共享一个设计前提:它们仅读取当前推理过程,要么通过内省推理、要么通过评分其标记概率、要么通过重采样。我们认为,当前推理不足以作为置信度的充分依据。我们提出 XConf(经验性置信度):在估计置信度的同时结合模型积累的经验。经验以模型自身分级过去情节的记录形式存储,每条记录包含任务、模型反思、其陈述的置信度、结果以及评分到达后写下的教训。面对新任务时,XConf 的召回阶段检索在类似任务上遇到相似陈述置信度的过去情节,并读取其历史成功率;其反思阶段向模型展示该记录,让其指出反复出现的失败模式,并基于自身历史记录重新陈述置信度。我们的估计器格式通用,无需访问 logits 或更新权重,且仅需一次答案生成。在涵盖推理、编码、多模态问答和交互式智能体的九个基准测试以及来自三个家族的四个模型上,XConf 在 23/24 项比较中的判别力(AUROC)优于或匹配十样本自洽性,同时校准误差(ECE)更低,且生成成本仅为十分之一。用于选择性预测时,对最不自信的 10% 情节弃权可使智能体任务的成功率提高高达 8.7 个百分点。因此,我们将经验性置信度估计视为未来通用置信度估计的新范式。
一句话总结
剑桥大学和谷歌DeepMind的研究人员提出了XConf,一种经验置信度估计器,通过回忆和反思两个阶段,用已评分的过往片段增强当前推理,在23/24项基准比较中以十分之一的生成成本达到10-sample自洽性的AUROC水平,并将agent任务中的交付成功率最多提升8.7 points。
核心贡献
- 提出XConf(eXperiential Confidence),一种无需训练的置信度估计器,将不确定性建立在存储的已评分过往片段经验库之上,使用回忆阶段检索相似片段,并使用反思阶段重新审视历史成功率和已命名的失败模式后重新陈述置信度。
- 无需访问logit或更新权重,仅需一次答案生成,且格式通用;在九个基准(推理、编码、多模态问答、交互式agent)和四个模型上,XConf在24项比较中的23项中达到或超过十样本自洽性的AUROC,同时具有更低的ECE和十分之一的生成成本。
- 证明置信度信号来源于存储的经验:打乱存储结果会破坏估计,删除记录会消除增益,扩大记录会改善校准;对置信度最低的10%片段进行弃权可将agent任务的交付成功率最多提升8.7个百分点。
引言
大语言模型越来越多地部署在代码生成、浏览器自动化和agent决策等高风险场景中,在这些场景中,错误输出可能带来严重后果。这使得可靠的置信度估计变得至关重要:它决定了何时交付、升级给人工或重试。现有的置信度估计器都仅依赖当前推理过程本身,无论是通过口头内省、token似然评分,还是对重采样输出的一致性检查。这些方法都没有参考模型的过往经验,尽管数十年来的人类元认知研究表明,人们部分通过回忆类似任务过去的结果来校准判断。一个学生因为类似的题目总是做对而信任一个行列式解而不重新检查,同时因为组合证明此前经常失败而预期失败;这两种判断都不来自重新检查推导本身。
作者提出XConf,一种黑盒、无需训练且格式通用的置信度估计器,利用模型积累的经验而非仅依赖当前推理。XConf维护一个已评分过往片段的记录,每个片段存储任务、模型的反思、陈述的置信度和结果。对于新任务,回忆阶段检索相似片段并计算给定相似置信度水平下的观测成功频率,机械地纠正习惯性校准偏差。反思阶段随后将模型自己的历史记录展示给模型,要求其识别重复出现的失败模式,并据此重新陈述置信度。在覆盖推理、编码、多模态问答和交互式agent的九个基准上,XConf在区分能力上达到或超过十样本自洽性,同时实现更低的校准误差,在编码和agent任务上增益最大。该方法还表明经验可跨数据集和模型迁移,随记录增长而改善,并且在最低置信度片段上弃权时实现高达8.7个百分点的选择性预测增益,凸显了从读取当前推理转向从积累经验中学习的转变。
方法
作者提出XConf,一种置信度估计器,使模型在给出置信度之前查阅自己已评分的过往。核心思想是每段经验被读取两次:一次统计读取和一次语言读取。回忆阶段将过去视为数据,计算相似片段上的置信度条件命中率,而反思阶段将这些片段以文本形式重新呈现给模型,使陈述的置信度受模型自身历史记录的影响,而非孤立产生。
问题定义。 该估计器在正常操作期间收集的片段上运行。每个片段定义为
e=(x,ρ,a,r,v,y),其中x是任务,ρ是推理轨迹或展开过程,a是输出,r是在评分之前写下的简短自我反思,v∈是片段结束时陈述的置信度,y∈{0,1}是评分结果。经验库B={e1,…,en}存储过往片段,在测试时仅当前片段之前已评分的片段可见。置信度估计器是一个映射
c^=f(x,ρ,a,r,v;B),目标是校准概率P(y=1∣x,a)。关键区别在于对B的依赖:现有估计器是轨迹内在的,形式为c^=g(x,ρ,a),而XConf通过检索查阅经验库。
经验库。 每个存储的片段有五个字段:任务、模型对其自身解决方案的反思(在结果已知之前写下)、陈述的置信度、评分结果,以及模型在收到评分后自己写下的一次性教训。该教训被隔离在经验库中,在模型反思未评分解决方案时绝不展示,因为结果知识会以指令无法消除的方式偏误自我判断。经验库是系统运行的副产物,而非单独的数据收集工作:这些片段在开发、评估或延迟反馈部署期间本来就会被评分,而嵌入它们是离线的且均摊成本低。同样的五个字段同样描述一个选择题答案、一个程序或一个三十步的展开过程。
回忆:置信度条件命中率。 回忆阶段回答一个问题:在与当前片段相似的过往片段中,模型陈述了相似置信度的那些,实际正确的频率是多少?每个片段由两个字段作为键,
F(e)=[taskembeddingϕ(x);statedconfidencev],其中ϕ是一个冻结的现成嵌入器。为确保“相似”意味着因相同原因失败而非共享主题,相似性在该空间的正确性监督重缩放中测量,该重缩放基于经验库自身的已评分片段拟合。回忆检索该空间中最近的k个经验库片段Nk(e),并读取它们的结果命中率,
RECALL(e)=k1j∈Nk(e)∑yj,k=50,即模型在相似任务上遇到相似感觉时的历史准确率。当经验库在当前任务周围稀疏时,估计会优雅退化而非失败:被检索的k个片段仅弱相似,命中率向该陈述置信度下的模型基础成功率松弛,这是一个粗略但诚实的先验。
反思:阅读自身历史记录。 反思阶段让模型读取自己的过去,包括教训。回忆检索到的片段被渲染为简短的上下文卡片,每个片段一张:任务摘要、当时的陈述置信度、结果和教训。在展示当前任务、模型自身的反思和这些卡片后,模型被要求先指出记录揭示的任何重复失败模式,然后才重新陈述校准后的置信度。反思是一个简短提示,不重新求解任务。
最终估计。 最终置信度对同一记录的两个读取进行平均,一个是统计的,一个是语言的:
Confidence(e)=21(RECALL(e)+REFLECT(e)).等权重遵循长期以来的发现:两个不完全相关的评判者的等权混合很难被击败。
实验
评估涵盖四个模型、九个基准,覆盖推理、多模态问答、代码和交互式agent任务,使用冻结嵌入器作为模型无关的检索键。所提出的方法XConf在几乎所有比较中以十分之一的生成成本达到或超过十样本自洽性,同时具有一致的更低校准误差,并在无需修改的情况下有效跨任务族迁移。增益在自省信号失效的场景中最大,例如具有静默失败的agent展开过程,XConf在无任何训练的情况下甚至击败了训练过的验证器。该方法随经验扩展而扩展,通过允许在低置信度片段上可靠弃权来改善选择性预测,并在模型大小和经验库迁移中保持稳健,但当结果标签由模型自身生成而非外部评分时会退化。
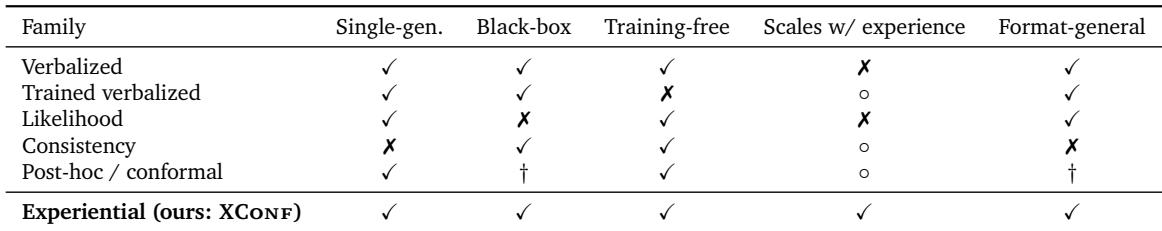
该表按操作属性比较了估计器族,表明所提出的经验估计器独特地结合了单次生成、黑盒、无需训练和经验扩展能力,同时保持格式通用。实验摘录验证了这一设计,表明基于经验的估计在难度控制之外仍然有效,对模型规模缩减稳健,且仅需要独立的结果标签而非模型自我判断。经验估计器是唯一同时具备单次生成、黑盒、无需训练、随经验扩展且跨格式工作的族。在题目难度保持不变的情况下,基于经验的估计仍以0.79的AUROC区分正确与错误的尝试,在36个单元中的35个中高于随机水平。该估计在模型大小间保持稳定,只有自我反思的语言读取在较小模型上退化。使用独立评判者的标签保留该方法的大部分价值,但使用模型自身的自生成标签完全失效。陈述置信度和反思状态是检索中最重要的元素,语义检索大幅优于随机邻居。
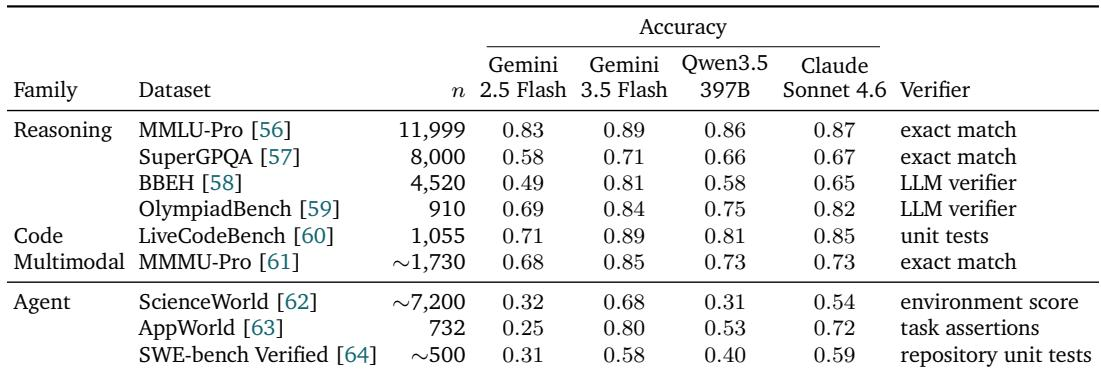
该表评估了推理、代码和多模态任务中四个模型在九个基准上的表现,Gemini各代之间以及不同模型族之间的准确率差异显著。评分依赖任务特定的验证器,从精确匹配到单元测试,而引用的文本强调了客观外部评分对置信度估计的重要性。Gemini 3.5 Flash在所有基准上大幅优于Gemini 2.5 Flash,显示出明显的能力差距。Claude Sonnet 4.6和Qwen3.5-397B通常介于两个Gemini模型之间,Claude往往更接近较强的Gemini。推理基准显示各模型间准确率差异最大,而代码和多模态任务也显示一致的排序。验证器选择是任务特定的:选择题使用精确匹配,自由形式推理使用LLM验证器,代码使用单元测试。
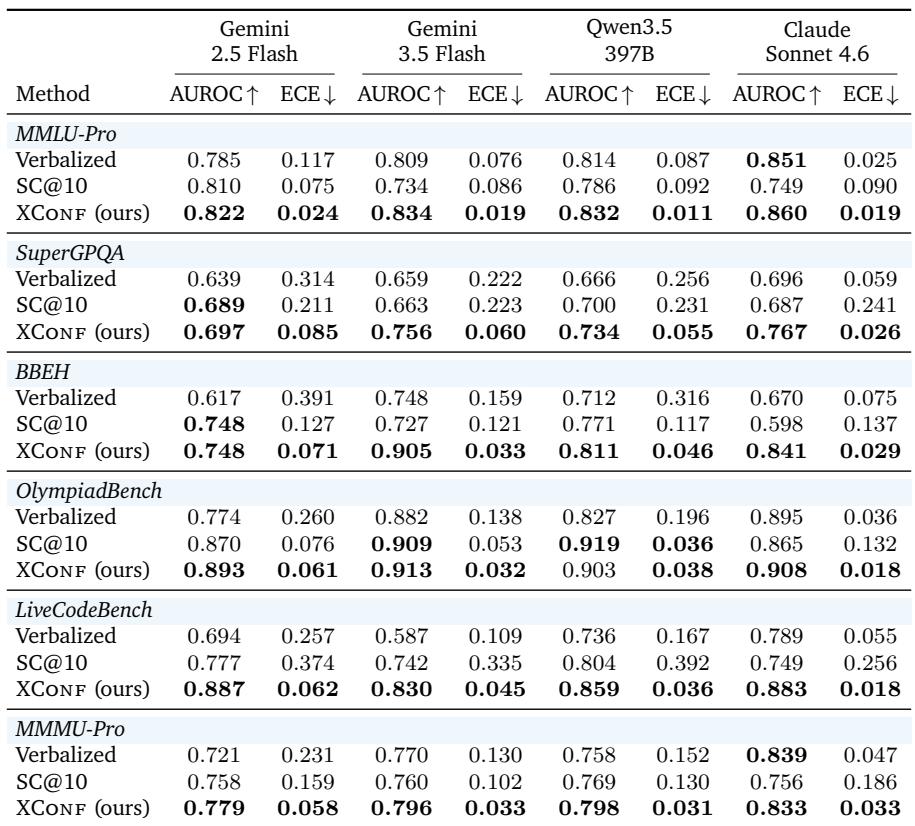
所提出的置信度估计方法在推理、代码和多模态任务上持续达到或超过现有方法,同时以极小成本运行。其增益对难度混杂因素、模型规模缩减和不完美的外部评分标签均稳健,但当标签来自模型自身时退化。该方法在几乎所有评估组合上达到或超过自洽性,且校准误差更低。即使在题目难度保持不变时,置信度估计仍保持区分能力,优于口头化置信度。该方法几乎不受模型规模缩小的影响,除了反思组件在较小模型中退化。用独立弱评分器替换真实标签保留了大部分收益,而自生成标签使性能降至未标记基线以下。
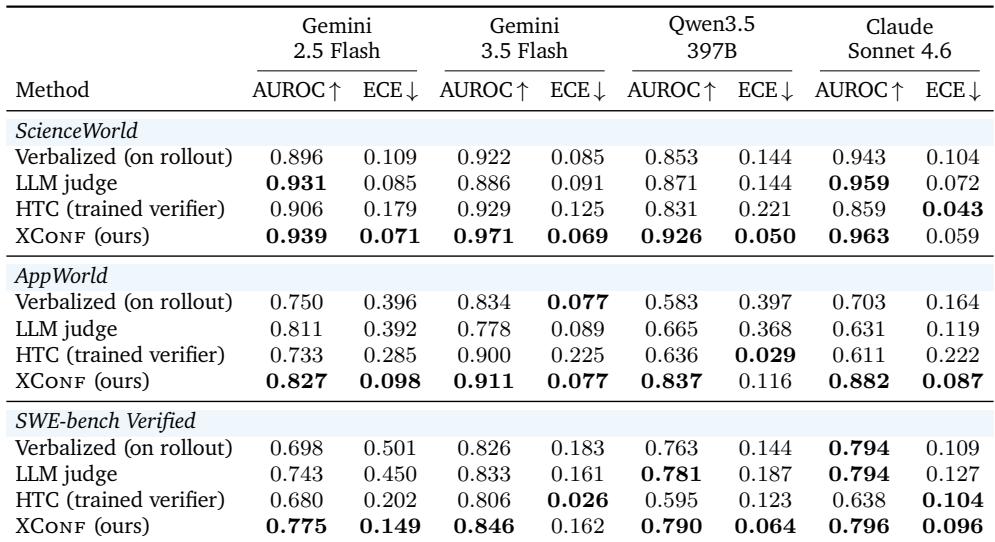
所提出的方法在所有测试的agent基准和模型主干上持续达到最佳或持平的AUROC和ECE,优于口头化置信度和训练过的验证器基线。即使在控制题目难度时,该方法的优势依然存在,且其对底层模型大小稳健,尽管它依赖独立的结果信号而非模型自身的自我判断。该方法在所有十二个模型-基准单元中达到最高AUROC和最低或持平的ECE。它在几乎所有模型上优于口头化置信度和HTC训练验证器。即使在题目难度保持不变时,它以0.79的AUROC区分正确与错误的尝试,在36个单元中的35个中高于随机水平。该估计几乎不受模型大小影响,除了语言反思组件在27B参数以下退化。性能依赖独立的评分信号:用LLM评判者替换真实标签保留大部分价值,而自生成标签使性能退化到低于无标签的状态。
所提出的置信度估计方法在推理、代码、多模态和agent基准上以更低成本持续达到或超过基线,在控制题目难度时仍保持区分能力,并对模型规模缩减稳健。其有效性依赖独立的结果标签,使用独立评判者保留大部分收益,而自生成标签使性能退化到低于未标记基线。该方法还依赖反思状态的语义检索,这是区分正确与错误尝试的关键。