Command Palette
Search for a command to run...
ScienceBuddy:面向交互式科学智能体的递归内递归自我改进方法
ScienceBuddy:面向交互式科学智能体的递归内递归自我改进方法
摘要
我们引入并发布了 ScienceBuddy,一个交互式科学研究工作空间,将不断改进的科学智能体融入研究者的日常工作中。ScienceBuddy 支持研究者执行科学任务,同时将其请求、反馈和执行证据转化为用于持续学习的任务和评估标准。其核心是递归内递归自我改进范式,该范式将机制进化与模型强化学习相结合:内层递归在固定模型的情况下改进机制,而外层递归则在改进后的机制下训练模型。机制进化塑造了训练体验,而模型学习则为机制适应创造了新的机会。我们展示了研究者交互、机制细化和模型学习的案例研究,基准案例涵盖四个科学任务家族。通过将 ScienceBuddy 作为研究产品发布,我们将这一范式提供给科学界,并朝着发现智能迈出了一步:科学人工智能通过与研究者的持续合作而进步,并随着其支持的研究而演化。
一句话总结
来自 phai-labs 的研究人员推出了 ScienceBuddy,一个交互式科学工作空间,通过 recursive-in-recursive 自我改进实现持续进步的 agent,将工具链演化与模型强化学习相耦合,把反馈转化为任务和评估标准,案例研究覆盖四个科学任务族并推动发现智能的发展。
核心贡献
- 推出并开源 ScienceBuddy,一个交互式科学研究工作空间,将研究者对话、可执行分析、可检视工件和可插拔工具链连接起来,使该范式可供科学社区使用。
- 提出 recursive-in-recursive 自我改进,一种将可评估工具链演化与基于标准监督的模型强化学习相结合的协同设计范式,其中反射器保持固定以隔离每种改进机制。
- 涵盖四个科学任务族的案例研究表明,工具链细化提升了可访问反馈任务的首轮响应准确率,而模型学习在固定工具链下扩展了问题覆盖范围,并提供了更广问题覆盖和更优任务执行的证据。
引言
科学研究依赖于迭代分析、检视和修正,语言模型 agent 可通过检索证据、查询数据库和运行计算工作流来支持这一过程。然而,虽然会话内的答案修正有助于单个任务,但并不能系统性地改进 agent 的广义流程或能力。已有工作探讨了反思、工具链优化和交互驱动适应,但这些方法通常将流程学习和模型学习孤立对待,未能充分解决协作本身如何为协调且持续的改进提供任务和评估标准的问题。
作者推出了 ScienceBuddy,一个交互式科学研究工作空间,支持从研究者协作中持续学习。该系统将可编辑的工具链(通过指令和技能组织行为)与科学基础设施分离,使流程变更显式且可评估。核心贡献是 recursive-in-recursive 自我改进范式:内环使用固定辅助模型诊断失败并提出有界流程编辑,外环基于标准奖励在新轨迹上训练任务模型。这种双向耦合使工具链修订能塑造训练轨迹,模型更新能改变流程有效性,从而形成改进系统返回研究者继续交互的循环。来自 LAB-Bench 和 Biomni-Eval 四个任务族的案例研究显示首轮响应准确率和问题覆盖率均有提升,并将 ScienceBuddy 开源为面向科学辅助和能力演化的共享工作空间。
方法
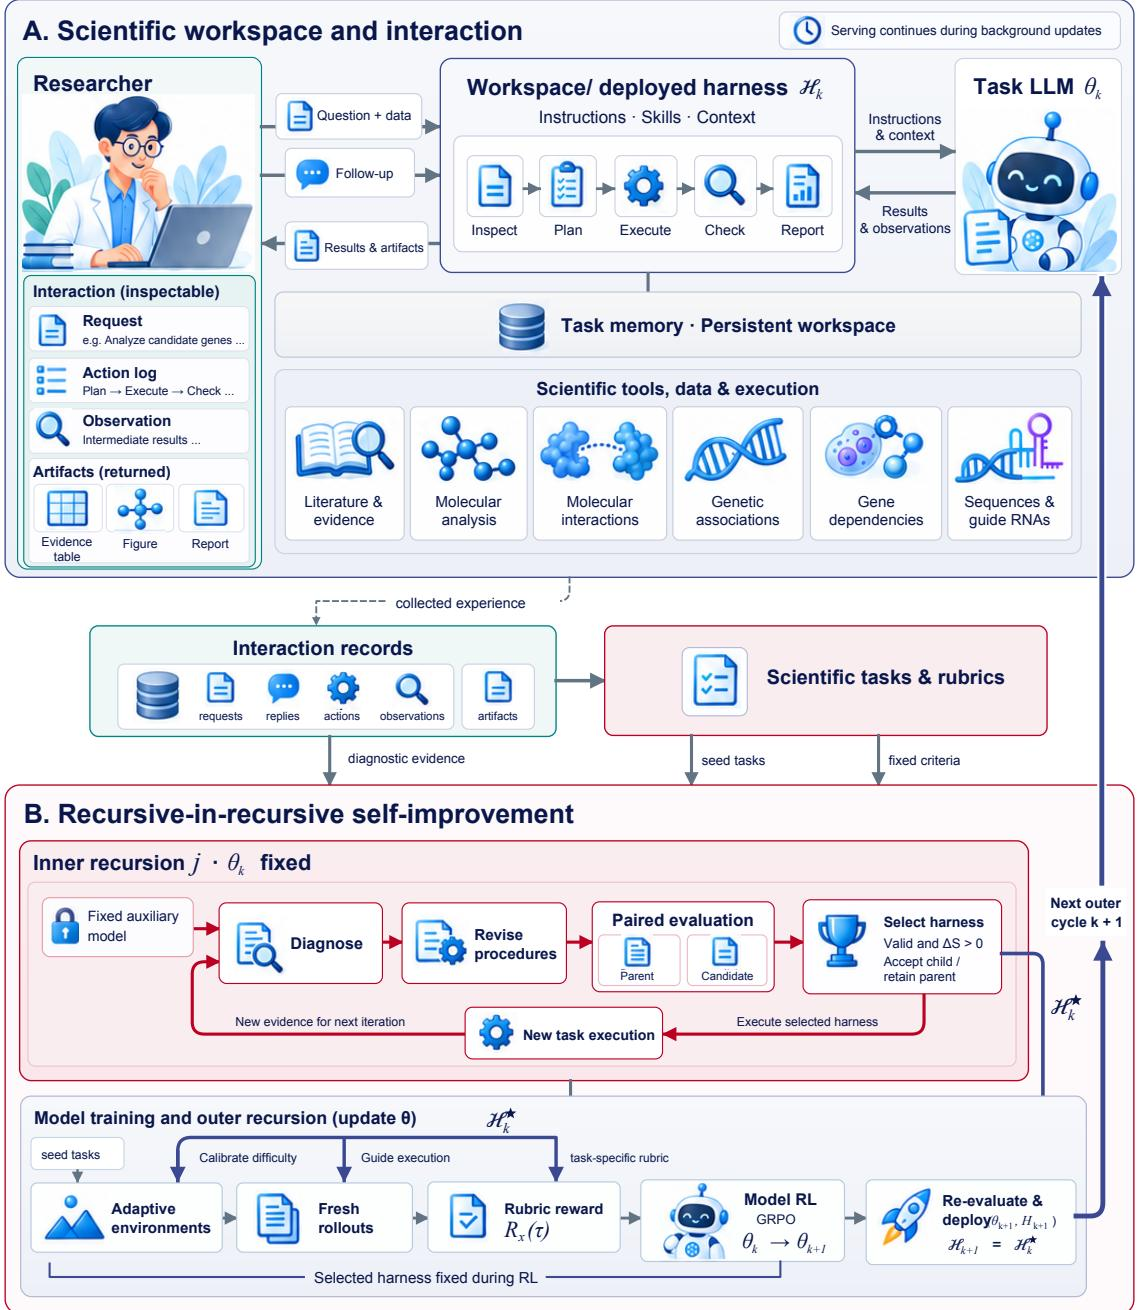
ScienceBuddy 作为一个交互式科学研究工作空间,将证据访问、计算分析和方法论指导整合到单一对话工作流中。系统架构将 agent 工具链与底层基础设施分离。工具链管理指令、技能和上下文管理流程,而基础设施处理研究者交互、任务执行和持久化存储。这种模块化设计使系统能显式修订科学问题求解流程,同时保持执行环境的一致性。
如下图所示,该工作空间支持 recursive-in-recursive 自我改进过程。研究者提交问题和数据,agent 通过涉及代码执行和工具使用的 ReAct 风格推理循环处理这些内容。生成的轨迹和工件可作为系统更新的诊断证据。
系统将研究者交互形式化以生成学习信号。设 x 表示研究请求,πθ 为任务模型,H 为工具链。联合策略 μθ,H 基于历史 ht 和工具链上下文 CH(ht) 决定动作 at。
μθ,H(a∣ht)={δdH(ht)(a),πθ(a∣CH(ht)),if a harness action is scheduled,otherwise,协作记录被转化为自包含的 Harbor 任务和评估标准。该过程将相关对话轮次整合为科学目标,从完整轨迹推导正确性和方法论标准,而非仅依赖专家标注。
参考任务推导过程的框架示意图。
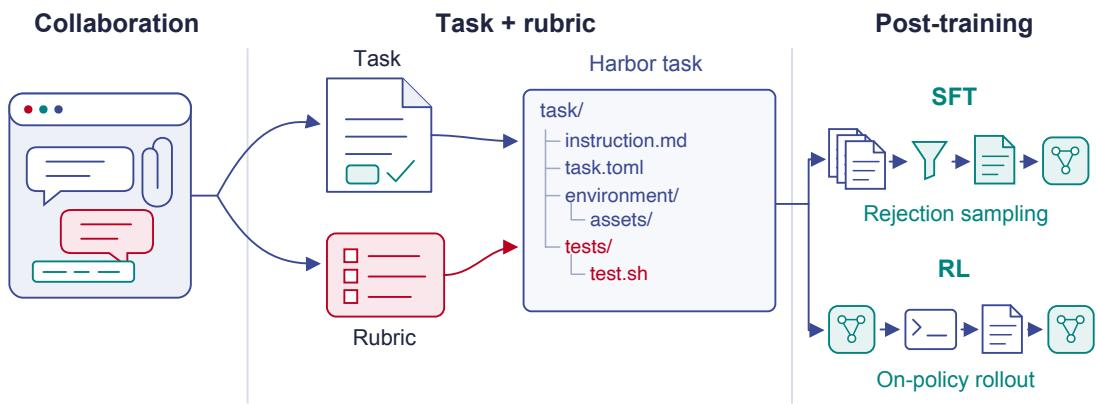
这些任务打包了指令、资源、执行环境和标准,支持通过拒绝采样进行监督微调以及通过在线轨迹进行强化学习。
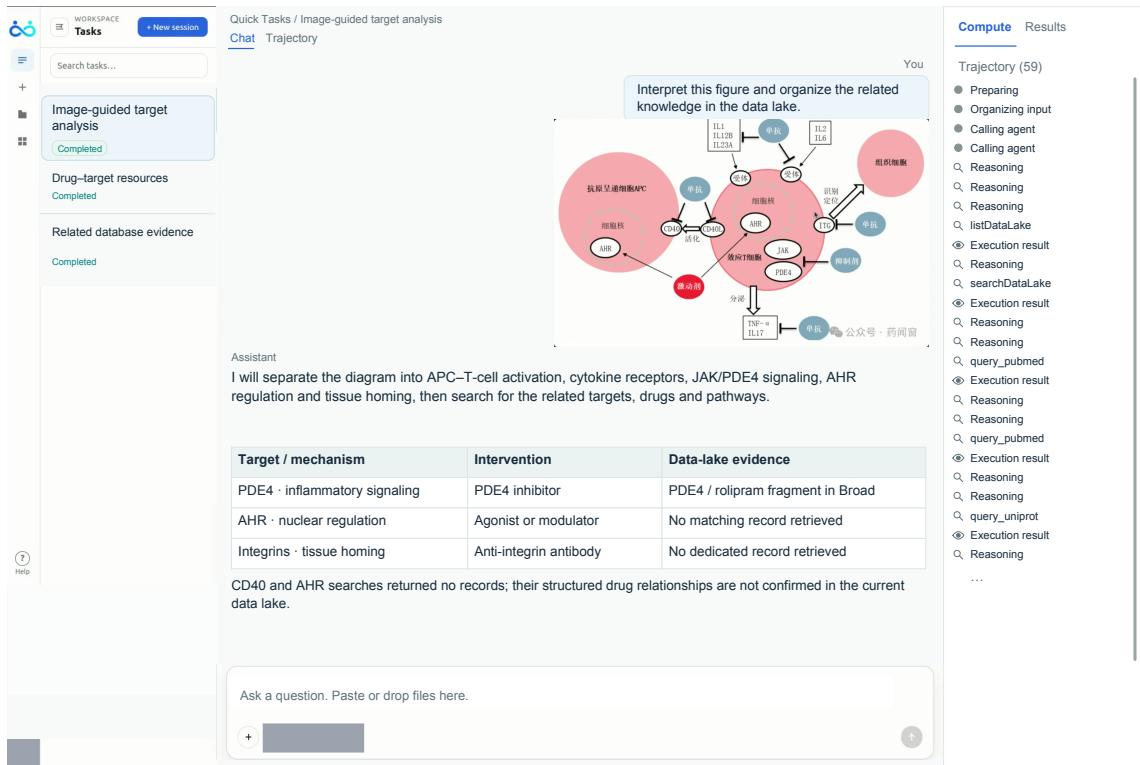
该工作空间支持多模态输入,允许研究者提供文档、生物序列和图像以及自然语言请求。
如下图所示,上传的图表可指导分子靶标识别和相关知识组织,界面将视觉解释连接到结构化证据表。
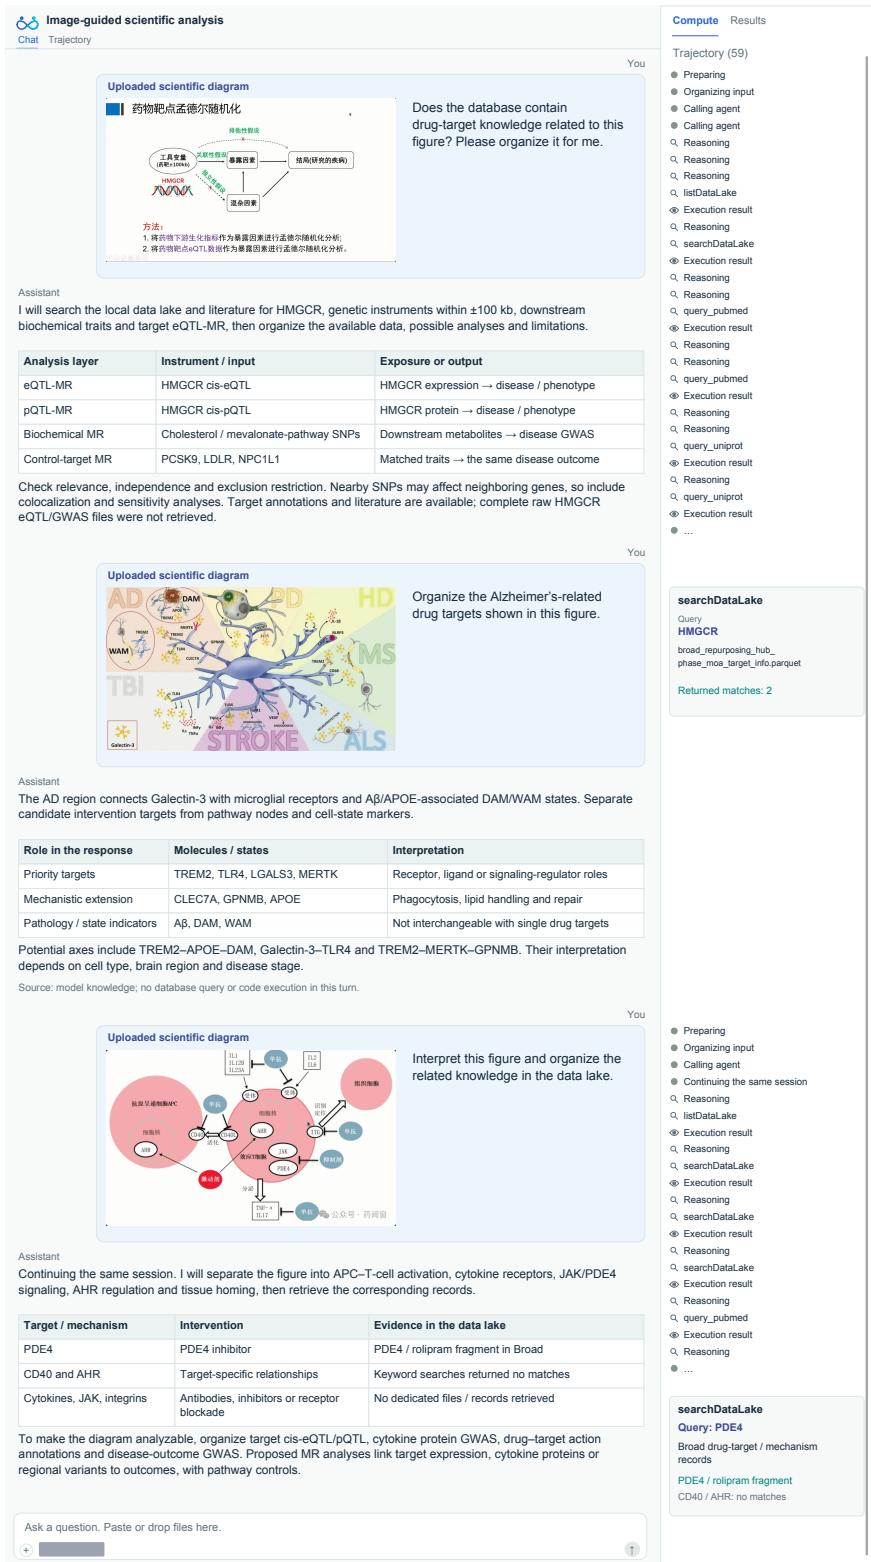
系统支持长上下文 agentic 推理,连续的基于图像的请求可在持久会话中引导靶标分析。agent 通过推理和检索解释图像,并利用先前交换恢复会话。
参考下图展示长上下文推理。
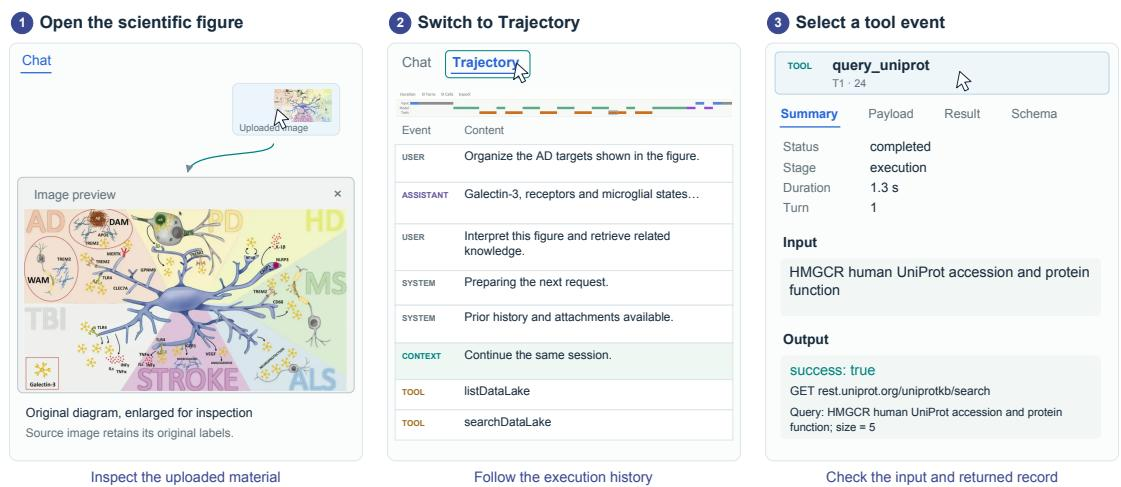
研究者还可以在对话输入之外检视 agent 的工作。切换到轨迹视图并选择特定工具事件后,用户可检查元数据、输入和输出,以验证 agent 响应的依据。
如下图所示,这些控件允许对执行历史进行详细检视。
训练过程通过嵌套递归将工具链适应与模型更新耦合。在内递归中,任务模型参数 θk 保持固定。固定辅助模型分析近期轨迹和标准评估以识别未满足的标准,并提出对工具链 H 的有界流程编辑,例如修订技能或指令:
Hk,j+1=U(Hk,j,Ek,j;θk)候选仅在满足编辑约束并提升开发任务上的平均归一化标准分 Sˉk 时被接受:
Hk,j+1={Hk,j+1,Hk,j,Valid(Hk,j+1)∧Δk,j>0,otherwise.在外递归中,一旦选定工具链,系统校准环境难度并生成新轨迹。奖励信号由任务特定标准 C(x) 导出:
Rx(τ)=∑c∈C(x)wc(x)∑c∈C(x)wc(x)vc(x,τ)任务模型通过 GRPO 更新以最大化期望轨迹奖励:
θmaxJk(θ)=Ex∼qkEτ∼πθ,Hk⋆(⋅∣x)[Rx(τ)]在模型更新 θk+1 后,工具链和模型被重新评估并共同部署,开启下一轮研究者交互和改进循环。
实验
四个案例研究通过独立研究问题评估 ScienceBuddy:研究者交互、耦合的 recursive-in-recursive 改进、工具链适应和模型学习。真实研究者请求展示了反馈如何转化为任务目标和评估标准,从而导出基于轨迹的标准。在交替进行工具链细化和强化学习的三轮协同演化循环中,总体测试准确率从 42.2% 升至 73.3%,所有任务族均有提升,且更多先前错误的问题转为正确。在固定模型权重下,工具链适应将验证准确率提升 20 个百分点;在固定工具链下,模型学习将问题覆盖率从 48.3% 提升至 67.8%,确认两种机制均独立扩展了科学任务性能。